
Tutorial
gemini-4-carbon im Praxis-Einsatz: 5 wertvolle Anwendungsszenarien für Textmodelle und die wichtigsten Integrationspunkte
Auf dieser Seite
Warum Textmodelle anhand von Szenarien statt anhand von Ranglisten bewerten
Der häufigste Irrtum bei der Modellauswahl ist, eine Rangliste als Ergebnis zu nehmen. Die Gesamtpunktzahl einer Rangliste spiegelt die durchschnittliche Leistung über das Bewertungsset wider, während Ihr Geschäft sich nur für eine Art von Aufgabenform interessiert: Kundenservice-E-Mails in strukturierte Felder extrahieren oder Nutzerfeedback in fünf Kategorien einteilen. Diese beiden Aufgaben stellen völlig unterschiedliche Anforderungen an das Modell – die erste verlangt strikte Einhaltung des Ausgabeformats und keine fehlenden Felder, die zweite eine stabile Label-Entscheidung und kein Schwanken bei Grenzfällen. Ein Modell mit hoher Gesamtpunktzahl kann bei Ihrer konkreten Aufgabe durchaus schlechter abschneiden als ein Modell im Mittelfeld.
Praktischer ist es, zunächst die Aufgabenform zu zerlegen und dann zu beurteilen, ob das Modell passt. Textbezogene Anforderungen lassen sich grob in einige Kategorien einteilen: strukturierte Extraktion (Felder aus Freitext entnehmen), Klassifikation und Routing (Labels vergeben, über den weiteren Weg entscheiden), Komprimierung langer Texte (Zusammenfassungen und Kernpunkte), Fragebeantwortung und Umformulierung auf Basis von Materialien sowie Review und Qualitätsprüfung (Beurteilung von Bestanden/Nicht-Bestanden mit Begründung). Jede Kategorie hat unterschiedliche Ein-/Ausgabekontrakte, unterschiedliche Empfindlichkeit gegenüber Prompts und unterschiedliche Behebungskosten bei Fehlern.
Der Bewertungsprozess sollte daher lauten: Zuerst bestimmen, zu welcher Form die Aufgabe gehört, 20 bis 50 echte Beispiele schreiben, klar definieren, was „richtig gemacht“ bedeutet, dann die Kandidatenmodelle einmal durchlaufen lassen und die Ergebnisse manuell vergleichen. gemini-4-carbon ist das stärkste Modell der Gemini-4-Serie und richtet sich an die komplexesten mehrstufigen, langfristigen Aufgaben; auch dafür eignet es sich, auf diese Weise validiert zu werden, statt voreingenommen seinen Marketingbeschreibungen zu vertrauen.
Im Folgenden werden 5 wertvolle Szenarien vorgestellt, jeweils mit Ein-/Ausgabekonventionen, wichtigen Punkten beim Prompt-Design und Ansätzen zur Kostensteuerung, sodass Sie direkt passend zu Ihrem Bedarf auswählen können.
Szenario 1: Unstrukturierter Text zu strukturierten Daten
Dies ist die Art von Aufgabe, bei der Textmodelle am ehesten direkten geschäftlichen Nutzen erzeugen: Die Eingabe ist der Text eines Tickets, eine Kunden-E-Mail, ein Vertragsabschnitt oder ein Meeting-Protokoll, die Ausgabe ist JSON mit festen Feldern. Typische Felder sind Problemtyp, betroffenes Produkt, Dringlichkeit, Schlüsselentitäten und eine Zusammenfassung des Nutzeranliegens.
Der Ein-/Ausgabekontrakt muss vorab festgelegt werden
Vor der Umsetzung muss das Schema klar geschrieben werden, etwa Feldnamen, Typen, Enum-Werte und ob null erlaubt ist. Sobald das Schema feststeht, muss das Modell in der Ausgabeebene strikt daran gehalten werden. Die Vorgehensweise ist, im Prompt direkt die Felddefinitionen und ein vollständiges Beispiel anzugeben, statt nur zu beschreiben „Bitte extrahieren Sie die wichtigsten Informationen“. Beispiele sind wirksamer als Beschreibungen, besonders wenn die Feldbedeutung leicht mehrdeutig ist.
Drei Ebenen zur Erzwingung des Ausgabeformats
Die erste Ebene ist der Prompt: klarstellen „Geben Sie ausschließlich JSON aus, keine Erklärungen, keinen Text außerhalb von Markdown-Codeblock-Markierungen“. Die zweite Ebene ist die Strukturvalidierung: Nach Erhalt der Antwort sofort Parsing und Feldvalidierung durchführen; Enum-Werte außerhalb des zulässigen Bereichs, fehlende Pflichtfelder und Typabweichungen werden als Fehlschlag gewertet. Die dritte Ebene ist der erneute Versuch: Bei fehlgeschlagener Validierung die Validierungsfehlermeldung als zusätzliche Anweisung mitsenden und erneut anfragen; dies hat in der Regel eine deutlich höhere Erfolgsrate als ein unveränderter erneuter Versuch.
Erwarten Sie nicht, dass es beim ersten Mal perfekt ist. Bei langen Texten kann das Modell Informationen im hinteren Teil übersehen; bei Schemas mit vielen Feldern können zwei ähnliche Felder vertauscht werden. All das muss in der Validierungsebene abgefangen werden, nicht durch wiederholte Ausrufezeichen im Prompt.
Kostensteuerung
Bei Extraktionsaufgaben ist die Eingabe oft lang und die Ausgabe kurz; die Kosten konzentrieren sich auf die Eingabeseite. Nicht benötigte Gesprächsverläufe, E-Mail-Signaturen und rechtliche Haftungsausschlüsse sollten vor dem Senden an das Modell entfernt werden. Nur die für die Felder relevanten Abschnitte zu behalten spart Geld und erhöht die Genauigkeit.
Szenario 2: Inhaltsklassifikation und Routing
Die Form von Klassifikationsaufgaben ist: Ein Text geht hinein, ein oder mehrere Labels kommen heraus, und die Labels entscheiden, welcher Prozess als Nächstes durchlaufen wird – an welches Team weitergeleitet, in welche Warteschlange eingereiht, welche automatische Antwort ausgelöst wird.
Label-Design ist wichtiger als die Modellauswahl
Zunächst prüfen, ob die Label-Menge disjunkt und erschöpfend ist. Wenn es eine Auffangkategorie wie „Sonstiges“ gibt, muss deren Entscheidungskriterium klar definiert sein. Die Anzahl der Labels sollte anfangs nicht zu groß sein; ab mehr als zehn Kategorien steigt die Verwechslung des Modells bei Grenzfällen deutlich an, daher empfiehlt es sich, ähnliche Kategorien zunächst zusammenzufassen und erst nach erfolgreichem Durchlauf feiner zu unterteilen. Zu jedem Label sollte idealerweise eine Entscheidungserklärung und ein Positivbeispiel im Prompt stehen.
Konfidenz und Auffangregelung
Im Prompt kann das Modell gebeten werden, eine kurze Entscheidungsbegründung zu liefern, die als Routing-Grundlage dient: Klare und in sich stimmige Begründungen werden direkt weitergeleitet, vage oder widersprüchliche Begründungen gelangen in die manuelle Warteschlange. Beachten Sie jedoch, dass die selbst gemeldete Konfidenz des Modells nicht immer gut kalibriert ist; unbedingt an echten Beispielen validieren, ob sie tatsächlich zwischen „einfachen“ und „schwierigen“ Beispielen unterscheiden kann. Sicherer ist es, die Verteilung mehrerer Kandidaten-Labels zu betrachten oder in der Regel-Ebene zu beurteilen, ob die vom Modell gelieferte Begründung ausreichend ist.
Gleichzeitig muss es einen Auffangzweig geben: Parsing-Fehler, Labels außerhalb der Enum-Menge, Konflikte mehrerer Labels – all das geht grundsätzlich in die manuelle oder Standard-Warteschlange. Routing ist eine stark beeinflussende Kette; lieber mehr manuelle Bearbeitung als fehlerhafte automatische Zuweisung.
Kostensteuerung
Bei Klassifikationsaufgaben ist die Eingabelänge mittel und die Ausgabe extrem kurz; der Token-Verbrauch hängt hauptsächlich von der Eingabe ab. Es können nur Titel, Anfangsparagraph und Schlüsselsätze an das Modell gesendet werden statt des gesamten Dokuments; bei überlangen Inhalten zuerst kürzen und dann klassifizieren, was in den meisten Szenarien nur begrenzte Wirkungsverluste verursacht.
Szenario 3: Zusammenfassung langer Texte und Extraktion von Kernpunkten
Die Schwierigkeit bei der Zusammenfassung langer Texte liegt nicht im „einen Absatz Zusammenfassung schreiben“, sondern im „keine Schlüsselinformationen verlieren, nicht doppelt zusammenfassen, nichts erfinden“. Bei der Verarbeitung überlanger Texte in einem einzigen Aufruf neigt das Modell dazu, Inhalte aus der Mitte zu verlieren und den Anfang wiederholt umzuformulieren.
Abschnittsweise zusammenfassen und dann zusammenführen
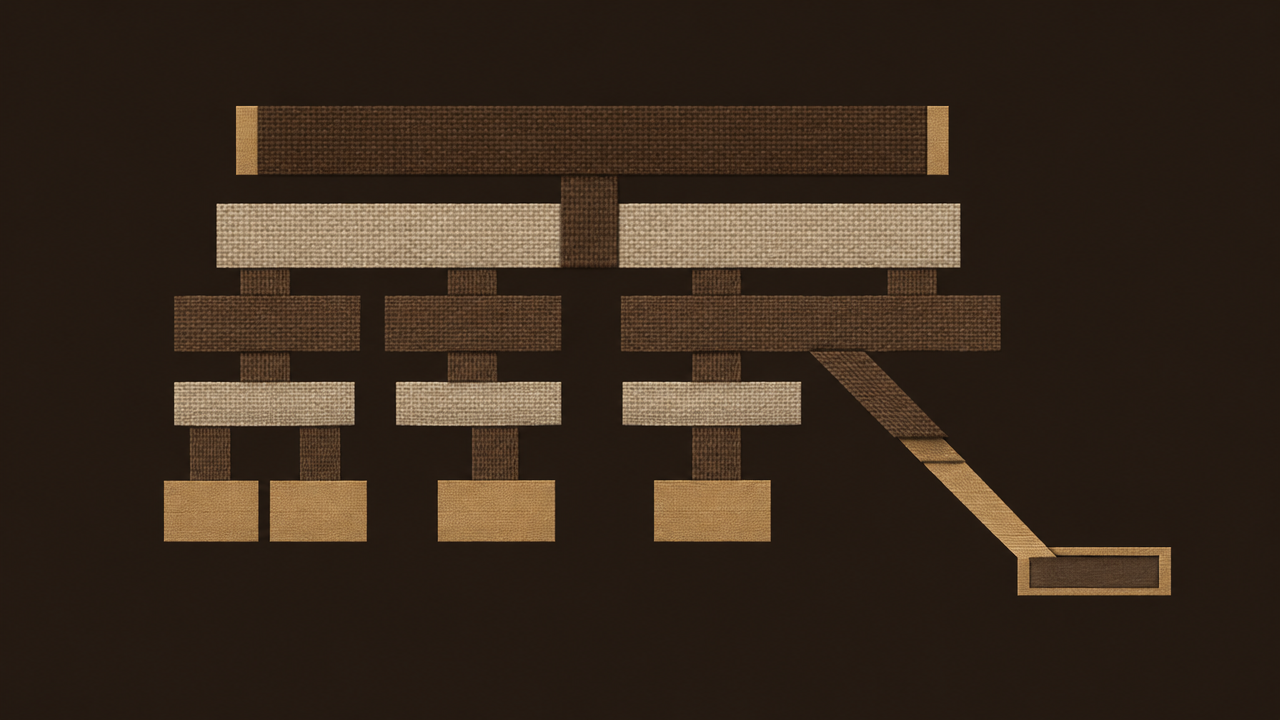
Üblich ist, den langen Text nach Absätzen oder Kapiteln zu unterteilen, abschnittsweise Kernpunkte zu erzeugen und diese dann zur endgültigen Zusammenfassung zusammenzuführen. Beim Unterteilen möglichst an semantischen Grenzen schneiden statt starr nach fester Zeichenzahl, da ein in zwei Hälften getrennter Satz Rauschen einführt. In der Zusammenführungsphase sollte das Modell nur auf Basis der bereits erzeugten Kernpunkte komprimieren, statt erneut auf den Originaltext zurückzugreifen, was Wiederholungen und Abschweifungen deutlich reduziert.
Zielgruppe und Granularität der Zusammenfassung klären
Im Prompt muss klarstehen: Für wen ist die Zusammenfassung, wie lang soll sie sein, welche Elemente müssen erhalten bleiben (Zahlen, Schlussfolgerungen, To-dos). Ohne diese Angaben liefert das Modell durchschnittliche Allgemeinplätze. Eine weitere wirksame Vorgabe ist „Ausgabe als Stichpunkte“, wobei jeder Punkt ein Satz ist, um redundante Übergangsfloskeln in zusammenhängenden langen Absätzen zu vermeiden.
Qualitätsprüfung
Für Zusammenfassungen gibt es keine eindeutig richtige Antwort, aber einige kostengünstige Prüfungen sind möglich: Liegt die Länge im Bereich, sind die geforderten Schlüsselelemente enthalten, tauchen Zahlen oder Entitäten auf, die im Original nicht vorkommen. Der letzte Punkt ist besonders wichtig, da das Modell beim Komprimieren gelegentlich eine plausibel wirkende Zahl „ergänzt“, was in Geschäftsdokumenten ein gravierender Fehler ist.
Kostensteuerung
Dies ist das Szenario mit dem höchsten Eingabe-Token-Verbrauch. Abschnittsweise Zusammenfassung bedeutet, dass dasselbe Dokument mehrfach gelesen wird, und die Kosten wachsen ungefähr linear mit der Länge. Es empfiehlt sich, für überlange Dokumente eine Längenobergrenze festzulegen und eine klare Degradationsstrategie zu definieren, z. B. nur die ersten Kapitel detailliert und den Rest grob zusammenfassen.
Szenario 4: Fragebeantwortung und Umformulierung auf Basis eigener Materialien
Die Form dieses Szenarios ist: Der Nutzer stellt eine Frage, das System ruft zunächst Kandidatenabschnitte aus eigenen Materialien ab, fügt sie in den Kontext ein und lässt das Modell auf Basis dieser Abschnitte antworten oder umformulieren. Der Unterschied zur allgemeinen Fragebeantwortung besteht darin, dass die Antwort in den vorgegebenen Materialien verankert sein muss.
Zusammensetzung des Kontexts
Die abgerufenen Abschnitte sollten zuerst sortiert und dann gekürzt werden, wobei die relevantesten nahe an der Anweisung platziert werden. Jeder Materialabschnitt erhält eine Quellenkennung, damit das Modell in der Antwort zitieren kann und Sie Fehler nachvollziehen können. Wenn sich die Abrufergebnisse widersprechen, sollte der Prompt das Modell ausdrücklich auffordern, den Konflikt zu benennen, statt selbst einen auszuwählen.
Die Antwort verweigern ist wertvoller als zwanghaft zu antworten
Im Prompt muss festgehalten werden: Wenn die Materialien nicht ausreichen, um zu antworten, direkt angeben, dass keine relevanten Informationen in den Materialien sind, und nicht aus Allgemeinwissen ergänzen. Diese Vorgabe kann die Halluzinationsrate deutlich senken, setzt aber voraus, dass im Bewertungsset gezielt eine Reihe von Fragen vorbereitet wird, deren Antwort in den Materialien tatsächlich nicht enthalten ist, sonst lässt sich das nicht messen.
Zusätzliche Vorgaben für Umformulierungsszenarien
Bei Anforderungen wie „die Materialien in einen für den Nutzer verständlichen Absatz umformulieren“ müssen neben der inhaltlichen Genauigkeit auch Stilvorgaben gemacht werden: Länge, Ton, ob Listen erlaubt sind, ob Originalterminologie beibehalten werden muss. Die Lesbarkeit der Umformulierungsausgabe hängt stark von diesen Punkten ab; fehlt einer, kommt es zu Stilabweichungen.
Kostensteuerung
Die Kosten werden fast vollständig von der Länge der in den Kontext eingefügten Materialien bestimmt. Im Abruf mehr Kandidaten zu holen und dann zu kürzen spart oft mehr Geld als ein größeres Top-K; wiederholte Fragen innerhalb derselben Sitzung können zwischengespeichert werden; bei Umformulierungsaufgaben senkt eine klare Begrenzung der Ausgabelänge sowohl die Kosten als auch die Stilkonsistenz.
Szenario 5: Unterstützung bei Review und Qualitätsprüfung
Die Form von Review-Aufgaben ist: Gegeben ist ein Inhalt (Werbetext, Code-Kommentar, Kundenservice-Antwort, Produktbeschreibung) und ein Regelwerk; die Ausgabe ist Bestanden oder Nicht-Bestanden sowie der Grund für Nicht-Bestanden. Es wird keine Kreativität angestrebt, sondern Entscheidungskonsistenz.
Review-Kriterien als entscheidbare Punkte formulieren
Kriterien wie „Ist der Ton freundlich“ lassen sich nicht stabil ausführen. Sie müssen in entscheidbare Punkte zerlegt werden: Enthält verbotene Wörter, gibt es Zusicherungen, liegt die Länge im Intervall, sind notwendige Informationspunkte enthalten. Jedes Kriterium entspricht einer booleschen Entscheidung und einer kurzen Begründung, die Ausgabestruktur ist fest als Ergebnis pro Kriterium plus Gesamtfazit.
Harte Validierung und weiche Empfehlungen trennen
Prüfungen, die mit Regelcode erledigt werden können (Regex, Länge, Wortliste), sollten nicht dem Modell überlassen werden, da dies langsam und instabil ist. Das Modell eignet sich für Teile, die von Regeln nicht abgedeckt werden: ob die Semantik in sich widersprüchlich ist, ob Formulierungen Missverständnisse hervorrufen könnten, ob vom vorgegebenen Kriterium abgewichen wird. Werden diese beiden Ergebnisarten getrennt ausgegeben, ist der Aufwand für die manuelle Nachprüfung deutlich geringer.
Ausgabedesign
Das Modell soll für jedes Kriterium einen dreiwertigen Status ausgeben: „Bestanden / Nicht bestanden / Nicht beurteilbar“ statt nur zweiwertig. Die Aufnahme von „Nicht beurteilbar“ reduziert deutlich die erzwungenen Entscheidungen des Modells bei unzureichender Information und gibt Ihnen eine klare Warteschlange zur manuellen Bearbeitung. Das Begründungsfeld wird auf einen Satz begrenzt, was Token spart und die aggregierte Auswertung erleichtert.
Kostensteuerung
Qualitätsprüfungen sind oft Batch-Aufgaben mit niedrigen Kosten pro Einheit, aber großem Gesamtvolumen. Steuerungsmittel sind standardisierte Prompt-Vorlagen, komprimierte zu prüfende Inhalte (nur die zu prüfenden Teile senden) sowie eine vorgeschaltete Regel-Filterung offensichtlich bestandener Beispiele, sodass nur fragwürdige Fälle an das Modell gehen.
Integrationsumsetzung: Schnittstelle, Parameter und Ausgabevorgaben
Die obigen 5 Szenarien haben auf Integrationsebene viele Gemeinsamkeiten und lassen sich zu einem allgemeinen Prozess abstrahieren: Prompt-Vorlage → Modellaufruf → Ausgabevalidierung → erneuter Versuch bei Fehlschlag. Der Modellaufruf erfolgt einheitlich über die Chat-Completions-kompatible Schnittstelle https://api.hiapi.ai/v1/chat/completions, die base_url des SDK ist https://api.hiapi.ai/v1, Streaming-Ausgabe wird unterstützt.
Modellname und Leitungen
Dasselbe Modell bietet zwei Leitungen: Bei der Standardleitung hat der Modellname keinen Suffix, bei der Vertex-Leitung wird dem Modellnamen @vertex angehängt, z. B. gemini-4-carbon@vertex. Der Wechsel der Leitung ändert nur das Feld model, der Rest der Anfrage bleibt unverändert; die Modellfähigkeiten beider Leitungen sind identisch, die Preise unterscheiden sich, siehe Preistabelle unten.
Eingabe und Längenobergrenzen
Als Eingabe werden nur Text und Bilder unterstützt, nicht Audio, Video und PDF. Die Kontextlänge beträgt 1.048.576 Token, die maximale Ausgabe pro Aufruf 65.536 Token, was für Szenarien wie die Zusammenfassung langer Texte größeren Spielraum lässt, aber eine abschnittsweise Verarbeitung bleibt ein wirksames Mittel zur Steuerung von Kosten und Stabilität.
Reasoning-Intensität
Die Reasoning-Intensität wird über reasoning_effort angegeben, wählbar sind low, medium, high. Welche Stufe gewählt wird, sollte anhand der tatsächlichen Aufgabe durch Bewertung bestimmt werden: Mit echten Beispielen jede Stufe einmal durchlaufen lassen, Genauigkeit, Laufzeit und Token-Verbrauch vergleichen und dann den Standardwert festlegen. Je höher die Reasoning-Intensität, desto mehr Laufzeit und Ausgabe-Token; dies muss je nach Szenario abgewogen werden.
Derzeit nicht unterstützte Fähigkeiten
Diese Schnittstelle unterstützt derzeit keine Tool-Aufrufe / function calling, keine Websuche, kein computer use und keine strukturierte Ausgabe / keinen JSON-Modus. Daher müssen Vorgaben zum Ausgabeformat im Prompt und in der Code-Validierungsebene liegen: Der Prompt gibt Felddefinitionen und ein vollständiges Beispiel, der Code parst die Antwort und validiert Punkt für Punkt, ohne sich auf eine Schema-Erzwingung seitens der Schnittstelle zu verlassen.
Beispielanfrage
curl https://api.hiapi.ai/v1/chat/completions \
  -H "Authorization: Bearer $HIAPI_API_KEY" \
  -H "Content-Type: application/json" \
  -d '{
    "model": "gemini-4-carbon",
    "reasoning_effort": "medium",
    "stream": true,
    "messages": [
      {"role": "user", "content": "Extrahieren Sie das folgende Ticket als JSON mit festen Feldern: ..."}
    ]
  }'
Struktur der Prompt-Vorlage
Empfohlen ist eine feste Vierteilung: Rollen- und Aufgabenbeschreibung, Eingabedaten, Ausgabeformatdefinition und Beispiel, Grenzen und Verbote. Die Eingabedaten werden mit klaren Trennzeichen eingefasst, um Verwechslungen mit Anweisungen zu vermeiden. Beispiele müssen vollständig parsbar sein; schreiben Sie nicht „JSON ähnlich wie dieses“ und geben dann ein unvollständiges Fragment.
Ausgabevalidierung ist Pflicht, nicht optional
Nach Erhalt der Antwort zunächst parsen: Lässt sich das JSON parsen, sind Pflichtfelder vollständig, sind Enum-Werte gültig, liegen Zahlen in vernünftigen Bereichen. Bei fehlgeschlagener Validierung nicht stillschweigend auf ein leeres Ergebnis zurückfallen, sondern protokollieren, denn die Fehlerquote selbst ist ein wichtiger Indikator für die Modellqualität.
Wiederholungsstrategie
Empfohlen sind maximal ein bis zwei Wiederholungen, und bei der Wiederholung den Validierungsfehler als Zusatzinformation an das Modell senden, z. B. darauf hinweisen, welches Feld fehlt oder welcher Enum-Wert ungültig ist. Ein unveränderter erneuter Versuch bringt in der Regel wenig Nutzen. Gleichzeitig Timeout und Nebenläufigkeitsgrenzen setzen, damit ein einzelner Ausreißer nicht den gesamten Batch lahmlegt.
Protokollierung und Beobachtbarkeit
Bei jedem Aufruf mindestens protokollieren: Szenariokennung, Verbrauch an Eingabe- und Ausgabe-Token, Validierungsergebnis, Laufzeit. Diese Daten dienen sowohl der Kostenanalyse als auch als Vergleichsbasis für einen späteren Modellwechsel oder die Anpassung von Prompts. Ohne diese Protokollierung kann jede Optimierung nur aus dem Bauchgefühl erfolgen.
Kostensteuerung nach Token-Abrechnung und Empfehlungen für den Produktivstart
gemini-4-carbon wird nach Token abgerechnet, das bedeutet, die Kosten werden gemeinsam von Eingabelänge und Ausgabelänge bestimmt, und die Kostenstruktur unterscheidet sich stark je nach Szenario. Bei Extraktions- und Fragebeantwortungsszenarien dominiert die Eingabe, bei Zusammenfassungen sind Eingabe und Ausgabe beide schwer, bei Klassifikation und Qualitätsprüfung ist die Eingabe schwer und die Ausgabe extrem leicht. Klären Sie zuerst, auf welcher Seite Ihr Szenario das Geld ausgibt, dann hat die Optimierung eine Richtung.
Preise und Auswahlbasis
Die Einheit der folgenden Tabelle ist US-Dollar / Million Token, die drei Spalten sind in Reihenfolge Eingabe, gecachte Eingabe, Ausgabe.
| Modell | Leitung | Eingabe | Gecachte Eingabe | Ausgabe |
|---|---|---|---|---|
| gemini-4-carbon | Standard | 1.00 | 0.05 | 5.00 |
| gemini-4-carbon | @vertex | 1.64 | 0.09 | 8.20 |
| gemini-4-argon | Standard | 1.00 | 0.05 | 5.00 |
| gemini-4-argon | @vertex | 1.64 | 0.09 | 8.20 |
| gemini-3.8-flash | Standard | 0.19 | 0.02 | 0.92 |
| gemini-3.8-flash | @vertex | 0.62 | 0.07 | 3.08 |
Die drei Modelle sind unterschiedlich positioniert: gemini-4-carbon ist das stärkste Modell der Gemini-4-Serie und richtet sich an die komplexesten mehrstufigen, langfristigen Aufgaben; gemini-4-argon eignet sich für die meisten Software-Engineering- und Wissensaufgaben und bietet ein ausgewogenes Verhältnis von Fähigkeit und Kosten; gemini-3.8-flash ist schnell und günstig und eignet sich für Aufgaben mit hoher Nebenläufigkeit und niedriger Latenz. Für dieselbe Aufgabe kann zunächst Argon oder Flash zum Laufen gebracht werden, bevor beurteilt wird, ob ein Upgrade auf Carbon sinnvoll ist.
Leitung und Reasoning-Intensität sind ebenfalls Kostenfaktoren: Der Stückpreis der Standardleitung ist niedriger als der der @vertex-Leitung. Die Stufe der Reasoning-Intensität wird anhand der tatsächlichen Aufgabenbewertung gewählt; mit echten Beispielen Genauigkeit und Token-Verbrauch der einzelnen Stufen vergleichen und dann den Standardwert festlegen.
Eingabe komprimieren
Die häufigste Verschwendung ist, das gesamte Dokument unverändert an das Modell zu senden. Mögliche Maßnahmen: standardisierte Kopf- und Fußzeilen sowie Haftungsausschlüsse entfernen, Gesprächsverläufe nur auf die letzten Runden kürzen, Abrufergebnisse nach Relevanz kürzen, bei langen Texten nur die benötigten Kapitel senden. Diese Änderungen verlieren in der Regel keine Genauigkeit, reduzieren aber direkt die Eingabe-Token.
Ausgabe begrenzen
Die Steuerung auf der Ausgabeseite ist einfacher: Maximale Länge angeben, Ausgabe als Stichpunkte statt langer Absätze fordern, Wiederholungen der Eingabe verbieten. In vielen Prompts steht „Bitte ausführlich erläutern“, was im token-basierten Abrechnungsmodell ein Kostenverstärker ist, es sei denn, das Geschäft benötigt wirklich Details.
Zuerst im kleinen Maßstab bewerten, dann skalieren
Ersetzen Sie die offizielle Beschreibung nicht durch Ihre eigene Validierung. Empfohlen ist: Für jedes Szenario einige Dutzend echte Beispiele vorbereiten, entscheidbare Bestehenskriterien definieren, zunächst einen Durchlauf machen, um Genauigkeit und Fehlermuster zu sehen, dann entscheiden, ob der Umfang erweitert wird. Das Bewertungsset muss aufbewahrt werden als Regressionsbasis für später.
Einen wiederverwendbaren Bewertungs- und Regressionsprozess etablieren
Modellwechsel, Prompt-Änderungen und Anpassungen der Kontextlänge beeinflussen alle die Ergebnisse. Nur mit einem festen Bewertungsskript und festen Metriken kann innerhalb von Minuten nach einer Änderung beurteilt werden, ob es besser oder schlechter geworden ist. Dies ist die Infrastruktur für den langfristigen Einsatz von Textmodellen und wichtiger als jede einzelne Optimierung.
Wählen Sie zunächst ein Szenario, einige Dutzend Beispiele und ein klares Bestehenskriterium; erst nach erfolgreichem Durchlauf über Erweiterung sprechen. Auf der Modellseite von HiAPI.ai können Sie die Schnittstellenbeschreibung und Abrechnungsmodalitäten von gemini-4-carbon einsehen; ein Budget auf Basis des tatsächlichen Token-Verbrauchs von Eingabe und Ausgabe ist genauer.
Ähnliche Artikel
Alle Artikel ansehen →-

Tutorial
So rufen Sie kimi-k3.1-pro über die HiAPI-API auf: curl, Python und direkt ausführbare Anfragen
Ein praxisnaher Integrationsleitfaden zu Endpunkten, Anfrageparametern, Streaming, Tool-Aufrufen und Fehlerbehebung
-

Tutorial
ElevenLabs Music API auf HiAPI: Musikgenerierung mit curl, Python und Prompt-Rezepten
Ein praktisches Tutorial zum Aufruf von elevenlabs/music-v2.5 über HiAPI sowie kopierbare Prompt-Rezepte für Stil, Stimmung und Länge
-

Tutorial
So verwenden Sie gpt-image-2.5-sunburst/image-to-image über die HiAPI API: curl und Python
Ausführbare Requests für Entwickler, Workflow zum Hochladen von Referenzbildern und Fehlerbehebung