
Benutzerhandbuch
gemini-4-hydrogen – Einstiegsleitfaden: Fähigkeitsgrenzen, Parameter und Integrationspraxis
Referenz zur Integration und Auswahl von Textmodellen für Engineering-Teams
Auf dieser Seite
Positionierung und Fähigkeitsgrenzen von gemini-4-hydrogen
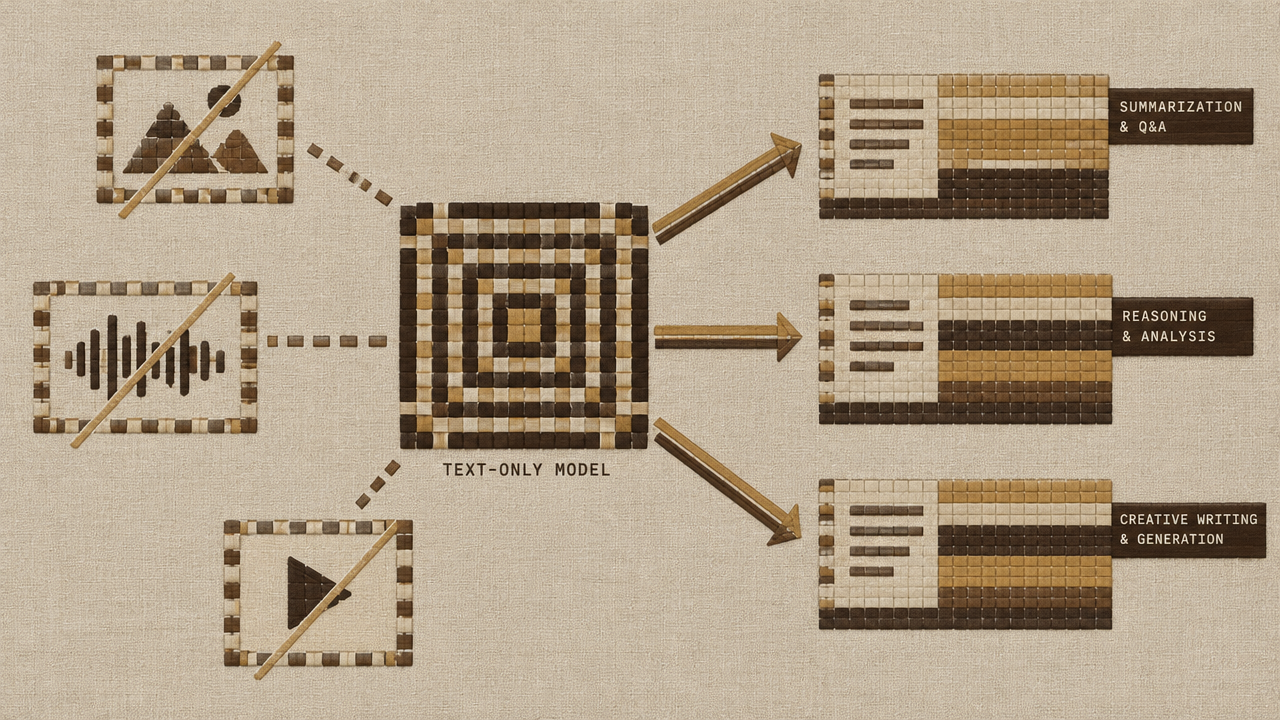
gemini-4-hydrogen ist ein Textmodell von Google. Sein Ausgabetyp ist reiner Text – das bestimmt, wo du es in deiner Architektur platzieren solltest: in Abschnitten mit Texteingang und Textausgang, nicht als Teil einer multimodalen Pipeline.
Wofür es geeignet ist
Aus technischer Sicht liegt der typische Einsatzbereich von Modellen mit reiner Textausgabe bei Aufgaben, deren „Zwischenprodukt ein Textstück ist“:
- Strukturierte Extraktion und Konvertierung: Umwandlung unstrukturierten Textes in vereinbarte Formate wie JSON, Tabellenzeilen, Feldlisten;
- Zusammenfassung und Umschreibung: Komprimierung langer Dokumente, Anpassung des Tonfalls, Vereinheitlichung mehrsprachiger Formulierungen;
- Klassifikation und Bewertung: Absichtserkennung, Inhaltsklassifizierung, Ticket-Routing – kurze Ausgaben für geringe Latenz;
- Unterstützung bei generativen Aufgaben: Entwurfserstellung, Vervollständigung von Codekommentaren, Erweiterung von Prompts als vorgelagerte Schritte vor der manuellen Prüfung;
- Dialog und Frage-Antwort: Antwortorganisation bei vorhandenem Retrieval-Kontext.
Gemeinsames Merkmal dieser Aufgaben: Die Eingabe lässt sich als Text serialisieren, die Ausgabe kann von nachgelagerten Programmen geparst werden, und die Ergebnisse können stichprobenartig geprüft werden.
Wofür es nicht geeignet ist
Ebenfalls eine technische Einschätzung: Die Grenzen müssen vorab klar gezogen werden:
- Erwarte nicht, dass es direkt Bilder, Audio oder Video erzeugt. Die Ausgabeform ist Text; Ketten mit multimodaler Generierung müssen an anderer Stelle zusammengesetzt werden;
- Betrachte es nicht als stark deterministischen Rechner. Logik wie exakte Arithmetik und strenge Regelvalidierung gehört in Code, nicht ins Modell;
- Lass es keine faktischen Aussagen ohne Kontext treffen. In Szenarien, die externes Wissen erfordern, füge zuerst Material per Retrieval in die Eingabe ein und lass es dann die Antwort organisieren;
- Betrachte es nicht als einzige Informationsquelle für Echtzeitereignisse. Das interne Wissen des Modells hat einen Stichtag; Inhalte mit hohen Aktualitätsanforderungen müssen von deinem System eingespeist werden.
Diese Punkte in die Design-Dokumente des Teams zu schreiben, ist deutlich günstiger, als später nachgelagert nachzubessern.
Was vor der Integration geklärt werden muss
Bevor du die erste Aufrufzeile schreibst, lohnt es sich, einige Dinge vorab zu klären; sonst entstehen in der Debug-Phase viele unnötige Fehlersuchen.
Aufgabenform und Ausgabevertrag festlegen
Beantworte zuerst drei Fragen: Ist die Eingabe ein einzelner Turn oder mehrstufig? Ist die Ausgabe Freitext oder muss sie einer bestimmten Struktur entsprechen? Kann die nachgelagerte Verarbeitung bei Fehlern Wiederholungen tolerieren? Diese drei Antworten bestimmen direkt, wie du später Prompts schreibst, Obergrenzen für die Ausgabelänge setzt und Validierungen durchführst.
Zugangsdaten und Aufrufeinstieg
Unabhängig davon, welche Integrationsart du letztlich wählst, benötigst du einen verwaltbaren und rotierbaren API-Zugangsschlüssel, und Zugangsdaten dürfen nicht in Frontend-Code geschrieben oder ins Repository eingecheckt werden. Empfohlen: Zugangsdaten in serverseitigen Umgebungsvariablen oder einem Secret-Management-Dienst ablegen, das Backend ruft das Modell zentral auf, das Frontend kommuniziert nur mit deinem Backend. Das verhindert Leaks und erleichtert später Kontingente und Audits nach Geschäftsdimensionen.
Netzwerk und Timeout-Budget
Die Dauer einer Anfrage an ein Textmodell variiert mit Eingabe- und Ausgabelänge. Lege vor dem Go-live fest: Welche maximale Antwortzeit kann dein Geschäft akzeptieren? Daraus leitest du Request-Timeout, Anzahl der Wiederholungen und Degradationsstrategie ab. Viele Rückmeldungen über „instabile Modelle“ sind tatsächlich eine Nichtübereinstimmung von Timeout-Einstellungen und Geschäftserwartungen.
Beobachtbarkeit vor Funktionalität
Bevor du Geschäftslogik schreibst, lege die Log-Felder fest: Request-ID, Eingabe-Token-Anzahl, Ausgabe-Token-Anzahl, Dauer, Fehlercode. Diese Punkte sind bei späterer Kostenkalkulation und Problemlokalisierung nahezu unverzichtbar; nachträglich einzufügen erfordert oft eine Runde Codeänderungen.
Compliance und Datengrenzen
Prüfe, ob die zu sendenden Inhalte sensible Informationen wie Nutzer-Privatsphäre, Schlüssel oder interne Dokumente enthalten, und lege fest, welche Felder vor dem Senden an das Modell maskiert werden müssen.
Aufrufparameter und Organisation von Anfragen
Ein typischer Aufruf besteht aus drei Teilen: Eingabeinhalt, Steuerparameter, Rückgabeergebnis. Wirklich relevant für Ergebnisqualität und Kosten sind meist nur wenige Parameter.
Wie der Eingabeinhalt organisiert wird
Betrachte die Eingabe in drei Schichten: „Anweisung + Kontext + zu verarbeitende Daten“:
- Die Anweisung steht am Anfang und beschreibt Rolle und Aufgabenziel;
- Der Kontext (abgerufene Materialien, Gesprächsverlauf) steht in der Mitte und wird klar abgetrennt;
- Die zu verarbeitenden Daten stehen am Ende, direkt neben dem von der Anweisung adressierten Objekt.
Bei mehrstufigen Dialogen sollten nur die letzten N Turns beibehalten werden statt unbegrenzt Historie anzuhäufen – je länger die Historie, desto mehr Verbrauch auf der Eingabeseite, und Rauschen verdünnt Schlüsselinformationen. Inhalte für langfristiges Gedächtnis sollten besser als Zusammenfassung injiziert werden, nicht vollständig als Original.
Wichtige Parameter
- Obergrenze der Ausgabelänge: Der am leichtesten übersehene Parameter, der zugleich Kosten und Erlebnis beeinflusst. Zu klein führt zu abgeschnittenen Antworten, zu groß gibt dem Modell Raum zum „Schwafeln“. Empfohlen: nach Aufgabentyp staffeln – Klassifikationsaufgaben erhalten eine sehr kleine Obergrenze, nur Langtextgenerierung wird freigegeben.
- Sampling-Parameter wie Temperatur/top-p: Bei Aufgaben, die stabile Ausgaben erfordern (Extraktion, Klassifikation, Formatkonvertierung), die Zufälligkeit niedrig halten; bei Texterstellung kann man sie moderat öffnen. Innerhalb desselben Geschäftsbereichs konsistent halten, um Regressionsvergleiche zu erleichtern.
- Stoppbedingungen: Wenn dein Downstream erwartet, dass die Ausgabe an einer bestimmten Stelle endet (z. B. nur das erste JSON-Objekt), ist eine Stoppsequenz zuverlässiger als nachträgliches Regex-Beschneiden.
- Vorgaben für strukturierte Ausgabe: Wenn Programme parsen sollen, gib in der Anweisung Feldnamen, Typen und Beispiele an und formuliere klar „Gib nur JSON aus, ohne Erklärungen“.
Einige Erfahrungen zur Anfrageorganisation
- Prompts vom Geschäftscode trennen und als versionierbare Templates pflegen, um A/B-Vergleiche zu erleichtern;
- Fallback beim Parsen der Ausgabe: Bei Parsing-Fehlern die Rohantwort protokollieren statt direkt einen Fehler an den Nutzer zu werfen;
- Idempotenzschlüssel für dieselbe Anfrage setzen, um doppelte Abrechnung und doppelte Nebenwirkungen durch Wiederholungen zu vermeiden;
- Bei langen Eingaben zuerst segmentieren und filtern und irrelevante Absätze vom Modell fernhalten – das ist die direkteste Sparmaßnahme.
Kostenschätzung und -steuerung bei Token-Abrechnung
gemini-4-hydrogen wird nach Token abgerechnet. Das bedeutet, deine Kosten hängen fast vollständig von zwei Dingen ab: wie viele Token pro Anfrage hineingehen und wie viele Token das Modell ausgibt. Preisangaben richten sich nach dem Preispaneel der Website; hier geht es nur um die Methode.
Eine Schätzroutine aufbauen
Schätze nicht nach Gefühl. Vorgehen: Zuerst eine Charge echter Beispiele laufen lassen, pro Anfrage Eingabe- und Ausgabe-Token protokollieren, nach Geschäftsszenarien gruppiert Mittelwerte und Perzentile berechnen. Mit „durchschnittliche Token-Anzahl × tägliche Aufrufmenge“ die Größenordnung schätzen, dann mit P95 den Worst Case betrachten. Du wirst feststellen, dass sich die Verteilungen zwischen Szenarien stark unterscheiden; eine einheitliche Durchschnittsschätzung weicht oft stark ab.
Konkrete Ansatzpunkte zur Kostenkontrolle
- Eingabe komprimieren: doppelte System-Prompts entfernen, irrelevanten Kontext zuschneiden, lange Dokumente zuerst zusammenfassen und dann senden. Die Eingabeseite ist meist der größte Kostenfaktor, der Nutzen am direktesten;
- Ausgabe begrenzen: über Obergrenzen der Ausgabelänge und Anweisungen wie „bitte knapp antworten“ redundante Ausgaben direkt unterdrücken;
- Gestaffelte Aufrufe: einfache Klassifikation und Formatprüfung mit kleinen Anfragen lösen, vollständige Aufrufe nur, wenn tatsächlich generative Fähigkeiten benötigt werden;
- Caching und Deduplizierung: Ergebnisse identischer oder sehr ähnlicher Anfragen cachen, besonders bei Batch-Offline-Aufgaben;
- Batching und Asynchronität: nicht-Echtzeit-Aufgaben gebündelt verarbeiten, um wiederkehrende Fixkostenanteile zu reduzieren.
Kosten zu beobachtbaren Metriken machen
Token-Verbrauch im Log nach Geschäftslinie protokollieren und als Tages-/Wochentrend-Dashboard darstellen. Steigt der Verbrauch an einem Tag ungewöhnlich, gibt es meist drei Ursachen: gestiegenes Aufrufvolumen, längere Eingaben (z. B. geänderte Kontextzusammensetzung) oder längere Ausgaben (z. B. geänderte Prompts). Diese drei Punkte als Monitoring zu führen spart viel nachträgliche Fehlersuche.
Eine letzte Erinnerung: Kostenoptimierung darf nicht auf Kosten der Ausgabequalität gehen. Erst ein Evaluationsset aufbauen, dann über Komprimierung sprechen.
Integration auf aggregierten API-Plattformen und Modellvergleich
Für die meisten Teams sind die größten Kosten in der Auswahlphase nicht das Schreiben von Code, sondern „bei jedem Modellwechsel die Integrationsschicht ändern zu müssen“. Ein einheitlicher Einstieg reduziert diesen Aufwand auf ein Minimum.
Vorteile einer einheitlichen Schnittstelle
Auf einer aggregierten API-Plattform wird der Modellaufruf auf dieselbe Anfragestruktur vereinheitlicht: gleiche Authentifizierung, gleiches Nachrichtenformat, gleiche Logik zur Rückgabeverarbeitung. Beim Modellwechsel muss meist nur der Modellbezeichner geändert werden, der Geschäftscode bleibt im Wesentlichen unverändert. Der direkte Nutzen:
- Die Integrationsschicht wird nur einmal geschrieben und von mehreren Modellen genutzt;
- In der Evaluationsphase lassen sich quervergleiche kostengünstig durchführen;
- In der Produktion sind Canary-Releases und schnelle Rücknahmen möglich – bei Problemen mit einem Modell genügt ein Konfigurationswechsel zum Ausweichmodell.
Informationen zur Integration und Verfügbarkeit dieses Modells findest du auf der Modellseite: /models/gemini-4-hydrogen.
Einmal einen Vergleich mit derselben Aufgabe durchführen
Schau nicht nur auf Ranglisten. Bereite ein eigenes Evaluationsset vor, das die reale Geschäftsverteilung mit 20 bis 50 Beispielen abdeckt, inklusive einfacher Fälle, Grenzfälle und langer Eingaben, und dann:
- dasselbe Prompt-Template mit mehreren Kandidatenmodellen ausführen;
- Ausgabequalität (manuell oder regelbasiert bewertet), Dauer und Token-Verbrauch protokollieren;
- vor allem auf Erfolgsquote und Fehlermuster achten, nicht auf Durchschnittsnoten;
- bei deutlich abweichenden Beispielen Ursachen zuordnen: Anweisungsbefolgung, Formatproblem oder Abschneiden bei langem Kontext.
Wechsel- und Koexistenzstrategie
Das Evaluationsergebnis lautet oft nicht „nur ein Modell verwenden“, sondern „nach Szenario aufteilen“. Zum Beispiel: Klassifikation und Extraktion mit einem Modell geringer Latenz, Langtextgenerierung mit einem Modell besserer Ausgabequalität. Ein einheitlicher Einstieg erlaubt es, diese Aufteilung in der Konfigurationsschicht auszudrücken, ohne mehrere SDKs pflegen zu müssen. Gleichzeitig empfiehlt es sich, in der Integrationsschicht einen Konfigurationsschalter für den Modellbezeichner vorzuhalten und in Kombination mit Canary-Releases schrittweise auszurollen.
Prüfliste vor dem Go-live und Fehlerbehebung häufiger Probleme
Prüfliste vor dem Go-live
Diese Schritte der Reihe nach durchlaufen, bevor du an Skalierung denkst:
- Smoke-Test: Kommt eine kürzeste Anfrage korrekt zurück, sind Authentifizierung und Netzwerk in Ordnung?
- Formatprüfung: Wie hoch ist bei strukturierter Ausgabe die Parsing-Erfolgsrate über eine Chargenprobe, und wie sehen fehlgeschlagene Rohantworten aus?
- Grenzeingaben: Wie verhalten sich überlange Eingaben, leere Eingaben, Eingaben mit Sonderzeichen und mehrsprachige Eingaben jeweils?
- Ausgabelänge: Wird die Ausgabe im Worst Case abgeschnitten, und kann das Downstream Abschneiden erkennen?
- Parallelität und Timeout: Sind Timeout- und Fehlerraten bei erwarteter Spitzenparallelität akzeptabel?
- Degradationspfad: Funktioniert der Weg zum Ausweichmodell oder zu einem Fallback-Ergebnis wirklich, wenn das Hauptmodell nicht verfügbar ist?
- Kostenbasis: Token-Verbrauch unter einer typischen Lastrunde protokollieren als Referenz für spätere Überwachung.
Häufige Probleme und Reihenfolge der Fehlersuche
Request-Timeout: Zuerst prüfen, ob die Eingabe zu lang ist (besonders, ob ein ganzes Dokument hineingepackt wurde), dann, ob die Ausgabeobergrenze zu groß gesetzt ist, und schließlich, ob Client-Timeout und Wiederholungsstrategie angemessen sind. Wiederholungen mit Backoff versehen, um einen Lawineneffekt zu vermeiden.
Ausgabe abgeschnitten: Obergrenze der Ausgabelänge prüfen und ob der Prompt zu lange Inhalte verlangt; manchmal führt eine falsch gesetzte Stoppsequenz zu vorzeitigem Ende.
Ausgabe instabil, Format mal gut, mal schlecht: Vorrangig die Sampling-Zufälligkeit senken; dann prüfen, ob die Anweisung eindeutig ist (Feldnamen, Typen, Beispiele vollständig); dann prüfen, ob in der Eingabe widersprüchliche Beispiele enthalten sind.
Inhalt weicht von der Anweisung ab: Häufigste Ursache ist zu langer Kontext, der Schlüsselanweisungen verdünnt. Die Anweisung ans Ende der Eingabe verschieben und einmal wiederholen oder den Kontext komprimieren hilft meist.
Kosten steigen ungewöhnlich: Nach den genannten drei Ursachen – Aufrufvolumen, Eingabelänge, Ausgabelänge – die Log-Trends einzeln vergleichen.
Ergebnisse nicht reproduzierbar: Anfrageparameter und Template-Version protokollieren; Modellausgaben sind inhärent zufällig, erwarte keine wortgenaue Reproduktion, die Validierung sollte auf Regeln oder manueller Bewertung beruhen.
Diese Prüfliste in den Release-Prozess zu übernehmen ist deutlich stabiler, als bei jedem Go-live aus dem Stegreif zu entscheiden. Konkrete Details zu Auswahl und Integration lassen sich zuerst auf der Modellseite /models/gemini-4-hydrogen klären.
Ähnliche Artikel
Alle Artikel ansehen →-

Benutzerhandbuch
Nano Banana Basisversion Leitfaden für Text-zu-Bild: Bildformat, Freiraum und Prompt-Nutzung
Mit den Feldern aspect_ratio und prompt der Aufgaben-API kompositorisch klare Bilder für Banner und Social Cards erzeugen
-

Benutzerhandbuch
Kimi K3 Antwortverarbeitung in der Praxis: Vollständiges JSON, Streaming-Abbrüche und Retry-Grenzen
-

Benutzerhandbuch
GLM 5.3 Strukturierte Extraktion in der Praxis: Jedes JSON-Feld mit Beleg aus dem Originaltext
Feldextraktion mit dem JSON-Objektmodus: fehlende Werte, Zitate und Geschäftsvalidierung halten Fehler vom Datenbankeintrag fern