
Benutzerhandbuch
Kurzvideos mit heygen-avatar-iv über die HiAPI-API generieren: Ein Entwicklerleitfaden
Avatar- und Audio-Eingaben, Skript-Tempo, Seitenverhältnis und Dauer sowie Batch-Generierung – mit ausführbaren HiAPI-Anfragen
Auf dieser Seite
Warum heygen-avatar-iv für Kurzvideos
Kurzvideos sind zum Standard-Verbreitungskanal für Produktlaunches, Versionshinweise, Dokumentationserklärungen und Social-Media-Clips geworden. Für die meisten Engineering-Teams liegt der Engpass nicht beim Schnitt – sondern darin, zuverlässig Sprechmaterial mit einer Person vor der Kamera zu produzieren, ohne ein Studio buchen oder mit echten Sprecher:innen Material hin- und herschicken zu müssen.
Genau diese Lücke füllt die Generierung von Videos mit digitalen Avataren. Du lieferst die visuelle Identität und die Audio-/Stimmquelle, und das Modell gibt einen gerenderten Clip zurück, in dem der digitale Avatar das Skript vorliest. heygen-avatar-iv ist der Endpunkt im HiAPI-Katalog für diesen Workflow: kurze, hochformatig ausgerichtete Clips, in denen die präsentierende Person direkt in die Kamera spricht.
Das Modell eignet sich für folgende Szenarien:
- Du musst in großem Umfang produzieren. Zehn lokalisierte Versionen derselben Ankündigung oder ein täglicher Clip pro Release – das ist eine Schleife, kein einzelner Dreh.
- Der Inhalt wird vom Skript getrieben. Wenn die Botschaft im Text steckt, reicht ein digitaler Avatar als Moderator.
- Du willst Reproduzierbarkeit. Eine Anfrage ist eine Datei, die sich diffen, versionieren und erneut ausführen lässt – anders als eine aufgezeichnete Session.
- Du rufst bereits eine API auf. Ein einzelner HTTP-Aufruf lässt sich in eine bestehende Pipeline integrieren, ohne ein neues Tool mit eigener UI einzuführen.
Es eignet sich nicht für improvisierte Auftritte mit ausladender Gestik und auch nicht für Szenarien, in denen die physische Präsenz einer bestimmten Person der Verkaufsargument ist. Betrachte heygen-avatar-iv als Renderer: Bei gleichen Eingaben sollte dieselbe Art von Ausgabe entstehen – genau das macht ihn skriptbar.
Der Rest dieses Leitfadens führt vom einzelnen Testaufruf bis zur Batch-Schleife, mit ausführbarem curl und Python, das du selbst anpassen kannst. Modelldetails und Parameter findest du auf der heygen-avatar-iv-Modellseite.
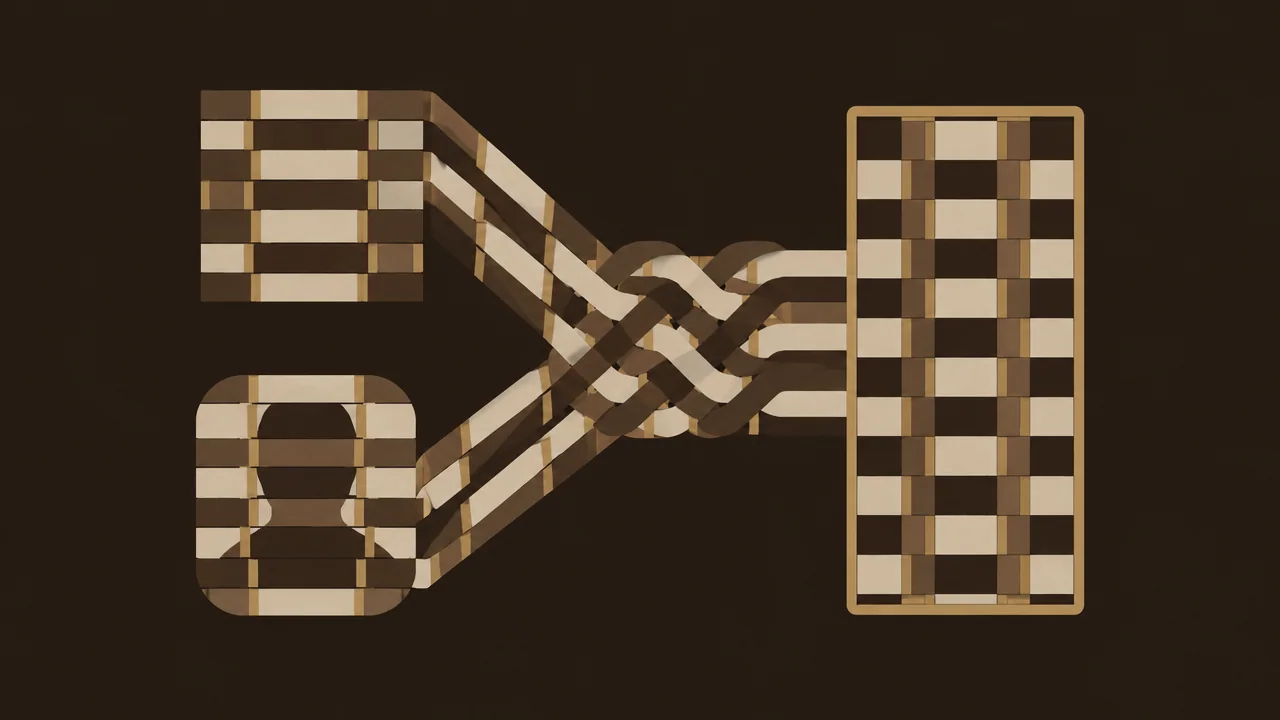
Aufbau einer heygen-avatar-iv-Anfrage
Bevor du Generierungscode schreibst, modelliere die Anfrage als zwei unabhängige Eingabegruppen. Nahezu alle frühen Bugs entstehen daraus, dass beide verwechselt werden.
Erste Gruppe: visuelle Identität
Das ist wer vor der Kamera steht – die Auswahl des digitalen Avatars, die Gesicht, Bildkomposition und das gesamte Erscheinungsbild der präsentierenden Person bestimmt. Halte diese Gruppe innerhalb einer Kampagne stabil. Wenn du fünf Clips über dasselbe Produkt erstellst, sollten sie denselben Avatar-Block verwenden, damit die Serie wie derselbe Moderator wirkt.
Zweite Gruppe: Audio und Stimme
Das ist was gesagt wird und wie. Je nach Anfrage kann die Audioquelle entweder eine Stimmauswahl sein, die deinen Skripttext vorliest, oder eine bereitgestellte Tonspur. Diese Gruppe ändert sich bei jedem Clip: neues Skript, neues Tempo, manchmal eine neue Stimme für die Lokalisierung.
Wie sie auf den Aufruf abgebildet werden
Eine HiAPI-Anfrage sendet beide Gruppen im selben Payload an den Generierungsendpunkt. Konzeptionell:
request
├── avatar / identity block   → bleibt in einer Serie stabil
└── audio / voice block       → ändert sich pro Clip
        └── Skripttext oder Audioquelle
Diese Aufteilung führt zu zwei praktischen Regeln:
- Parametrisiere die Audiogruppe, friere die Identitätsgruppe ein. Halte den Avatar im Code als Konstante auf Modulebene und übergib Skript und Stimme als Funktionsparameter. So ist die visuelle Konsistenz einer Serie strukturell gewährleistet.
- Ändere beim Debuggen immer nur eine Gruppe. Wirkt der Clip falsch, ersetze nur den Avatar; klingt er falsch, ersetze nur die Audiogruppe. Debugging mit zwei Variablen bei kostenpflichtigen Render-Aufrufen ist teuer.
Lege außerdem früh fest, ob deine Audiogruppe textgetrieben oder tonspurgetrieben ist, denn diese Wahl bestimmt das Tempo im nächsten Abschnitt – eine bereitgestellte Tonspur gibt das Timing vor, während generierte Sprache deinem Skript folgt.
Die genauen Feldnamen, zulässigen Werte und Standardwerte sind auf der Modellseite aufgeführt; lies sie einmal durch und fixiere sie in einem Konfigurationsobjekt, statt Literale über den Code zu verteilen.
Dein erster Aufruf mit curl
Beginne mit einem kurzen Clip. Das Ziel dieses Aufrufs ist nicht die Ausgabequalität – sondern die Ende-zu-Ende-Verifikation von Anmeldedaten, Payload-Form und Download-Pfad, bevor du irgendetwas automatisierst.
Lege den Schlüssel als Umgebungsvariable ab, damit er nie im Klartext in der Shell-Historie landet:
export HIAPI_API_KEY="your_key_here"
Sende dann eine minimale Anfrage. Ersetze die Platzhalter durch deine eigene Avatar-Auswahl und einen kurzen einzeiligen Skripttext:
curl -X POST "https://api.hiapi.ai/v1/generate" \
  -H "Authorization: Bearer $HIAPI_API_KEY" \
  -H "Content-Type: application/json" \
  -d '{
    "model": "heygen-avatar-iv",
    "input": {
      "avatar": "<avatar_identifier>",
      "script": "Dies ist ein dreißigsekündiger Test der Avatar-Pipeline. Wenn du diesen Satz auf dem Bildschirm lesen kannst, stimmt die Form der Anfrage.",
      "voice": "<voice_identifier>",
      "aspect_ratio": "9:16",
      "duration": 30
    }
  }'
Prüfe in dieser Reihenfolge:
- Authentifizierung. Ein Fehler bei den Anmeldedaten bedeutet hier Stopp – alles Nachgelagerte ist irrelevant.
- Payload-Validierung. Schemfehler zeigen das problematische Feld an. Behebe immer nur ein Feld auf einmal.
- Auftragsannahme. Ein erfolgreicher Aufruf gibt eine Job- oder Task-Referenz zurück, nicht unbedingt die fertige Datei. Die Generierung ist asynchron; protokolliere diese Kennung.
- Ergebnis abrufen. Nutze die zurückgegebene Referenz, um den Status abzufragen oder die Ergebnis-URL abzurufen, gemäß dem auf der Modellseite dokumentierten Antwortvertrag.
- Wiedergabe. Lade den Clip herunter und sieh ihn dir an. Prüfe, ob Bildkomposition, Ausrichtung und gesprochener Inhalt mit dem Skript übereinstimmen.
Bewahre diesen curl-Befehl in einer Scratch-Datei auf und trage deine echten Kennungen ein. Er wird dein Kontrollexperiment: Wenn die Python-Version Probleme macht, führe curl erneut aus, um zu beweisen, ob das Problem in deinem Code oder in den Eingaben liegt.
Umstieg auf Python für wiederholbare Generierung
Nachdem der curl-Aufruf erfolgreich war, kapsele ihn in eine Funktion. Der Punkt ist nicht Abstraktion um ihrer selbst willen – sondern jeder Parameter soll ein expliziter Parameter sein, sodass ein Clip vollständig durch die Aufrufstelle beschrieben wird.
import os
import requests

API_URL = "https://api.hiapi.ai/v1/generate"
API_KEY = os.environ["HIAPI_API_KEY"]

# Bleibt in einer Serie stabil
AVATAR = "<avatar_identifier>"


def generate_clip(script: str, voice: str, aspect_ratio: str = "9:16",
                  duration: int = 30) -> dict:
    payload = {
        "model": "heygen-avatar-iv",
        "input": {
            "avatar": AVATAR,
            "script": script,
            "voice": voice,
            "aspect_ratio": aspect_ratio,
            "duration": duration,
        },
    }
    resp = requests.post(
        API_URL,
        headers={
            "Authorization": f"Bearer {API_KEY}",
            "Content-Type": "application/json",
        },
        json=payload,
        timeout=120,
    )
    resp.raise_for_status()
    return resp.json()


if __name__ == "__main__":
    job = generate_clip(
        script="Dies ist ein dreißigsekündiger Test der Avatar-Pipeline.",
        voice="<voice_identifier>",
    )
    print(job)
Designpunkte, die sich später auszahlen:
- Standardwerte spiegeln deine häufigsten Clips wider. Wenn die meisten Ausgaben kurze Hochformat-Clips sind, mache diese zum Standard und überschreibe sie selten.
- Der Avatar liegt auf Modulebene. Die Avatar-Auswahl existiert an genau einer Stelle; ein Rebranding erfordert nur eine Zeile.
- Gib die vollständige Antwort zurück. Extrahiere nicht sofort die URL und verwirf das Job-Objekt; du wirst die Kennung für Logs und Wiederholungen brauchen.
- Wirf bei HTTP-Fehlern eine Exception. Stille Fehler in einer Batch-Schleife sind schlimmer als Abstürze.
- Behandle den asynchronen Schritt explizit. Füge einen kleinen Helfer
poll(job_id)hinzu, statt innerhalb der Generierungsfunktion zu schlafen.
Orientier dich bei der Antwortverarbeitung am dokumentierten Vertrag auf der Modellseite – die Feldnamen für Job-Status und Ergebnisabruf weichen am ehesten von deinen Annahmen ab.
Sprechskripte schreiben und das Tempo steuern
Videos mit digitalen Avataren sind audio-zuerst. Ein Skript, das auf Papier gut aussieht, ist beim Vorlesen oft zu lang, und nachträgliches Kürzen bedeutet, für Text zu rendern, der später herausgeschnitten wird.
Erst nach Länge schreiben, dann kürzen
Schätze die Dauer vor dem API-Aufruf. Ein angenehmes Tempo liegt bei etwa 130–160 Wörtern pro Minute; für technische Inhalte, denen die Zuschauer folgen müssen, nimm den unteren Bereich. Ein 30-Sekunden-Clip braucht also etwa 65–80 Wörter, ein 60-Sekunden-Clip etwa 130–160 Wörter. Entwirf dein Skript nach diesem Budget, lies es mit einem Timer laut vor und kürze dann. Wenn du kürzen musst, streiche ganze Sätze statt Wörter – auf Satzebene zu kürzen erhält den Rhythmus.
Für das Ohr schreiben
- Kurze Sätze. Ein Gedanke pro Satz. Nebensätze sind der Punkt, an dem das Verständnis abnimmt.
- Keine Verweise, die nur auf dem Visuellen beruhen. „Wie unten gezeigt“ funktioniert nicht ohne Folie.
- Die Kernaussage nach vorn. Zuschauer von Kurzvideos entscheiden in den ersten Sekunden; setze die Behauptung in den ersten Satz.
- Schreibe aus, was TTS falsch aussprechen würde. Abkürzungen, Versionsstrings und Produktnamen mit ungewöhnlicher Groß-/Kleinschreibung sollten so geschrieben werden, wie sie ausgesprochen werden sollen.
Tempo entlang der Zeitachse steuern
Lege das Skript in Zeitblöcken über die Ziellänge aus:
0–5s    Hook: Behauptung oder Problem
5–20s   Hauptteil: Mechanismus, zwei bis drei Sätze
20–28s  Detail: eine Zahl oder ein Beispiel, das es wert ist, behalten zu werden
28–30s  Abschluss: ein einziger Handlungsaufruf
Diese Blockstruktur ist zugleich ein Review-Artefakt – Reviewer können einen Block ablehnen, ohne dass du irgendetwas neu rendern musst. Wenn du das Skript jedes Clips in einer eigenen Datei ablegst und zusammen mit dem Code versionierst, der es rendert, wird die Batch-Schleife im nächsten Abschnitt vollständig reproduzierbar.
Seitenverhältnis, Dauer und Ausgabe festlegen
Entscheide vor dem ersten Rendering über Ausrichtung und Länge, abhängig von der Zielplattform. Einen fertigen Clip in eine zweite Ausrichtung neu zu rendern ist reine Verschwendung, und einen zu langen Clip neu zu schneiden bedeutet, auch das Audio neu zu generieren.
Seitenverhältnis
- 9:16 Hochformat – der Standard im Kurzvideo-Feed: Shorts, Reels, Stories und Mobile-first-Platzierungen. Entwirf die Komposition primär dafür; schneide, wo möglich, andere Formate aus einer Hochformat-Masterdatei.
- 16:9 Querformat – eingebettete Player, Landingpages, Dokumentationsvideos und Präsentationskontexte.
- 1:1 Quadrat – Feed-Platzierungen, die das Quadrat bevorzugen. Gut als sekundäre Ableitung.
Wenn deine Kampagne beide Ausrichtungen benötigt, behandle sie als zwei verschiedene Aufgaben mit unterschiedlichen Skripten, statt dasselbe Skript zweimal zu rendern – eine Zeile, die in einem 30-sekündigen Hochformat-Film funktioniert, hinterlässt in einem kürzeren quadratischen Schnitt oft eine Leerstelle.
Dauer
Lege die Dauer anhand des Skript-Budgets aus dem vorherigen Abschnitt fest, nicht umgekehrt. Übergib eine Dauer, die zur tatsächlichen Vorleselänge passt; Clips, die aufgefüllt oder mitten im Satz abgeschnitten werden, sehen einfach kaputt aus. Halte die Plattformziele in einer Konfiguration, damit sie sich leicht anpassen lassen:
TARGETS = {
    "vertical": {"aspect_ratio": "9:16", "duration": 30},
    "horizontal": {"aspect_ratio": "16:9", "duration": 45},
}
Ausgabe
Lade die fertigen Clips selbst herunter und speichere sie, statt dich auf temporäre Ergebnis-URLs zu verlassen. Eine einfache Konvention – {clip_id}-{orientation}-{version}.mp4 – hält Ableitungen nachvollziehbar und macht veraltete Dateien auf einen Blick erkennbar. Protokolliere die Job-Kennung zusammen mit der Datei, damit jeder Clip bis zu seiner exakten Anfrage zurückverfolgt werden kann.
Abgerechnet wird pro angeforderter Generierung – nach Dauer und Anzahl der Clips –, daher ist das Straffen des Skripts vor dem Rendern die günstigste Optimierung, die dir zur Verfügung steht. Aktuelle Tarife findest du im Preispaneel.
Mehrere Clips im Batch generieren
Mit einer funktionierenden Funktion ist die Stapelverarbeitung eine Schleife über eine Aufgabenliste. Der Schlüssel liegt darin, dass jede Aufgabe eine vollständige Beschreibung eines Clips ist.
JOBS = [
    {"id": "launch-vertical", "script_file": "scripts/launch.txt",
     "voice": "<voice_a>", "aspect_ratio": "9:16", "duration": 30},
    {"id": "launch-square", "script_file": "scripts/launch_sq.txt",
     "voice": "<voice_a>", "aspect_ratio": "1:1", "duration": 20},
    {"id": "changelog-vertical", "script_file": "scripts/changelog.txt",
     "voice": "<voice_b>", "aspect_ratio": "9:16", "duration": 30},
]

results = []
for job in JOBS:
    with open(job["script_file"]) as f:
        script = f.read().strip()
    print(f"submitting {job['id']} ({len(script.split())} words)")
    resp = generate_clip(
        script=script,
        voice=job["voice"],
        aspect_ratio=job["aspect_ratio"],
        duration=job["duration"],
    )
    results.append({"id": job["id"], "job": resp})
Muster, die sich lohnen:
- Skripte als Dateien statt String-Literale. Sie lassen sich reviewen, diffen und zwischen Ausrichtungen wiederverwenden.
- Wortzahl-Logging. Gib die Wortzahl jeder Aufgabe aus, um Skripte, die die Dauer überschreiten werden, vor dem kostenpflichtigen Rendern zu erkennen.
- Stabile Job-IDs. Verwende sie in Ausgabedateinamen und Logs, damit fehlgeschlagene Clips über zwanzig Läufe hinweg identifizierbar sind.
- Sanft scheitern, dann berichten. Umgib jede Übermittlung mit try/except, sammle Fehler und fahre fort – ein kaputtes Skript sollte nicht den ganzen Batch abbrechen.
- Rate Limits und Parallelität beachten. Beginne seriell; füge erst einen begrenzten Worker-Thread-Pool hinzu, wenn der serielle Lauf stabil ist.
- Ergebnisliste persistieren. Schreibe die Job-IDs in eine JSON-Datei, damit ein teilweise abgeschlossener Batch fortgesetzt statt neu gestartet werden kann.
Häufige Fehlerquellen und Prüfungen
Dies sind die Probleme, die zuerst auftreten. Jedes hat eine günstige Isolationsprüfung.
Fehlerhafte Eingabeformate
Schemfehler sind der häufigste erste Fehlschlag. Prüfung: Führe den ursprünglichen curl-Befehl mit denselben Kennungen aus. Wenn curl erfolgreich ist und Python scheitert, liegt der Bug in deiner Serialisierung – meist ein Typkonflikt, etwa ein String anstelle einer ganzzahligen duration, oder ein zusätzlicher Zeilenumbruch am Ende der Skriptdatei.
Audio passt nicht zum Skript
Wenn die Stimme etwas anderes sagt als beabsichtigt, oder der Clip stumm ist, ist die Audiogruppe falsch. Prüfung: Stelle fest, ob die Anfrage textgetrieben oder tonspurgetrieben ist, und ob du das passende Feld übergibst. Tonspur und Skriptfeld gleichzeitig anzugeben ist ein typischer stummer Konflikt – entscheide, welches Vorrang hat, und entferne das andere.
Falsche Ausrichtung oder schwarze Balken
Der Clip kommt mit schwarzen Balken oder einem unerwarteten Rahmen zurück. Prüfung: Vergewissere dich, dass aspect_ratio tatsächlich im Payload ankommt – ein Standardwert in der Funktion kann den Wert, den du zu übergeben glaubst, stillschweigend überschreiben. Protokolliere den zusammengesetzten Payload vor dem Senden.
Dauer stimmt nicht
Der Clip wird mitten im Satz abgeschnitten oder läuft nach. Prüfung: Vergleiche die Wortzahl des Skripts mit dem Dauerbudget. Korrigiere das Skript statt die Dauer, es sei denn, das Ziel selbst ist falsch.
Avatar-Drift innerhalb einer Serie
Clips derselben Kampagne sehen wie verschiedene Moderatoren aus. Prüfung: Stelle sicher, dass die Avatar-Kennung aus einer einzigen Konstante stammt und nicht aus einer aufgabenweisen Konfiguration.
Ausgabe abgeschnitten oder fehlend
Der Job ist erfolgreich, aber die Datei ist unvollständig. Prüfung: Vergewissere dich vor dem Download, dass der Job den erfolgreichen Endzustand erreicht hat, und dass du den Abrufvertrag auf der Modellseite befolgst, statt URLs zu raten.
Allgemeine Regel: ein Testclip, ein curl-Aufruf, eine Variable auf einmal. Validiere Ende-zu-Ende mit einem kurzen Hochformat-Rendering über den heygen-avatar-iv-Modell, bevor du die Schleife skalierst.
Ähnliche Artikel
Alle Artikel ansehen →-

Benutzerhandbuch
Leitfaden für den Einstieg in gpt-6.2-sol: Grenzen der Fähigkeiten, API-Anbindung und Hinweise zur Token-Abrechnung
Entscheidungshilfen und praktische Hinweise zur Anbindung für Engineering-Teams
-

Benutzerhandbuch
gpt-6.2-astra Einstiegsleitfaden: Grenzen der Textmodell-Fähigkeiten, Integrationspunkte und Kostenkontrolle
-

Benutzerhandbuch
Tripo H3.1 Einstiegsleitfaden: Drei Eingabewege, Parameter und Preiswahl
Praktische Entscheidungsfindung und Kostenkontrolle bei der 3D-Generierungsintegration für Entwickler