
Benutzerhandbuch
Vidu Q3 Mix Referenz-zu-Video-Anleitung: Fähigkeitsgrenzen, API-Parameter und Abrechnung
Integrationsentscheidungen und Praxis aus Entwicklersicht
Auf dieser Seite
Welches Problem löst dieses Modell
Die Eingabeform eines Videogenerierungsmodells entscheidet darüber, ob du die „Kontrolle“ in der Hand behältst. Text-zu-Video liefert nur einen Prompt, den Bildverlauf gestaltet das Modell frei; Bild-zu-Video liefert ein erstes Frame, und das Modell sorgt dafür, dass es „in Bewegung kommt“. Reference-to-Video (Referenz-zu-Video) geht einen dritten Weg: Du stellst Referenzmaterial bereit, und das Modell bezieht sich während der Generierung kontinuierlich darauf, statt es nur als erstes Frame zu behandeln.
vidu-q3-mix/reference-to-video ist genau in diesem Zweig angesiedelt. Es eignet sich für folgende Anforderungen:
- Charaktere oder Subjekte müssen über mehrere Einstellungen hinweg konsistent bleiben: Du hast kein fertiges Videomaterial, aber ein oder mehrere Referenzbilder, die das Aussehen des Subjekts repräsentieren, und möchtest, dass das Subjekt im Ergebnis „immer noch es selbst“ ist.
- Stil und Tonalität müssen verankert werden: Das Referenzmaterial trägt Licht, Material und Kompositionsneigung in sich; das Ergebnis übernimmt diese visuelle Sprache und ist so kontrollierbarer als eine rein textliche Beschreibung.
- Aus statischen Assets dynamische Inhalte machen: E-Commerce-Produkte, IP-Figuren, Konzeptdesigns und andere vorhandene Bildassets sollen in Kurzvideos umgewandelt werden.
Anders gesagt: Wenn dein Anliegen „gib mir irgendein Video, das der Beschreibung entspricht“ ist, ist Text-zu-Video direkter; wenn dein Anliegen „dieses Video muss wie das aussehen, was ich vorgebe“ ist, ist Referenz-zu-Video das passende Werkzeug. Frage dich bei der Auswahl zuerst: Habe ich einen visuellen Anker, der unbedingt erhalten bleiben muss? Wenn ja, nutze es.
Auf HiAPI.ai teilt dieses Modell denselben Aufrufkontext mit anderen Videomodellen; du musst keine separate Integrationslogik dafür aufbauen. Beim Modellwechsel ändern sich hauptsächlich die Fähigkeitsparameter, nicht die Projektstruktur.
Der entscheidende Unterschied zu Bild-zu-Video
Das Eingabebild bei Bild-zu-Video ist der „Startpunkt“, die Eingabe bei Referenz-zu-Video ist die „Einschränkung“. Ersteres gibt dem Modell ein Bild, das es fortsetzen muss; letzteres gibt dem Modell eine Reihe von Merkmalen, die es einhalten soll. Wenn du das verstehst, ergeben sich alle späteren Entscheidungen zu Materialvorbereitung und Parameteroptimierung von selbst.
Fähigkeitsgrenzen und ungeeignete Szenarien
Den Fähigkeitsbereich des Modells klar abzustecken ist wichtiger, als sich zu merken, was es unterstützt. Basierend auf der Fähigkeitsdefinition von reference-to-video lassen sich folgende Grenzen festhalten:
Was es abdeckt
- Videogenerierung auf Basis von Referenzmaterial als visuelle Grundlage: Die Merkmale der Referenzbilder werden in den Generierungsprozess eingebracht.
- Subjektkonsistenz und Stilkontinuität: Über mehrere Generierungen hinweg wird ein relativ stabiler Ausdrucks des Aussehens beibehalten.
- Inhaltssteuerung über Prompts: Das Referenzmaterial ist für „sieht es ähnlich aus“ zuständig, der Prompt für „was passiert“.
Was es nicht abdeckt
- Kein Ersatz für Text-zu-Video: Ohne Referenzmaterial sollte man den Prompt nicht extrem lang schreiben, um ein Referenzbild zu „simulieren“ – das ist der falsche Werkzeugeinsatz, und sowohl Ergebnis als auch Kosten sind unrentabel.
- Kein striktes Frame-für-Frame-Reproduktionswerkzeug: Referenz-zu-Video bedeutet nicht, ein Referenzbild präzise zu animieren, und man sollte nicht erwarten, dass es für jeden einzelnen Pixel des Referenzbilds geradesteht. Wenn dein Bedarf „dieses Bild muss sich originalgetreu bewegen“ ist, ist Bild-zu-Video näher dran.
- Keine unbegrenzte Dauer garantiert: Die konkrete Obergrenze der Dauer pro Generierung richtet sich nach den verfügbaren Parametern der Schnittstelle und des Plattform-Panels; gestalte Produktabläufe nicht nach dem Motto „so lange, wie ich will“.
- Kein Ersatz für Postproduktion: Untertitel, Schnitt, Zusammenfügen mehrerer Segmente und Audiospur-Synthese bleiben Aufgaben deiner Pipeline.
Die häufigste Fehlanwendung bei der Auswahl
Die typischste Fehlanwendung ist, Referenz-zu-Video als „günstigeres Bild-zu-Video“ zu betrachten. Die Eingabesemantik beider ist unterschiedlich, und die Ergebnis-Erwartungen ebenfalls: Wenn du eigentlich eine strikt ausgerichtete erste Einstellung brauchst, liefert Referenz-zu-Video oft ein „ähnliches, aber anderes“ Ergebnis, und wiederholtes Nachbessern vervielfacht nur die Kosten. Umgekehrt, wenn du über mehrere Einstellungen hinweg ein stabiles Subjekt brauchst und bei Bild-zu-Video segmentweise Bilder einspeist, kommt es eher zu Aussehens-Drift.
Die Entscheidungsregel lässt sich auf einen Satz reduzieren: Willst du einen Startpunkt, wähle Bild-zu-Video; willst du eine Einschränkung, wähle Referenz-zu-Video.
API-Parameter und Ablaufpunkte beim Aufruf
Die technische Komplexität bei der Integration solcher Modelle liegt vor allem nicht im „Anfrage senden“, sondern in der „Eingabevorbereitung“ und der „Ablauforganisation“. Die gesamte Kette lässt sich in vier Abschnitte unterteilen:
1. Referenzmaterial vorbereiten
Vor dem Aufruf sollte das Referenzmaterial normalisiert werden: einheitliche Größe und Seitenverhältnisse, Wasserzeichen und überflüssige Hintergrundelemente entfernen, sicherstellen, dass das Subjekt klar und die Beleuchtung konsistent ist. Nur wenn dieser Schritt solide ist, haben spätere Parameter-Feinjustierungen Bedeutung.
2. Anfrage aufbauen
Ein typischer Aufruf erfordert drei Arten von Informationen in der Anfrage:
- Fähigkeitskennung:
vidu-q3-mix/reference-to-videoangeben, damit die Anfrage im richtigen Fähigkeitszweig landet. - Referenzmaterial: Position oder Upload-Handle des Referenzbilds; konkrete Feldnamen und akzeptierte Formen richten sich nach der Schnittstellendokumentation.
- Generierungsbeschreibung: Prompt, der Aktion, Kamerabewegung, Rhythmus und Atmosphäre beschreibt, statt das im Referenzbild bereits vorhandene Aussehen zu wiederholen.
Konkrete Feldnamen, Pflichtfelder und Wertebereiche entnimm bitte der Schnittstellendokumentation und der Modelldetailseite von HiAPI.ai. Dieser Artikel erfindet keine Felder; beim Integrieren einfach nach Dokumentation zusammenbauen.
3. Generierungsaufgabe
Videogenerierung ist im Wesentlichen asynchron: Nach dem Absenden der Anfrage wird eine Aufgabenkennung zurückgegeben, und die Inferenz auf Modellseite braucht Zeit. Dein Server sollte „Absenden“ und „Ergebnis abholen“ entkoppeln und mit der Aufgabenkennung pollen oder Callbacks empfangen, statt in einer synchronen Anfrage zu warten.
4. Ergebnis abholen und wiederholen
Nach Erhalt des Ergebnisses zuerst eine Nutzbarkeitsprüfung durchführen (lässt sich die Datei normal dekodieren, entspricht die Dauer den Erwartungen), dann über eine Wiederholung entscheiden. Der Wiederholungszweig braucht eine Obergrenze, und jeder Fehlergrund sollte protokolliert werden – das ist entscheidend für die Kostenschätzung.
Wie der Prompt geschrieben werden sollte
Beim Prompt für Referenz-zu-Video sollte der Schwerpunkt auf „Informationen außerhalb des Referenzbilds“ liegen: Was soll das Subjekt im Bild tun, wie bewegt sich die Kamera, wie verändert sich die Umgebung. Länge damit zu verbringen, bereits im Referenzbild Vorhandenes zu wiederholen, ist eine häufige Verschwendung. Je konkreter die Beschreibung und je näher an einer ausführbaren Bildanweisung, desto stabiler das Generierungsergebnis.
Kosten mit $0,1865/Sekunde schätzen
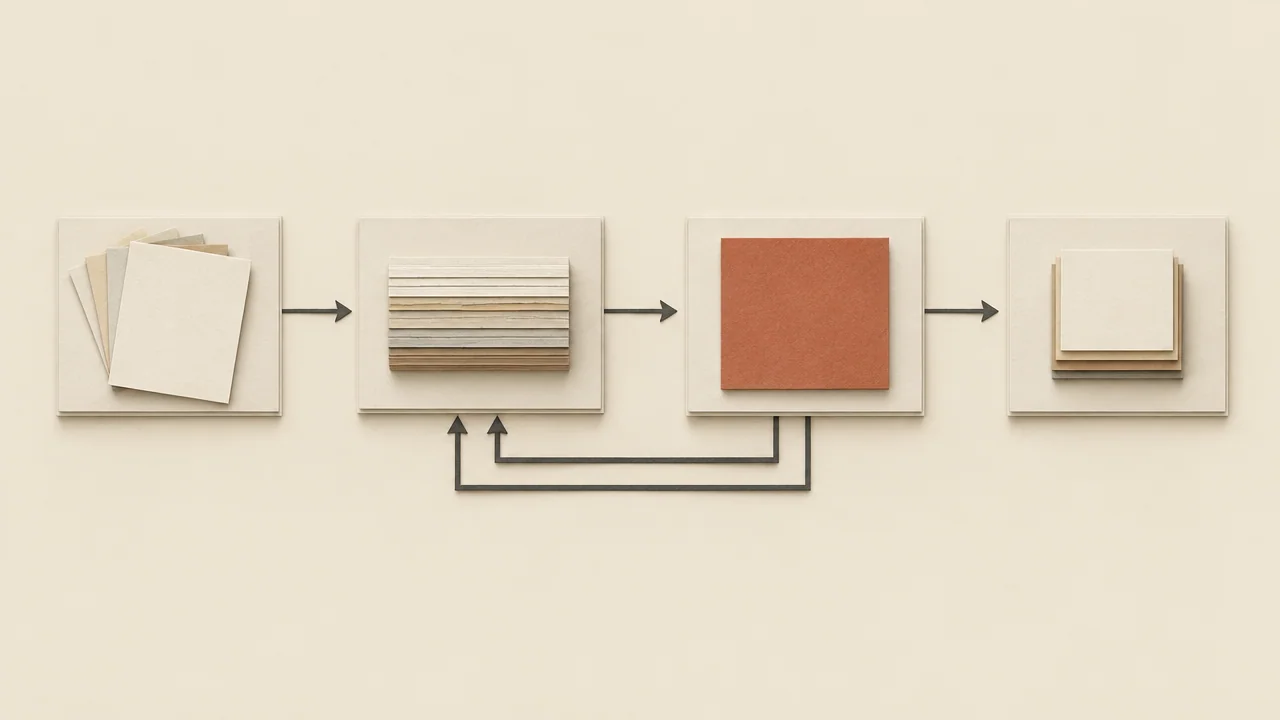
Die Abrechnungsgrundlage dieses Modells ist Abrechnung nach Sekunden des Ausgabevideos zum Stückpreis von $0,1865 pro Sekunde. Wenn du das verstehst, wird die Kostenschätzung zu einer einfachen Multiplikationsaufgabe.
Kostenformel pro Video
Kosten pro Video = Ausgabedauer (Sekunden) × $0,1865
Ein 5-Sekunden-Video kostet 5 × 0,1865; 10 Sekunden kosten 10 × 0,1865. Verdoppelte Dauer bedeutet linear verdoppelte Kosten – keine Staffelung und kein versteckter Rabatt für „einmalige längere Generierung“, daher muss das Dauerbudget von Anfang an in das Produktdesign einfließen.
Wiederholungen mit einrechnen
Die realen Kosten sind nie „der Preis eines Videos“. Die Generierung ist mit Unsicherheit behaftet, du musst ein Wiederholungsbudget für Fehlschläge und Unzufriedenheit einplanen:
Erwartete Gesamtkosten = Kosten pro Video × erwartete Versuchsanzahl
erwartete Versuchsanzahl ≈ 1 + Wiederholungsrate
Beispiel: Wenn eine 8-sekündige Generierungsaufgabe im Durchschnitt eine Wiederholung braucht, um ein brauchbares Ergebnis zu liefern, betragen die tatsächlichen Kosten 8 × 0,1865 × 2 statt 8 × 0,1865. Bei Teams mit hoher Wiederholungsrate vervielfachen sich die Kosten – das ist ein versteckter Kostenfaktor, den viele Integratoren erst nach dem Skalieren entdecken.
Drei Ansatzpunkte zur Budgetkontrolle
- Erst kurz, dann lang: In der Debug-Phase mit der kürzesten Dauer prüfen, ob Prompt und Material zusammenpassen; erst nach Bestätigung verlängern. Kurze Videos haben deutlich niedrigere Trial-and-Error-Kosten.
- Obergrenze für Wiederholungen setzen: Jeder Aufgabe eine maximale Versuchsanzahl geben; bei Überschreitung manuell eingreifen oder Material wechseln, damit automatische Wiederholungen nicht das Budget auffressen.
- Jeden Aufruf protokollieren: Dauer, ob wiederholt wurde, Fehlergrund als Telemetrie melden. Ohne diese Daten kannst du nicht beurteilen, ob Budgetüberschreitungen von Prompt- oder Materialproblemen stammen.
Aktuelle Preise und Abrechnungsdetails richten sich nach dem Preispaneel auf der HiAPI.ai-Website; dieser Artikel diskutiert nur die Schätzmethode.
Ansätze zur Vorbereitung und Optimierung von Referenzmaterial
In dieser Referenz-zu-Video-Kette gilt: Die Materialqualität hat meist größeren Einfluss auf das Ergebnis als Parameter-Feinjustierung. Der Grund: Parameter justieren die „Neigung“ des Modells, Material bestimmt die „Grundlage“. Ist die Grundlage unklar, kann auch die beste Neigung nicht greifen.
Was gutes Referenzmaterial ausmacht
- Klares Subjekt: Der Betrachter erkennt innerhalb einer halben Sekunde, „was in diesem Bild erhalten bleiben soll“. Viel Hintergrundunruhe und ein kleiner Subjektanteil schwächen den Referenzeffekt.
- Stabile Merkmale: Das Aussehen desselben Subjekts sollte in verschiedenen Referenzbildern konsistent sein. Wenn mehrere Referenzbilder sich selbst widersprechen (Farbe, Form, Material passen nicht zusammen), kann das Modell nur zwischen den Versionen schwanken.
- Vernünftiges Licht und plausible Winkel: Extreme Beleuchtung und stark verzerrte Winkel vermitteln dem Modell falsche visuelle Hinweise.
- Sauber: Wasserzeichen, Sticker und überflüssigen Text entfernen. Diese Elemente könnten als Subjektmerkmale übernommen werden.
Prioritäten der Optimierung
Wenn das Ergebnis nicht zufriedenstellt, empfiehlt es sich, in dieser Reihenfolge zu prüfen, statt sofort Parameter zu ändern:
- Zuerst Material wechseln: Das Referenzbild durch eine klarere Version mit eindeutigerem Subjekt ersetzen ist oft die schnellste Verbesserung.
- Dann den Prompt ändern: Aktion und Umgebung klar benennen, Beschreibungen streichen, die das Referenzbild wiederholen.
- Erst zuletzt Parameter anfassen: Nachdem die ersten beiden Schritte stabil sind, Feinjustierung erwägen, und dabei immer nur eine Variable ändern, um die Ursache zuordnen zu können.
Konsistenz bei mehreren Referenzbildern
Wenn du mehrere Referenzmaterialien bereitstellst, stelle unbedingt sicher, dass sie „dasselbe Subjekt“ zeigen. Das Einmischen verschiedener Individuen oder Stile ist eine der häufigsten Ursachen für Ergebnis-Drift. Lieber ein Bild weniger geben als ein widersprüchliches Bild.
Eine Materialbasislinie aufbauen
Es empfiehlt sich, für deine Kernsubjekte ein festes Referenzmaterial-Set als Basislinie für alle späteren Generierungen aufzubauen. Jede Generierung startet von dieser Basislinie, und nur der Prompt wird geändert; so kannst du sauber zwischen „Materialproblem“ und „Beschreibungsproblem“ unterscheiden und die Stilkonsistenz zwischen mehreren Videosegmenten leichter sicherstellen.
Häufige Fehler und Fehlersuche
Die meisten Probleme in der Integrationsphase lassen sich in einige feste Muster einordnen. Die folgende Reihenfolge ist meist schneller als blindes Wiederholen.
1. Anfrage abgelehnt oder Parameterfehler zurückgegeben
Zuerst prüfen, ob die Fähigkeitskennung korrekt ist, ob die Pflichtfelder für Referenzmaterial vollständig sind und ob die Materialform von der Schnittstelle akzeptiert wird. Feldnamen richten sich nach der Dokumentation, nicht nach Vermutungen.
2. Aufgabe liefert lange kein Ergebnis
Videogenerierung ist eine asynchrone Aufgabe; prüfe zuerst, ob du das Ergebnis über die Aufgabenkennung abholst, statt in einer synchronen Anfrage zu warten. Bei tatsächlichem Timeout prüfen, ob das Materialvolumen zu groß ist.
3. Ergebnis „ähnelt“ dem Referenzmaterial nicht
Das ist das häufigste Problem; Prüfreihenfolge: Ist das Material klar → wurden widersprüchliche Referenzbilder gegeben → beschreibt der Prompt Inhalte, die dem Referenzbild widersprechen. In den meisten Fällen liegt es nicht am Modell, sondern am unzureichenden Material.
4. Subjekt driftet zwischen Segmenten
Ursache ist meist, dass jedes Segment anderes Referenzmaterial verwendet oder die Prompt-Beschreibung des Subjekts zwischen den Segmenten inkonsistent ist. Ein festes Basislinien-Material-Set und eine einheitliche Subjektbeschreibung verbessern das deutlich.
5. Bildaktion weicht von der Erwartung ab
Fehlen im Prompt klare Aktions- und Kameraanweisungen, kann das Modell nur frei gestalten. Schreibe klar, „was passiert, wie es sich bewegt, wo die Kamera steht“.
6. Kosten übersteigen die Erwartung
Aufrufprotokolle prüfen: Wurde die Dauer zu lang eingestellt, oder ist die Wiederholungsrate zu hoch? Ersteres erfordert Anpassung der Dauerstrategie auf Produktseite, letzteres führt zurück zu Material und Prompt.
Grundprinzip der Fehlersuche
Immer nur eine Variable ändern und Logs aufbewahren. Wenn du Material und Prompt gleichzeitig änderst, weißt du selbst bei besserem Ergebnis nicht, welches den Ausschlag gab, und musst beim nächsten ähnlichen Problem wieder von vorn beginnen.
Checkliste vor der Integration und nächste Schritte
Vor dem offiziellen Skalieren empfiehlt es sich, die folgende Checkliste Punkt für Punkt zu verifizieren, um Risiken in der Phase mit kleinem Traffic abzufangen.
Checkliste vor dem Start
- Fähigkeit passt: Bestätige, dass dein Szenario tatsächlich Referenz-zu-Video braucht und nicht Text-zu-Video oder Bild-zu-Video.
- Materialbasislinie bereit: Für die Kernsubjekte gibt es ein festes, sauberes Referenzmaterial-Set.
- Prompt als Template: Beschreibungen von Aktion, Kamera und Umgebung haben eine wiederverwendbare Struktur statt jedes Mal Improvisation.
- Asynchrone Kette funktioniert: Absenden, Polling oder Callback, Ergebnisprüfung, Wiederholung bei Fehlschlag – alle vier Abschnitte sind implementiert und lastgetestet.
- Wiederholung hat Obergrenze: Automatische Wiederholung hat eine maximale Anzahl; bei Überschreitung geht es in die manuelle Warteschlange.
- Kosten haben ein Dashboard: Aufrufe werden mit Dauer und Wiederholungsanzahl protokolliert, sodass tatsächliche Ausgaben jederzeit berechenbar sind.
- Dauerstrategie klar: Auf Produktseite gibt es Einschränkungen für die generierbare Dauer, damit Nutzer sie nicht beliebig verlängern und die Kosten außer Kontrolle geraten.
Vom kleinen Traffic zum Skalieren
Empfohlener Weg: Zuerst mit manuell konstruierten Anfragen Ende-zu-Ende durchlaufen und die Wirksamkeit von Material und Prompt verifizieren; dann mit kürzester Dauer einen kleinen Testlauf durchführen und Wiederholungsrate sowie Nutzbarkeitsrate statistisch erfassen; nach Stabilisierung der Kennzahlen schrittweise Parallelität und Dauer erhöhen. Bei jedem Schritt Rollback-Fähigkeit bewahren.
Wichtige Kennzahlen
In der Skalierungsphase sind vor allem die Erstnutzbarkeitsrate und die durchschnittliche Versuchsanzahl im Blick zu behalten. Erstere bestimmt das Nutzererlebnis, letztere direkt die Kosten. Erst wenn diese beiden Kennzahlen stabil sind, lässt sich über eine Erweiterung von Dauer und Parallelität sprechen.
Wenn du noch nicht angefangen hast, kannst du zuerst auf HiAPI.ai die Modelldetails und den aktuellen Preis von vidu-q3-mix/reference-to-video nachsehen und dann entscheiden, wie lang dein erstes generiertes Video sein soll.
Ähnliche Artikel
Alle Artikel ansehen →-

Benutzerhandbuch
Leitfaden für den Einstieg in gpt-6.2-sol: Grenzen der Fähigkeiten, API-Anbindung und Hinweise zur Token-Abrechnung
Entscheidungshilfen und praktische Hinweise zur Anbindung für Engineering-Teams
-

Benutzerhandbuch
gpt-6.2-astra Einstiegsleitfaden: Grenzen der Textmodell-Fähigkeiten, Integrationspunkte und Kostenkontrolle
-

Benutzerhandbuch
Tripo H3.1 Einstiegsleitfaden: Drei Eingabewege, Parameter und Preiswahl
Praktische Entscheidungsfindung und Kostenkontrolle bei der 3D-Generierungsintegration für Entwickler