
Guía de uso
Guía de uso de ElevenLabs Text to Dialogue: enviar audio de diálogo entre dos personas con el array dialogue
Desde la división de un guion de dos personas hasta la solicitud de voz por línea, envío y validación según el contrato actual de HiAPI
En esta página
Primero confirma que necesitas síntesis de diálogo y no una lectura de un solo fragmento
Si tu material es un guion de diálogo entre dos personas (o más personajes), lo más directo suele ser sintetizar cada línea por separado y luego concatenarlas en orden. El problema de este enfoque aparece recién en la etapa de entrega: cada línea es un audio independiente, y las pausas entre frases, la continuidad del ritmo y la consistencia de las voces tienes que compensarlas en la capa de concatenación; cuando hay muchos personajes, el orden de concatenación y los desajustes de voz se convierten en la principal fuente de errores.
La propuesta de elevenlabs/text-to-dialogue es expresar todo el diálogo en una sola solicitud. Divides el guion completo en un array dialogue y lo envías; el modelo completa el diálogo con múltiples voces en una misma generación y la salida es un único audio completo. En comparación con «múltiples síntesis de un solo fragmento + concatenación», la asignación de personajes y el orden de las líneas quedan dentro del cuerpo de la solicitud, y en la validación solo necesitas revisar un resultado.
Por lo tanto, primero haz una evaluación:
- Si el contenido es una lectura continua de un mismo hablante, basta con texto a voz y no se necesita el array
dialogue; - Si el contenido es un diálogo alternado entre dos o más personajes y deseas una escucha global uniforme, debes usar el array
dialoguede esta interfaz; - Si el contenido es un diálogo pero el total de caracteres supera ampliamente el límite, debes dividirlo por segmentos semánticos y enviarlo por partes, no volver a la síntesis línea por línea.
Una vez confirmado que perteneces al segundo caso, lo siguiente es entender la estructura del array en sí.
Estructura del array dialogue: text y voice por línea
En el contrato de HiAPI, la entrada de elevenlabs/text-to-dialogue tiene un único campo obligatorio central: dialogue. Es un array con un mínimo de 1 elemento; cada elemento es una línea de diálogo y contiene dos subcampos obligatorios:
text: el texto de esa línea, cadena, mínimo 1 carácter;voice: la voz usada en esa línea, cadena; puede ser un nombre de voz predefinida o unvoice_id, por defectoEkK5I93UQWFDigLMpZcX.
Ambos campos son obligatorios; incluso si solo quieres usar la voz predeterminada, se recomienda escribir voice explícitamente para que el cuerpo de la solicitud se explique por sí mismo. Una forma mínima de solicitud para dos personas es la siguiente:
{
  "dialogue": [
    { "text": "¿Cómo va el progreso por tu lado?", "voice": "EkK5I93UQWFDigLMpZcX" },
    { "text": "Esta semana puedo entregar la primera versión.", "voice": "Z3R5wn05IrDiVCyEkUrK" },
    { "text": "Bien, entonces primero te envío la lista de validación.", "voice": "EkK5I93UQWFDigLMpZcX" }
  ]
}
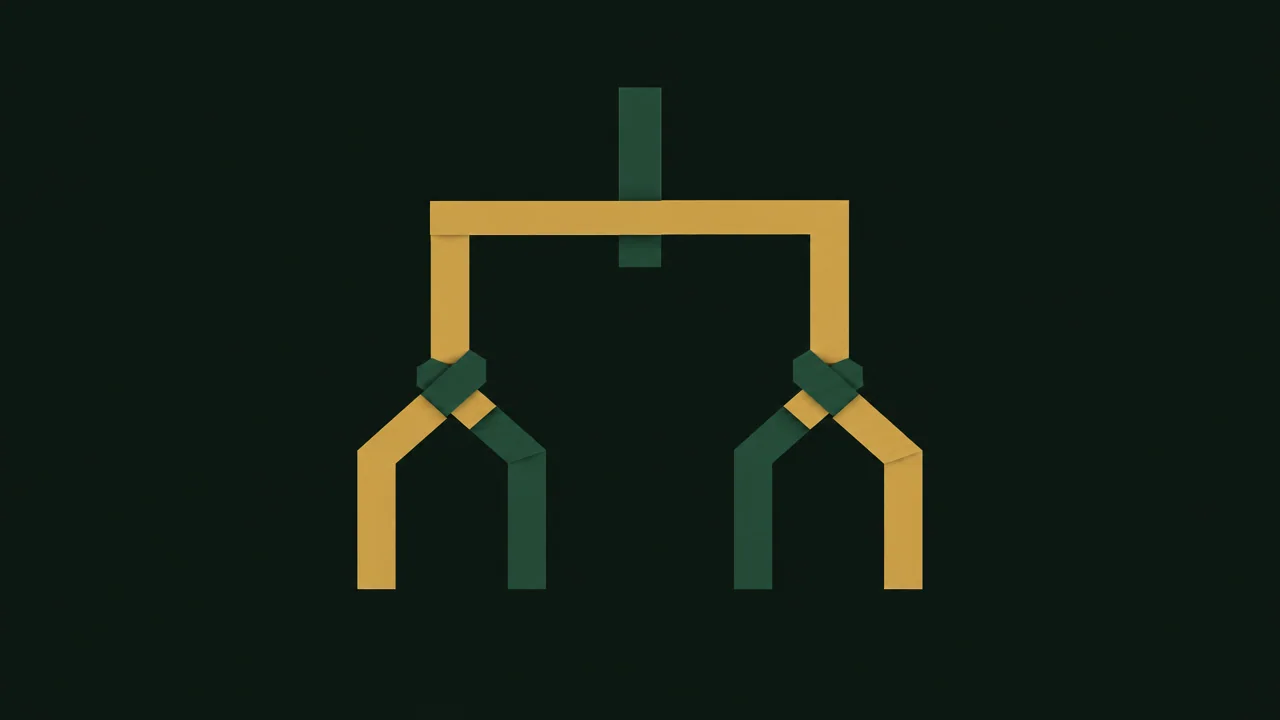
Ten en cuenta que el orden del array es el orden del diálogo; la interfaz no tiene un campo adicional de «hablante», y los personajes se distinguen completamente por voice. Este es el punto que más necesita diseñarse con anticipación en todo el proceso de integración.
Dividir el guion de dos personas en entradas línea por línea
Para pasar del texto del guion al array dialogue, se recomienda seguir un flujo fijo y evitar errores al escribir JSON a mano.
Paso 1: dividir por líneas y etiquetar al hablante
Organiza el guion en una estructura de pares «hablante + línea», una entrada por frase; no fusiones las líneas de dos personajes en un mismo text, porque un elemento solo puede llevar un voice y, tras la fusión, no se pueden distinguir los personajes. La narración y las acotaciones escénicas entre paréntesis no son líneas de diálogo; deben eliminarse por separado y no meterse en text.
Paso 2: limpiar el texto
Revisa cada entrada: elimina espacios al inicio y al final, unifica la puntuación y los saltos de línea, y borra las líneas vacías. La longitud mínima de text es de 1 carácter y una cadena vacía dispara directamente un fallo de validación. Si una línea solo tiene interjecciones (como «mmm» o «sí»), consérvala; pero si tras la limpieza queda vacía, confirma con el responsable del contenido si se elimina esa línea.
Paso 3: establecer el mapeo de personajes y generar el array
Cada etiqueta de hablante se asigna a una voz única y luego se generan los elementos en el orden de las líneas. El pseudocódigo sería aproximadamente:
speaker_voice = {
    "A": "EkK5I93UQWFDigLMpZcX",
    "B": "Z3R5wn05IrDiVCyEkUrK",
}

dialogue = [
    {"text": line.text, "voice": speaker_voice[line.speaker]}
    for line in script
]
Errores comunes
- Usar voces distintas para el mismo personaje en dos lugares provoca una escucha claramente fragmentada;
- Omitir
voicehace que todo el segmento caiga en la voz predeterminada y el diálogo de dos personas se convierte en «una persona interpretando dos papeles»; - El orden del array se altera por lógicas de ordenación o deduplicación y la semántica del diálogo se rompe.
Después de generar, imprime primero algunos elementos y revísalos manualmente antes de pasar al presupuesto de caracteres.
Mapeo fijo de voces: un solo voice por personaje
La razón para «fijar» voice es que determina tanto el timbre en sí como la semántica de «quién está hablando». Si un mismo personaje aparece con dos valores de voice distintos en todo el diálogo, el oyente pensará que cambió la persona; a la inversa, si dos personajes coinciden en el mismo voice, el diálogo pierde capacidad de distinción.
En la práctica, se recomienda mantener en el código una tabla de constantes que asigne personajes a voces, en lugar de dispersar literales de cadena en cada línea de diálogo:
const VOICE = {
  host: "EkK5I93UQWFDigLMpZcX",
  guest: "Z3R5wn05IrDiVCyEkUrK",
};
Todas las líneas toman el valor solo de esta tabla; los cambios de línea o la reordenación del guion no romperán la consistencia. voice admite nombres de voces predefinidas o voice_id; si el equipo ya tiene su propio sistema de nombres de voces, se puede hacer una conversión en la capa de configuración y unificar al valor aceptado por la interfaz al momento de la solicitud. El contrato incluye una enumeración de voces; validarla antes de enviar bloquea problemas básicos como errores de ortografía: los valores fuera de la enumeración no se tratan silenciosamente como el valor predeterminado.
Otro punto que suele pasarse por alto es la estabilidad entre segmentos. Cuando el total de caracteres supera el límite y es necesario dividir en varias solicitudes, la tabla de mapeo de voces debe reutilizarse tal cual; no elijas nuevas voces en la nueva solicitud, de lo contrario el mismo personaje sonará diferente en distintos segmentos.
Presupuesto de caracteres y división de solicitudes
La interfaz tiene una restricción estricta de volumen: el total de caracteres de todos los campos text del array dialogue no debe superar los 5000. Ten en cuenta que es la suma de todos los textos del array, no la longitud de una línea ni el número de elementos. Normalmente los caracteres chinos, ingleses y la puntuación cuentan como caracteres; al estimar, es preferible dejar margen con el criterio más amplio.
La lógica de conteo debe escribirse después de generar el array y antes de enviar la solicitud:
total = sum(len(item["text"]) for item in dialogue)
assert total <= 5000
Cuando se supera el límite, lo correcto es dividir por límites semánticos en varios subdiálogos, enviarlos por separado, obtener los audios por separado y combinarlos según las necesidades del negocio; no se deben truncar líneas ni eliminar frases. Al dividir, ten en cuenta tres puntos:
- Elige puntos de corte en cambios de escena o de tema, y evita separar una pregunta y su respuesta en dos solicitudes;
- Cada subfragmento se cuenta por separado y tampoco debe superar los 5000;
- Al reconstruir el array de cada fragmento, mantén el orden de líneas original y el mapeo de voces por personaje.
Si el contenido es en sí un diálogo largo, se recomienda organizarlo desde el lado del contenido por «actos» o «capítulos», de modo que cada acto caiga naturalmente dentro del presupuesto y se reduzcan las discontinuidades de escucha provocadas por divisiones improvisadas.
Parámetros opcionales: stability y language_code
Además de dialogue, la interfaz ofrece dos parámetros opcionales; su elección depende del tipo de contenido.
stability
stability es un parámetro numérico que puede tomar 0, 0.5 o 1, con valor predeterminado 0.5. Su significado es la estabilidad de la voz:
- Cuanto menor es el valor, más rica es la emoción y más variación hay; es adecuado para diálogos con altibajos emocionales y contenido dramático;
- Cuanto mayor es el valor, más estable y consistente es la salida; es adecuado para anuncios de marca, guiones de atención al cliente y otros escenarios que requieren una escucha uniforme;
- El valor predeterminado 0.5 es un punto medio entre ambos.
Ten en cuenta que es un parámetro a nivel de toda la solicitud, no una configuración por línea. Cuando las diferencias emocionales entre personajes en un mismo diálogo son grandes, o aceptas un valor de compromiso o, al dividir en segmentos, haces que distintos fragmentos usen distintos stability.
language_code
language_code es un código de idioma en formato ISO, con valor predeterminado cadena vacía; dejarlo vacío significa detección automática del idioma. Cuando el idioma del contenido es claro y se desea evitar desviaciones de detección, especificarlo explícitamente es más seguro; por ejemplo, para contenido en chino se usa zh. El contrato incluye una enumeración completa de códigos de idioma; se debe validar antes de enviar para evitar valores no admitidos.
Ninguno de los dos parámetros es obligatorio; si el contenido no tiene requisitos especiales, omitirlos y usar el comportamiento predeterminado es completamente válido.
Envío y validación: revisar según el contrato basado en tareas
Esta interfaz se envía en forma de tarea: envías la entrada, obtienes un resultado de tarea y luego validas ese resultado. Esto implica dos cosas.
Primera, el contrato de entrada debe validarse por tu cuenta. Antes de enviar la solicitud, revisa punto por punto: dialogue es un array con al menos 1 elemento; cada elemento tiene text y voice no vacíos; el total de caracteres de todos los text no supera 5000; stability solo toma 0/0.5/1; language_code pertenece a la enumeración o está vacío. Colocar estas comprobaciones en el cliente reduce significativamente los envíos inválidos.
Segunda, no supongas comportamientos no declarados en el contrato. La documentación de la interfaz no promete reintentos automáticos, claves de idempotencia ni compensación de fallos, así que no te apoyes en «reenviar la misma solicitud» como respaldo: cada envío debe considerarse una tarea independiente. Las prácticas seguras de ingeniería son:
- Antes de enviar, registra un resumen de la entrada de esta solicitud (número de elementos del array, total de caracteres, versión del mapeo de voces) para facilitar la comparación posterior;
- Tras recibir el resultado, confirma primero que el audio es utilizable, que la duración es razonable y que los personajes se distinguen, y luego distribúyelo aguas abajo;
- Si necesitas volver a ejecutar, realiza de nuevo toda la validación de entrada en lugar de reutilizar un cuerpo de solicitud antiguo no verificado.
El foco de la validación es «si el resultado cumple lo esperado», no especular sobre los procesos internos del servidor. En HiAPI, puedes consultar el contrato actual en la página del modelo elevenlabs/text-to-dialogue antes de empezar.
Lista de autoverificación antes del lanzamiento
Fija el siguiente conjunto de comprobaciones como flujo automático antes de enviar; básicamente cubre la gran mayoría de las causas de fallo:
dialoguees un array con número de elementos ≥ 1;- Cada elemento contiene simultáneamente
textyvoice, y ninguno es cadena vacía; - Cada
voiceestá dentro de la enumeración del contrato, y el mismo personaje usa globalmente el mismo valor; - El orden del array coincide con el orden de las líneas del guion, sin lógicas de ordenación o deduplicación;
- El total de caracteres de todos los
textes ≤ 5000, y el contenido que excede el límite ya se dividió semánticamente; - Si se establece explícitamente,
stability∈ {0, 0.5, 1},language_code∈ enumeración o vacío; - El resumen de la entrada (número de elementos, número de caracteres, versión del mapeo) está registrado para facilitar la comparación en la validación.
Además de la lista, hay una regla empírica: primero ejecuta de extremo a extremo con una muestra corta y luego amplía al guion completo. Problemas como el mapeo de personajes y el presupuesto de caracteres se exponen con una muestra de pocas decenas de líneas; no es necesario esperar a enviar todo el contenido para descubrirlos.
Artículos relacionados
Ver todos los artículos →-

Guía de uso
Guía de inicio con gpt-6.2-sol: límites de capacidad, integración vía API y consideraciones sobre el precio por token
Puntos clave de decisión e implementación de la integración para equipos de ingeniería
-

Guía de uso
Guía de inicio de gpt-6.2-astra: límites de capacidad del modelo de texto, puntos clave de integración y control de costes
-

Guía de uso
Guía de inicio de Tripo H3.1: cómo elegir entre tres modos de entrada, parámetros y precios
Guía práctica de decisiones de integración y control de costes de la generación 3D para desarrolladores