
Guía de uso
Guía de inicio de gemini-4-hydrogen: límites de capacidad, puntos clave de los parámetros y prácticas de integración
Referencia de integración y selección de modelos de texto para equipos de ingeniería
En esta página
Posicionamiento y límites de capacidad de gemini-4-hydrogen
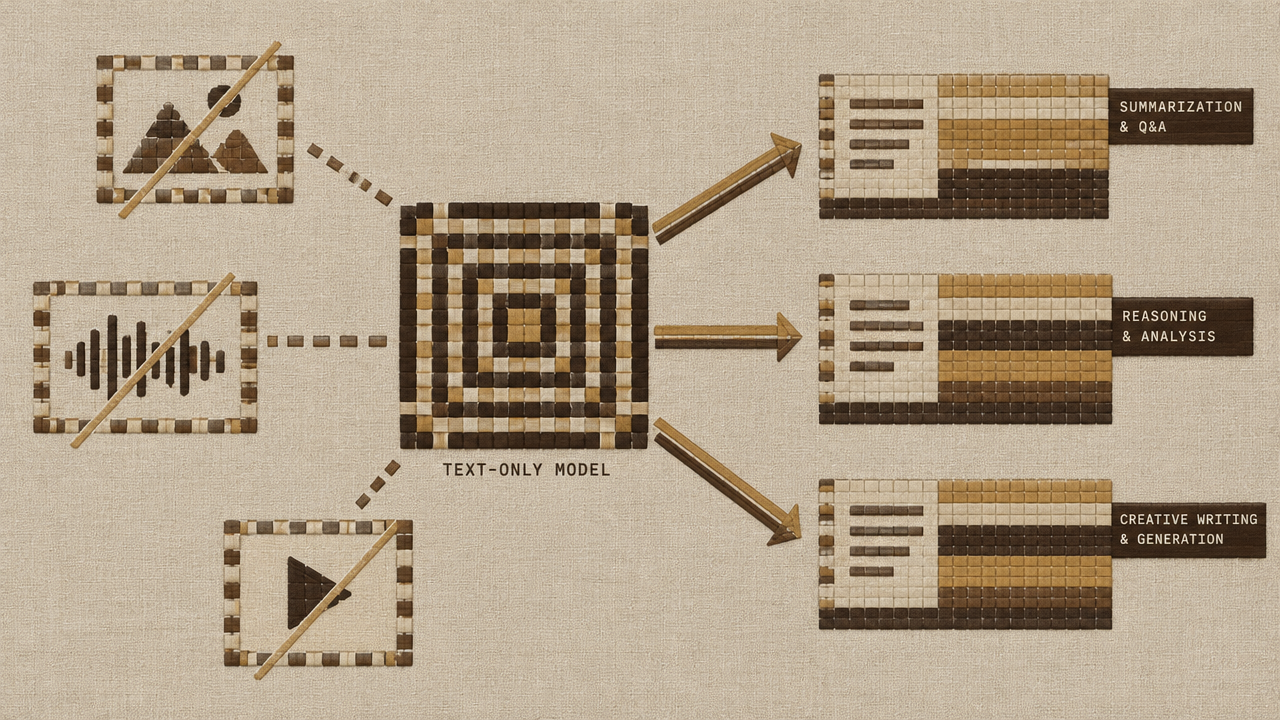
gemini-4-hydrogen es un modelo de texto lanzado por Google. Su tipo de salida es texto plano, lo que determina en qué punto de tu arquitectura debes colocarlo: en los eslabones de entrada de texto y salida de texto, no como una pieza de un flujo multimodal.
Para qué es bueno
Desde la perspectiva de la ingeniería, el destino más típico de un modelo con salida de texto plano son aquellas tareas en las que «el producto intermedio es un fragmento de texto»:
- Extracción y transformación estructurada: convertir texto no estructurado en JSON, filas de tabla, listas de campos u otros formatos acordados;
- Resumen y reescritura: compresión de documentos largos, ajuste de tono, unificación de expresiones multilingües;
- Clasificación y determinación: reconocimiento de intenciones, clasificación de contenido, enrutamiento de tickets, usando salidas cortas para reducir la latencia;
- Asistencia generativa: redacción de borradores, autocompletado de comentarios de código, expansión de prompts y otras etapas previas a la revisión humana;
- Diálogo y preguntas y respuestas: organización de respuestas con un contexto de recuperación previo.
La característica común de estas tareas es que la entrada puede serializarse como texto, la salida puede ser analizada por programas posteriores y el resultado puede revisarse por muestreo.
Para qué no es adecuado
También como criterio de ingeniería, conviene delimitar de antemano los límites:
- No esperes que produzca directamente imágenes, audio o vídeo. La forma de salida es texto, por lo que las cadenas que impliquen generación multimodal deben ensamblarse en otro lugar;
- No lo trates como una calculadora de alta determinación. La aritmética exacta y la validación de reglas estrictas deben dejarse al código, no al modelo;
- No le hagas asumir afirmaciones fácticas sin contexto. En escenarios que requieran conocimiento externo, primero coloca los materiales en la entrada mediante recuperación y luego deja que organice la respuesta;
- No lo consideres la única fuente de información de eventos en tiempo real. El conocimiento interno del modelo tiene un límite temporal, y el contenido con altos requisitos de actualidad debe ser inyectado por tu sistema.
Escribir estos puntos en el documento de diseño del equipo es mucho más económico que parchear posteriormente los sistemas posteriores.
Cosas que hay que confirmar antes de la integración
Antes de escribir la primera línea de código de invocación, conviene confirmar claramente algunos puntos; de lo contrario, durante la fase de depuración aparecerán muchas comprobaciones inútiles.
Definir la forma de la tarea y el contrato de salida
Primero responde a tres preguntas: ¿la entrada es de un solo turno o de varios turnos? ¿La salida es texto libre o debe cumplir cierta estructura? ¿El sistema posterior puede tolerar reintentos en caso de fallo? Estas tres respuestas determinarán directamente cómo escribirás los prompts, cómo establecerás el límite máximo de longitud de salida y cómo harás la validación.
Credenciales y punto de entrada de invocación
Independientemente del método de integración que se elija finalmente, necesitas un conjunto de credenciales de API gestionables y rotables, y no debes escribir las credenciales en el código del frontend ni confirmarlas en el repositorio. La práctica recomendada es: guardar las credenciales en variables de entorno o en un servicio de gestión de secretos del lado del servidor, hacer que el backend realice de forma centralizada las invocaciones al modelo y que el frontend se comunique únicamente con tu backend. Así se evita la filtración y también se facilita posteriormente la aplicación de cuotas y auditorías por dimensión de negocio.
Red y presupuesto de tiempo de espera
El tiempo que tarda una solicitud a un modelo de texto varía según la longitud de entrada y de salida. Antes de lanzar, determina: ¿cuál es el tiempo máximo de respuesta que puede aceptar tu negocio? A partir de ahí, deduce el tiempo de espera de la solicitud, el número de reintentos y la estrategia de degradación. Muchos comentarios de «el modelo es inestable» en realidad se deben a que la configuración de tiempo de espera no coincide con las expectativas del negocio.
La observabilidad antes que la funcionalidad
Antes de escribir la lógica de negocio, define primero los campos de registro: ID de solicitud, cantidad de tokens de entrada, cantidad de tokens de salida, tiempo consumido y código de error. Estos elementos son casi imprescindibles más adelante para el cálculo de costes y la localización de problemas; añadirlos después suele implicar modificar una ronda de código.
Cumplimiento y límites de datos
Confirma si el contenido que vas a enviar contiene información sensible como privacidad de usuarios, claves o documentos internos, y define qué campos deben anonimizarse antes de enviarse al modelo.
Puntos clave de los parámetros de invocación y de la organización de solicitudes
Una invocación típica consta de tres partes: contenido de entrada, parámetros de control y resultado devuelto. Lo que realmente afecta a la calidad y al coste del resultado suele ser solo un pequeño número de parámetros.
Cómo organizar el contenido de entrada
Considera la entrada como tres capas: «instrucción + contexto + datos a procesar»:
- La instrucción va al principio, indicando el rol y el objetivo de la tarea;
- El contexto (materiales recuperados, historial de conversación) va en medio y claramente separado;
- Los datos a procesar van al final, junto al objeto de acción requerido por la instrucción.
En conversaciones multiturno, conserva los últimos turnos en lugar de acumular historial indefinidamente: cuanto más largo sea el historial, más se consumirá en el lado de la entrada y el ruido diluirá la información clave. Para el contenido que requiera memoria a largo plazo, se recomienda resumirlo e inyectarlo, en lugar de arrastrar el texto original completo.
Parámetros clave
- Límite máximo de longitud de salida: es el parámetro más fácil de pasar por alto y, sin embargo, afecta tanto al coste como a la experiencia. Si se establece demasiado bajo, la respuesta se truncará; si se establece demasiado alto, se le deja al modelo espacio para «hablar de más». Se recomienda establecer niveles según el tipo de tarea: para tareas de clasificación, un límite muy pequeño; solo abrirlo para la generación de textos largos.
- Parámetros de muestreo como temperatura/top-p: en tareas que requieren salidas estables, como extracción, clasificación o conversión de formato, reduce la aleatoriedad; en la generación de textos, puede abrirse moderadamente. Mantén la coherencia dentro del mismo negocio para facilitar comparaciones de regresión.
- Condiciones de parada: si tu sistema posterior requiere que la salida termine en un punto determinado (por ejemplo, tomar solo el primer párrafo JSON), restringir con secuencias de parada es más fiable que recortar a posteriori con expresiones regulares.
- Restricciones de salida estructurada: cuando se necesite que un programa lo analice, indica en la instrucción los nombres de los campos, los tipos y ejemplos, y especifica claramente «salida solo en JSON, sin explicaciones adicionales».
Algunas experiencias en la organización de solicitudes
- Separa los prompts del código de negocio y conviértelos en plantillas versionables para facilitar la comparación A/B;
- Establece una red de seguridad para el análisis de la salida: si el análisis falla, registra la respuesta original en lugar de lanzar directamente el error al usuario;
- Establece claves de idempotencia para la misma solicitud, evitando cobros duplicados y efectos secundarios repetidos por reintentos;
- En escenarios con entradas largas, realiza primero segmentación y filtrado, y deja fuera del modelo los párrafos irrelevantes; esta es la forma más directa de ahorrar.
Cómo estimar y controlar el coste con facturación por token
gemini-4-hydrogen se factura por token. Esto significa que tu coste está determinado casi por completo por dos cosas: cuántos tokens se envían en cada solicitud y cuántos tokens devuelve el modelo. Consulta las cifras de precio en el panel de precios del sitio; aquí solo se trata el método.
Adquirir el hábito de estimar
No estimes a ojo. El método es: ejecutar primero un lote de muestras reales, registrar la cantidad de tokens de entrada y de salida de cada solicitud, y agrupar por escenario de negocio para calcular la media y los percentiles. Usa «número medio de tokens × volumen diario de invocaciones» para obtener una estimación de orden de magnitud, y luego usa el P95 para ver el peor caso. Descubrirás que la distribución varía enormemente entre escenarios, y que estimar con una media única suele desviarse gravemente.
Palancas concretas para el control de costes
- Comprimir la entrada: eliminar prompts de sistema repetidos, recortar contexto irrelevante y resumir documentos largos antes de enviarlos. El lado de la entrada suele ser la mayor parte del coste y también donde el beneficio es más directo;
- Limitar la salida: mediante el límite máximo de longitud de salida e instrucciones del tipo «responde de forma concisa», eliminar directamente la salida redundante;
- Invocación por niveles: resolver clasificaciones simples y validaciones de formato con solicitudes pequeñas, y realizar la invocación completa solo cuando realmente se necesite capacidad generativa;
- Caché y deduplicación: almacenar en caché resultados de solicitudes idénticas o muy similares, especialmente en tareas por lotes fuera de línea;
- Lotes y asincronía: acumular tareas no en tiempo real para procesarlas por lotes y reducir la parte de coste fijo repetido.
Convertir el coste en una métrica observable
Registra en los logs el consumo de tokens por línea de negocio y crea paneles de tendencia diaria y semanal. Cuando el consumo sube de forma anómala en un día determinado, suele corresponder a tres tipos de causas: aumento del volumen de invocaciones, entrada más larga (por ejemplo, porque cambió la lógica de concatenación de contexto) o salida más larga (por ejemplo, porque se modificó el prompt). Convertir estos tres puntos en elementos de monitorización ahorra muchas investigaciones posteriores.
Una última advertencia: no optimices el coste a expensas de la calidad de la salida. Primero crea un conjunto de evaluación y luego habla de compresión.
Integración en plataformas de API agregadoras y comparación entre múltiples modelos
Para la mayoría de los equipos, el mayor coste en la fase de selección no es escribir código, sino que «cambiar de modelo obligue a modificar la capa de integración». Integrar mediante un punto de entrada unificado puede reducir ese coste al mínimo.
Ventajas de una interfaz unificada
En las plataformas de API agregadoras, la forma de invocar los modelos se unifica en la misma estructura de solicitud: el mismo método de autenticación, el mismo formato de mensajes y la misma lógica de análisis de la respuesta. Al cambiar de modelo, normalmente solo hay que cambiar el identificador del modelo y el código de negocio apenas se toca. El beneficio directo que aporta esto es:
- La capa de integración se escribe una sola vez y la comparten varios modelos;
- En la fase de evaluación se pueden hacer comparaciones horizontales a bajo coste;
- En producción se pueden hacer despliegues graduales y reversiones rápidas: cuando un modelo falla, cambiar al alternativo solo requiere modificar la configuración.
La información de integración y la disponibilidad de este modelo pueden consultarse en la página del modelo: /models/gemini-4-hydrogen.
Hacer una comparación sobre las mismas preguntas
No te limites a mirar los rankings. El método consiste en preparar tu propio conjunto de evaluación que cubra la distribución real del negocio, con 20 a 50 muestras que incluyan casos simples, casos límite y casos de entrada larga; después:
- Ejecutar varios modelos candidatos con la misma plantilla de prompt;
- Registrar la calidad de la salida (evaluación manual o por reglas), el tiempo consumido y el consumo de tokens;
- Fijarse especialmente en la tasa de aprobación y en los modos de fallo, no en la puntuación media;
- Para las muestras con diferencias evidentes, hacer un análisis de atribución: ¿es un problema de seguimiento de instrucciones, de formato o de truncamiento de contexto largo?
Estrategia de cambio y coexistencia
La conclusión de la evaluación a menudo no es «usar un solo modelo», sino «repartir tareas según el escenario». Por ejemplo: usar un modelo de baja latencia para clasificación y extracción, y un modelo con mejor calidad de salida para la generación de textos largos. Un punto de entrada unificado permite expresar este reparto en la capa de configuración, sin necesidad de mantener varios SDK. Al mismo tiempo, se recomienda conservar en la capa de integración un interruptor de configuración para el identificador del modelo, junto con despliegues graduales para aumentar el tráfico poco a poco.
Lista de verificación previa al lanzamiento y resolución de problemas frecuentes
Lista de verificación previa al lanzamiento
Completa estos pasos en orden antes de considerar aumentar el tráfico:
- Prueba de humo: ¿una solicitud mínima devuelve correctamente? ¿La autenticación y la red funcionan sin problemas?
- Validación de formato: en escenarios de salida estructurada, ¿cuál es la tasa de éxito de análisis de un lote de muestras y qué aspecto tienen las respuestas que fallan al analizarse?
- Entradas límite: entradas muy largas, entradas vacías y entradas con caracteres especiales y varios idiomas, ¿cómo se comportan respectivamente?
- Longitud de salida: en el peor caso, ¿se trunca la salida? Cuando se trunca, ¿puede detectarlo el sistema posterior?
- Concurrencia y tiempos de espera: con la concurrencia máxima prevista, ¿son aceptables la tasa de tiempos de espera y la tasa de errores?
- Ruta de degradación: cuando el modelo principal no está disponible, ¿la cadena para cambiar al alternativo o devolver un resultado de respaldo realmente funciona?
- Línea base de coste: registrar el consumo de tokens con un flujo típico como referencia para la monitorización posterior.
Problemas frecuentes y orden de resolución
Tiempo de espera de la solicitud agotado: primero comprueba si la entrada es demasiado larga (especialmente si se ha metido un documento entero), luego si el límite de salida está configurado demasiado alto y, por último, si la estrategia de tiempo de espera y reintentos del cliente es razonable. Los reintentos deben incluir retroceso exponencial para evitar una avalancha.
Salida truncada: revisa el límite máximo de longitud de salida y si el prompt exige contenido demasiado largo; a veces se debe a que la secuencia de parada está mal configurada y provoca un final prematuro.
Salida inestable y formato que varía: prioriza reducir la aleatoriedad del muestreo; después comprueba si la instrucción es clara (si los nombres de campo, tipos y ejemplos están completos); por último, comprueba si en la entrada se han mezclado ejemplos contradictorios.
El contenido se desvía de la instrucción: la causa habitual es que un contexto demasiado largo diluye las instrucciones clave. Mover la instrucción al final de la entrada y repetirla una vez, o comprimir el contexto, suele mejorar el resultado.
Aumento anómalo del coste: aplica la atribución en tres puntos mencionada anteriormente —volumen de invocaciones, longitud de entrada y longitud de salida— y compáralos uno a uno con las tendencias de los logs.
Resultados no reproducibles: registra los parámetros de la solicitud y la versión de la plantilla; la salida del modelo es en sí misma aleatoria, no esperes reproducirla palabra por palabra; la validación debe basarse en reglas o en puntuaciones humanas.
Incorporar esta lista al proceso de publicación es mucho más estable que improvisar en cada lanzamiento. Para los detalles concretos de selección e integración, puedes empezar por confirmarlos en la página del modelo /models/gemini-4-hydrogen.
Artículos relacionados
Ver todos los artículos →-

Guía de uso
Guía de generación de imágenes a partir de texto con Nano Banana Basic: formato, espacio en blanco y uso de prompts
Use los campos aspect_ratio y prompt de la interfaz de tareas para generar imágenes con composición clara para pancartas y tarjetas sociales
-

Guía de uso
Práctica de procesamiento de respuestas de Kimi K3: JSON completo, interrupciones de streaming y límites del reintento
-

Guía de uso
GLM 5.3 extracción estructurada en la práctica: cada campo JSON con respaldo en el texto original
Extraer campos con el modo de objeto JSON: frenar los errores antes de almacenarlos mediante valores ausentes, citas y validaciones de negocio