
Guía de uso
¿Cuánto tarda GPT Image en generar una imagen? Tiempos reales de 24 generaciones
Tiempo medio de GPT Image 2 y 2.5 con distintas calidades y resoluciones, en qué se va el tiempo y cómo generar imágenes más rápido.
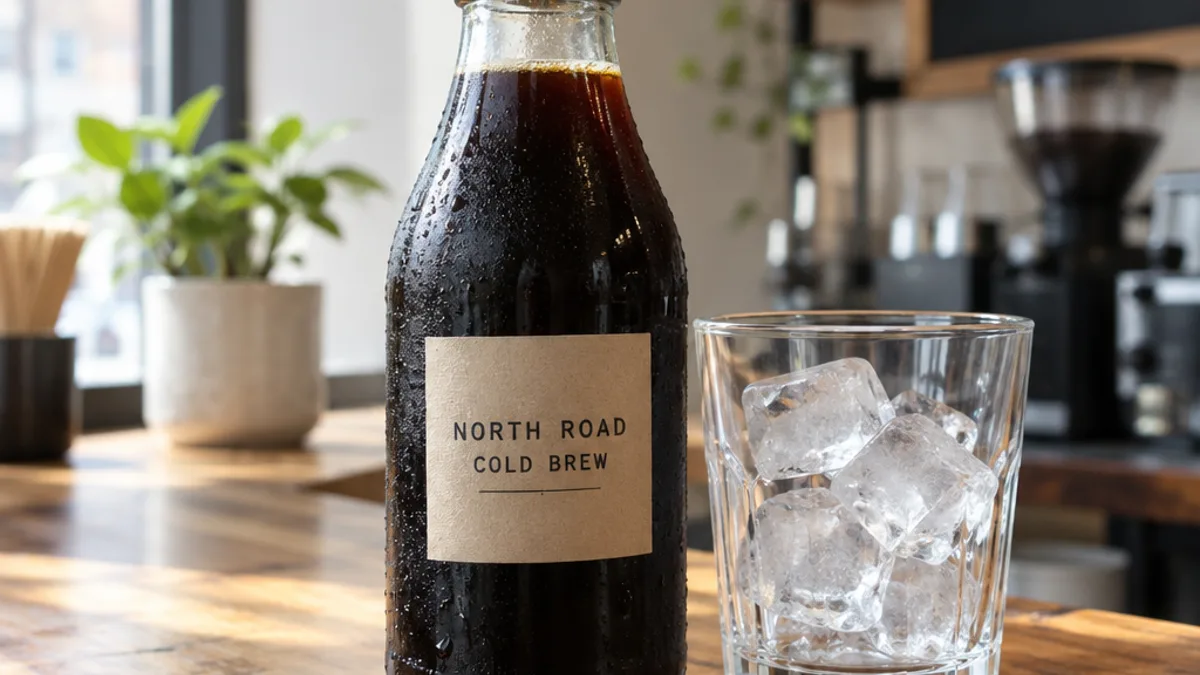
El modelo GPT Image de OpenAI tarda entre unos 45 segundos y 1.5 minutos en generar una imagen, y unos 3 minutos con la máxima calidad. El 29 de septiembre de 2026 medimos 24 generaciones a través de la API: GPT Image 2.5 Flare fue el más rápido, con una mediana de 43 segundos; GPT Image 2 en alta calidad fue el más lento, con 175 segundos. La página de ayuda de OpenAI sobre ChatGPT dice que una imagen «puede tardar varios minutos según la complejidad de la solicitud».
| Modelo y configuración | Tiempo medio | Rango de 3 | Precio por imagen en HiAPI |
|---|---|---|---|
| GPT Image 2.5 Flare, 1K | 43 s | 42–54 s | $0.05 ($0.025 antes de las 0:00 del 9 de noviembre, hora de Pekín) |
| GPT Image 2, baja calidad, 1K | 47 s | 37–61 s | $0.007 |
| GPT Image 2.5 Sunburst, 1K | 56 s | 52–58 s | $0.05 ($0.025 durante la promoción) |
| GPT Image 2, calidad media, 1K | 72 s | 72–87 s | $0.061 |
| GPT Image 2, estándar, 1K | 75 s | 68–88 s | $0.03 |
| GPT Image 2, estándar, 2K | 90 s | 88–97 s | $0.04 |
| GPT Image 2, estándar, 4K | 88 s | 85–104 s | $0.06 |
| GPT Image 2, alta calidad, 1K | 175 s | 168–177 s | $0.245 |
Tiempo desde el envío de la solicitud hasta que la imagen se puede descargar, medido a través de la API de HiAPI el 29 de septiembre de 2026. Las 24 generaciones se completaron con éxito.
Qué hace más lenta la generación
Lo que más influye es el nivel de calidad. Con el mismo prompt en 1K, la baja calidad tarda 47 segundos, la media 72 y la alta 175. La alta calidad es casi 4 veces más lenta que la baja y cuesta 35 veces más.
La resolución influye menos de lo que parece. GPT Image 2 estándar tarda 75 segundos en 1K, y alrededor de 90 segundos tanto en 2K como en 4K. En nuestras pruebas, pasar de 2K a 4K no añadió tiempo.
GPT Image 2.5 es más rápido que GPT Image 2. Con el mismo tamaño, Flare tarda 43 segundos y Sunburst 56, frente a los 75 de GPT Image 2 estándar. OpenAI afirma que el tiempo de generación de Images 2.5 se reduce «hasta un 50 %» respecto a Images 2.0, y nuestros datos coinciden con esa afirmación.
Efecto del mismo prompt con los tres niveles de calidad de GPT Image 2:
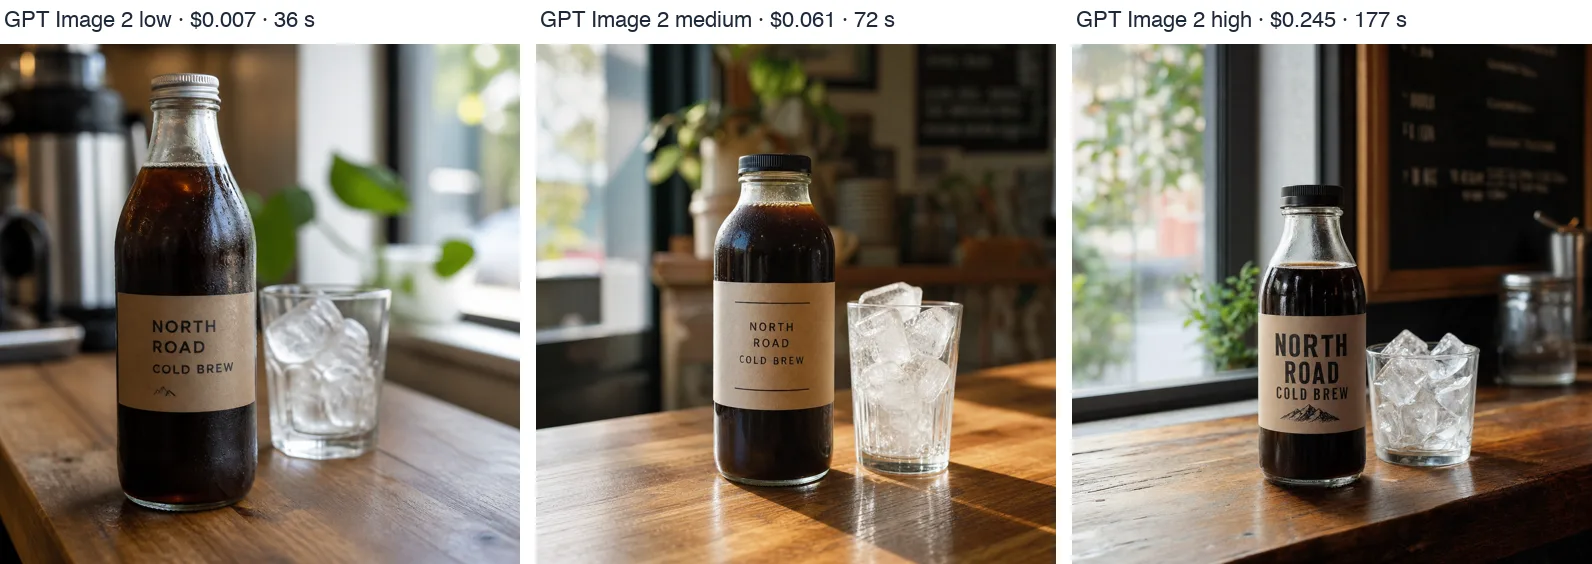
GPT Image 2, 1K. De izquierda a derecha: baja calidad ($0.007, 36 s), calidad media ($0.061, 72 s), alta calidad ($0.245, 177 s).
Las tres imágenes escribieron correctamente la etiqueta «NORTH ROAD COLD BREW». La de alta calidad tiene texturas más finas y una tipografía de etiqueta más llamativa; pero para imágenes de sitios web y redes sociales, la baja calidad de 36 segundos y $0.007 suele ser suficiente.
GPT Image 2.5 es más rápido con el mismo tamaño y también escribe bien el texto pequeño:
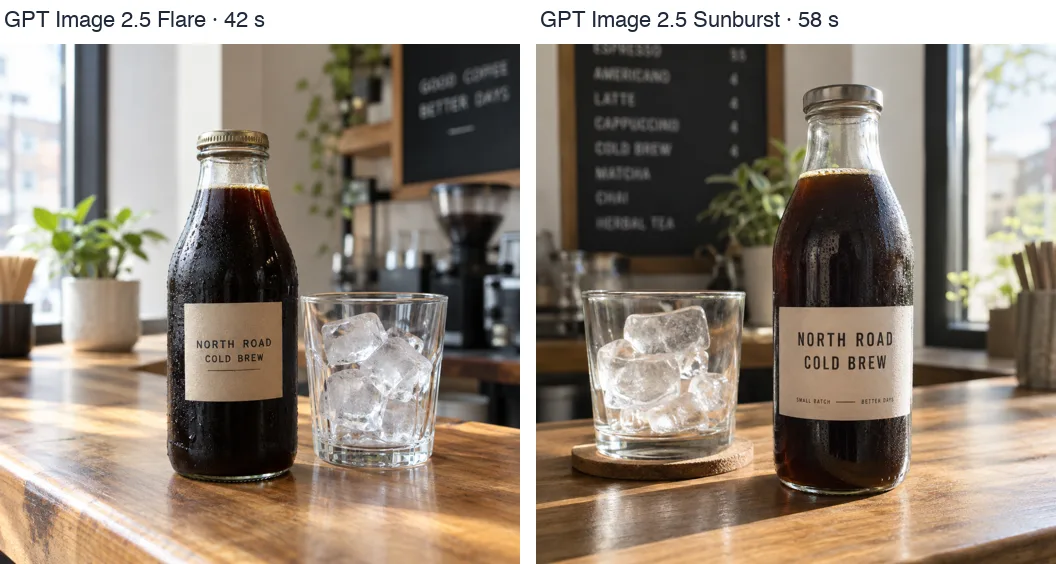
GPT Image 2.5, 1K. Flare 42 s, Sunburst 58 s.
En qué se va el tiempo
Las tareas de generación de imágenes a través de la API pasan por varios estados. La distribución de tiempos que medimos es:
| Estado | Qué está haciendo | Tiempo medido |
|---|---|---|
queued |
En cola esperando una máquina disponible | Menos de 12 segundos, a menudo se salta directamente |
handling |
El modelo está dibujando | La mayor parte del tiempo total |
archiving |
Guardando el archivo generado | 3–11 segundos |
success |
El enlace de la imagen está disponible | — |
El siguiente script imprime cada cambio de estado y sirve para medir tus propios prompts:
import os
import time

import requests

API = "https://api.hiapi.ai/v1"
HEADERS = {"Authorization": f"Bearer {os.environ['HIAPI_API_KEY']}"}

start = time.monotonic()
task_id = requests.post(f"{API}/tasks", headers=HEADERS, json={
    "model": "gpt-image-2/text-to-image@ext",
    "input": {"prompt": "a glass bottle of cold brew coffee on a wooden cafe counter",
              "aspect_ratio": "1:1", "resolution": "1K", "quality": "low"},
}).json()["data"]["taskId"]

last = None
while True:
    task = requests.get(f"{API}/tasks/{task_id}", headers=HEADERS).json()["data"]
    if task["status"] != last:
        last = task["status"]
        print(f"{time.monotonic() - start:5.1f}s  {last}")
    if last in ("success", "fail"):
        break
    time.sleep(3)

print(task["output"][0]["url"] if last == "success" else task.get("error"))
Una ejecución con baja calidad produce esta salida:
  3.7s  handling
 49.2s  archiving
 57.4s  success
Primero hay que ejecutar pip install requests y configurar la clave de API de HiAPI en HIAPI_API_KEY.
Cómo generar imágenes más rápido
- Usa baja calidad o GPT Image 2.5 Flare. Ambos generan en menos de 1 minuto, a $0.007 y $0.05 respectivamente ($0.025 durante la promoción).
- Usa 1K si no necesitas una imagen grande. 2K y 4K añaden unos 15 segundos cada uno.
- Envía en paralelo. El tiempo por imagen no cambia, pero se pueden ejecutar muchas a la vez. En nuestra comparativa con ChatGPT Plus, 12 imágenes enviadas juntas terminaron todas en 97 segundos.
- Consulta el estado cada 3–5 segundos y, en tareas de alta calidad, espera al menos 5 minutos antes de darlas por bloqueadas. Si una tarea realmente se bloquea, consulta cómo tratar los tiempos de espera de tareas.
Si quieres probar estas configuraciones, abre GPT Image 2 o GPT Image 2.5 Flare y genera una imagen en 1K.
Preguntas frecuentes
¿Cuánto tarda ChatGPT en generar una imagen?
OpenAI dice que «puede tardar varios minutos según la complejidad de la solicitud». ChatGPT usa ahora GPT Image 2.5, y en nuestras pruebas a través de la API este modelo tarda entre 43 y 56 segundos por imagen en 1K.
¿Cuánto tarda GPT Image 2 en generar una imagen?
Estándar en 1K unos 75 segundos; en 2K y 4K unos 90 segundos. Baja calidad 47 segundos, alta calidad unos 3 minutos.
¿GPT Image 2.5 es más rápido que GPT Image 2?
Sí. En 1K, GPT Image 2.5 Flare tarda 43 segundos y Sunburst 56, frente a los 75 de GPT Image 2 estándar.
¿Por qué GPT Image es tan lento?
Porque dibuja la imagen completa con todo detalle antes de devolver el resultado; cuanto mayor es la calidad, más cálculo requiere cada imagen. Con baja calidad o GPT Image 2.5 Flare, la espera se puede reducir a menos de 1 minuto.
Si tengo que generar muchas imágenes, ¿cuál es la forma más rápida?
Enviarlas en paralelo, no una tras otra. Enviando 12 a la vez por la API, todas terminan en 97 segundos en total, similar a una sola imagen estándar en 2K.
Artículos relacionados
Ver todos los artículos →-

Guía de uso
seedream-5.0-pro/image-to-image: guía de introducción — capacidades, precios y puntos clave de integración
Límites de capacidad, modelo de facturación y prácticas de integración técnica del modelo de edición de imágenes de ByteDance
-

Guía de uso
Guía de inicio de seedream-5.0-pro texto a imagen: límites de capacidad, integración de API y control de costes
Perspectiva práctica para desarrolladores: desde los puntos clave de los parámetros hasta la estimación de coste de $0.05 por imagen
-

Guía de uso
Guía de inicio de Hailuo 2.3 Fast de imagen a video: límites de capacidad, precios e integración práctica
Claves de selección e integración del modelo MiniMax de imagen a video para desarrolladores