
Guía de uso
Guía de inicio de Vidu Q3 Mix referencia-a-vídeo: límites de capacidad, parámetros de API y puntos clave de facturación
Perspectiva de decisión de integración y práctica para desarrolladores
En esta página
Qué problema resuelve este modelo
La forma de entrada de un modelo de generación de vídeo determina si puedes mantener el «control» en tus manos. La generación texto-a-vídeo (text-to-video) solo recibe un prompt y la evolución de la imagen queda a libertad del modelo; la generación imagen-a-vídeo (image-to-video) recibe un primer fotograma y el modelo se encarga de «ponerlo en movimiento». El reference-to-video (referencia-a-vídeo) sigue un tercer camino: tú aportas material de referencia y el modelo lo consulta de forma continua durante la generación, en lugar de usarlo solo como primer fotograma.
El posicionamiento de vidu-q3-mix/reference-to-video se sitúa en esta rama. Encaja en necesidades como estas:
- Un personaje o sujeto debe mantenerse coherente entre planos: no dispones de material de vídeo existente, pero sí de una o varias imágenes de referencia que representan el aspecto del sujeto, y quieres que en el vídeo final el sujeto «siga pareciendo él».
- El estilo y el tono deben quedar anclados: el material de referencia transmite luz, materiales y tendencia de composición, y el vídeo final mantiene ese lenguaje visual, algo más controlable que confiar solo en una descripción textual.
- Crear contenido dinámico a partir de activos estáticos: productos de comercio electrónico, imágenes de marca (IP), bocetos de diseño conceptual y otros activos de imagen ya existentes que necesitan convertirse en vídeos cortos.
En otras palabras, si tu necesidad es «dame un vídeo que cumpla la descripción, sin más», la generación texto-a-vídeo es más directa; si tu necesidad es «este vídeo tiene que parecerse a lo que yo aporto», la generación referencia-a-vídeo es la herramienta adecuada. Antes de elegir, pregúntate: ¿tengo un anclaje visual que deba conservarse obligatoriamente? Si lo tienes, usa esta opción.
En HiAPI.ai, este modelo comparte el mismo contexto de invocación que otros modelos de vídeo; no necesitas construir una lógica de integración específica para él, y al cambiar de modelo lo que varía son principalmente los parámetros de capacidad, no la estructura de ingeniería.
Diferencia clave con la generación imagen-a-vídeo
La imagen de entrada de imagen-a-vídeo es el «punto de partida»; la entrada de referencia-a-vídeo es una «restricción». La primera da al modelo una imagen que debe continuar; la segunda le da un conjunto de rasgos que debe respetar. Entender esto hace que todos los juicios posteriores sobre preparación de material y ajuste de parámetros resulten naturales.
Límites de capacidad y escenarios no adecuados
Tener claro el círculo de capacidades del modelo es más importante que memorizar qué admite. Según la definición de capacidad de reference-to-video, pueden establecerse los siguientes límites:
Lo que cubre
- Generación de vídeo con material de referencia como base visual: los rasgos de la imagen de referencia se incorporan al proceso de generación.
- Coherencia del sujeto y continuidad de estilo: mantiene una expresión visual relativamente estable en generaciones múltiples.
- Control del rumbo del contenido mediante prompts: el material de referencia se encarga del «parecido», y el prompt, de «qué ocurre».
Lo que no cubre
- No es un sustituto de la generación texto-a-vídeo: cuando no hay material de referencia, no conviene escribir un prompt larguísimo para «simular» una imagen de referencia; eso es usar mal la herramienta y no resulta rentable ni en resultado ni en coste.
- No es una herramienta de réplica estricta fotograma a fotograma: referencia-a-vídeo no equivale a animar con precisión la imagen de referencia, ni debe esperarse que responda por cada píxel de ella. Si tu necesidad es «esta imagen debe animarse tal cual», imagen-a-vídeo se acerca más.
- No promete duración ilimitada: el límite superior de duración por generación depende de los parámetros disponibles en la interfaz y en el panel de la plataforma; no diseñes el flujo de producto asumiendo «generar todo el tiempo que quiera».
- No sustituye la postproducción: subtítulos, montaje, unión de varios tramos y mezcla de pistas de audio siguen siendo responsabilidad de tu pipeline.
El mal uso más habitual al elegir
El error más típico es tratar referencia-a-vídeo como un «imagen-a-vídeo más barato». La semántica de entrada de ambos es distinta y la expectativa de salida también: cuando realmente necesitas una alineación estricta con el primer fotograma, usar referencia-a-vídeo suele dar resultados «parecidos pero distintos», y reintentar una y otra vez solo multiplica el coste. A la inversa, cuando necesitas estabilidad del sujeto entre varios planos, alimentar imagen-a-vídeo tramo a tramo tiende a producir más deriva visual.
La regla de decisión puede resumirse en una frase: si quieres un punto de partida, elige imagen-a-vídeo; si quieres una restricción, elige referencia-a-vídeo.
Puntos clave de los parámetros de API y del flujo de llamada
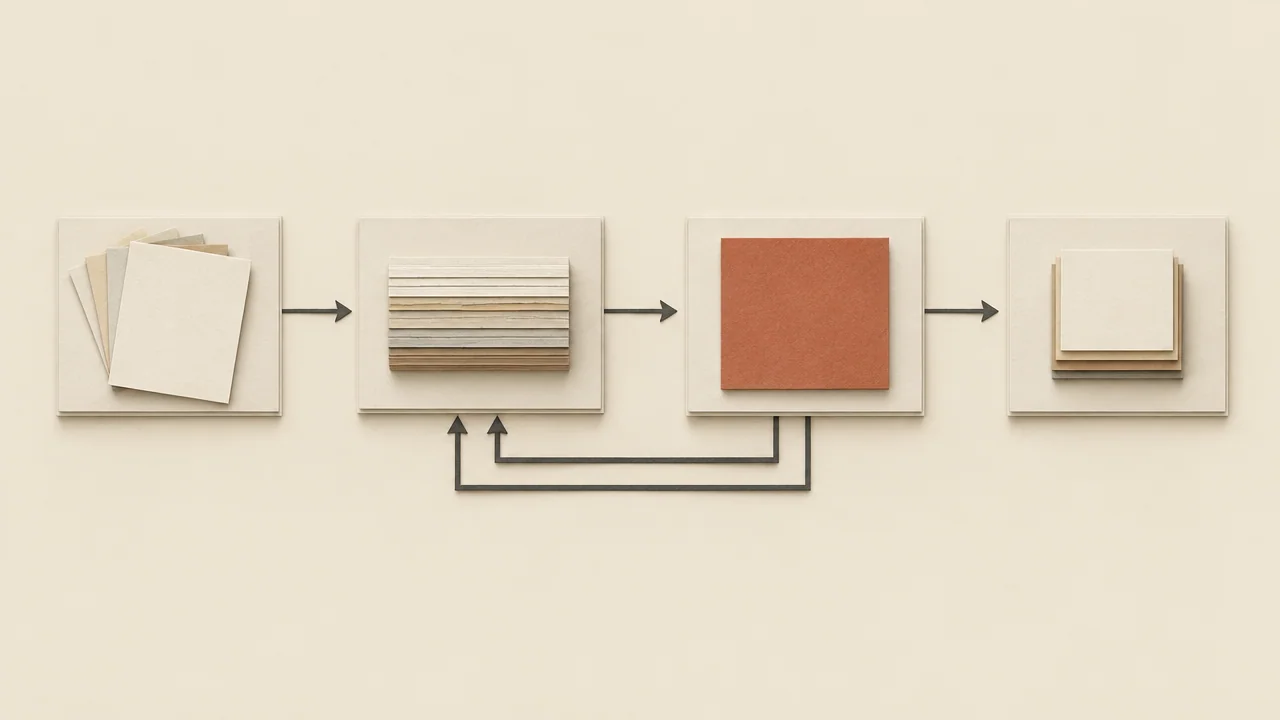
La complejidad de ingeniería al integrar este tipo de modelos no está principalmente en «enviar la petición», sino en «preparar la entrada» y «organizar el flujo». La cadena completa puede dividirse en cuatro tramos:
1. Preparación del material de referencia
Antes de lanzar la llamada, normaliza el material de referencia: unifica tamaño y proporción, elimina marcas de agua y elementos de fondo sobrantes, y asegura que el sujeto sea nítido y la iluminación coherente. Solo si este paso está bien hecho tiene sentido el ajuste fino posterior de parámetros.
2. Construcción de la petición
Una llamada típica debe organizar tres tipos de información en la petición:
- Identificador de capacidad: especificar
vidu-q3-mix/reference-to-videopara que la petición llegue a la rama de capacidad correcta. - Material de referencia: la ubicación o el identificador de carga de la imagen de referencia; los nombres exactos de campo y las formas aceptadas dependen de la documentación de la interfaz.
- Descripción de generación: el prompt, que debe describir acciones, movimiento de cámara, ritmo y atmósfera, en lugar de repetir el aspecto que ya aparece en la imagen de referencia.
Los nombres concretos de campo, los obligatorios y los rangos de valores deben consultarse en la documentación de la interfaz y en la página de detalles del modelo de HiAPI.ai. Este artículo no inventa campos; al integrar, basta con componer la petición según la documentación.
3. Tarea de generación
La generación de vídeo es esencialmente asíncrona: tras enviar la petición se devuelve un identificador de tarea y el modelo tarda un tiempo en completar la inferencia. Tu servidor debe desacoplar «enviar» y «obtener resultado», usando el identificador de tarea para consultar el estado o recibir callbacks, en lugar de esperar dentro de una petición síncrona.
4. Obtención del resultado y reintentos
Tras recibir el resultado, haz primero una validación de disponibilidad (si el archivo se decodifica correctamente y si la duración coincide con lo esperado) y luego decide si reintentar. La rama de reintento debe tener un límite y registrar el motivo de cada fallo; esto es esencial para estimar costes.
Cómo escribir el prompt
En el prompt de referencia-a-vídeo, el foco debe estar en «la información que no está en la imagen de referencia»: qué debe hacer el sujeto en la escena, cómo se mueve la cámara y cómo cambia el entorno. Dedicar espacio a repetir lo que ya muestra la imagen de referencia es un desperdicio habitual. Cuanto más concreta sea la descripción y más se acerque a una instrucción visual ejecutable, más estable será el resultado.
Estimar costes con $0.1865/segundo
La facturación de este modelo se basa en los segundos del vídeo de salida, con un precio unitario de $0.1865 por segundo. Entendido esto, la estimación de costes se convierte en una simple multiplicación.
Fórmula de coste por pieza
coste por pieza = duración de salida (segundos) × $0.1865
Un vídeo final de 5 segundos cuesta 5 × 0.1865; uno de 10 segundos, 10 × 0.1865. Al duplicar la duración, el coste se duplica linealmente: no hay tramos ni descuentos ocultos por «generar de una vez», así que el presupuesto de duración debe incorporarse al diseño del producto desde el principio.
Incluir los reintentos
El coste real nunca es «el precio de un vídeo». La generación tiene incertidumbre, y debes reservar presupuesto de reintento para fallos e insatisfacciones:
coste total esperado = coste por pieza × número esperado de intentos
número esperado de intentos ≈ 1 + tasa de reintento
Por ejemplo, si una tarea de generación de 8 segundos necesita de media un reintento para dar un resultado utilizable, el coste real será 8 × 0.1865 × 2, no 8 × 0.1865. En equipos con alta tasa de reintento, el coste se multiplica; este es un coste oculto que muchos integradores descubren solo al escalar.
Tres palancas para controlar el presupuesto
- Primero corto, luego largo: en fase de depuración, usa la duración más corta para validar si el prompt y el material están alineados, y alarga solo cuando esté confirmado. El coste de prueba y error de un vídeo corto es mucho menor.
- Fijar un límite de reintentos: asigna a cada tarea un número máximo de intentos; si se supera, interviene manualmente o se cambia el material, evitando que los reintentos automáticos consuman el presupuesto.
- Registrar cada llamada: reporta duración, si hubo reintento y el motivo del fallo. Sin estos datos no podrás saber si el exceso de presupuesto viene del prompt o del material.
Los precios en tiempo real y las condiciones de facturación deben consultarse en el panel de precios del sitio de HiAPI.ai; este artículo solo trata el método de estimación.
Criterios de preparación y ajuste del material de referencia
En esta cadena de referencia-a-vídeo, el impacto de la calidad del material en el vídeo final suele ser mayor que el del ajuste fino de parámetros. La razón es que los parámetros ajustan la «tendencia» del modelo, mientras que el material determina su «base». Si la base no es clara, la mejor tendencia no llega a materializarse.
Qué material de referencia es bueno
- Sujeto claro: el espectador debe poder ver en medio segundo «qué hay que conservar» en la imagen. Un fondo con muchos elementos y un sujeto pequeño debilitan el efecto de referencia.
- Rasgos estables: el aspecto del mismo sujeto debe ser coherente entre distintas imágenes de referencia. Si varias imágenes de referencia se contradicen entre sí (color, forma o material que no coinciden), el modelo solo puede oscilar entre versiones.
- Iluminación y ángulo razonables: luces extremas y ángulos muy distorsionados transmiten pistas visuales erróneas al modelo.
- Limpieza: elimina marcas de agua, pegatinas y texto sobrante. Estos elementos pueden heredarse como rasgos del sujeto.
Prioridad del ajuste
Cuando el resultado no es el esperado, conviene investigar en este orden en lugar de tocar parámetros de inmediato:
- Cambiar primero el material: sustituir la imagen de referencia por una versión más nítida y con un sujeto más único suele ser la mejora más rápida.
- Modificar después el prompt: concretar acciones y entorno, y eliminar descripciones que repiten la imagen de referencia.
- Tocar los parámetros al final: considerar el ajuste fino solo cuando los dos pasos anteriores estén estables, y cambiar una sola variable cada vez para poder atribuir causas.
Coherencia entre varias imágenes de referencia
Si aportas varios materiales de referencia, asegúrate de que representan «el mismo sujeto». Mezclar imágenes de individuos distintos o de estilos distintos es una de las causas más frecuentes de deriva en el resultado. Mejor dar una imagen menos que dar una contradictoria.
Establecer una base de material
Se recomienda crear un conjunto fijo de materiales de referencia para tus sujetos principales, que sirva como base para todas las generaciones posteriores. Partir siempre de esta base y cambiar solo el prompt permite distinguir con claridad entre «problema de material» y «problema de descripción», y facilita la uniformidad de estilo entre varios vídeos.
Fallos habituales y direcciones de diagnóstico
La mayoría de los problemas en fase de integración encajan en unos pocos patrones fijos. Investigar en el orden siguiente suele ser más rápido que reintentar a ciegas.
1. Petición rechazada o error de parámetros
Confirma primero que el identificador de capacidad está bien escrito, que los campos obligatorios de material de referencia están completos y que la forma del material es aceptada por la interfaz. Los nombres de campo se toman de la documentación; no los adivines por experiencia.
2. La tarea no da resultado durante mucho tiempo
La generación de vídeo es una tarea asíncrona; confirma que obtienes el resultado mediante el identificador de tarea y no esperando dentro de una petición síncrona. Si realmente hay timeout, comprueba si el volumen del material es demasiado grande.
3. El resultado «no se parece» al material de referencia
Es el problema más frecuente; el orden de diagnóstico es: ¿el material es nítido? → ¿se han dado imágenes de referencia contradictorias? → ¿el prompt describe contenido que entra en conflicto con la referencia? En la mayoría de los casos no es que el modelo falle, sino que el material no está a la altura.
4. El sujeto deriva entre tramos
La causa suele ser que cada tramo usa materiales de referencia distintos, o que las descripciones del sujeto en cada prompt no son coherentes. Fijar un conjunto base de materiales y unificar la descripción del sujeto mejora notablemente el resultado.
5. La acción de la imagen no coincide con lo esperado
Si al prompt le faltan instrucciones claras de acción y cámara, el modelo solo puede improvisar. Especifica bien «qué hacer, cómo moverse y dónde está la cámara».
6. El coste supera lo previsto
Revisa el registro de llamadas: ¿la duración se configuró demasiado larga o la tasa de reintento es alta? En el primer caso, ajusta la política de duración en el producto; en el segundo, vuelve al material y al prompt para buscar la causa.
Principio básico de diagnóstico
Cambia una sola variable a la vez y conserva registros. Si modificas material y prompt al mismo tiempo, aunque el resultado mejore no sabrás qué elemento fue determinante, y la próxima vez que aparezca un problema similar tendrás que empezar de cero.
Lista de comprobación antes de integrar y pasos siguientes
Antes de escalar en producción, se recomienda validar punto por punto con la siguiente lista, para contener el riesgo en la fase de poco tráfico.
Lista de comprobación previa al lanzamiento
- La capacidad encaja: confirma que tu escenario realmente necesita referencia-a-vídeo, y no texto-a-vídeo o imagen-a-vídeo.
- Base de material lista: los sujetos principales cuentan con un conjunto fijo y limpio de materiales de referencia.
- Prompt plantillado: las descripciones de acción, cámara y entorno tienen una estructura reutilizable, en lugar de improvisarse cada vez.
- Cadena asíncrona operativa: envío, consulta o callback, validación de resultado y reintento ante fallo; las cuatro etapas tienen código y han pasado pruebas de carga.
- Reintentos con límite: el reintento automático tiene un número máximo; al superarlo, pasa a una cola manual.
- Panel de costes: a partir de los registros de llamadas (duración y número de reintentos) se puede calcular el gasto real en cualquier momento.
- Política de duración clara: el producto limita la duración generable para evitar que el usuario la alargue sin control y dispare el coste.
De poco tráfico al escalado
La ruta recomendada es: primero ejecutar de extremo a extremo con peticiones construidas manualmente, validando la eficacia del material y del prompt; después hacer pruebas por lotes con la duración más corta, midiendo la tasa de reintento y la tasa de disponibilidad; cuando las métricas sean estables, ampliar gradualmente concurrencia y duración. Mantén capacidad de reversión en cada paso.
Métricas clave
En la fase de escalado, lo que realmente hay que vigilar son la tasa de disponibilidad en el primer intento y el número medio de intentos. La primera determina la experiencia del usuario; el segundo determina directamente el coste. Solo cuando ambas métricas sean estables tiene sentido ampliar duración y concurrencia.
Si aún no has empezado, puedes consultar primero en HiAPI.ai los detalles del modelo vidu-q3-mix/reference-to-video y su precio en tiempo real, y luego decidir cuánto debe durar tu primer vídeo generado.
Artículos relacionados
Ver todos los artículos →-

Guía de uso
Guía de inicio con gpt-6.2-sol: límites de capacidad, integración vía API y consideraciones sobre el precio por token
Puntos clave de decisión e implementación de la integración para equipos de ingeniería
-

Guía de uso
Guía de inicio de gpt-6.2-astra: límites de capacidad del modelo de texto, puntos clave de integración y control de costes
-

Guía de uso
Guía de inicio de Tripo H3.1: cómo elegir entre tres modos de entrada, parámetros y precios
Guía práctica de decisiones de integración y control de costes de la generación 3D para desarrolladores