
Meta
Muse Image 1.0
muse-image-1.0/text-to-image
Modelo de generación y edición de imágenes de razonamiento de Meta que primero descompone las indicaciones complejas y luego las renderiza; puede combinar varias imágenes de referencia y apoyarse en la búsqueda web para garantizar la precisión factual
Probar muse-image-1.0/text-to-image
Entrada
Creaciones
Ver todas las creacionesSalida
image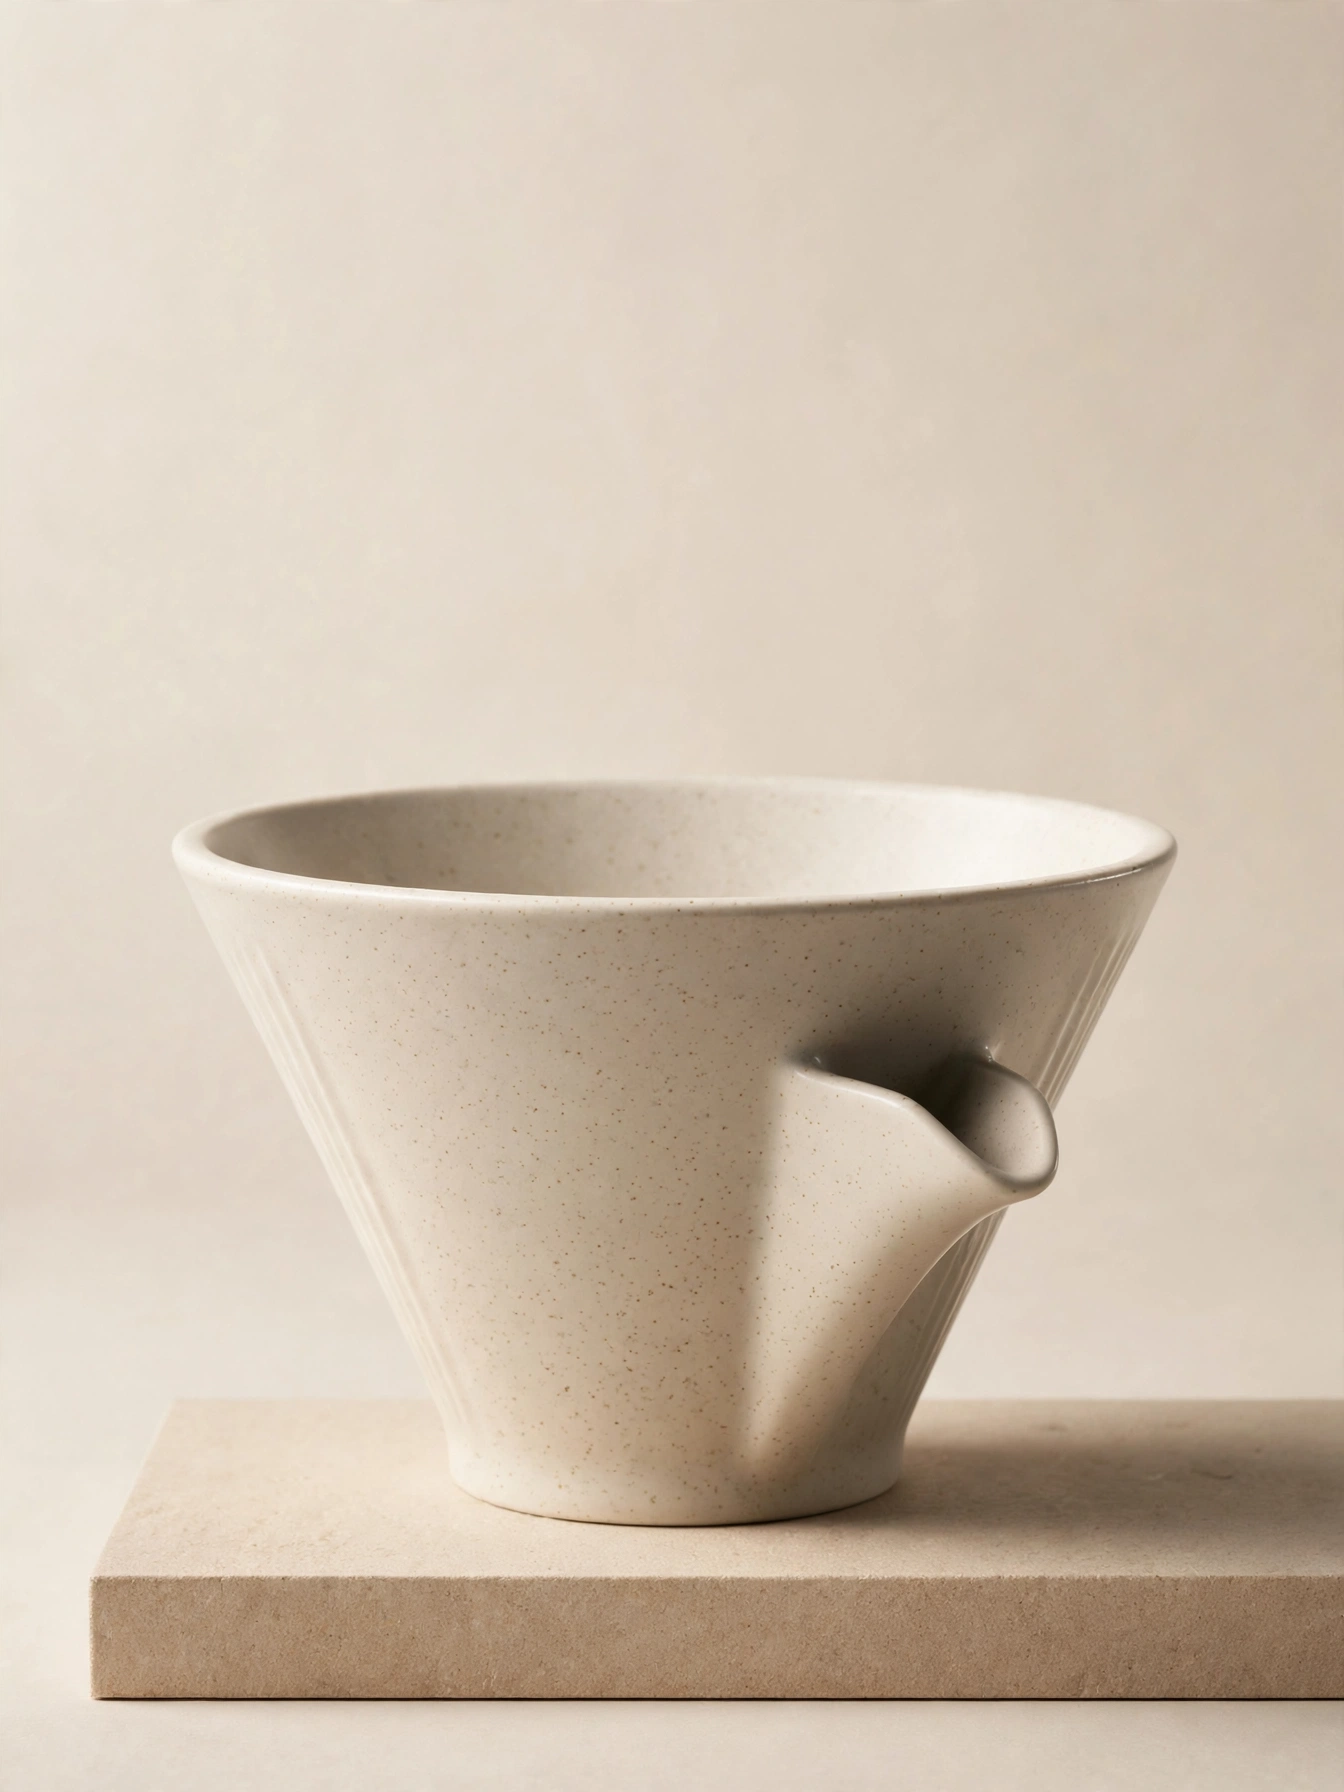
Calidad de fotografía de producto de nivel e-commerce: generación de imágenes con muse-image a partir de texto
Estilo Imagen de producto · Iluminación de estudio · Negocios
Prompt
Fotografía de producto en estudio de una cafetera de filtro de cerámica mate para café de especialidad, en tono blanco cálido tendente al beige, con una base color arena baja como centro y vista en tres cuartos. Fondo continuo de beige claro con una suave transición degradada. Luz principal desde un softbox grande a 45 grados en la parte superior izquierda, un panel reflector suave a la derecha que realza las zonas oscuras y una tira estrecha de luz de contorno en el borde derecho que separa el sujeto del fondo. Textura de finas motas visible en el esmalte, borde de la taza redondeado y nítido, pico vertedor geométricamente preciso. Capturada con un objetivo equivalente a 85 mm y apertura f/8, con una atenuación suave hacia el borde lejano y sin distorsión. Estética de retoque comercial limpio, balance de blancos neutro, altas luces controladas sin sobreexposición y una sombra de contacto suave que asienta el objeto. Composición vertical 4:3 con amplio espacio negativo en la parte superior para la maquetación. Sin texto, sin logotipos y sin atrezzo desordenado.
Copia el prompt completo y adáptalo a tu propia generación.
Etiquetas
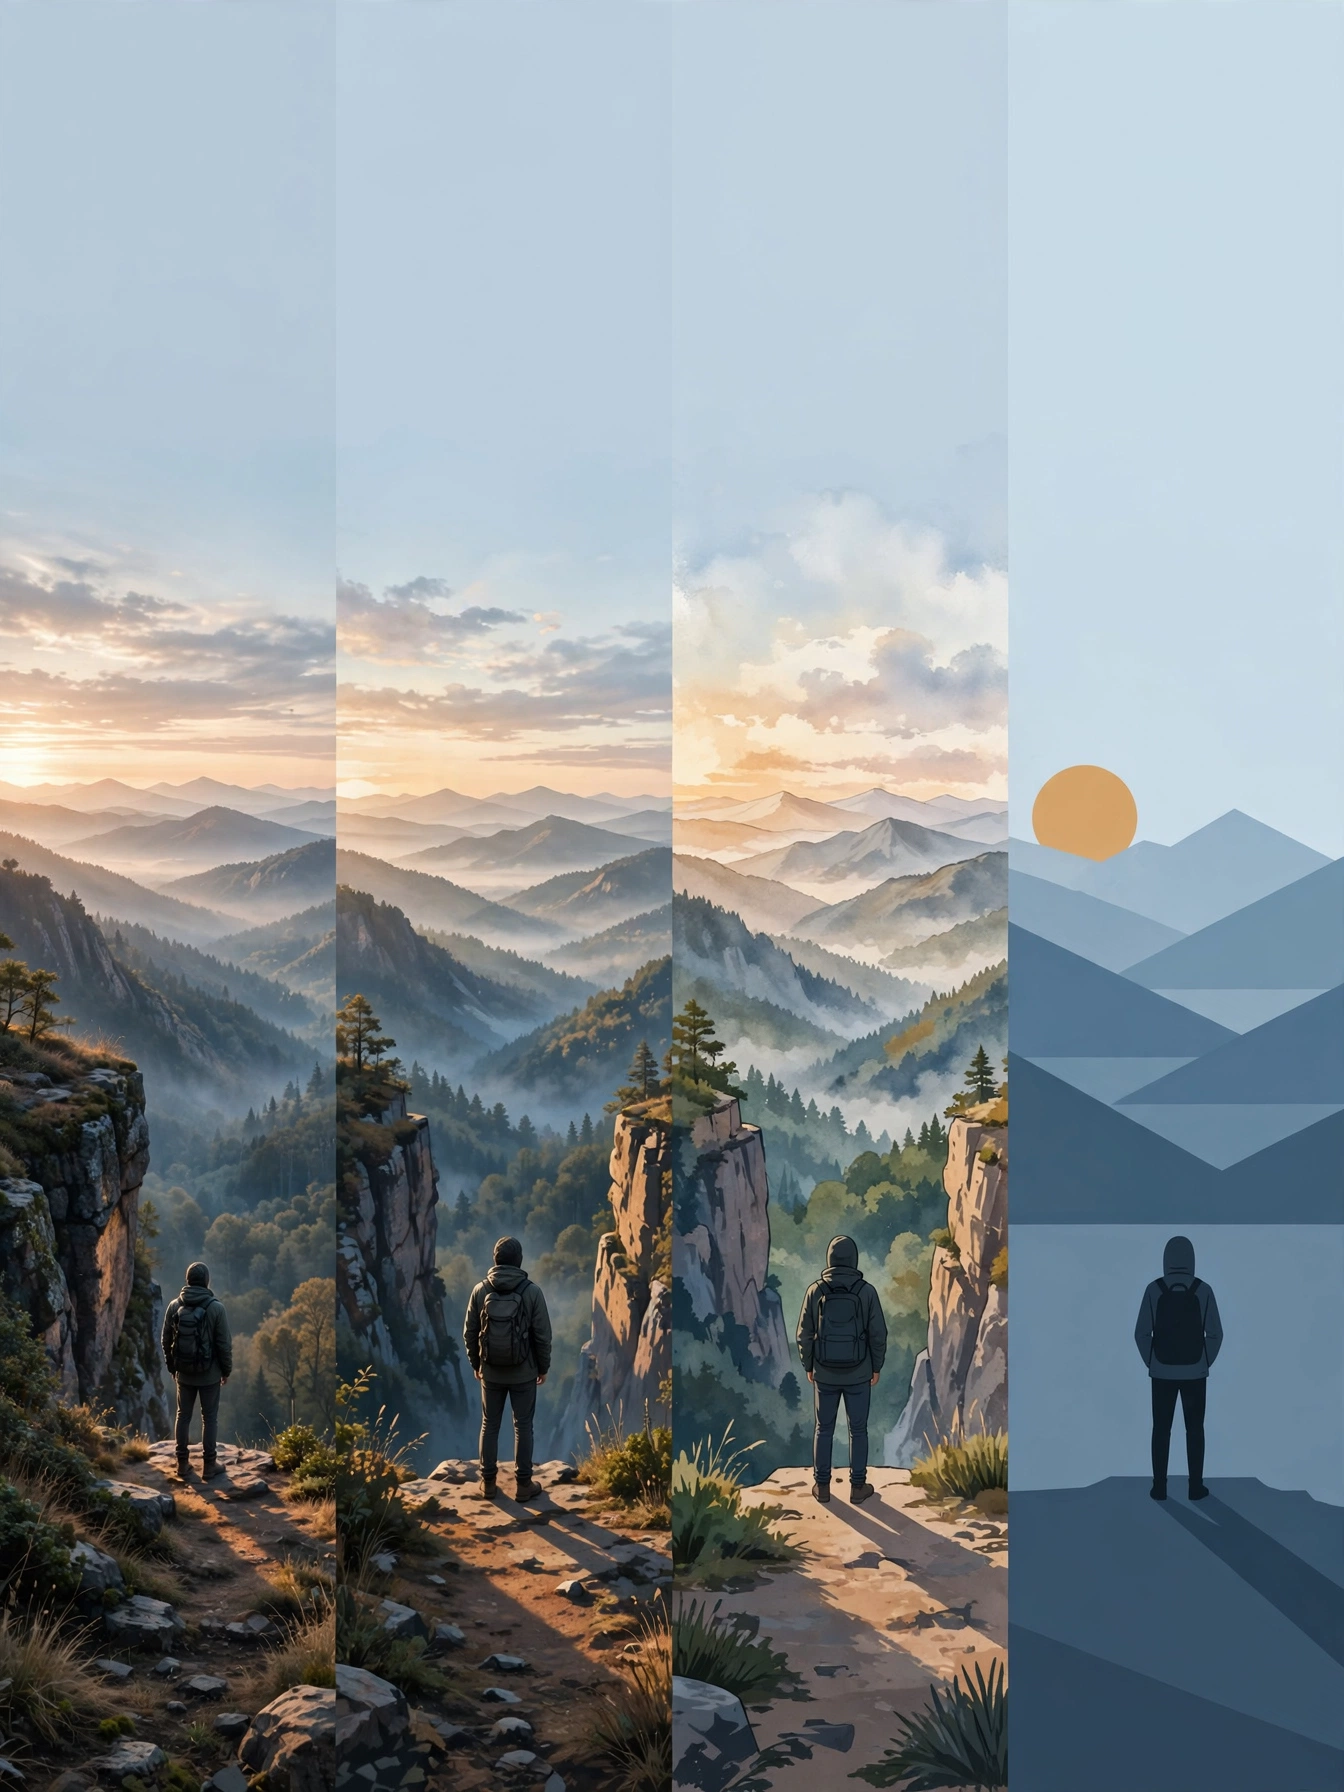
El espectro de estilos de ilustración: del realismo al flat
Estilo Ilustración · Estudio de estilo · Dirección de arte
Prompt
Una única ilustración de estilo editorial con un sujeto protagonista, que recorre el espectro del realismo al flat: una figura solitaria de pie al borde de un acantilado, contemplando un valle escalonado al amanecer. Composición: el sujeto centrado, anclado en el tercio inferior del encuadre, el valle retrocede en franjas horizontales hacia un horizonte alto y lejano, y arriba queda un amplio espacio negativo para la composición tipográfica. Estilo: un lenguaje ilustrativo coherente con fases deliberadamente simplificadas: en un extremo, volumen fotográfico y bruma atmosférica; en el otro, bloques de color vectoriales de bordes duros sin degradados. Iluminación: luz solar cálida y baja proveniente de la izquierda, sombras largas y suaves, luz de relleno ambiental de tonos fríos en el valle. Paleta: azul pizarra desaturado con acentos de ocre cálido, colores limitados y contenidos. Acabado: una obra nítida y lista para imprimir, siluetas limpias, sin texto ni marcas de agua.
Copia el prompt completo y adáptalo a tu propia generación.
Etiquetas
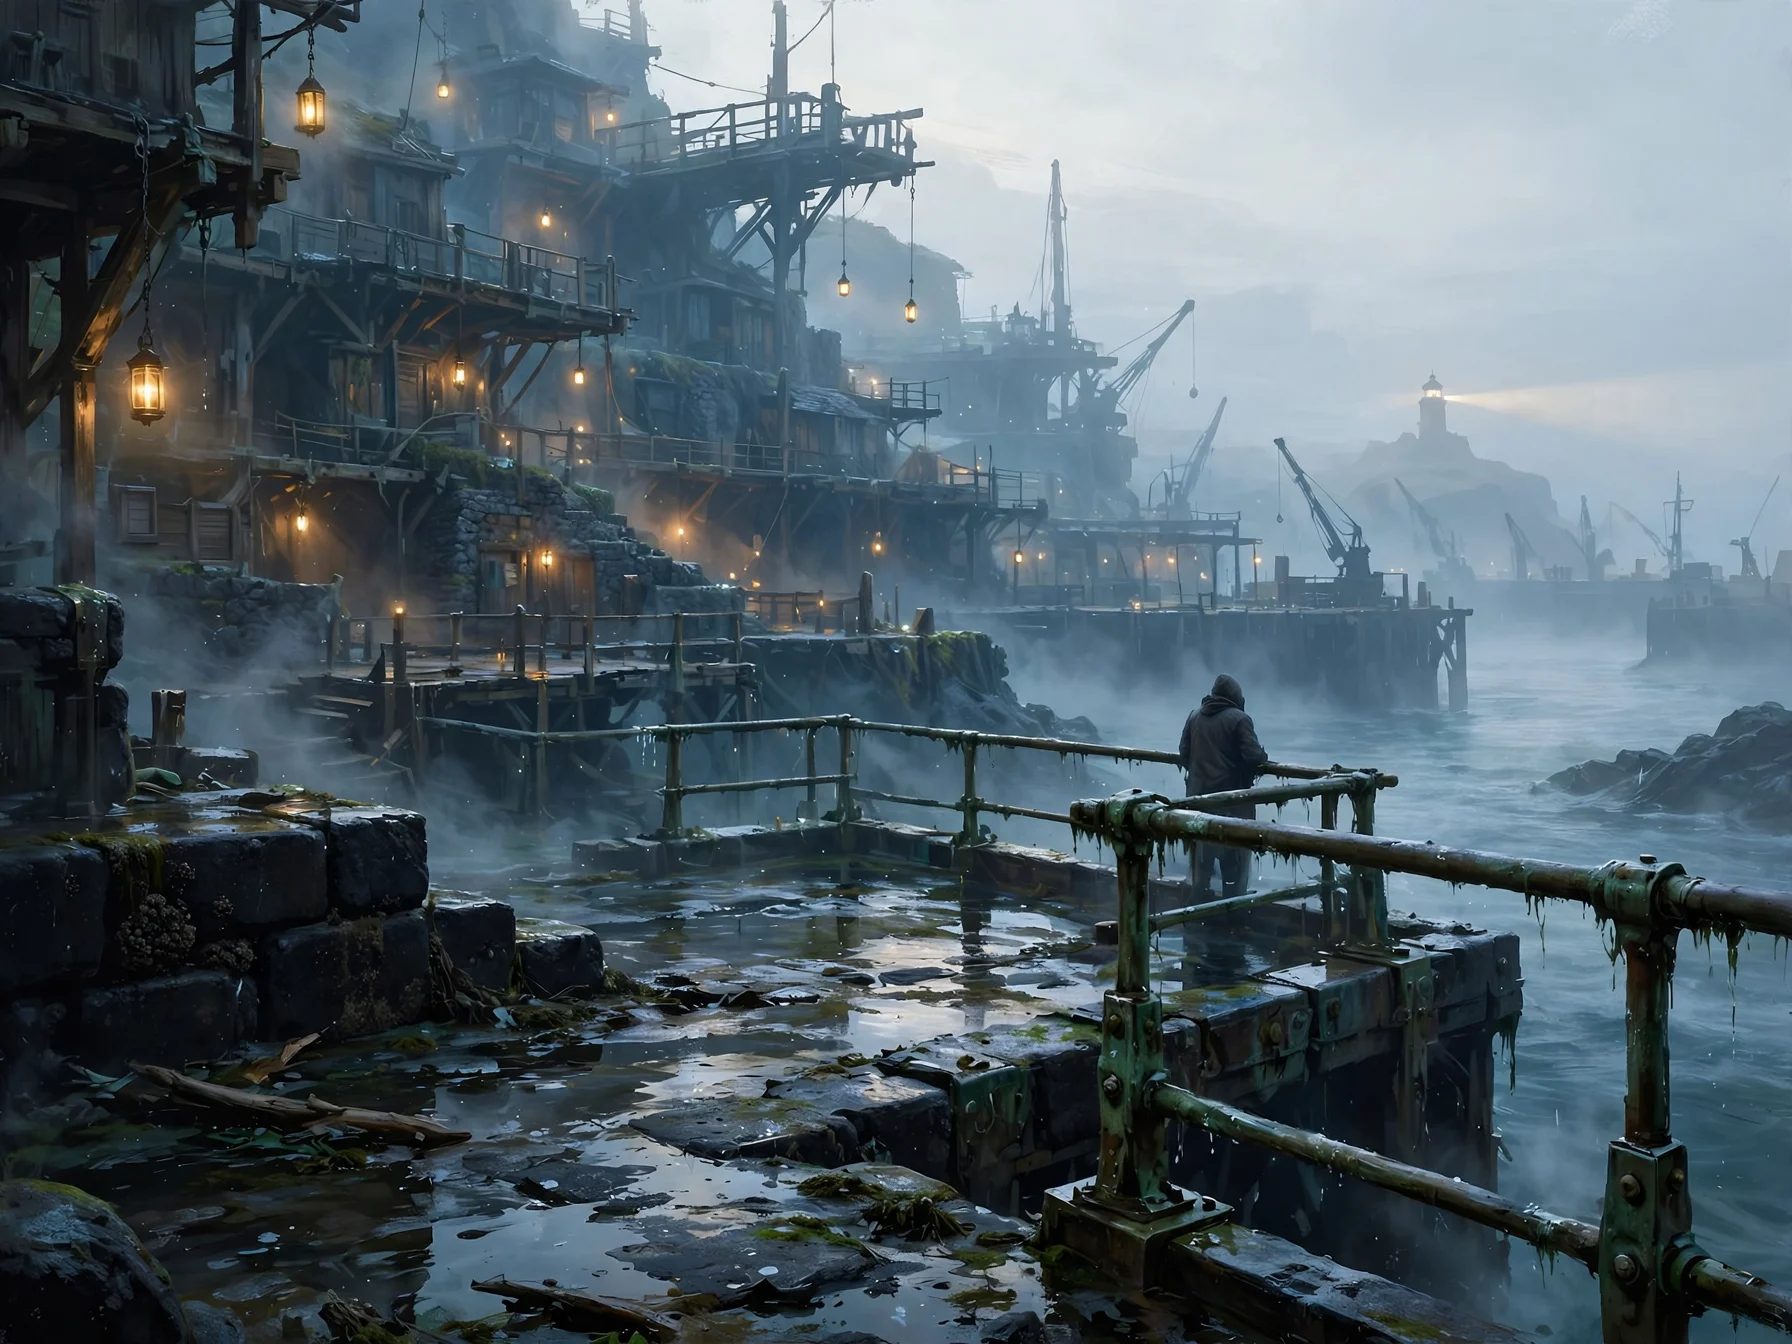
Imagen conceptual de escenario del mundo: Plataforma de mareas del Puerto de Niebla
Estilo Construcción del mundo · Arte conceptual · Atmósfera
Prompt
Una obra de arte conceptual cinematográfica en formato panorámico que representa un puerto costero envuelto en niebla de un mundo ficticio, con una composición panorámica de 21:9. Primer plano: una plataforma de observación de mareas erosionada por el viento marino, construida con basalto oscuro y latón oxidado, que queda medio al descubierto tras la bajamar, con la superficie de piedra húmeda reflejando un cielo pálido. Plano medio: edificios portuarios construidos contra el acantilado en capas superpuestas, pasarelas de madera, faroles colgantes que emiten una cálida luz ámbar en medio de la niebla azul fría, una figura solitaria con un abrigo grueso de pie junto a la barandilla de la plataforma, que sirve para mostrar la escala. Fondo: la desembocadura del puerto se difumina entre capas de niebla, grúas en silueta y el haz de luz de un faro lejano que barre lentamente. Atmósfera: densa niebla marina, salpicaduras de agua dispersas, atenuación de la profundidad de campo con bajo contraste. Iluminación: un amanecer frío y nublado, con una única fuente de luz práctica y cálida proveniente de los faroles, luz volumétrica suave. Estilo: arte conceptual digital de carácter pictórico, paleta contenida —azul pizarra, verde azulado oxidado y ámbar apagado—, detalles de materiales refinados en piedra y metal, sin texto, sin logotipos.
Copia el prompt completo y adáptalo a tu propia generación.
Etiquetas
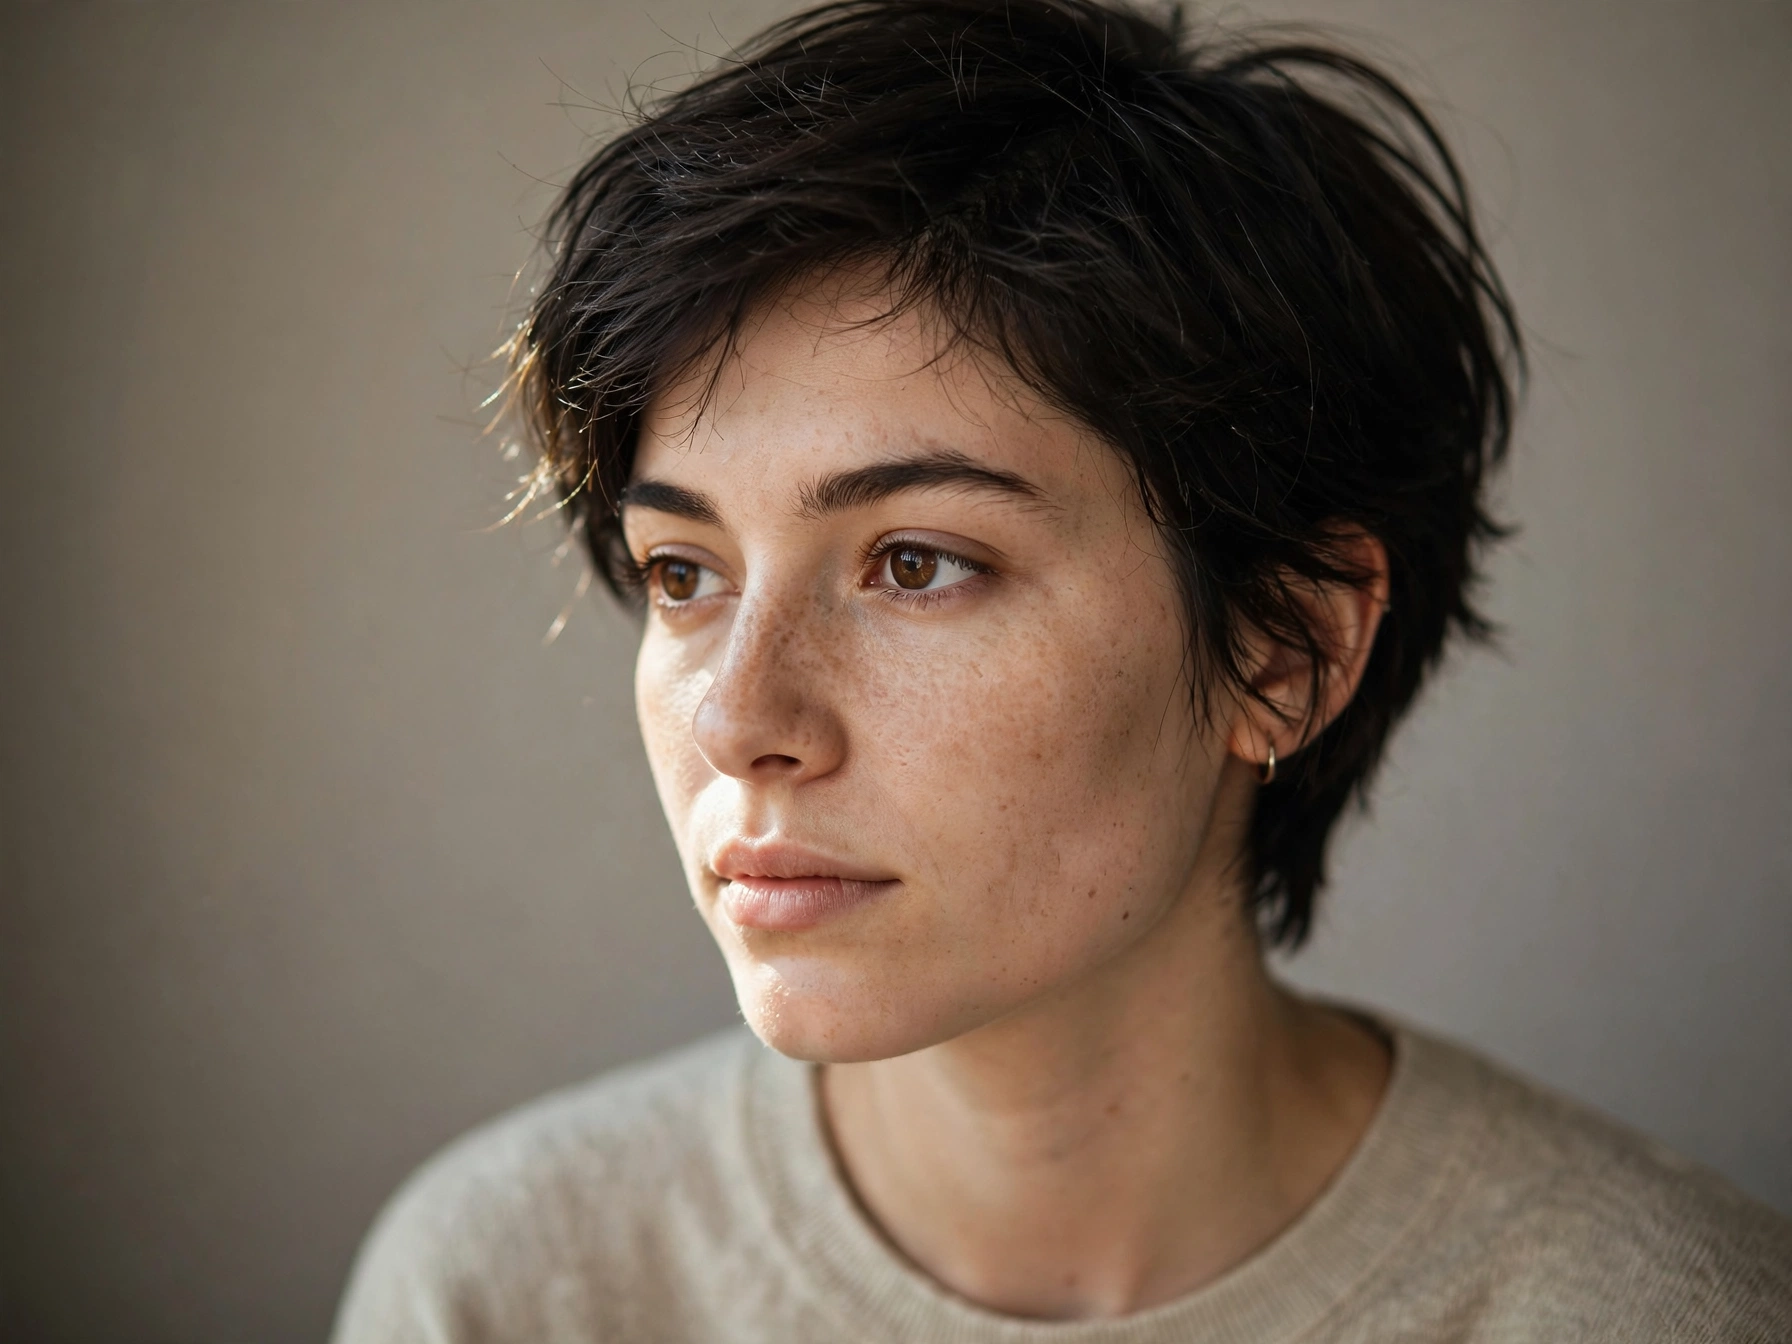
Referencia de estilos de retrato en Muse Image: dos rutas de prompt, realismo y artisticidad
Estilo Retrato y fotografía · Fotorrealismo · Editorial
Prompt
Un retrato de estudio vertical en 3:4, en el que aparece una mujer joven con pecas, cabello corto oscuro, hombros relajados y mirada directa, ligeramente desviada de la cámara. Una luz principal suave y amplia procedente de la izquierda de la cámara forma un sutil contorno luminoso sobre el cabello, y la luz se desvanece suavemente hacia un fondo continuo gris cálido. Capturado con un objetivo de 85 mm a f/2.0, con profundidad de campo reducida, textura de piel realista, poros visibles y finos cabellos, corrección de color contenida y sin rastro de retoque. En conjunto posee una estética de fotografía editorial, una atmósfera tranquila y serena, gran detalle facial y un fondo deliberadamente sencillo para mantener la atención siempre en el sujeto.
Copia el prompt completo y adáptalo a tu propia generación.
Etiquetas
Precios
muse-image-1.0/text-to-image per task
| Precio unitario | $0.015 |
|---|
Descripción general
muse-image-1.0/text-to-image es la línea de solo texto en HiAPI.ai del modelo de texto a imagen lanzado por Meta, que emplea un flujo de generación en el que primero se razona y luego se renderiza: antes de generar la imagen, descompone indicaciones de varios segmentos, planifica la composición del lienzo y se autocorrige durante el razonamiento. Es adecuado para desarrolladores que necesitan generar imágenes por lotes con alta concurrencia y con indicaciones relativamente complejas, por ejemplo, variantes de materiales publicitarios o imágenes de catálogos de productos. Mediante la interfaz unificada de HiAPI.ai, basta con una indicación de texto para generar una imagen, con relación de aspecto y formato de salida opcionales.
Puntos clave
- Primero razona y luego renderiza, indicaciones complejas más controlables: antes del renderizado, descompone indicaciones de varios segmentos en la cadena de razonamiento, planifica la composición e itera y corrige la salida, lo que resulta más adecuado para descripciones estructuradas que la generación en una sola pasada.
- Las indicaciones con alta densidad de conocimiento pueden apoyarse en la búsqueda web: cuando se encuentra una indicación que requiere información del mundo real, se recurre a la búsqueda web para calibrar el contenido, lo que reduce las desviaciones en ilustraciones de tipo factual.
- Una sola llamada produce la imagen final, integración sencilla: solo hay que enviar la indicación de texto para especificar la relación de aspecto y el formato de salida jpeg, png o webp, y obtener directamente un recurso de imagen listo para usar.
Descripción de capacidades
Texto a imagen con razonamiento: descompone indicaciones complejas de varios segmentos en elementos visuales ejecutables, planifica la composición antes del renderizado y se autocorrige, lo que reduce el coste de modificar las indicaciones repetidamente.
Relaciones de aspecto predefinidas: ofrece nueve proporciones: 1:1, 4:3, 3:4, 16:9, 9:16, 3:2, 2:3, 21:9 y 9:21, que pueden seleccionarse directamente según la ubicación del anuncio o el formato, sin necesidad de recortes posteriores.
Salida en varios formatos: admite tres formatos de descarga: jpeg, png y webp, con webp por defecto, lo que facilita elegir según la visualización en el frontend, el archivado o los procesos de tratamiento posteriores.
Compatibilidad con indicaciones largas: el límite de la indicación es de 5000 caracteres, suficiente para albergar necesidades de generación complejas con varios párrafos y descripciones con restricciones.
Casos de uso
- Equipos de publicidad que generan variantes de anuncios por lotes: generar imágenes por lotes con varios conjuntos de indicaciones de texto sobre el mismo argumento de venta, produciendo materiales en distintas proporciones para pruebas de campañas publicitarias multicanal.
- Operaciones de comercio electrónico que crean imágenes de escena de productos: generar imágenes de escena con distintos estilos y composiciones a partir de descripciones de productos, para complementar las ilustraciones de catálogos y páginas de detalles.
- Operaciones de contenido que ilustran temas de conocimiento: introducir descripciones de temas con elementos fácticos y producir ilustraciones ajustadas al contenido, para artículos, publicaciones y redes sociales.
Limitaciones y recomendaciones de selección
La información pública no revela la resolución de salida de esta línea; la relación de aspecto solo determina la proporción, no el tamaño exacto en píxeles, por lo que los escenarios con requisitos estrictos de resolución deben verificarse de antemano. El flujo de razonamiento y la búsqueda web bajo demanda introducen latencia adicional, por lo que no es adecuado para generación en tiempo real con latencia muy baja. La salida se limita a imágenes y no incluye vídeo ni audio. Si la tarea requiere fusión o reescritura a partir de una imagen de referencia, debe elegirse la línea image-to-image de la misma familia.
Preguntas frecuentes
Ver todas las preguntas →-
¿Cómo elegir entre generación de imágenes a partir de texto y edición de imágenes?
Cuando solo se dispone de texto y se parte de cero, elige la generación de imágenes a partir de texto; cuando necesites reutilizar un sujeto o un diseño ya existente, elige la edición de imágenes y proporciona una imagen de referencia.
-
¿Cuántas imágenes se pueden obtener cada vez?
Cada tarea devuelve una imagen, no hay opción de cantidad. Si necesita comparar otra composición, ajuste el prompt y envíe una nueva tarea.
-
¿Se puede elegir 1K, 2K o 4K?
Esta entrada no ofrece niveles de resolución. Tú eliges la relación de aspecto y el modelo determina el tamaño en píxeles, normalmente unos 2.5MP; consulta las dimensiones reales del archivo descargado.
-
¿Qué formatos de archivo se pueden elegir?
Se puede elegir JPEG, PNG o WebP; si no se selecciona ninguno, se usa WebP. Elija según las necesidades posteriores de materiales web o herramientas de diseño.
Crear una tarea de generación
https://api.hiapi.ai/v1/tasks Encabezados
AuthorizationstringObligatorioClave API de la cuenta. Obligatoria en cada solicitud. Ejemplo: Bearer YOUR_HIAPI_API_KEY. Obtener clave API
Content-TypestringOpcionalEl cuerpo de la solicitud siempre se analiza como JSON; si se envía, solo se acepta application/json (charset opcional) — cualquier otro valor devuelve 415. Ejemplo: application/json.
Idempotency-KeystringOpcionalClave de idempotencia, hasta 255 bytes. Los reintentos con la misma clave de la misma cuenta crean la tarea una sola vez; las repeticiones devuelven el taskId original.
Ante timeouts de red o reintentos automáticos del cliente, la misma clave crea la tarea una sola vez, sin doble cobro (alcance = la cuenta de la clave API). Usa un identificador de negocio único (p. ej. "order-42"); las repeticiones devuelven el taskId original y las claves caducan 24 h después de la primera solicitud. La matriz completa de escenarios está en la introducción de la API asíncrona unificada.
Cuerpo
modelstringObligatorioValor fijo actual: muse-image-1.0/text-to-image
routestringOpcionalValor fijo actual: default
inputobjectObligatorio
Objeto de parámetros de negocio para muse-image-1.0/text-to-image y la ruta default; consulta la tabla de parámetros a continuación.
promptstringObligatoriominLength 1maxLength 5000Se utiliza para describir la imagen que se desea generar, o para indicar qué contenido de la imagen de referencia debe modificarse y qué debe conservarse; se proporciona como cadena de texto.
aspect_ratiostringOpcionalSelecciona la relación de aspecto de la imagen de salida; se proporciona como cadena de texto; esta opción no especifica dimensiones exactas en píxeles.
1:14:33:416:99:163:22:321:9Mostrar todo (1)
9:21output_formatstringOpcionalPredeterminado: "webp"Selecciona el formato de archivo de la imagen descargada; se proporciona como cadena de texto; el valor predeterminado es webp.
jpegpngwebpcallbackobjectOpcional
Configuración de notificación de estado terminal. Si se omite, no hay callback: consulta la tarea por tu cuenta.
Indica callback.url al crear y HiAPI hará POST a tu servicio en el estado terminal, sin necesidad de sondeo. El cuerpo del callback replica la estructura del detalle de la tarea; firma, reintentos e idempotencia se detallan en la introducción de la API asíncrona unificada.
urlstringObligatorioObligatorio si se incluye callback. Al estado terminal se envía un POST a esta URL; debe ser una URL http(s) válida.
whenstringOpcionalPredeterminado: "final"Actualmente solo se admite final: notifica tanto en success como en fail.
finalstoragestringOpcionalPredeterminado: "temp"Nivel de almacenamiento de artefactos: temp (por defecto, ~7 días) o persistent (largo plazo, facturado por tamaño). Saldo insuficiente o exceso de límite ⇒ degradación silenciosa a temp; el nivel efectivo se muestra en la respuesta del detalle.
temppersistentEjemplos de solicitud
# Envía una tarea asíncrona; devuelve un taskId de inmediato (sin esperar la generación)
curl -X POST "https://api.hiapi.ai/v1/tasks" \
  -H "Authorization: Bearer $HIAPI_API_KEY" \
  -H "Content-Type: application/json" \
  -d '{
  "model": "muse-image-1.0/text-to-image",
  "input": {
    "prompt": "…",
    "output_format": "webp"
  }
}'
const res = await fetch("https://api.hiapi.ai/v1/tasks", {
method: "POST",
headers: {
Authorization: `Bearer ${process.env.HIAPI_API_KEY}`,
"Content-Type": "application/json",
},
body: JSON.stringify({
model: "muse-image-1.0/text-to-image",
input: {
"prompt": "…",
"output_format": "webp"
}
}),
});
const task = await res.json();
// { code: 200, message: "success", data: { taskId } }import os, requests
res = requests.post(
"https://api.hiapi.ai/v1/tasks",
headers={"Authorization": f"Bearer {os.environ['HIAPI_API_KEY']}"},
json={
"model": "muse-image-1.0/text-to-image",
"input": {
"prompt": "…",
"output_format": "webp"
}
},
)
print(res.json()) # { code, message, data: { taskId } }200 OK
{
  "code": 200,
  "message": "success",
  "data": {
    "taskId": "tk-hiapi-01HZTQ8BX2N3GM3YFK4Z9D7VQR"
  }
}
400 Bad Request
{
  "code": 400,
  "message": "invalid request",
  "data": null,
  "error_code": "INVALID_REQUEST"
}
Obtener el detalle de la tarea
https://api.hiapi.ai/v1/tasks/:id Campos de respuesta
taskIdstringObligatorioID de tarea, siempre con prefijo tk-hiapi-.
modelstringObligatorioNombre completo resuelto del modelo. Las tareas enviadas con el parámetro route devuelven base@route (p. ej. gpt-image-2/text-to-image@ext); si no, coincide con el nombre enviado.
routestringOpcionalSolo aparece si se usó el parámetro route explícito; repite el valor enviado.
statusstringObligatorioEstado de la tarea.
queued En cola, sin iniciar.
handling Procesando.
archiving Proceso terminado, preparando artefactos.
success Terminal: completado, artefactos disponibles (se devuelve output).
fail Terminal: error (se devuelve error).
Tras el envío, guíate por status: success y fail son terminales; el resto, no. Sondea cada 1–3 s hasta el estado terminal. Con éxito, descarga los artefactos desde output[].url y transfiérelos antes de expireAt; para retención larga usa storage: "persistent" al crear.
creatednumberObligatorioHora de creación de la tarea (segundos Unix).
completednumberObligatorioSegundos Unix al alcanzar estado terminal; 0 mientras no sea terminal.
outputarrayOpcional
Solo con status == success. Lista de artefactos — siempre un array; una tarea puede devolver varios types a la vez (p. ej. video + first_frame).
Array [ object ]
Elementos del array
urlstringObligatorioURL del artefacto, descargable directamente.
typestringObligatorioValores posibles actuales: video, image, audio, first_frame, last_frame, thumbnail; podrían ampliarse más adelante.
expireAtnumberObligatorioSegundos Unix hasta los que el artefacto es accesible; descárgalo o transfiérelo antes.
errorobjectOpcional
Solo con status == fail.
codestringObligatorioCódigo de error de negocio.
messagestringObligatorioDescripción del error.
Ejemplos de respuesta
Éxito
{
  "code": 200,
  "message": "success",
  "data": {
    "taskId": "tk-hiapi-01HZTQ8BX2N3GM3YFK4Z9D7VQR",
    "model": "happyhorse-1-0",
    "status": "success",
    "created": 1777282033,
    "completed": 1777282099,
    "output": [
      {
        "url": "https://cdn.hiapi.ai/tasks/.../video.mp4",
        "type": "video",
        "expireAt": 1777886899
      }
    ]
  }
}
En proceso (no terminal)
{
  "code": 200,
  "message": "success",
  "data": {
    "taskId": "tk-hiapi-...",
    "model": "happyhorse-1-0",
    "status": "archiving",
    "created": 1777282033,
    "completed": 0
  }
}
Fallido
{
  "code": 200,
  "message": "success",
  "data": {
    "taskId": "tk-hiapi-...",
    "model": "happyhorse-1-0",
    "status": "fail",
    "created": 1777282033,
    "completed": 1777282099,
    "error": {
      "code": "TASK_FAILED",
      "message": "task failed"
    }
  }
}Artículos
Ver todos los artículos →-

Comparativa
hailuo-2.3-fast/image-to-video comparativa horizontal: cómo elegir un modelo de imagen a video y puntos clave para migrar
-

Tutorial
Cómo llamar a hailuo-2.3/text-to-video mediante la API de HiAPI: curl, Python y ejemplos de solicitud ejecutables
-

Tutorial
Tutorial de kandinsky-6.0-pro/image-to-video en HiAPI: curl + Python
Realiza una solicitud de imagen a video funcional en HiAPI: desde la carga del primer fotograma hasta el sondeo asíncrono y la descarga final
-

Comparativa
Recraft v4.1 Flash comparativa horizontal de texto a imagen: guía de selección y migración para desarrolladores
Con un coste de $0.01 por imagen y capacidad pura de texto a imagen, evalúa si encaja en tu pipeline de generación de imágenes
-

Tutorial
Cómo llamar a kling-4.0/image-to-video en HiAPI: curl, Python y sondeo
-

Tutorial
Uso de Kandinsky 6.0 Pro texto a video en HiAPI: tutorial con curl y Python
Demostración práctica centrada en la solicitud: construir la llamada de prompt a clip de video, enviar la solicitud, sondear el estado de finalización y descargar el resultado
-

Tutorial
Cómo llamar a hailuo-2.3-fast/image-to-video a través de la API de HiAPI: práctica con curl y Python
La primera solicitud ejecutable del nivel rápido y de bajo coste de imagen a vídeo: del ID del modelo a la descarga del MP4
-

Tutorial
Cómo usar kling-4.0/text-to-video a través de la API de HiAPI: curl, Python y un ejemplo de solicitud ejecutable
Guía práctica para desarrolladores: prompts cinematográficos, audio sincronizado, sondeo asíncrono y descarga de resultados
Modelos relacionados
Ver todos los modelos →Mismo tipo
-
 BRIA Product Shot Bria $0.058 /imagen
-
 FLUX 1.1 Pro Black Forest Labs $0.050 /imagen
-
 Ideogram V4 Ideogram $0.050 /imagen
-
 FLUX 3 Image Black Forest Labs $0.041 /imagen
-
 Nano Banana Pro Google $0.057 /imagen
-
 Recraft Creative Upscale Recraft $0.357 /imagen
-
 Wan 2.7 Image Alibaba $0.035 /imagen
-
 FLUX.2 Black Forest Labs $0.035 /imagen
-
 Qwen Image 3.0 Alibaba $0.036 /imagen
-
 Ideogram V3 Character Ideogram $0.090 /imagen
-
 Z-Image Alibaba $0.008 /imagen
-
 Recraft V4.1 Recraft $0.010 /imagen
