
Meta
Muse Image 1.0
muse-image-1.0/text-to-image
Modello di generazione e modifica di immagini con ragionamento di Meta: scompone prima i prompt complessi e poi esegue il rendering, può integrare più immagini di riferimento e si avvale della ricerca web per garantire l'accuratezza fattuale
Prova muse-image-1.0/text-to-image
Input
Creazioni
Vedi tutte le creazioniOutput
image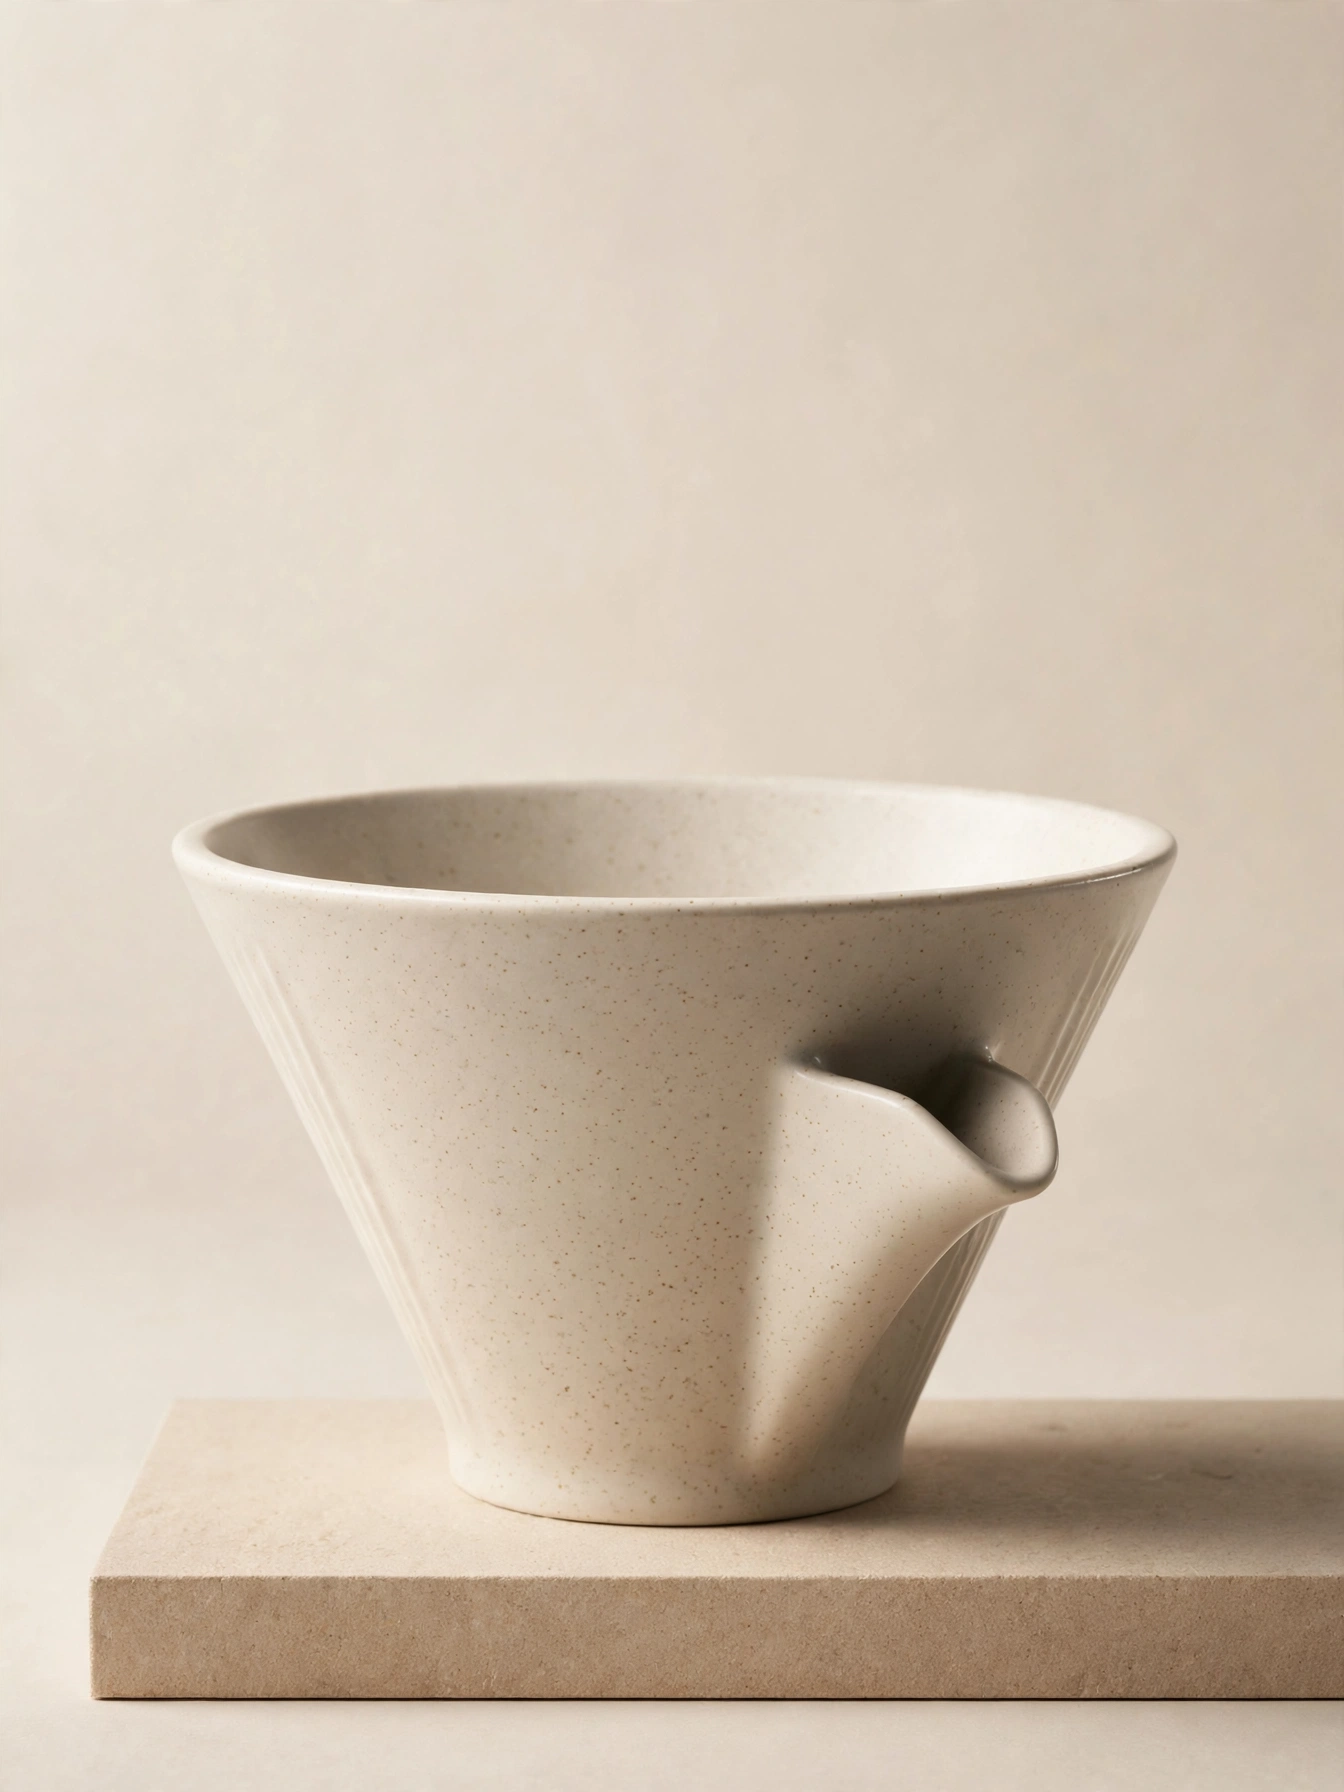
Qualità fotografica di livello e-commerce: generazione di immagini da testo con muse-image
Stile Immagine del prodotto · Illuminazione da studio · Affari
Prompt
Foto prodotto da studio di un dripper per caffè in ceramica opaca, bianco caldo tendente al beige, con vista a tre quarti centrata su una base color sabbia bassa. Sfondo senza giunture beige chiaro, con morbida transizione a gradiente. Luce principale da softbox ampio a 45 gradi in alto a sinistra, pannello di riempimento leggero sulla destra per schiarire le ombre, striscia sottile di luce di contorno sul bordo destro per separare il soggetto dallo sfondo. Sulla superficie smaltata si nota una texture fine a puntinatura, il bordo della tazza è arrotondato e nitido, il beccuccio è geometricamente preciso. Scattato con obiettivo equivalente 85mm, apertura f/8, morbido decadimento sui bordi lontani, senza distorsioni. Estetica di ritocco commerciale pulito, bilanciamento del bianco neutro, alte luci controllate senza sovraesposizione, ombra di contatto morbida che fa poggiare l'oggetto. Composizione verticale 4:3, ampio spazio negativo in alto per l'impaginazione. Nessun testo, nessun logo, nessun oggetto di scena disordinato.
Copia il prompt completo e adattalo alla tua generazione.
Tag
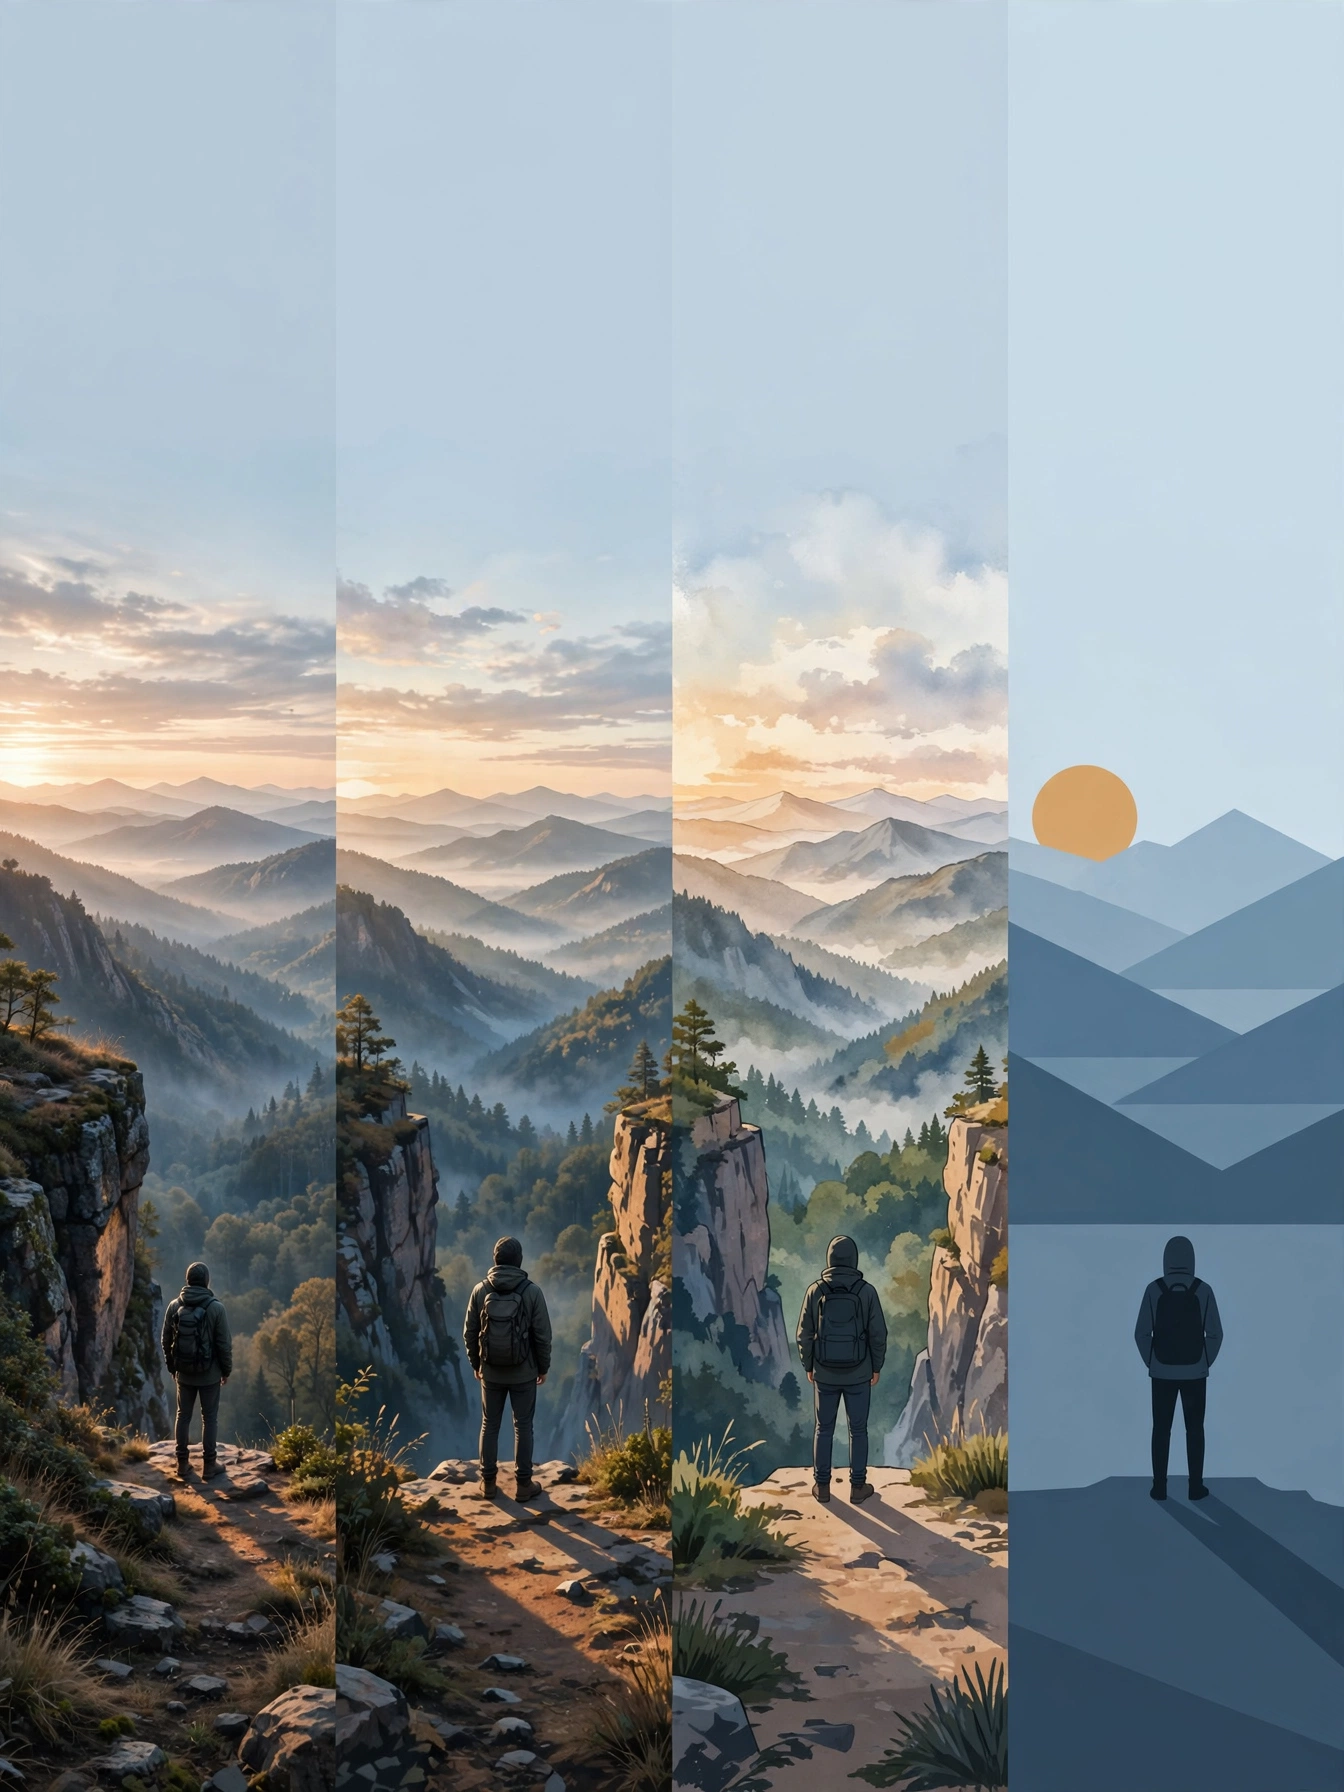
Dallo stile realistico a quello piatto: uno spettro di stili illustrativi
Stile Illustrazione · Studio di stile · Direzione artistica
Prompt
Un'unica illustrazione dal taglio editoriale, presentata lungo uno spettro che va dal realistico al piatto: una figura solitaria in piedi sul bordo di una scogliera, che osserva dall'alto una valle a terrazze stratificate all'alba. Composizione: soggetto centrato, ancorato al terzo inferiore dell'inquadratura, la valle si ritira a bande orizzontali verso un orizzonte alto e lontano, mentre sopra il cielo lascia ampio spazio negativo per l'impaginazione. Stile: un linguaggio illustrativo coerente, con fasi deliberatamente semplificate — a un estremo una resa volumetrica quasi fotografica con foschia atmosferica, all'altro campiture vettoriali a bordi netti senza sfumature. Luce: sole caldo a bassa angolazione da sinistra, ombre lunghe e morbide, luce ambientale di riempimento dai toni freddi nella valle. Palette: blu ardesia desaturati con accenti caldi color ocra, gamma cromatica limitata e misurata. Finitura: opera nitida e pronta per la stampa, silhouette pulite, senza testo né filigrane.
Copia il prompt completo e adattalo alla tua generazione.
Tag
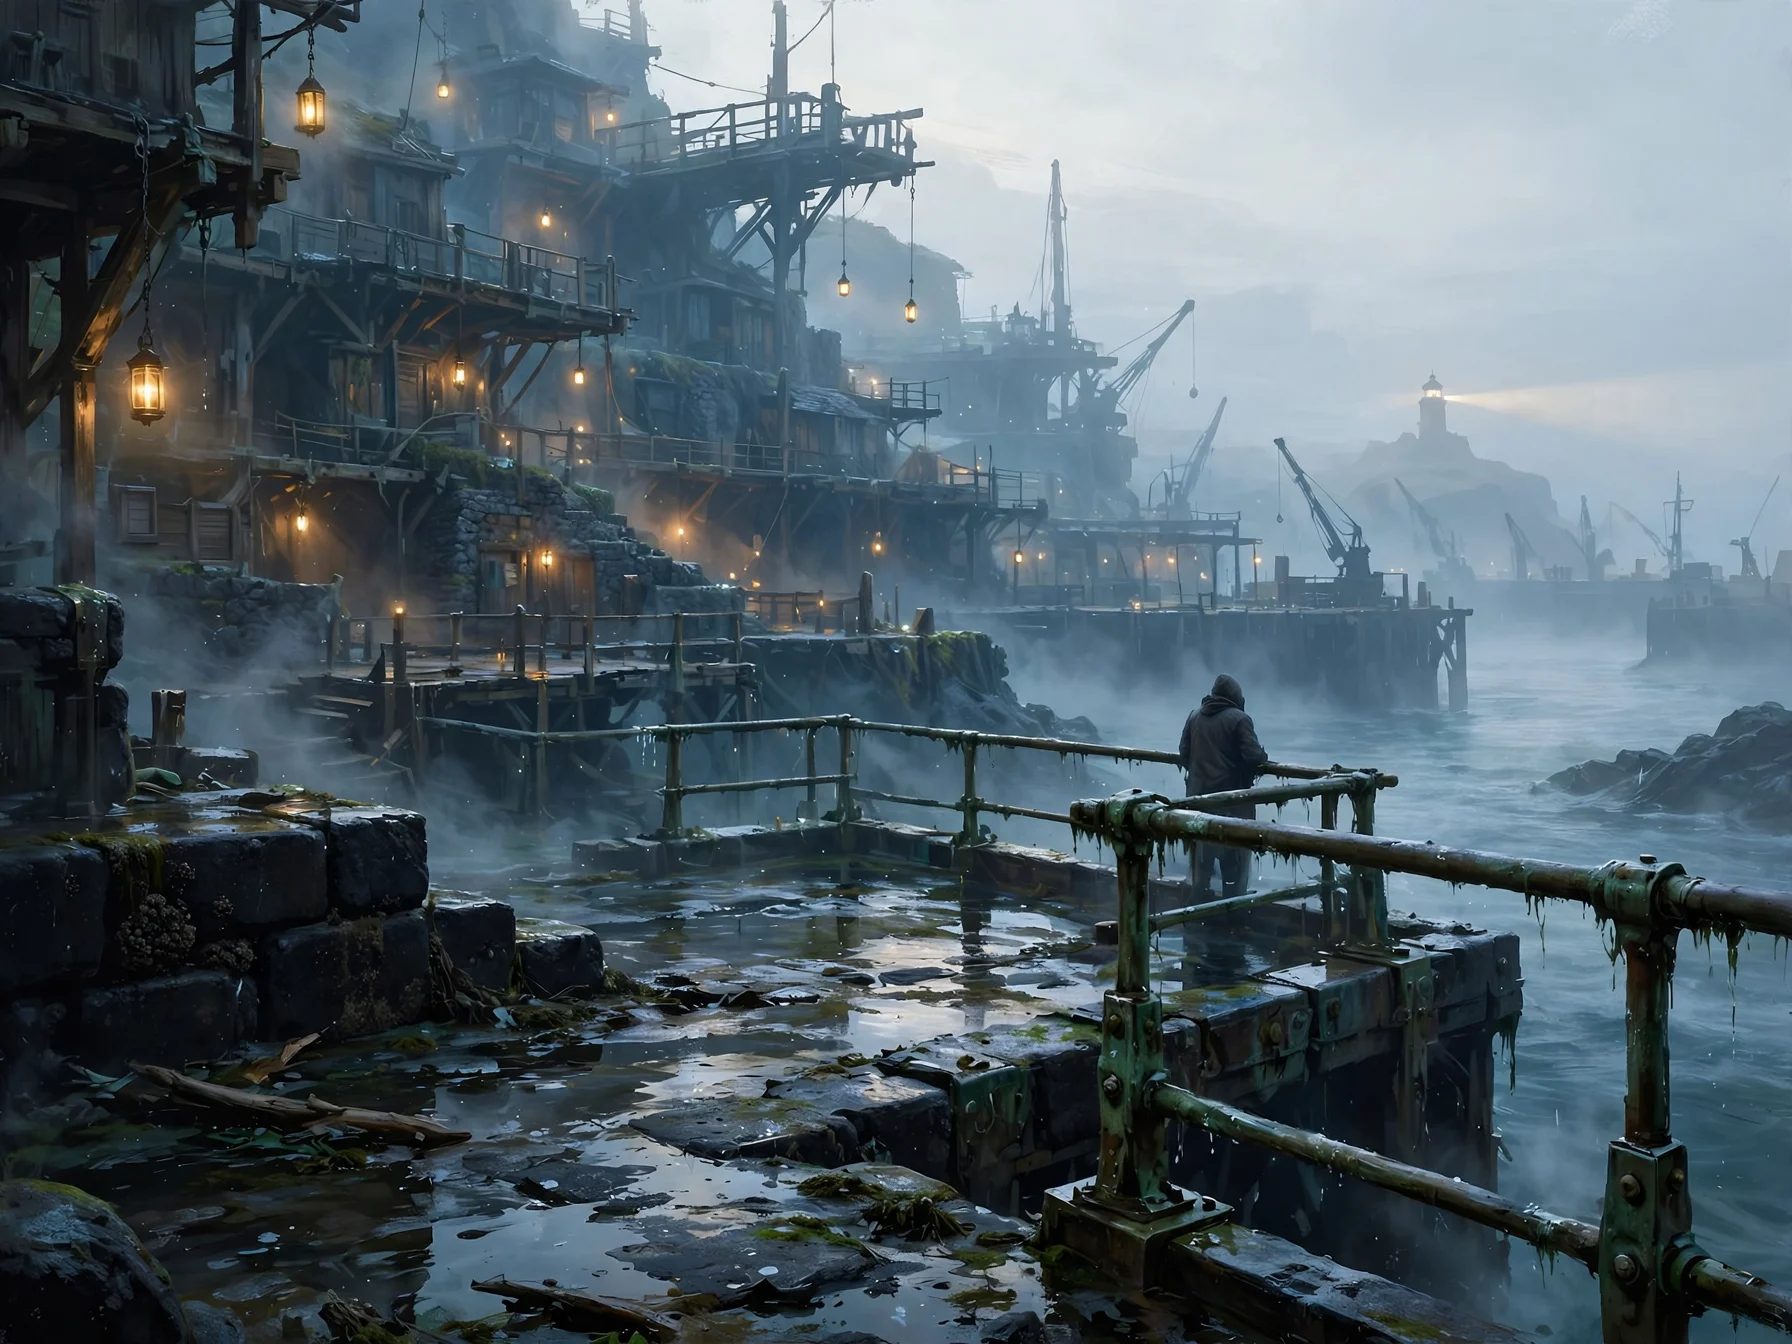
Concept art di scenario worldbuilding: piattaforma di marea nel porto di nebbia
Stile Costruzione del mondo · Concept art · Atmosfera
Prompt
Un'ampia concept art cinematografica che raffigura un porto costiero avvolto dalla nebbia in un mondo immaginario, composizione panoramica 21:9. Primo piano: una piattaforma di osservazione delle maree erosa dal vento marino, costruita in basalto scuro e ottone ossidato, emergente per metà dopo il deflusso, con la superficie lapidea umida che riflette un cielo pallido. Piano intermedio: edifici portuali a terrazze costruiti lungo la scogliera, passerelle in legno, lanterne sospese che diffondono una calda luce ambrata nella nebbia blu fredda, una figura solitaria in un cappotto pesante in piedi accanto alla ringhiera della piattaforma, a dare la scala. Sfondo: l'imboccatura del porto si dissolve in strati di nebbia, gru in silhouette e il fascio di un faro lontano che spazza lentamente. Atmosfera: fitta nebbia marina, spruzzi alla deriva, attenuazione della profondità di campo a basso contrasto. Illuminazione: alba fredda e cupa, un'unica fonte pratica calda data dalle lanterne, morbida luce volumetrica. Stile: concept art digitale pittorica, palette contenuta — blu ardesia, verde ossidato e ambra spento, dettagli materici fini su pietra e metallo, senza testo, senza loghi.
Copia il prompt completo e adattalo alla tua generazione.
Tag
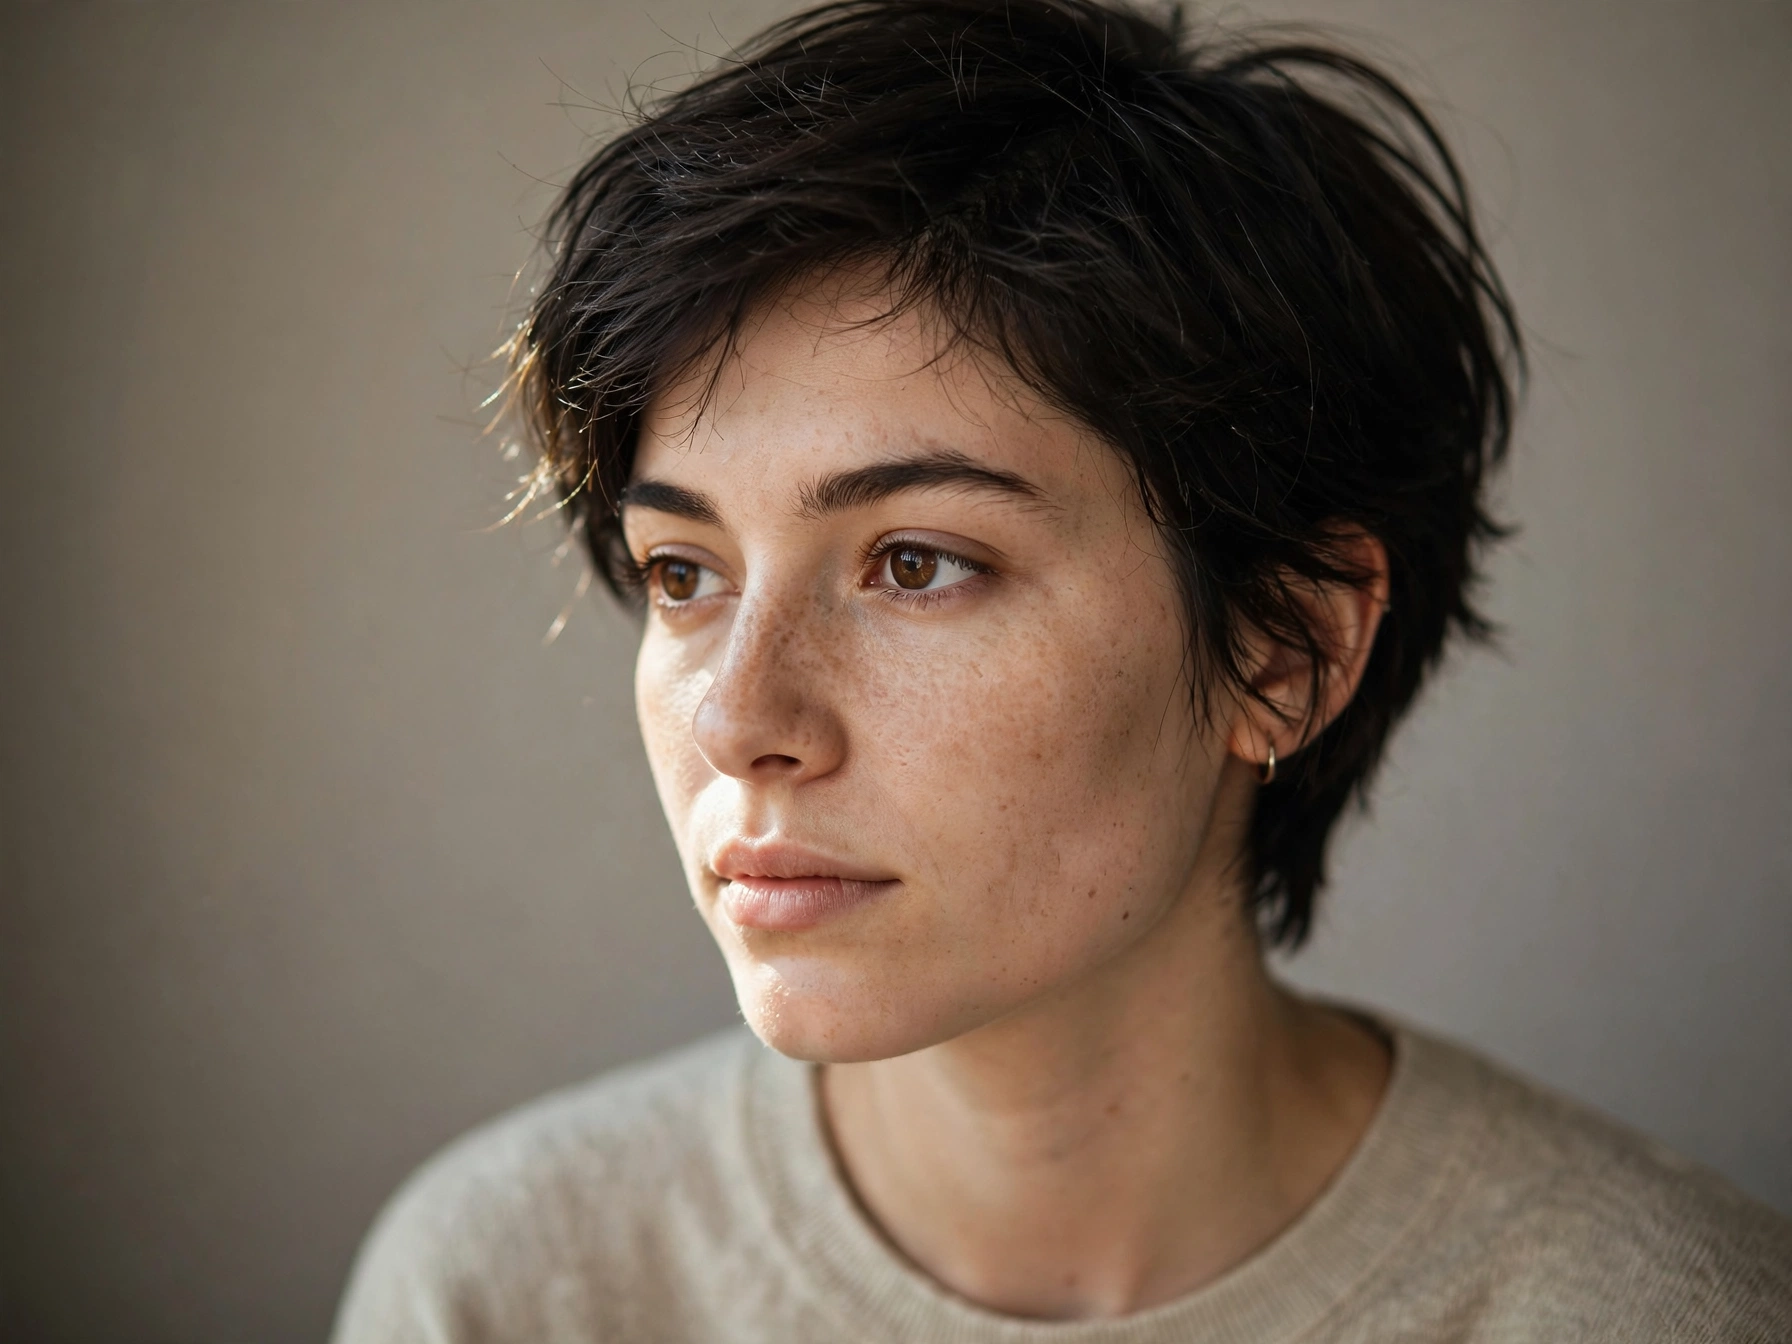
Riferimento di stile per ritratti con Muse Image: due percorsi di prompt, realismo e artisticità
Stile Ritratto e fotografia · Fotorealistico · Editoriale
Prompt
Un ritratto in studio in formato verticale 3:4, con una giovane donna dal volto lentigginoso e i capelli corti scuri, le spalle rilassate, lo sguardo diretto leggermente fuori dall'obiettivo. Una luce principale morbida e ampia proveniente dalla sinistra della fotocamera crea sottili riflessi di contorno sui capelli, sfumando delicatamente in uno sfondo continuo grigio caldo. Scattato con un obiettivo 85mm a f/2.0, profondità di campo ridotta, texture cutanea realistica, pori e sottili ciocche visibili, color grading contenuto, senza tracce di ritocco. Estetica complessiva da fotografia editoriale, atmosfera calma e composta, dettagli del volto ricchi, sfondo volutamente essenziale per mantenere l'attenzione sempre sul soggetto.
Copia il prompt completo e adattalo alla tua generazione.
Tag
Prezzi
muse-image-1.0/text-to-image per task
| Prezzo unitario | $0.015 |
|---|
Panoramica della posizione
muse-image-1.0/text-to-image è la linea puramente testuale su HiAPI.ai del modello text-to-image lanciato da Meta, che adotta un flusso di generazione basato su prima ragionamento e poi rendering: prima di generare l'immagine scompone i prompt multi-segmento, pianifica il layout dell'immagine e si autocorregge durante il ragionamento. È adatto a sviluppatori che necessitano di generazione batch ad alta concorrenza con prompt piuttosto complessi, ad esempio varianti di materiali pubblicitari, immagini di cataloghi prodotti e simili. Tramite l'interfaccia unificata di HiAPI.ai basta un prompt testuale per generare immagini, con rapporto d'aspetto e formato di output selezionabili.
Punti di forza principali
- Prima ragionamento poi rendering, prompt complessi più controllabili——prima del rendering scompone i prompt multi-segmento nella catena di ragionamento, pianifica il layout e corregge iterativamente l'output, risultando più adatto alla generazione strutturata rispetto a una singola generazione forward.
- I prompt ad alta intensità di conoscenza possono avvalersi della ricerca web——quando si incontrano prompt che richiedono informazioni del mondo reale viene attivata la ricerca web per calibrare i contenuti, riducendo le deviazioni nelle illustrazioni di tipo fattuale.
- Output di un'immagine finita con una singola chiamata, integrazione semplice——è sufficiente inviare un prompt testuale per specificare il rapporto d'aspetto e il formato di output jpeg, png o webp, ottenendo direttamente asset immagine pronti all'uso.
Descrizione delle capacità
Text-to-image con ragionamento: scompone prompt complessi multi-segmento in elementi visivi eseguibili, pianifica il layout prima del rendering e si autocorregge, riducendo i costi della modifica ripetuta dei prompt.
Rapporti d'aspetto preimpostati: offre nove rapporti 1:1, 4:3, 3:4, 16:9, 9:16, 3:2, 2:3, 21:9, 9:21, selezionabili direttamente in base al posizionamento o al layout, senza necessità di ritaglio successivo.
Output multi-formato: supporta tre formati di download jpeg, png, webp, predefinito webp, per scegliere facilmente in base alla visualizzazione frontend, all'archiviazione o ai processi di elaborazione successivi.
Supporto a prompt lunghi: il limite del prompt è di 5000 caratteri, sufficiente per esigenze di generazione complesse con più paragrafi e descrizioni vincolate.
Scenari applicabili
- Generazione batch di varianti pubblicitarie da parte dei team di campagne——generare immagini in batch con più gruppi di prompt testuali sullo stesso punto di vendita, producendo materiali con rapporti diversi, direttamente utilizzabili per test di advertising multicanale.
- Realizzazione di immagini di scenario prodotto da parte degli operatori e-commerce——generare immagini di scenario con stili e composizioni diversi a partire da testi descrittivi del prodotto, integrando le immagini dei cataloghi prodotti e delle pagine di dettaglio.
- Illustrazioni per argomenti divulgativi da parte dei content manager——inserendo descrizioni di argomenti con elementi fattuali, produrre illustrazioni aderenti ai contenuti, per articoli, post e pubblicazioni sui social media.
Limiti e consigli per la scelta
I materiali pubblici non rivelano la risoluzione di output di questa linea; il rapporto d'aspetto determina solo le proporzioni, non le dimensioni precise in pixel, quindi gli scenari con requisiti rigidi di risoluzione devono essere verificati in anticipo. Il flusso basato su ragionamento e la ricerca web su richiesta comportano latenze aggiuntive, quindi non è adatto a generazioni in tempo reale con latenza estremamente bassa. L'output è limitato alle immagini e non riguarda video o audio. Se l'attività richiede fusione o riscrittura basate su immagini di riferimento, è necessario scegliere la linea image-to-image della stessa famiglia.
Domande frequenti
Vedi tutte le domande →-
Come scegliere tra generazione di immagini da testo e modifica di immagini?
Scegli la generazione di immagini da testo quando hai solo testo e parti da zero; scegli la modifica di immagini e fornisci un'immagine di riferimento quando devi mantenere un soggetto o un layout esistente.
-
Quante immagini si possono ottenere ogni volta?
Ogni attività restituisce un'immagine, non è possibile scegliere il numero di immagini. Per confrontare un'altra composizione, modifica il prompt e invia una nuova attività.
-
È possibile scegliere 1K, 2K o 4K?
Questa voce non offre livelli di risoluzione. Il formato è a tua scelta, mentre le dimensioni in pixel sono determinate dal modello, di solito circa 2,5 MP; fai riferimento alle dimensioni effettive del file scaricato.
-
Quali formati di file posso scegliere?
Puoi scegliere JPEG, PNG o WebP; se non ne selezioni uno, viene utilizzato WebP. Scegli in base alle esigenze delle successive risorse web o degli strumenti di progettazione.
Crea un'attività di generazione
https://api.hiapi.ai/v1/tasks Header
AuthorizationstringObbligatorioChiave API dell'account. Obbligatoria in ogni richiesta. Esempio: Bearer YOUR_HIAPI_API_KEY. Ottieni una chiave API
Content-TypestringOpzionaleIl corpo della richiesta viene sempre interpretato come JSON; se inviato, è accettato solo application/json (charset facoltativo) — qualsiasi altro valore restituisce 415. Esempio: application/json.
Idempotency-KeystringOpzionaleChiave di idempotenza, fino a 255 byte. I retry con la stessa chiave dello stesso account creano l'attività una sola volta; i replay restituiscono il taskId originale.
In caso di timeout di rete o retry automatici del client, la stessa chiave crea l'attività una sola volta, senza doppi addebiti (ambito = l'account della chiave API). Usa un identificatore univoco di business (es. "order-42"); i replay restituiscono il taskId originale e le chiavi scadono 24 ore dopo la prima richiesta. La matrice completa degli scenari è nell'introduzione dell'API asincrona unificata.
Corpo
modelstringObbligatorioValore fisso attuale: muse-image-1.0/text-to-image
routestringOpzionaleValore fisso attuale: default
inputobjectObbligatorio
Oggetto di parametri di business per muse-image-1.0/text-to-image e la route default — vedi la tabella dei parametri sotto.
promptstringObbligatoriominLength 1maxLength 5000Serve a descrivere l'immagine che si desidera generare, oppure a indicare i contenuti dell'immagine di riferimento da modificare e quelli da mantenere, in forma di stringa.
aspect_ratiostringOpzionaleSeleziona le proporzioni dell'immagine di output, in forma di stringa; questa opzione non specifica dimensioni esatte in pixel.
1:14:33:416:99:163:22:321:9Mostra tutto (1)
9:21output_formatstringOpzionalePredefinito: "webp"Seleziona il formato file dell'immagine da scaricare, in forma di stringa, predefinito webp.
jpegpngwebpcallbackobjectOpzionale
Configurazione di notifica dello stato terminale. Se omessa, nessun callback: interroga l'attività per conto tuo.
Fornisci callback.url in creazione e HiAPI invierà un POST al tuo servizio allo stato terminale, senza polling. Il corpo del callback replica la struttura del dettaglio attività; verifica firma, retry e idempotenza sono descritti nell'introduzione dell'API asincrona unificata.
urlstringObbligatorioObbligatoria se è presente callback. Allo stato terminale viene inviato un POST a questo URL; deve essere un URL http(s) valido.
whenstringOpzionalePredefinito: "final"Al momento è supportato solo final: notifica sia su success sia su fail.
finalstoragestringOpzionalePredefinito: "temp"Livello di archiviazione degli artefatti: temp (predefinito, ~7 giorni) o persistent (a lungo termine, fatturato per dimensione). Saldo insufficiente o superamento del limite ⇒ declassamento silenzioso a temp; il livello effettivo è visibile nella risposta di dettaglio.
temppersistentEsempi di richiesta
# Invia un'attività asincrona; restituisce subito un taskId (senza attendere la generazione)
curl -X POST "https://api.hiapi.ai/v1/tasks" \
  -H "Authorization: Bearer $HIAPI_API_KEY" \
  -H "Content-Type: application/json" \
  -d '{
  "model": "muse-image-1.0/text-to-image",
  "input": {
    "prompt": "…",
    "output_format": "webp"
  }
}'
const res = await fetch("https://api.hiapi.ai/v1/tasks", {
method: "POST",
headers: {
Authorization: `Bearer ${process.env.HIAPI_API_KEY}`,
"Content-Type": "application/json",
},
body: JSON.stringify({
model: "muse-image-1.0/text-to-image",
input: {
"prompt": "…",
"output_format": "webp"
}
}),
});
const task = await res.json();
// { code: 200, message: "success", data: { taskId } }import os, requests
res = requests.post(
"https://api.hiapi.ai/v1/tasks",
headers={"Authorization": f"Bearer {os.environ['HIAPI_API_KEY']}"},
json={
"model": "muse-image-1.0/text-to-image",
"input": {
"prompt": "…",
"output_format": "webp"
}
},
)
print(res.json()) # { code, message, data: { taskId } }200 OK
{
  "code": 200,
  "message": "success",
  "data": {
    "taskId": "tk-hiapi-01HZTQ8BX2N3GM3YFK4Z9D7VQR"
  }
}
400 Bad Request
{
  "code": 400,
  "message": "invalid request",
  "data": null,
  "error_code": "INVALID_REQUEST"
}
Ottieni i dettagli dell'attività
https://api.hiapi.ai/v1/tasks/:id Campi della risposta
taskIdstringObbligatorioID attività, sempre con prefisso tk-hiapi-.
modelstringObbligatorioNome completo risolto del modello. Le attività inviate con il parametro route restituiscono base@route (es. gpt-image-2/text-to-image@ext); altrimenti coincide con il nome inviato.
routestringOpzionalePresente solo se è stato usato il parametro route esplicito; restituisce il valore inviato.
statusstringObbligatorioStato dell'attività.
queued In coda, non avviata.
handling In elaborazione.
archiving Elaborazione conclusa, preparazione artefatti.
success Terminale: completato, artefatti disponibili (restituisce output).
fail Terminale: errore (restituisce error).
Dopo l'invio, segui status: success e fail sono terminali, il resto no. Esegui polling ogni 1–3 s fino allo stato terminale. In caso di successo scarica gli artefatti da output[].url e trasferiscili prima di expireAt; per conservazione lunga usa storage: "persistent" in creazione.
creatednumberObbligatorioIstante di creazione dell'attività (secondi Unix).
completednumberObbligatorioSecondi Unix dello stato terminale; 0 finché non terminale.
outputarrayOpzionale
Presente solo con status == success. Elenco artefatti — sempre un array; un'attività può restituire più type contemporaneamente (es. video + first_frame).
Array [ object ]
Elementi dell'array
urlstringObbligatorioURL dell'artefatto, scaricabile direttamente.
typestringObbligatorioValori attualmente possibili: video, image, audio, first_frame, last_frame, thumbnail; potrebbero essere ampliati in futuro.
expireAtnumberObbligatorioSecondi Unix di disponibilità dell'artefatto; scarica o trasferisci prima della scadenza.
errorobjectOpzionale
Presente solo con status == fail.
codestringObbligatorioCodice errore di business.
messagestringObbligatorioDescrizione dell'errore.
Esempi di risposta
Successo
{
  "code": 200,
  "message": "success",
  "data": {
    "taskId": "tk-hiapi-01HZTQ8BX2N3GM3YFK4Z9D7VQR",
    "model": "happyhorse-1-0",
    "status": "success",
    "created": 1777282033,
    "completed": 1777282099,
    "output": [
      {
        "url": "https://cdn.hiapi.ai/tasks/.../video.mp4",
        "type": "video",
        "expireAt": 1777886899
      }
    ]
  }
}
In elaborazione (non terminale)
{
  "code": 200,
  "message": "success",
  "data": {
    "taskId": "tk-hiapi-...",
    "model": "happyhorse-1-0",
    "status": "archiving",
    "created": 1777282033,
    "completed": 0
  }
}
Non riuscito
{
  "code": 200,
  "message": "success",
  "data": {
    "taskId": "tk-hiapi-...",
    "model": "happyhorse-1-0",
    "status": "fail",
    "created": 1777282033,
    "completed": 1777282099,
    "error": {
      "code": "TASK_FAILED",
      "message": "task failed"
    }
  }
}Articoli
Vedi tutti gli articoli →-

Tutoriale
Come chiamare kling-4.0/image-to-video su HiAPI: curl, Python e polling
-

Confronto e valutazione
hailuo-2.3-fast/image-to-video confronto orizzontale: come scegliere un modello image-to-video e i punti chiave per la migrazione
-

Confronto e valutazione
Confronto orizzontale di Recraft v4.1 Flash per la generazione di immagini da testo: guida alla scelta e alla migrazione per gli sviluppatori
Con un costo di $0,01 per immagine e la capacità di generazione puramente testuale, valuta se è adatto alla tua pipeline di generazione di immagini
-

Tutoriale
Come chiamare hailuo-2.3-fast/image-to-video tramite l'API HiAPI: pratica con curl e Python
La prima richiesta funzionante per il livello image-to-video veloce ed economico — dall'ID del modello al download di un MP4
-

Tutoriale
Come usare kling-4.0/text-to-video tramite l'API HiAPI: curl, Python e un esempio di richiesta funzionante
Guida pratica per sviluppatori: prompt cinematografici, audio sincronizzato, polling asincrono e download dell'output
-

Tutoriale
recraft-v4.1-flash text-to-image in pratica: 5 scenari di business ad alto valore e punti chiave di integrazione
Partendo da un costo di $0,01 per immagine, pianificare l'implementazione della generazione di immagini nei processi di business reali
-

Tutoriale
Utilizzare Kandinsky 6.0 Pro su HiAPI per la generazione di video da testo: tutorial con curl e Python
Dimostrazione pratica guidata dalla richiesta: costruire la chiamata da prompt a clip video, inviare la richiesta, monitorare lo stato di completamento e scaricare il risultato
-

Tutoriale
Tutorial su kandinsky-6.0-pro/image-to-video tramite HiAPI: curl + Python
Avvia una richiesta funzionante di image-to-video su HiAPI: dal caricamento del primo fotogramma al polling asincrono fino al download finale
-

Tutoriale
Come chiamare hailuo-2.3/text-to-video tramite l'API HiAPI: curl, Python ed esempi di richiesta eseguibili
Modelli correlati
Vedi tutti i modelli →Stesso tipo
-
 FLUX.1 Schnell Black Forest Labs $0.005 /immagine
-
 FLUX.2 Black Forest Labs $0.035 /immagine
-
 Qwen Image 3.0 Alibaba $0.036 /immagine
-
 Google Virtual Try-On Google $0.107 /immagine
-
 Nano Banana 2 Lite Google $0.033 /immagine
-
 Nano Banana Pro Google $0.057 /immagine
-
 FLUX.1 Kontext Max Black Forest Labs $0.071 /immagine
-
 Nano Banana 2 Google $0.036 /immagine
-
 Recraft Creative Upscale Recraft $0.357 /immagine
-
 Grok Imagine Image 2.0 xAI $0.052 /immagine
-
 Nano Banana Google $0.021 /immagine
-
 Recraft Crisp Upscale Recraft $0.004 /immagine
