
Comparatif et évaluation
gpt-image-2.6-flare/image-to-image comparatif : comment choisir et migrer un modèle image-to-image
Sur cette page
Quel type de problème ce modèle résout-il
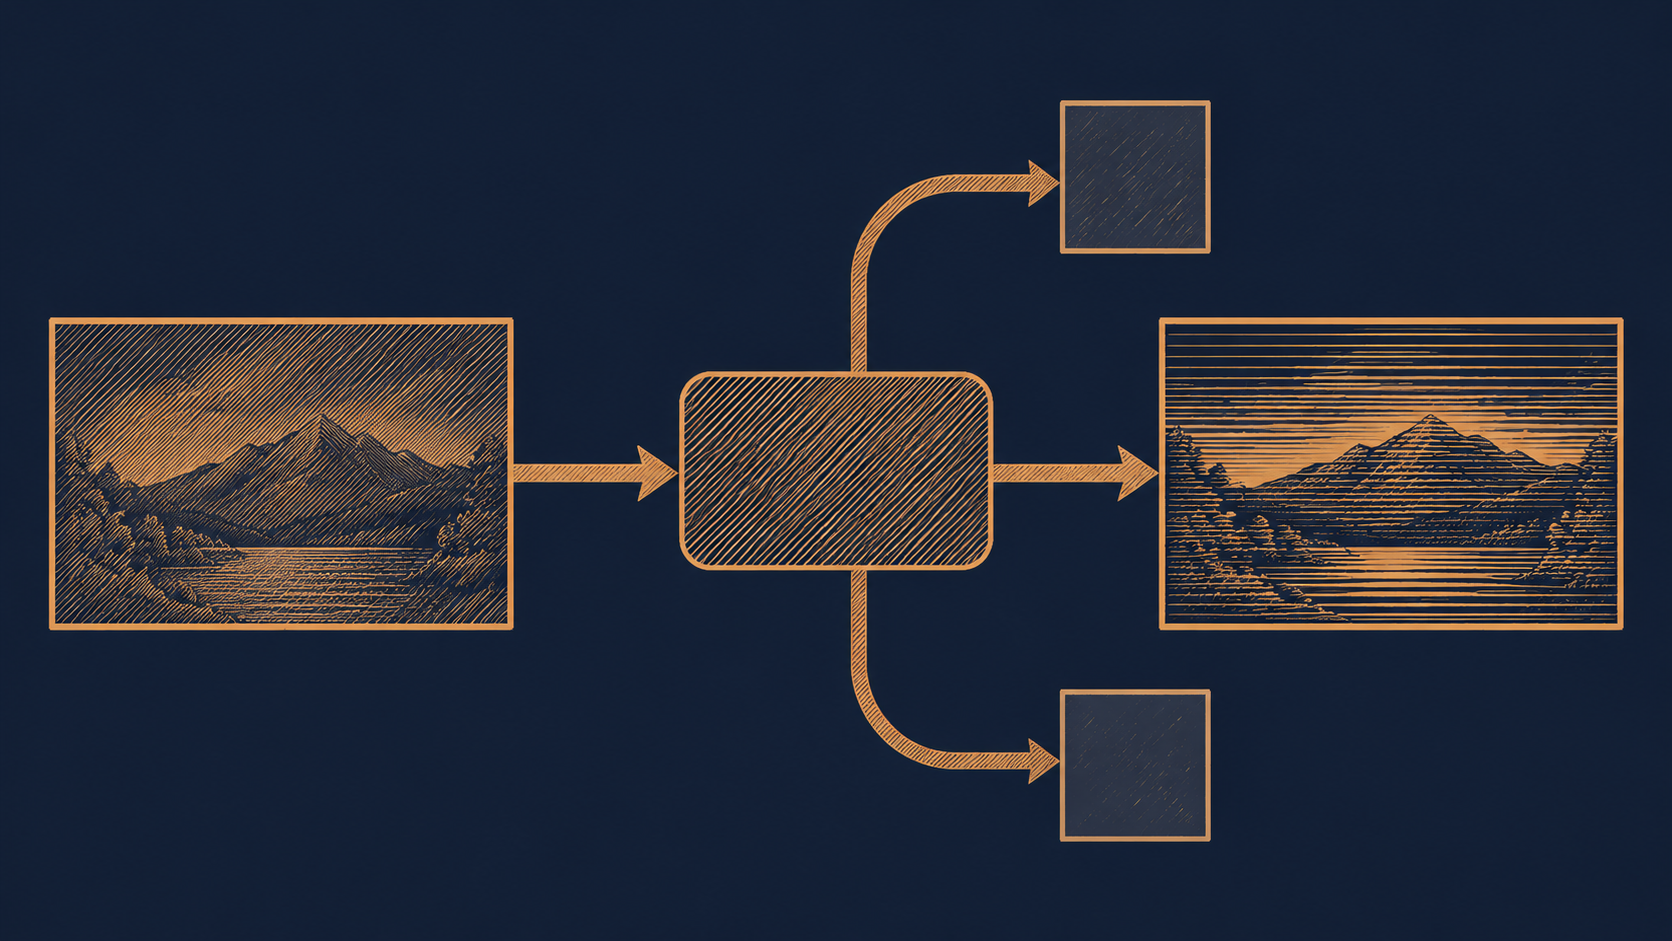
gpt-image-2.6-flare/image-to-image est un modèle image-to-image fourni par OpenAI, dont le type de sortie est une image. En décortiquant le nom, la question à laquelle il répond est très concrète : étant donné une image d'entrée, générer une image résultante modifiée ou redessinée à partir de cette image.
Ce type de tâche se présente généralement en ingénierie sous les formes suivantes :
- Édition locale : conserver le sujet et la composition, ne modifier que la zone spécifiée (changer l'arrière-plan, supprimer un objet, modifier la matière).
- Redessin de style et de teinte : entrer une photo, produire une illustration, un dessin au trait, une version dans un style visuel spécifique.
- Génération de variantes : produire plusieurs candidats à partir d'une même image d'entrée, pour que les équipes marketing ou design puissent choisir.
- Pilotage par image de référence : utiliser une image de référence comme point d'ancrage visuel pour contraindre le sujet, la palette de couleurs ou la mise en page de la nouvelle image.
Sa différence avec la génération purement textuelle réside dans l'entrée. La génération textuelle ne dispose que d'un prompt, le modèle a une grande liberté, et la qualité dépend fortement de la chance du prompt ; l'image-to-image ajoute une image d'entrée comme contrainte, la cohérence et la contrôlabilité entre la sortie et l'entrée sont plus facilement gérables par des moyens d'ingénierie — c'est pourquoi, dans les produits réels, lorsqu'il s'agit de fonctions de « retouche d'image », l'image-to-image est généralement le choix par défaut, plutôt que de demander à l'utilisateur de réécrire sans cesse le prompt.
À l'inverse, si votre besoin est simplement de « générer une image à partir de zéro », sans image de référence ni image originale à conserver, alors ce modèle n'est pas le chemin le plus court. La première étape de la sélection n'est pas de comparer la force des modèles, mais de confirmer d'abord si votre entrée contient réellement cette image.
Ce que signifie une facturation à l'image
La tarification de ce modèle est par nombre d'images générées, et non par token. Cette différence affecte directement votre façon d'estimer le budget.
Différence d'estimation entre facturation à l'image et au token
Avec une facturation au token, le coût unitaire dépend de la longueur du prompt, de la résolution de sortie et d'autres facteurs ; le coût d'une même fonction varie selon les entrées, et le budget doit souvent prévoir une marge importante. La facturation à l'image fixe le coût par appel, le coût total est approximativement égal à :
Coût total ≈ nombre d'images générées × coût par image
L'avantage de cette relation linéaire est qu'elle est rétro-calculable. Vous savez déjà combien d'images chaque opération utilisateur génère en moyenne (par exemple, « générer 4 candidats » correspond à 4 images), vous pouvez donc calculer directement le coût marginal par utilisateur actif et par point d'entrée fonctionnel, sans devoir d'abord lancer une campagne d'échantillonnage pour connaître le coût approximatif par appel.
Comment l'appliquer à votre échelle
Il est recommandé d'estimer en trois étapes :
- Clarifier l'unité de comptage : une requête renvoie-t-elle une ou plusieurs images ? Les tentatives en cas d'échec comptent-elles comme des images supplémentaires ?
- Estimer la fréquence d'appel : volume réel de requêtes par jour × nombre moyen d'images par requête, pour obtenir le nombre d'images générées par jour/mois.
- Prévoir une marge pour les tentatives et le déploiement progressif : comptabiliser séparément les tentatives en cas d'échec, les expériences A/B et les tests internes.
Il faut rappeler que, dans le cadre d'une facturation à l'image, savoir si la résolution ou le niveau de qualité affecte le prix unitaire relève des détails de l'interface ; les modèles diffèrent sur ce point, il convient de le vérifier dans le panneau de tarification et la documentation de l'API avant la mise en production, plutôt que de supposer par défaut qu'« une image compte pour une image ». De plus, l'image-to-image s'accompagne souvent de coûts de téléversement et de stockage ; l'hébergement des images et le trafic CDN sont souvent du même ordre de grandeur que les frais d'inférence, ne calculez pas seulement la partie modèle.
Quelles dimensions examiner dans une comparaison
L'erreur la plus courante dans la sélection d'un modèle image-to-image est de « comparer uniquement le prix unitaire ». Le coût par image ne représente qu'un cinquième de l'information ; il est recommandé d'examiner ensemble les dimensions suivantes.
1. Cohérence avec l'entrée
La valeur essentielle de l'image-to-image est de « ressembler à l'image originale ». Il faut examiner la stabilité du modèle à préserver les contours du sujet, les visages, le texte et la mise en page. Un modèle peu cohérent donne l'impression qu'« après modification, c'est une autre image », ce que l'utilisateur remarque immédiatement.
2. Contrôlabilité
Pouvez-vous diriger précisément la portée des modifications via des paramètres et des prompts ? L'édition locale prend-elle en charge des contraintes de zone ? L'intensité du transfert de style est-elle réglable ? Un modèle peu contrôlable rend la conception d'interaction côté produit impossible — car il est impossible de promettre à l'utilisateur que « ce que vous encerclez sera modifié ».
3. Coût par image
C'est-à-dire le prix unitaire facturé à l'image. C'est la seule chose qui peut s'écrire sous forme de ligne droite, mais elle n'est comparable qu'entre modèles ayant le même mode de facturation ; comparer directement un prix à l'image avec un prix au token donne généralement un résultat erroné.
4. Latence et débit
La retouche d'image est un scénario fortement interactif, l'utilisateur attend après avoir cliqué. Le temps jusqu'au premier octet, le temps de génération par image et l'éventuelle file d'attente en cas de forte concurrence déterminent directement si cette fonction peut être proposée en aperçu temps réel. Les tâches batch hors ligne se soucient davantage du débit que de la latence par image.
5. Forme de l'interface et des paramètres
Comment transmettre l'image d'entrée (URL, base64, ou faut-il d'abord la téléverser) ? Comment la sortie est-elle renvoyée (directement, ou via un ID de tâche à interroger) ? Y a-t-il des réglages comme seed, taille, intensité ? Cela détermine la charge d'intégration, ainsi que le coût de migration.
Transformez ces cinq points en un tableau de notation comparative, attribuez une note à chaque candidat plutôt que de n'indiquer que le prix ; vous constaterez souvent que l'écart entre les candidats ne se situe pas sur le plan financier.
Comment mener une expérience de sélection fiable sur un petit échantillon
Ne choisissez pas un modèle au feeling. Utilisez une expérience comparative sur un petit échantillon, réalisable en une demi-journée ; la conclusion sera plus fiable que n'importe quel article d'évaluation.
Première étape : sélectionner 8 à 15 entrées représentatives
L'échantillon doit couvrir la distribution réelle de votre activité, et pas seulement « de belles images » :
- Images de scénarios typiques (éclairage normal, composition standard)
- Échantillons difficiles (faible résolution, texte dense, photos de groupe)
- Échantillons limites (rapports d'aspect extrêmes, contenus non photographiques)
Chaque image est associée à une instruction d'édition fixe, tous les modèles candidats utilisent exactement les mêmes entrées et instructions.
Deuxième étape : définir les critères de notation
Fixez les critères de notation à l'avance, pour éviter de chercher des justifications après coup. Quatre critères recommandés, notés de 1 à 5 :
- Fidélité : le sujet, la structure et le texte sont-ils correctement préservés
- Respect de l'instruction : la modification demandée a-t-elle réellement été effectuée
- Qualité de l'image : artefacts, distorsions, dégradations locales
- Utilisabilité : ce résultat peut-il être livré directement à l'utilisateur
Troisième étape : évaluation en aveugle et consignation
Mélangez l'ordre des noms de fichiers de sortie avant de noter, pour réduire le biais lié à « savoir qui a produit l'image ». Le tableau d'enregistrement doit contenir au minimum : ID de l'échantillon, modèle, quatre notes, temps de génération, échec ou non, coût par appel.
Quatrième étape : calculer la conclusion globale
Score global = pondération(fidélité, respect de l'instruction, qualité de l'image, utilisabilité)
Rapport qualité-prix = score global / coût par image
Les pondérations sont définies selon l'activité : les supports marketing privilégient la qualité, les outils temps réel privilégient la latence. Enfin, ne produisez pas seulement un champion, mais une conclusion du type « dans quelles conditions choisir A, dans quelles conditions choisir B », ce qui est bien plus utile qu'un classement.
Points d'attention pour migrer vers un nouveau modèle
Pour passer de votre pipeline image-to-image existant à gpt-image-2.6-flare/image-to-image, le risque principal ne réside pas dans le modèle lui-même, mais dans les jonctions. Avant la mise en production, il est recommandé de vérifier point par point :
Interface et couche applicative
- Forme d'appel : retour synchrone ou tâche asynchrone ? Si asynchrone, l'intervalle d'interrogation et le délai d'expiration doivent être ajustés en conséquence.
- Contraintes d'entrée : quelles sont les limites de format, de taille et de rapport d'aspect de l'image d'entrée ? En cas de dépassement, y a-t-il une erreur ou un recadrage automatique ? Le comportement diffère, et l'indication côté front-end aussi.
- Forme de sortie : binaire d'image, URL ou base64 ? Cela détermine directement si votre chaîne de stockage doit être modifiée.
- Mappage des paramètres : les paramètres d'intensité, de taille et d'échantillonnage de l'ancien pipeline ont-ils un équivalent dans la nouvelle interface ? Si non, comment les exprimer en dégradé ?
Résilience d'ingénierie
- Classification des erreurs : traiter séparément le refus de modération de contenu, les paramètres invalides, la limitation de débit et le délai d'expiration ; ne pas réessayer uniformément — réessayer sur une erreur de modération ne fait qu'empirer.
- Budget de tentatives : avec une facturation à l'image, chaque tentative génère un nouveau coût ; la stratégie de tentative doit fixer une limite et être enregistrée.
- Couche d'adaptation : regrouper les appels de modèles derrière une fine couche d'adaptation, pour éviter que le code métier ne contienne des noms de paramètres propres à un fournisseur.
- Déploiement progressif et retour arrière : brancher d'abord le nouveau modèle sur un faible trafic, conserver un interrupteur pour l'ancien modèle, puis augmenter progressivement après confirmation des indicateurs.
- Traçage comparatif : enregistrer pour chaque requête la version du modèle, la durée, le succès ou non, et le rejet éventuel par un humain ; c'est la base des décisions ultérieures.
La migration n'est pas un remplacement, mais un basculement réversible. Ce n'est que si vous pouvez revenir à l'ancien pipeline en un clic que vous oserez réellement augmenter le trafic.
Quand ne pas le choisir
À l'inverse, dans plusieurs types de scénarios, gpt-image-2.6-flare/image-to-image n'est pas le premier choix :
- Absence totale d'image d'entrée. Pour la génération purement créative et la composition à partir de zéro, la génération textuelle est plus directe ; forcer l'image-to-image ne fait qu'ajouter une étape de téléversement.
- Édition nécessitant une précision au pixel. Par exemple, ajuster précisément la mise en page du texte, modifier des chiffres, changer des blocs de couleur selon des coordonnées ; ces tâches sont plus fiables avec un traitement d'image déterministe ou un rendu par template, car les modèles génératifs comportent naturellement de l'incertitude.
- Interaction fortement temps réel à très faible latence. Si le produit exige une réponse en millisecondes (comme un aperçu de type filtre en temps réel), il faut d'abord effectuer un test de charge pour confirmer que la latence est atteignable ; sinon, il ne faut pas le mettre en production.
- Fonctionnalité gratuite extrêmement sensible au coût. La facturation à l'image est linéaire, mais le nombre d'images sur une fonctionnalité gratuite croît linéairement avec le nombre d'utilisateurs ; il faut d'abord clarifier le modèle économique unitaire avant de décider de l'ouvrir.
- Traitement par lots nécessitant une reproductibilité stricte. Lorsqu'une même entrée doit toujours produire le même résultat, les modèles génératifs ne peuvent généralement pas garantir une cohérence parfaite.
La méthode de décision est simple : si votre besoin peut être résolu de manière stable par « des règles + une bibliothèque de traitement d'image », n'introduisez pas de modèle ; si le cœur du problème réside précisément dans la compréhension sémantique et le redessin d'image, alors il est un candidat approprié.
Articles similaires
Voir tous les articles →-

Comparatif et évaluation
Liste de contrôle pour le choix de Gemini Omni 1.2 Flash : modes d'entrée, spécifications et budget
Vérifier les modes d'entrée, les spécifications, le budget et les limites d'effet, puis finaliser le choix avec vos propres échantillons
-
Comparatif et évaluation
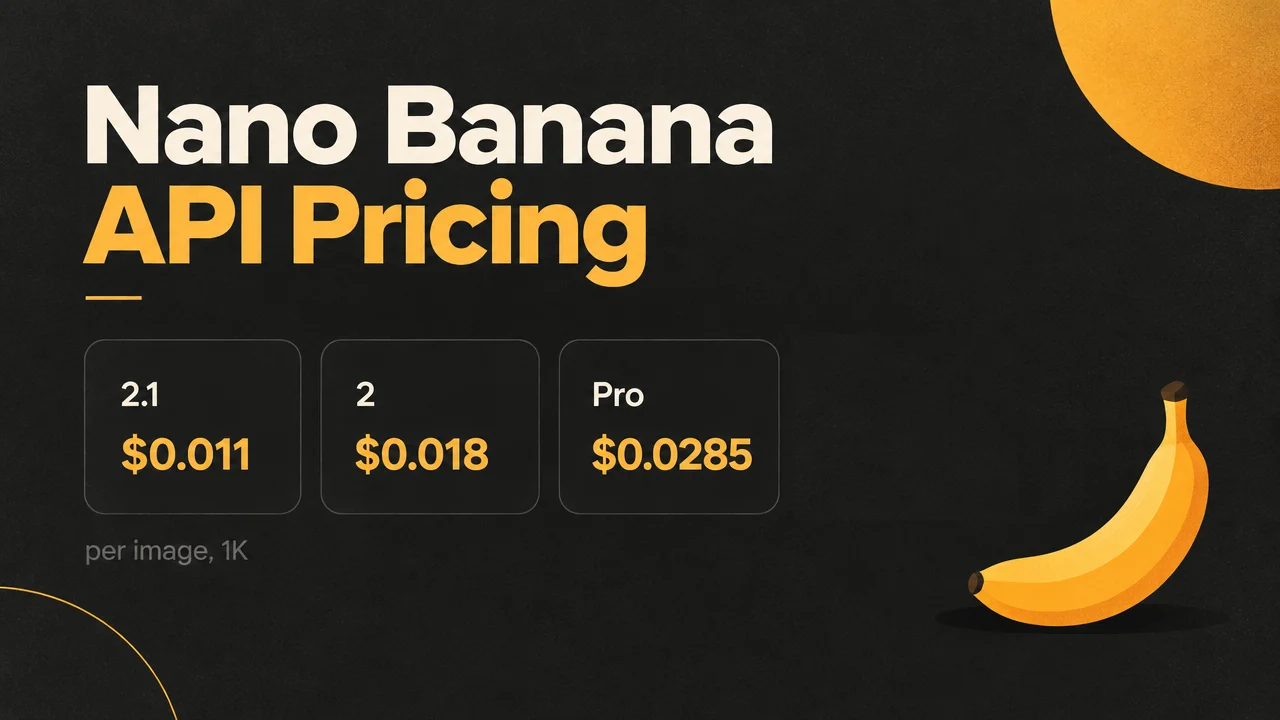
Nano Banana Black Friday : moins de 1 centime par image — comparaison de 2.1, 2 et Pro sur un même prompt
Prix normaux et prix Black Friday des trois versions 2.1, 2 et Pro, avec des images générées à partir du même prompt
-
Comparatif et évaluation
Prix des API de vidéo IA pour le Black Friday : jusqu'à environ 23 % d'économie par seconde avec Veo, Seedance et Kling
Prix à la seconde et à la vidéo de Veo 3.1, Seedance et Kling 3.0, et tarifs convertis pour le Black Friday