对比评测
gpt-image-2.6-flare/image-to-image 横向对比:图生图模型怎么选与迁移
本页内容
这个模型解决的是哪类问题
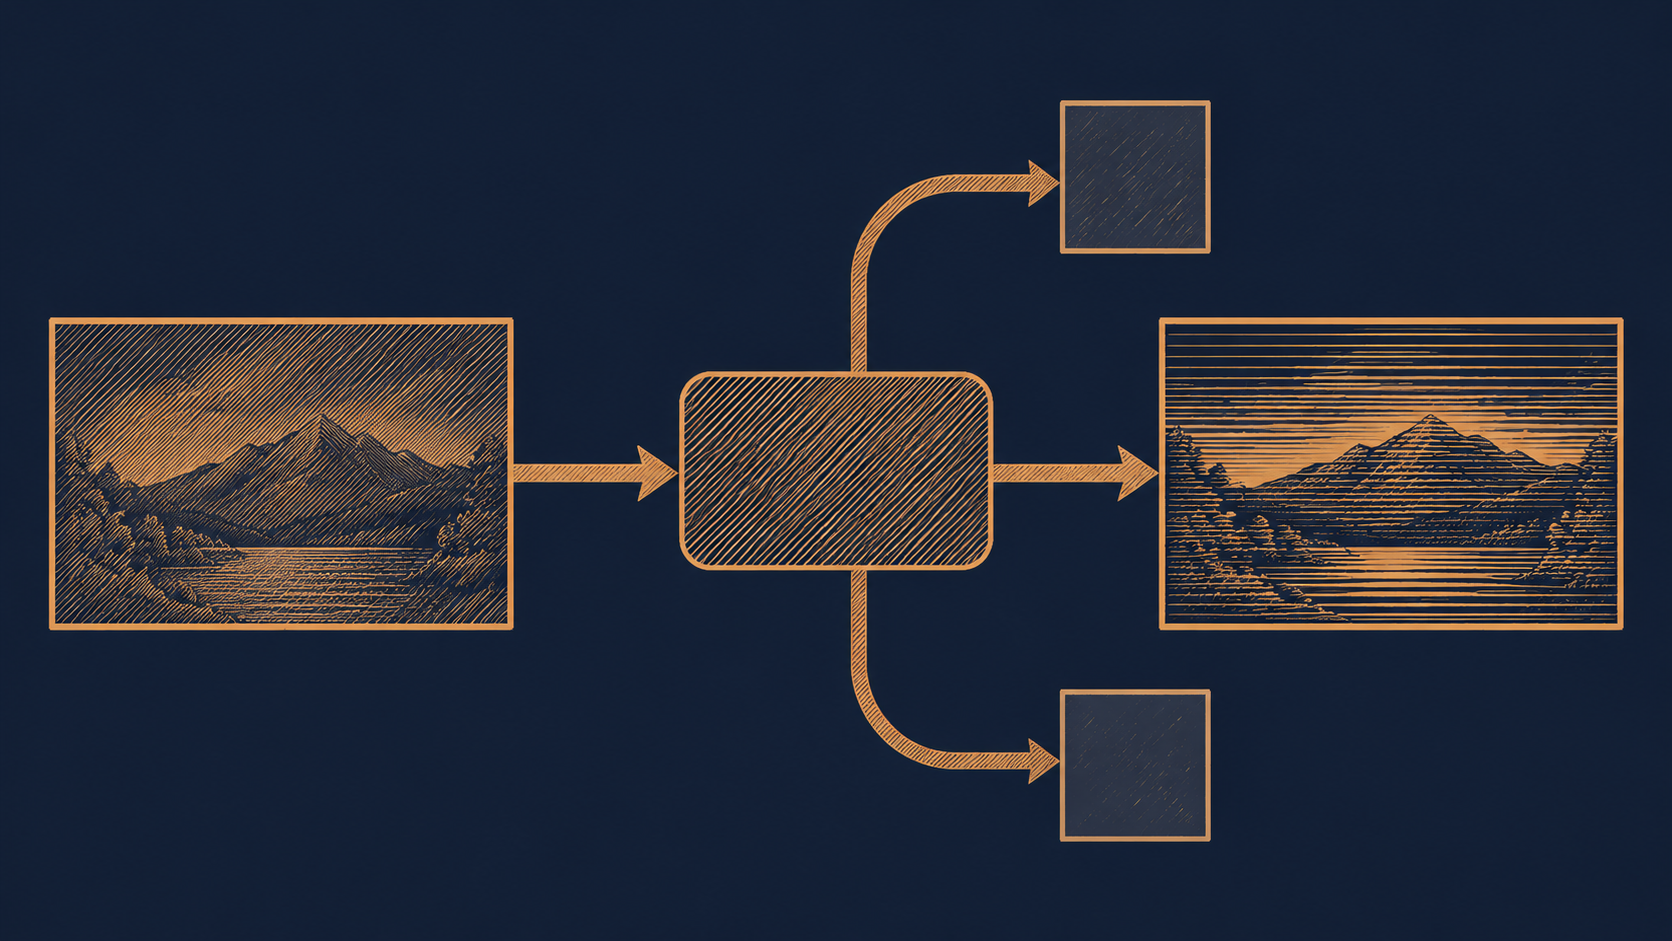
gpt-image-2.6-flare/image-to-image 是 OpenAI 提供的一个图生图模型,输出类型为图像。把名字拆开看,它回答的问题很具体:给定一张输入图,生成一张基于该图修改或重绘的结果图。
这类任务在工程上通常表现为以下几种形态:
- 局部编辑:保留主体与构图,只改指定区域(换背景、去物体、改材质)。
- 风格与色调重绘:输入照片,输出插画、线稿、特定视觉风格版本。
- 变体生成:同一输入图产出多个候选,供运营或设计做挑选。
- 参考图驱动:把参考图作为视觉锚点,约束新图的主体、配色或版式。
它和纯文生图的区别在于输入。文生图只有一段提示词,模型自由度很高,效果好坏高度依赖提示词运气;图生图多了一张输入图作为约束,输出与输入的一致性、可控性都更容易被工程手段管理——这也是为什么真实产品里做「改图」功能时,图生图通常是默认选择,而不是让用户反复重写提示词。
反过来说,如果你的需求只是「从零生成一张图」,没有参考图也没有需要保留的原始画面,那这个模型并不是最短路径。选型的第一步不是比较模型强弱,而是先确认你的输入里到底有没有那张图。
按张计费意味着什么
该模型的计费口径是按生成的图像张数,而不是按 token。这个差别直接影响你估算预算的方式。
按张 vs 按 token 的预估差异
按 token 计费时,单次成本取决于提示词长度、输出分辨率等因素,同一功能在不同输入下的花费会浮动,预算往往要留较大余量。按张计费则把单次调用成本固定下来,总成本近似等于:
总成本 ≈ 生成张数 × 单张成本
这条直线关系的好处是可倒推。你已知每次用户操作平均生成几张(比如一次「生成 4 个候选」就是 4 张),就能直接算出每个活跃用户、每个功能入口的边际成本,而不必先跑一轮采样才知道单次大概花多少。
怎么落到自己的量级上
建议按三步估算:
- 数清张数口径:一次请求返回一张还是多张?失败重试算不算额外张数?
- 估调用频次:日均真实请求量 × 平均每请求张数,得到日/月生成张数。
- 留出重试与灰度余量:把失败重试、A/B 实验、内部测试的量单独计入。
需要提醒的是,按张计费下分辨率或质量档位是否影响单价属于接口细节,不同模型口径不一,上线前应在价格面板与接口文档中确认,而不是默认「一张就是一张」。另外,图生图常伴随上传与存储成本,图片托管、CDN 流量这部分往往和推理费用同量级,别只算模型那一段。
横向对比该看哪些维度
图生图选型最常见的错误是「只比单价」。单张成本只是五分之一的信息量,下面这几个维度建议一起看。
1. 与输入的一致性
图生图的核心价值是「像原图」。要看模型在保持主体轮廓、人脸、文字、版式方面的稳定程度。一致性差的模型会给你一种「改完之后变成另一张图」的感觉,用户会立刻察觉。
2. 可控性
你能否通过参数和提示词精确指挥修改范围?局部编辑是否支持区域约束?风格迁移的强度是否可调?可控性弱的模型会让产品侧的交互设计无从下手——因为无法向用户承诺「你圈哪里就改哪里」。
3. 单张成本
即按张计费的单价。它是唯一可以写成直线的东西,但只对同类计费口径的模型有可比性;拿按张的价格去和按 token 的价格直接横比,结论通常是错的。
4. 延迟与吞吐
改图是强交互场景,用户点完按钮就在等。首字节时间、单张出图时间、以及高并发下是否排队,都会直接决定这个功能能不能做成实时预览。批量离线任务则更关心吞吐而非单张延迟。
5. 接口与参数形态
输入图怎么传(URL、base64、还是需要先上传)?输出怎么回(直接返回、还是返回任务 ID 轮询)?有没有 seed、尺寸、强度之类的旋钮?这些决定了接入工作量,也决定了迁移成本。
把上面五项做成一张对照打分表,给每个候选项打分而不是只写价格,你会发现候选之间的差距往往不在钱上。
如何做一次靠谱的小样本选型实验
不要凭感觉选模型。用一个半天就能跑完的小样本对照实验,结论比任何评测文章都可靠。
第一步:挑 8–15 张代表性输入
样本要覆盖你真实业务的分布,而不只是「好看的图」:
- 典型场景图(正常光照、标准构图)
- 困难样本(低分辨率、文字密集、多人合影)
- 边界样本(极端长宽比、非真实照片类素材)
每张图配一条固定的编辑指令,全部候选模型用完全相同的输入与指令。
第二步:定评分标准
提前写死评分项,避免事后找理由。推荐四项,各 1–5 分:
- 保真度:主体、结构、文字是否被正确保留
- 指令遵循:是否真的完成了指定的修改
- 画面质量:伪影、畸变、局部崩坏
- 可用性:这个结果能否直接交付给用户
第三步:盲评与记录
把输出文件名打乱顺序再打分,减少「知道是谁出的图」带来的偏见。记录表里至少包含:样本 ID、模型、四项分数、生成耗时、是否失败、单次成本。
第四步:算综合结论
综合分 = 加权(保真度, 指令遵循, 画面质量, 可用性)
性价比 = 综合分 / 单张成本
权重按业务定:营销物料重质量,实时工具重延迟。最后不要只输出一个冠军,而是给出「在什么条件下选 A、什么条件下选 B」的结论,这比排名有用得多。
迁移到新模型的注意事项
从现有图生图管线切到 gpt-image-2.6-flare/image-to-image,风险主要不在模型本身,而在衔接处。上线前建议逐项确认:
接口与应用层
- 调用形态:同步返回还是异步任务?如果是异步,轮询间隔与超时时间要同步调整。
- 输入约束:输入图的格式、大小、长宽比上限是多少?超限是报错还是自动裁剪,行为不同,前端提示也不同。
- 输出形态:返回的是图片二进制、URL 还是 base64?直接决定你的存储链路要不要改。
- 参数映射:老管线里的强度、尺寸、采样类参数,在新接口上有没有对应项,没有的话怎么降级表达。
工程韧性
- 错误分类:把内容审核拒绝、参数非法、限流、超时区分开处理,不要统一重试——审核类错误重试只会更糟。
- 重试预算:按张计费下每次重试都产生新成本,重试策略要设上限并记录。
- 适配层:把模型调用收敛到一个薄适配层后面,避免业务代码里散落着某家模型的参数名。
- 灰度与回退:新模型先接小流量,保留旧模型的开关,确认指标后再逐步放量。
- 对照埋点:记录每个请求的模型版本、耗时、是否成功、是否被人工否决,这是后续决策的依据。
迁移不是一次替换,而是一次可回退的切换。能一键退回旧管线,你才敢真正放量。
什么时候不该选它
反过来看,有几类场景里 gpt-image-2.6-flare/image-to-image 不是首选:
- 根本没有输入图。纯创意生成、从零构图的需求,用文生图更直接,硬套图生图只会多一道上传步骤。
- 要求像素级确定的编辑。比如精确调整文字排版、改数字、按坐标改色块,这类任务用确定性的图像处理或模板渲染更可靠,生成模型天然带有不确定性。
- 极低延迟的强实时交互。如果产品要求毫秒级响应(如实时滤镜式预览),需要先压测确认延迟是否可达,达不到就不该上。
- 对成本极度敏感的免费功能。按张计费虽然是直线,但免费功能上的张数会随用户量线性增长,需要先算清楚单位经济模型再决定要不要开放。
- 需要严格可复现的批处理。同一输入要求永远输出同一结果时,生成模型通常无法保证完全一致。
判断方法很简单:如果你的需求能被「规则 + 图像处理库」稳定解决,就别引入模型;如果核心难点正是语义理解与画面重绘,那它才是合适的候选。