
Vergleichstest
gpt-image-2.6-flare/image-to-image im Quervergleich: Wie man Bild-zu-Bild-Modelle auswählt und migriert
Auf dieser Seite
Welche Art von Problem dieses Modell löst
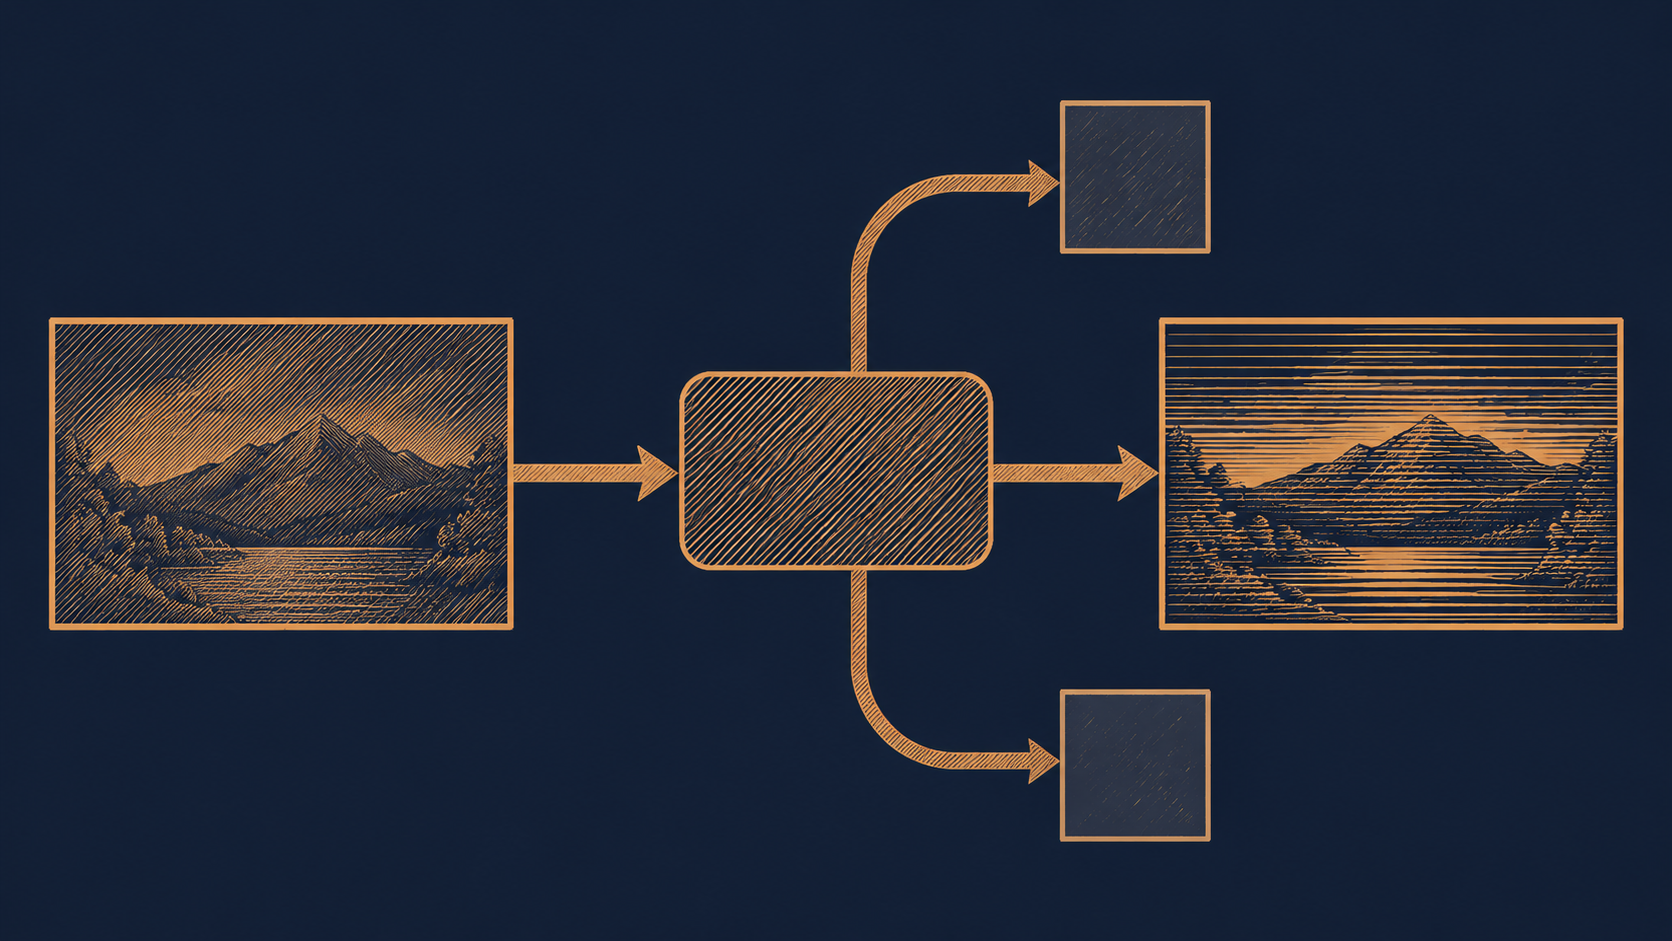
gpt-image-2.6-flare/image-to-image ist ein von OpenAI bereitgestelltes Bild-zu-Bild-Modell mit dem Ausgabetyp Bild. Zerlegt man den Namen, beantwortet es eine sehr konkrete Frage: Gegeben ein Eingabebild, erzeuge ein auf diesem Bild basierendes, modifiziertes oder neu gezeichnetes Ergebnisbild.
Technisch tritt diese Art von Aufgabe meist in folgenden Formen auf:
- Lokale Bearbeitung: Motiv und Komposition beibehalten, nur einen bestimmten Bereich ändern (Hintergrund austauschen, Objekte entfernen, Material ändern).
- Neuzeichnen von Stil und Farbton: Ein Foto als Eingabe, eine Illustration, Strichzeichnung oder eine bestimmte visuelle Stilversion als Ausgabe.
- Variantengenerierung: Aus demselben Eingabebild mehrere Kandidaten erzeugen, aus denen Betrieb oder Design auswählen.
- Referenzbildgetrieben: Ein Referenzbild als visuellen Anker verwenden, um Motiv, Farbgebung oder Layout des neuen Bildes einzuschränken.
Der Unterschied zur reinen Text-zu-Bild-Generierung liegt in der Eingabe. Text-zu-Bild hat nur einen Prompt, das Modell hat einen hohen Freiheitsgrad, und die Ergebnisqualität hängt stark vom Glück mit dem Prompt ab; Bild-zu-Bild hat zusätzlich ein Eingabebild als Einschränkung, sodass Konsistenz und Steuerbarkeit der Ausgabe gegenüber der Eingabe leichter mit technischen Mitteln verwaltet werden können – deshalb ist Bild-zu-Bild in echten Produkten bei „Bildbearbeitungs“-Funktionen meist die Standardwahl, statt Nutzer wiederholt Prompts umschreiben zu lassen.
Umgekehrt: Wenn Ihr Bedarf nur darin besteht, „von Grund auf ein Bild zu erzeugen“, ohne Referenzbild und ohne ein ursprüngliches Bild, das erhalten werden muss, dann ist dieses Modell nicht der kürzeste Weg. Der erste Schritt der Auswahl ist nicht der Vergleich der Modellstärke, sondern die Bestätigung, ob in Ihrer Eingabe überhaupt dieses Bild enthalten ist.
Was die Abrechnung pro Bild bedeutet
Die Abrechnungsgrundlage dieses Modells ist die Anzahl der generierten Bilder, nicht Tokens. Dieser Unterschied beeinflusst unmittelbar, wie Sie Ihr Budget schätzen.
Schätzungsunterschiede: pro Bild vs. pro Token
Bei Abrechnung pro Token hängen die Kosten pro Aufruf von Faktoren wie Prompt-Länge und Ausgaberesolution ab; dieselbe Funktion kostet bei unterschiedlichen Eingaben unterschiedlich viel, und das Budget muss oft einen größeren Puffer haben. Die Abrechnung pro Bild fixiert die Kosten eines Aufrufs; die Gesamtkosten liegen näherungsweise bei:
Gesamtkosten ≈ Anzahl generierter Bilder × Kosten pro Bild
Der Vorteil dieser linearen Beziehung ist die Rückrechenbarkeit. Wenn Sie wissen, wie viele Bilder eine durchschnittliche Nutzeraktion erzeugt (z. B. „4 Kandidaten generieren“ = 4 Bilder), können Sie die Grenzkosten pro aktivem Nutzer und pro Funktionseinstieg direkt berechnen, ohne erst eine Sampling-Runde laufen zu lassen, um zu wissen, was ein Aufruf ungefähr kostet.
Wie man es auf die eigene Größenordnung überträgt
Empfohlen ist eine Schätzung in drei Schritten:
- Bildzählung klären: Liefert eine Anfrage ein Bild oder mehrere? Zählen fehlgeschlagene Wiederholungen als zusätzliche Bilder?
- Aufrufhäufigkeit schätzen: Tägliche reale Anfragemenge × durchschnittliche Bilder pro Anfrage ergibt die tägliche/monatliche Bildmenge.
- Puffer für Wiederholungen und Gray Release lassen: Fehlgeschlagene Wiederholungen, A/B-Experimente und interne Tests separat einrechnen.
Zu beachten ist, dass bei Abrechnung pro Bild die Frage, ob Auflösung oder Qualitätsstufe den Stückpreis beeinflussen, ein Schnittstellendetail ist; verschiedene Modelle handhaben das unterschiedlich. Vor dem Livegang sollte dies im Preispaneel und in der API-Dokumentation bestätigt werden, statt standardmäßig „ein Bild ist ein Bild“ anzunehmen. Außerdem gehen Bild-zu-Bild-Aufgaben oft mit Upload- und Speicherkosten einher; Bild-Hosting und CDN-Traffic liegen häufig in derselben Größenordnung wie die Inferenzkosten – kalkulieren Sie nicht nur den Modellteil.
Welche Dimensionen ein Quervergleich betrachten sollte
Der häufigste Fehler bei der Auswahl von Bild-zu-Bild-Modellen ist „nur den Stückpreis vergleichen“. Die Kosten pro Bild sind nur ein Fünftel der Information; die folgenden Dimensionen sollten gemeinsam betrachtet werden.
1. Konsistenz mit der Eingabe
Der Kernwert von Bild-zu-Bild ist „wie das Original“. Zu prüfen ist, wie stabil das Modell Motivumrisse, Gesichter, Text und Layout beibehält. Modelle mit schlechter Konsistenz vermitteln das Gefühl, „nach der Bearbeitung ist es ein anderes Bild geworden“, was Nutzer sofort bemerken.
2. Steuerbarkeit
Können Sie den Änderungsumfang über Parameter und Prompts präzise steuern? Unterstützt die lokale Bearbeitung Bereichseinschränkungen? Ist die Stärke der Stilübertragung einstellbar? Modelle mit schwacher Steuerbarkeit machen es der Produktseite unmöglich, die Interaktion zu gestalten – weil man dem Nutzer nicht versprechen kann: „Was Sie einkreisen, wird genau dort geändert“.
3. Kosten pro Bild
Also der Stückpreis bei Abrechnung pro Bild. Er ist das Einzige, was sich als Gerade darstellen lässt, aber nur mit Modellen derselben Abrechnungslogik vergleichbar; einen Pro-Bild-Preis direkt gegen einen Pro-Token-Preis zu stellen, führt meist zu falschen Schlüssen.
4. Latenz und Durchsatz
Bildbearbeitung ist ein stark interaktiver Anwendungsfall; nach dem Klick wartet der Nutzer. Time-to-First-Byte, Zeit bis zum fertigen Bild und ob es unter hoher Last zu Warteschlangen kommt, entscheiden direkt darüber, ob die Funktion als Echtzeitvorschau machbar ist. Batch-Offline-Aufgaben interessieren sich eher für Durchsatz als für Einzelbildlatenz.
5. Schnittstelle und Parameterformen
Wie wird das Eingabebild übertragen (URL, base64 oder erst Upload nötig)? Wie kommt die Ausgabe zurück (direkt oder als Task-ID zum Polling)? Gibt es Stellschrauben wie seed, Größe, Stärke? Das bestimmt den Integrationsaufwand und auch die Migrationskosten.
Machen Sie aus den fünf Punkten eine Vergleichsbewertungstabelle und bewerten Sie jede Option, statt nur Preise einzutragen; Sie werden feststellen, dass die Unterschiede zwischen den Kandidaten oft nicht beim Geld liegen.
Wie man ein verlässliches Kleinstichproben-Auswahlexperiment durchführt
Wählen Sie Modelle nicht nach Gefühl. Ein Kleinstichproben-Vergleichsexperiment, das in einem halben Tag durchläuft, liefert verlässlichere Schlüsse als jeder Testbericht.
Schritt 1: 8–15 repräsentative Eingaben auswählen
Die Stichprobe sollte die Verteilung Ihres echten Geschäfts abdecken, nicht nur „schöne Bilder“:
- Typische Szenenbilder (normale Beleuchtung, Standardkomposition)
- Schwierige Beispiele (niedrige Auflösung, textreich, Gruppenfotos)
- Grenzfälle (extreme Seitenverhältnisse, nicht-fotografisches Material)
Geben Sie jedem Bild eine feste Bearbeitungsanweisung, und verwenden Sie für alle Kandidatenmodelle exakt dieselben Eingaben und Anweisungen.
Schritt 2: Bewertungskriterien festlegen
Legen Sie die Bewertungskriterien im Voraus schriftlich fest, um nachträgliche Rechtfertigungen zu vermeiden. Empfohlen sind vier Kriterien mit je 1–5 Punkten:
- Treue: Werden Motiv, Struktur und Text korrekt erhalten
- Anweisungsbefolgung: Wurde die vorgegebene Änderung tatsächlich umgesetzt
- Bildqualität: Artefakte, Verzerrungen, lokale Fehler
- Verwendbarkeit: Kann das Ergebnis direkt an den Nutzer ausgeliefert werden
Schritt 3: Blindbewertung und Protokollierung
Mischen Sie die Dateinamen der Ausgaben vor der Bewertung, um Verzerrungen durch „Wissen, von wem das Bild stammt“ zu verringern. Die Protokolltabelle sollte mindestens enthalten: Stichproben-ID, Modell, vier Punktzahlen, Generierungsdauer, Fehlschlag ja/nein, Einzelkosten.
Schritt 4: Gesamtschluss berechnen
Gesamtpunktzahl = gewichtet(Treue, Anweisungsbefolgung, Bildqualität, Verwendbarkeit)
Preis-Leistung = Gesamtpunktzahl / Kosten pro Bild
Die Gewichtung richtet sich nach dem Geschäft: Marketingmaterial legt Wert auf Qualität, Echtzeit-Tools auf Latenz. Geben Sie am Ende nicht nur einen Sieger aus, sondern ein Fazit der Form „unter welchen Bedingungen A, unter welchen B gewählt wird“ – das ist deutlich nützlicher als ein Ranking.
Hinweise bei der Migration auf ein neues Modell
Beim Wechsel von einer bestehenden Bild-zu-Bild-Pipeline auf gpt-image-2.6-flare/image-to-image liegt das Risiko weniger im Modell selbst als an den Schnittstellen. Vor dem Livegang sollten Sie Punkt für Punkt prüfen:
Schnittstelle und Anwendungsschicht
- Aufrufform: Synchrone Rückgabe oder asynchrone Aufgabe? Bei asynchron müssen Polling-Intervall und Timeout entsprechend angepasst werden.
- Eingabebeschränkungen: Welche Obergrenzen gelten für Format, Größe und Seitenverhältnis des Eingabebildes? Führt Überschreitung zu einem Fehler oder zu automatischem Zuschneiden? Das Verhalten unterscheidet sich, und damit auch der Frontend-Hinweis.
- Ausgabeform: Kommt das Bild als Binärdaten, URL oder base64 zurück? Das entscheidet direkt, ob Ihre Speicherkette geändert werden muss.
- Parameterabbildung: Gibt es für Stärke-, Größen- und Sampling-Parameter der alten Pipeline entsprechende Felder in der neuen Schnittstelle? Wenn nicht, wie drückt man sie ersatzweise aus?
Engineering-Robustheit
- Fehlerklassifizierung: Ablehnung durch Inhaltsprüfung, ungültige Parameter, Ratenbegrenzung und Timeout getrennt behandeln; nicht alles einheitlich wiederholen – bei Prüfungsfehlern macht Wiederholen es nur schlimmer.
- Wiederholungsbudget: Bei Abrechnung pro Bild erzeugt jede Wiederholung neue Kosten; die Wiederholungsstrategie braucht eine Obergrenze und Protokollierung.
- Adapterschicht: Modellaufrufe hinter einer dünnen Adapterschicht bündeln, damit im Geschäftscode nicht die Parameternamen eines bestimmten Anbieters verstreut sind.
- Gray Release und Rückfall: Neues Modell zuerst mit kleinem Traffic bedienen, Schalter für das alte Modell behalten, erst nach Bestätigung der Kennzahlen schrittweise ausweiten.
- Vergleichs-Tracking: Modellversion, Dauer, Erfolg und ob eine manuelle Ablehnung erfolgte pro Anfrage protokollieren – das ist die Grundlage für spätere Entscheidungen.
Migration ist kein einmaliger Austausch, sondern ein umschaltbarer Wechsel. Erst wenn Sie mit einem Klick zur alten Pipeline zurückkehren können, trauen Sie sich, wirklich auszuweiten.
Wann man es nicht wählen sollte
Umgekehrt gibt es einige Szenarien, in denen gpt-image-2.6-flare/image-to-image nicht die erste Wahl ist:
- Es gibt überhaupt kein Eingabebild. Für reine kreative Generierung und Komposition von Grund auf ist Text-zu-Bild direkter; Bild-zu-Bild aufzuzwingen fügt nur einen zusätzlichen Upload-Schritt hinzu.
- Pixelgenau deterministische Bearbeitung gefordert. Etwa präzise Anpassung des Textlayouts, Ändern von Zahlen, Ändern von Farbflächen nach Koordinaten – solche Aufgaben sind mit deterministischer Bildverarbeitung oder Template-Rendering zuverlässiger; generative Modelle bringen naturgemäß Unsicherheit mit.
- Stark echtzeitnahe Interaktion mit extrem niedriger Latenz. Wenn das Produkt eine Reaktion im Millisekundenbereich verlangt (z. B. Echtzeit-Filtervorschau), muss zuerst per Lasttest geklärt werden, ob die Latenz erreichbar ist; wenn nicht, sollte man es nicht einführen.
- Kostenextrem sensible kostenlose Funktionen. Die Abrechnung pro Bild ist zwar linear, aber bei kostenlosen Funktionen wächst die Bildzahl linear mit der Nutzerzahl; zuerst das Unit-Economics-Modell klären, bevor man entscheidet, ob man es öffnet.
- Streng reproduzierbare Batch-Verarbeitung erforderlich. Wenn dieselbe Eingabe immer dasselbe Ergebnis liefern muss, können generative Modelle in der Regel keine vollständige Gleichheit garantieren.
Die Entscheidungsmethode ist einfach: Lässt sich Ihr Bedarf stabil durch „Regeln + Bildverarbeitungsbibliotheken“ lösen, führen Sie kein Modell ein; liegt der Kern der Schwierigkeit genau im semantischen Verständnis und der Neuzeichnung des Bildes, dann ist es ein geeigneter Kandidat.
Ähnliche Artikel
Alle Artikel ansehen →-

Vergleichstest
Gemini Omni 1.2 Flash Auswahl-Checkliste: Eingabemodi, Spezifikationen und Budget
Eingabemodi, Spezifikationen, Budget und Effektgrenzen prüfen und die Auswahl mit eigenen Stichproben abnehmen
-
Vergleichstest
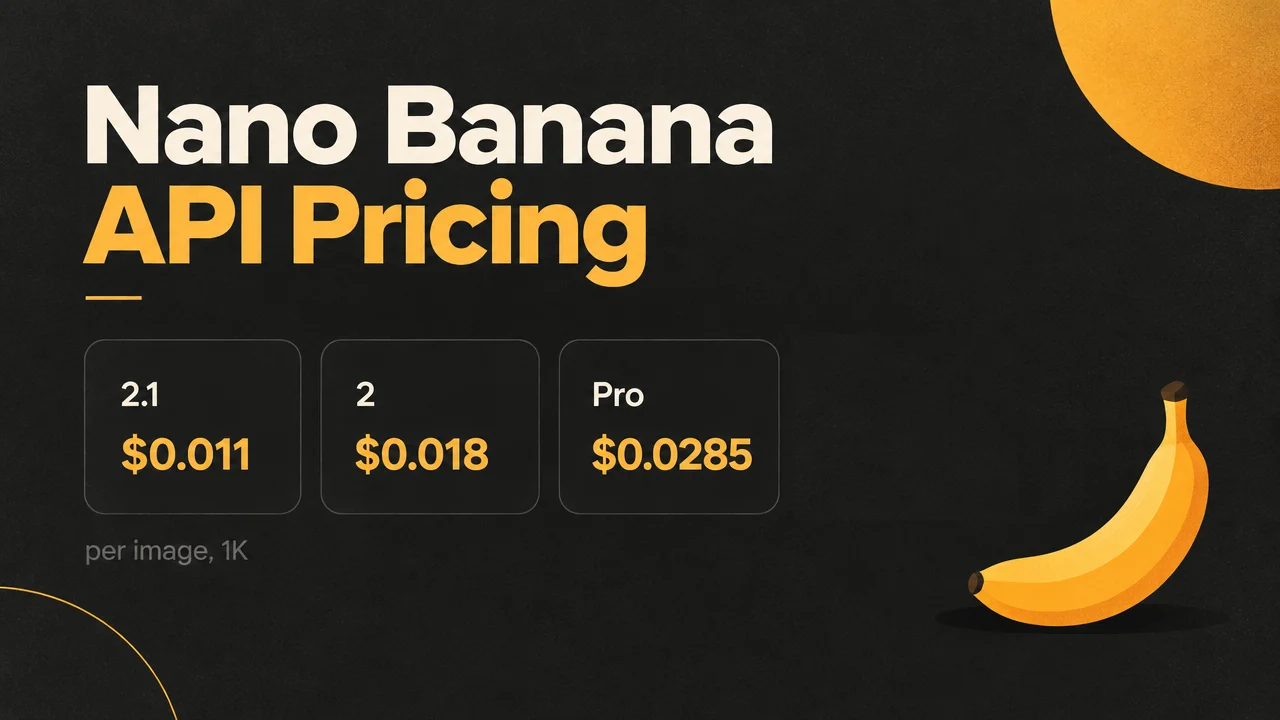
Nano Banana Black Friday: unter 1 Cent pro Bild – Vergleich von 2.1, 2 und Pro mit demselben Prompt
Reguläre Preise und Black-Friday-Preise der drei Versionen 2.1, 2 und Pro, Bildvergleich mit demselben Prompt
-
Vergleichstest
Black Friday AI-Video-API-Preise: Bei Veo, Seedance und Kling bis zu ca. 23 % pro Sekunde sparen
Veo 3.1, Seedance und Kling 3.0: Preise pro Sekunde, pro Clip und Black-Friday-Umrechnungspreis