
比較レビュー
gpt-image-2.6-flare/image-to-image 横断比較:画像生成モデルの選び方と移行
このページの内容
このモデルが解決するのはどのような課題か
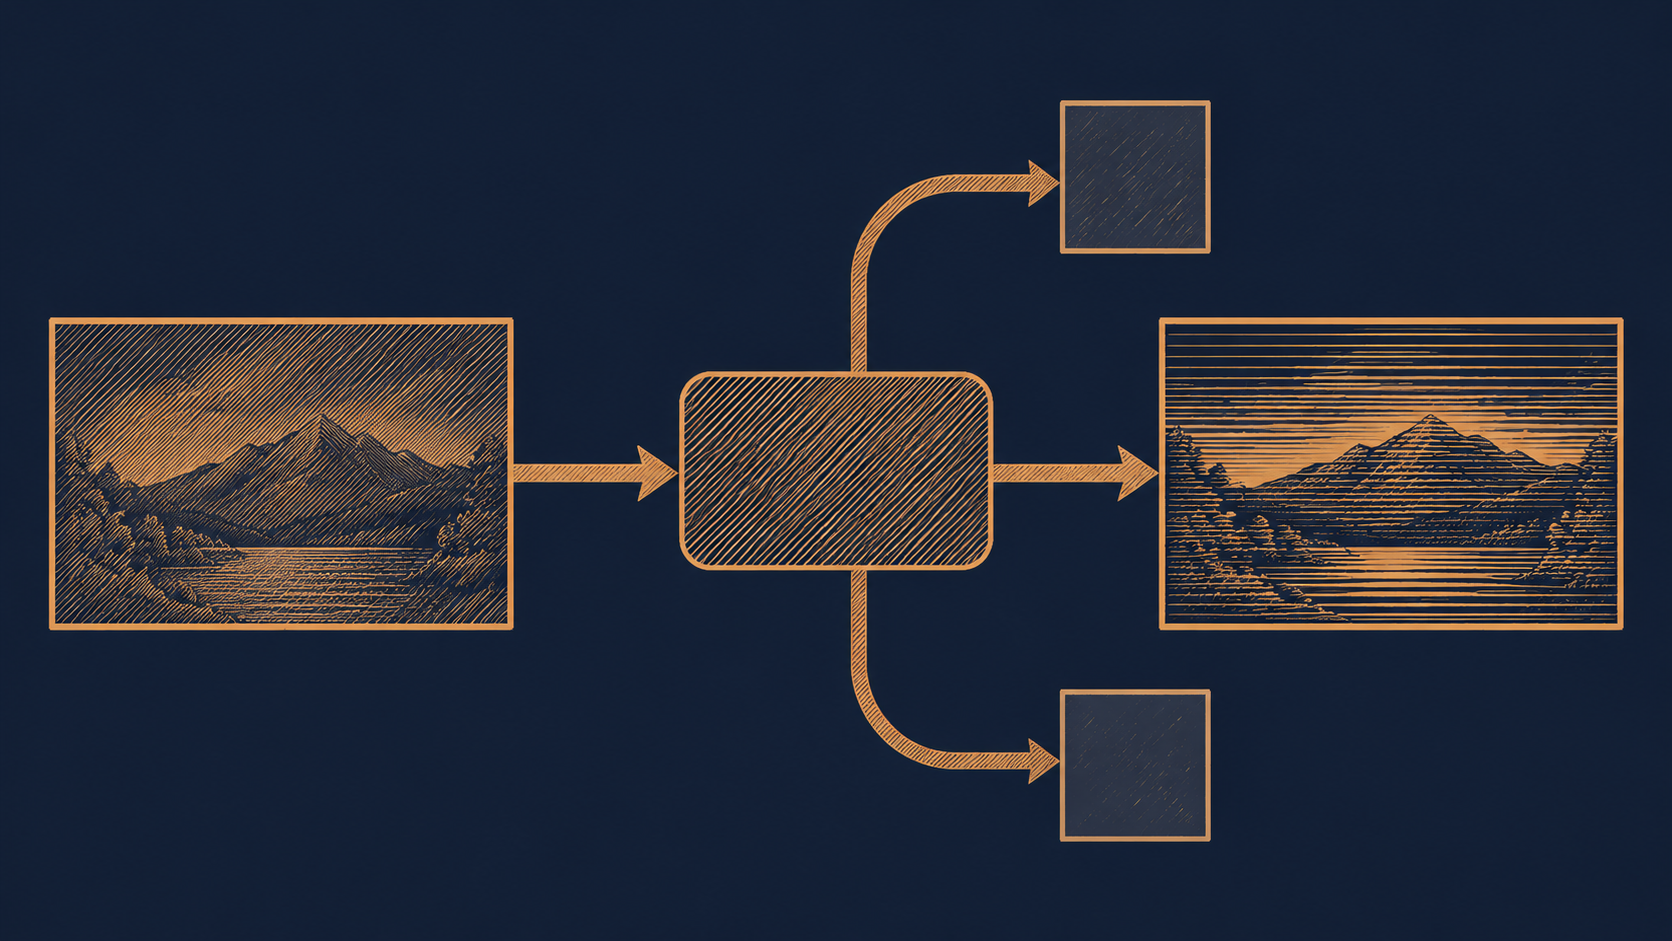
gpt-image-2.6-flare/image-to-image は OpenAI が提供する画像生成モデルで、出力タイプは画像です。名前を分解して見ると、答える問いは非常に具体的です。入力画像が与えられたとき、その画像を基に修正または再描画した結果画像を生成するということです。
この種のタスクは、エンジニアリング上では通常次のようないくつかの形態として現れます:
- 局部編集:被写体と構図を保ち、指定した領域だけを変更する(背景の差し替え、物体の削除、質感の変更)。
- スタイルと色調の再描画:写真を入力し、イラスト、線画、特定のビジュアルスタイルのバージョンを出力する。
- バリエーション生成:同じ入力画像から複数の候補を生成し、運用やデザインが選べるようにする。
- 参照画像駆動:参照画像を視覚的なアンカーとして、新しい画像の被写体、配色、レイアウトを制約する。
純粋なテキストからの画像生成との違いは入力にあります。テキストからの画像生成はプロンプトが 1 つだけであり、モデルの自由度が非常に高く、出来栄えはプロンプトの運に大きく依存します。画像生成は入力画像が 1 枚追加され制約として働くため、出力と入力の一貫性や制御性をエンジニアリングの手段で管理しやすくなります。これが、実際のプロダクトで「画像編集」機能を作る際に、ユーザーにプロンプトを何度も書き直させるのではなく、画像生成が通常デフォルトの選択となる理由です。
逆に言えば、あなたのニーズが「ゼロから 1 枚の画像を生成する」だけで、参照画像も保持すべき元の画面もないのであれば、このモデルは最短経路ではありません。選定の第一歩はモデルの優劣を比較することではなく、あなたの入力にその画像がそもそも存在するかを確認することです。
従量課金(1 枚単位)が意味するもの
このモデルの課金基準は生成した画像の枚数であり、トークンではありません。この違いは予算の見積もり方に直接影響します。
枚数課金 vs トークン課金の見積もり差異
トークン課金の場合、1 回のコストはプロンプトの長さや出力解像度などの要因に依存し、同じ機能でも入力によって費用が変動するため、予算には大きな余裕を見ておく必要があります。枚数課金では 1 回の呼び出しコストが固定され、総コストはおおよそ次のようになります:
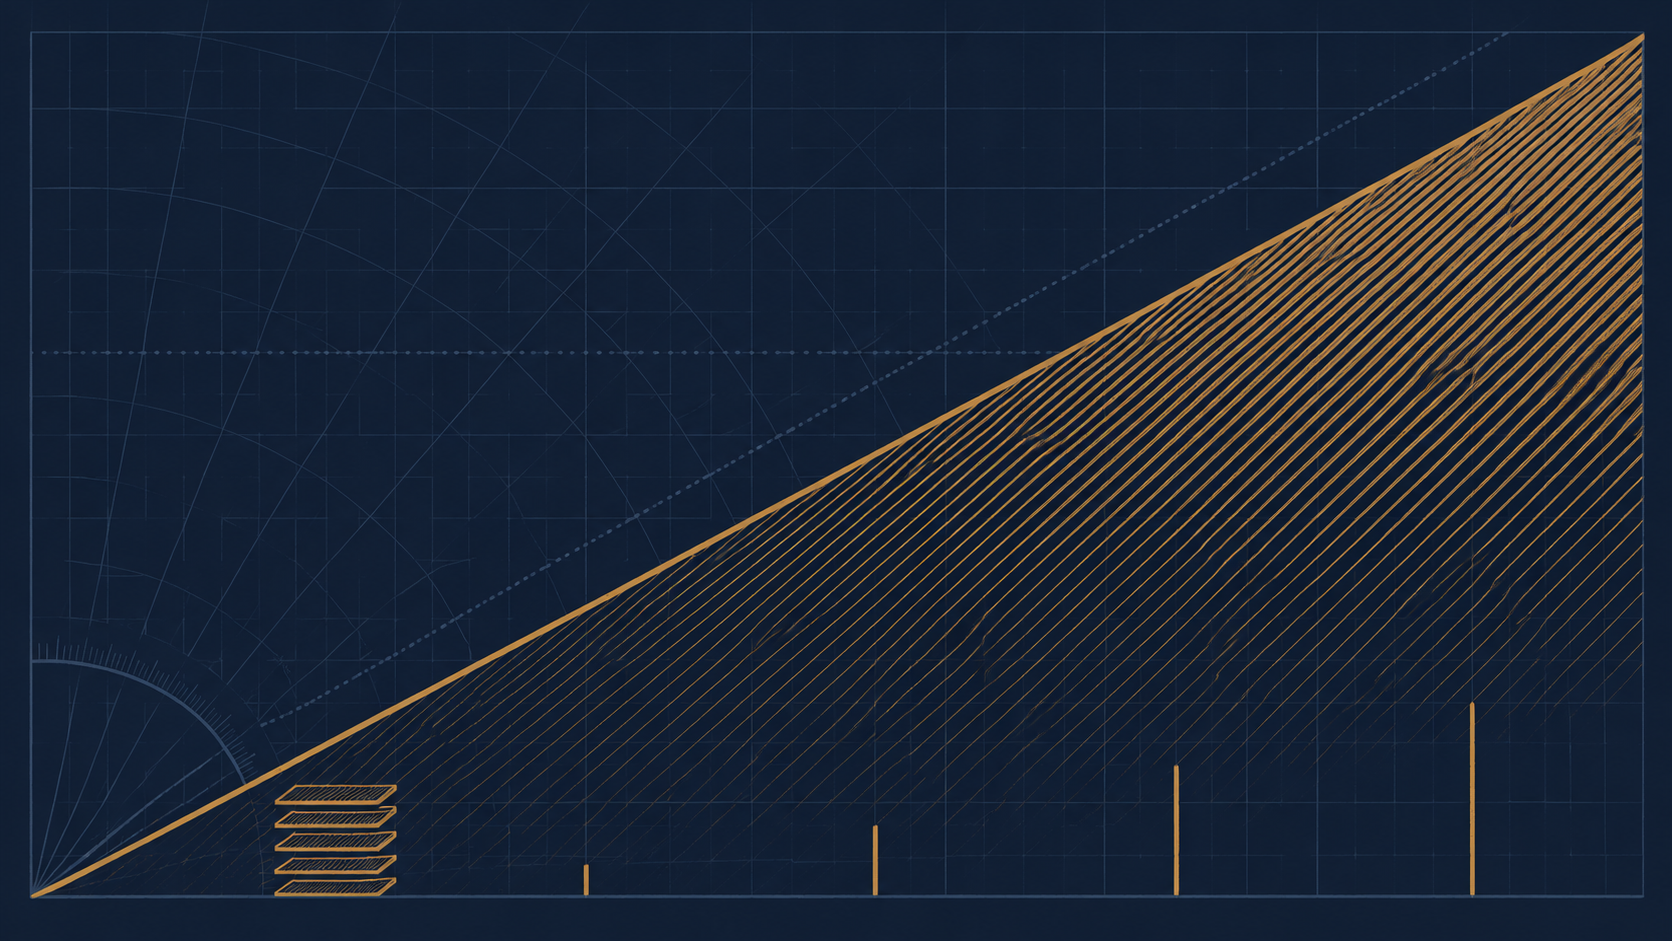
総コスト ≈ 生成枚数 × 1枚あたりのコスト
この直線関係の利点は逆算できることです。ユーザー操作 1 回あたり平均何枚生成するか(例えば「候補を 4 つ生成」なら 4 枚)が分かっていれば、アクティブユーザーごと、機能入口ごとの限界コストを直接算出でき、まずサンプリングを回して 1 回あたりのおおよその費用を知る必要はありません。
自分の規模に落とし込む方法
3 ステップでの見積もりを推奨します:
- 枚数の基準を明確にする:1 リクエストで 1 枚返るのか複数枚か?失敗時の再試行は追加枚数に数えるか?
- 呼び出し頻度を見積もる:1 日あたりの実リクエスト量 × リクエストあたりの平均枚数で、日次・月次の生成枚数を得る。
- 再試行と段階リリースの余裕を確保する:失敗時の再試行、A/B 実験、内部テストの量を別途計上する。
注意すべきは、枚数課金において解像度や品質グレードが単価に影響するかはインターフェースの詳細であり、モデルによって基準が異なるため、ローンチ前に価格パネルと API ドキュメントで確認すべきで、「1 枚は 1 枚」とデフォルトで決めつけてはいけません。また、画像生成はアップロードやストレージのコストを伴うことが多く、画像ホスティングや CDN トラフィックの部分は推論費用と同程度になることが多いため、モデル部分だけを計算してはいけません。
横断比較で見るべき軸
画像生成の選定で最もよくある誤りは「単価だけを比較する」ことです。1 枚あたりのコストは情報量の 5 分の 1 に過ぎません。以下の軸を併せて見ることを推奨します。
1. 入力との一貫性
画像生成の核心的価値は「元画像に似ている」ことです。被写体の輪郭、顔、文字、レイアウトを保持する安定性を見る必要があります。一貫性の低いモデルは「編集後に別の画像になった」という感覚を与え、ユーザーはすぐに気づきます。
2. 制御性
パラメータとプロンプトで修正範囲を正確に指示できるか?局部編集は領域制約をサポートするか?スタイル転送の強度は調整可能か?制御性の弱いモデルはプロダクト側のインタラクション設計を困難にします。なぜなら「囲んだところだけが変わる」とユーザーに約束できないからです。
3. 1 枚あたりのコスト
つまり枚数課金の単価です。これは直線として書ける唯一のものですが、同じ課金基準のモデルとのみ比較可能です。枚数課金の価格をトークン課金の価格と直接横比較すると、結論は通常誤ります。
4. レイテンシとスループット
画像編集は強いインタラクションが求められる場面で、ユーザーはボタンを押した後待っています。初回バイト時間、1 枚あたりの生成時間、高負荷時にキューが発生するかどうかは、この機能をリアルタイムプレビューとして実現できるかに直結します。バッチのオフラインタスクでは、1 枚あたりのレイテンシよりもスループットが重要です。
5. インターフェースとパラメータの形態
入力画像の渡し方(URL、base64、それとも事前アップロードが必要か)?出力の返し方(直接返すか、タスク ID を返してポーリングするか)?seed、サイズ、強度などの調整項目はあるか?これらは接続作業量を決め、移行コストも決めます。
上記 5 項目を 1 枚の対照スコア表にし、価格だけを書くのではなく各候補を採点すると、候補間の差は多くの場合お金の部分ではないことに気づくでしょう。
信頼できる小規模サンプル選定実験のやり方
感覚でモデルを選んではいけません。半日で完了できる小規模サンプルの対照実験で得られる結論は、どんな評価記事よりも信頼できます。
ステップ 1:代表的な入力画像を 8~15 枚選ぶ
サンプルは「見栄えの良い画像」だけでなく、実際の業務の分布をカバーする必要があります:
- 典型的なシーン画像(通常の照明、標準的な構図)
- 困難なサンプル(低解像度、文字が多い、複数人の集合写真)
- 境界的なサンプル(極端なアスペクト比、実写ではない素材)
各画像に固定の編集指示を 1 つ用意し、すべての候補モデルに完全に同じ入力と指示を使います。
ステップ 2:評価基準を決める
評価項目を事前に書き切っておき、後から理由を探すことを避けます。4 項目を推奨し、各 1~5 点:
- 忠実度:被写体、構造、文字が正しく保持されているか
- 指示追従:指定された修正が本当に完了しているか
- 画質:アーティファクト、歪み、局所的な崩れ
- 実用性:この結果をユーザーに直接納品できるか
ステップ 3:ブラインド評価と記録
出力ファイル名の順序をシャッフルしてから採点し、「どのモデルの出力か知っている」ことによる偏りを減らします。記録表には少なくとも以下を含めます:サンプル ID、モデル、4 項目のスコア、生成所要時間、失敗の有無、1 回あたりのコスト。
ステップ 4:総合的な結論を算出する
総合スコア = 重み付き(忠実度, 指示追従, 画質, 実用性)
コストパフォーマンス = 総合スコア / 1枚あたりのコスト
重みは業務に応じて決めます。マーケティング素材は品質重視、リアルタイムツールはレイテンシ重視です。最後に王者を 1 つだけ出力するのではなく、「どのような条件で A を選び、どのような条件で B を選ぶか」という結論を出す方がはるかに有用です。
新しいモデルへの移行時の注意点
既存の画像生成パイプラインから gpt-image-2.6-flare/image-to-image に切り替える際、リスクは主にモデル自体ではなく、接続部分にあります。ローンチ前に項目ごとに確認することを推奨します:
インターフェースとアプリケーション層
- 呼び出し形態:同期返却か非同期タスクか?非同期の場合、ポーリング間隔とタイムアウトを合わせて調整する必要があります。
- 入力制約:入力画像の形式、サイズ、アスペクト比の上限は?上限超過時はエラーか自動トリミングか。挙動が異なればフロントエンドの表示も変わります。
- 出力形態:返却されるのは画像バイナリ、URL、base64 のどれか?ストレージ経路を変更する必要があるかに直結します。
- パラメータマッピング:旧パイプラインの強度、サイズ、サンプリング系パラメータに新しいインターフェースで対応する項目はあるか。ない場合、どのように代替表現するか。
エンジニアリングの堅牢性
- エラー分類:コンテンツ審査拒否、不正パラメータ、レート制限、タイムアウトを区別して処理し、一律に再試行しないこと。審査系のエラーは再試行すると悪化するだけです。
- 再試行予算:枚数課金では再試行のたびに新しいコストが発生するため、再試行戦略には上限を設けて記録します。
- アダプタ層:モデル呼び出しを薄いアダプタ層の背後に集約し、業務コードに特定ベンダーのパラメータ名が散在するのを避けます。
- 段階リリースとロールバック:新しいモデルはまず小流量で接続し、旧モデルのスイッチを残し、指標を確認してから段階的に流量を増やします。
- 対照イベントトラッキング:各リクエストのモデルバージョン、所要時間、成功可否、人による却下の有無を記録します。これが後の意思決定の根拠となります。
移行は一度きりの置き換えではなく、ロールバック可能な切り替えです。ワンクリックで旧パイプラインに戻せてこそ、本当に流量を増やせます。
選ぶべきでないケース
逆に、いくつかの場面では gpt-image-2.6-flare/image-to-image は第一選択ではありません:
- 入力画像がそもそもない。純粋なクリエイティブ生成、ゼロからの構図が必要なニーズでは、テキストからの画像生成の方が直接的で、無理に画像生成を適用するとアップロード手順が 1 つ増えるだけです。
- ピクセル単位で確定した編集が求められる。例えば文字レイアウトの正確な調整、数字の変更、座標による色ブロックの変更など、こうしたタスクは決定論的な画像処理やテンプレートレンダリングの方が信頼性が高く、生成モデルは本質的に不確実性を伴います。
- 極めて低遅延の強リアルタイムインタラクション。ミリ秒単位の応答(リアルタイムフィルターのようなプレビューなど)が求められる場合、まず負荷テストで遅延が達成可能か確認する必要があり、達成できなければ導入すべきではありません。
- コストに極度に敏感な無料機能。枚数課金は直線的ですが、無料機能の枚数はユーザー数に比例して線形に増加するため、単位経済モデルを先に明確にしてから開放するか決める必要があります。
- 厳密な再現性が求められるバッチ処理。同じ入力に対して常に同じ出力が要求される場合、生成モデルは通常完全な一致を保証できません。
判断方法は簡単です。あなたのニーズが「ルール + 画像処理ライブラリ」で安定して解決できるならモデルを導入すべきではありません。核心的な難点がまさに意味理解と画面の再描画にあるなら、それが適切な候補となります。
関連記事
すべての記事を見る →-

比較レビュー
Gemini Omni 1.2 Flash 選定チェックリスト:入力モード、仕様、予算
入力モード、仕様、予算、効果の境界を確認し、自社サンプルで選定検収を完了する
-
比較レビュー
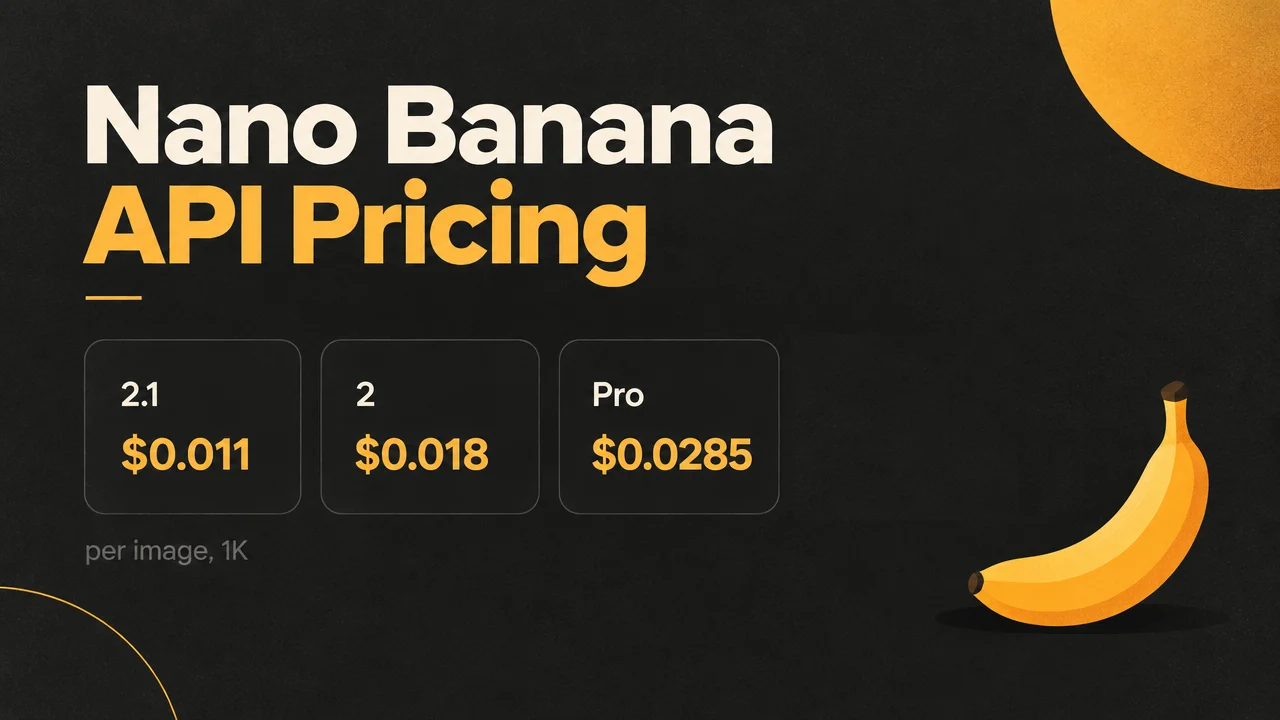
Nano Banana ブラックフライデーで1枚1セント未満:2.1、2、Proを同一プロンプトで比較
2.1、2、Pro の3バージョンの通常価格とブラックフライデー価格、同一プロンプトによる出力比較
-
比較レビュー
ブラックフライデー AI 動画 API 価格:Veo、Seedance、Kling は 1 秒あたり最大約 23% 節約
Veo 3.1、Seedance、Kling 3.0 の 1 秒あたり価格、1 本あたり価格、ブラックフライデー換算価格