
Confronto e valutazione
gpt-image-2.6-flare/image-to-image confronto trasversale: come scegliere un modello image-to-image e come migrare
In questa pagina
Quale tipo di problema risolve questo modello
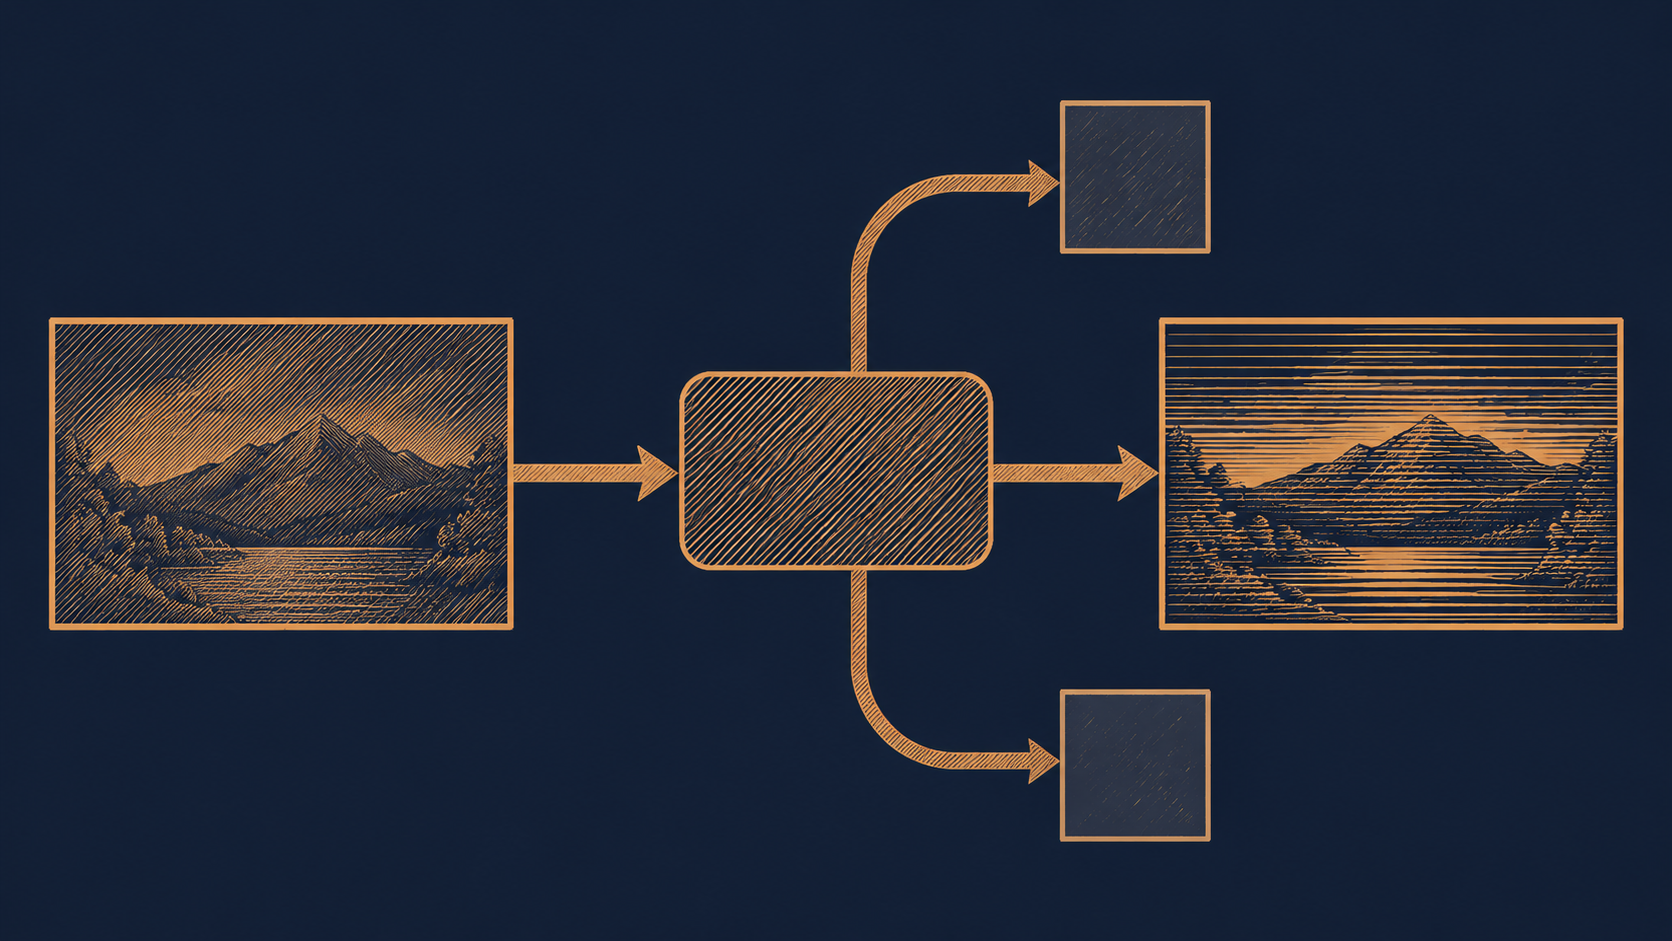
gpt-image-2.6-flare/image-to-image è un modello image-to-image fornito da OpenAI, con tipo di output immagine. Scomponendo il nome, la domanda a cui risponde è molto specifica: data un'immagine di input, generare un'immagine risultante basata su di essa, modificata o ridisegnata.
In ambito ingegneristico questo tipo di attività si presenta tipicamente nelle seguenti forme:
- Modifica locale: mantenere soggetto e composizione, modificare solo l'area specificata (cambiare sfondo, rimuovere oggetti, cambiare materiale).
- Ridisegno di stile e tonalità: input una foto, output un'illustrazione, un disegno al tratto, una versione con stile visivo specifico.
- Generazione di varianti: produrre più candidati dalla stessa immagine di input, per la selezione da parte di operations o design.
- Guidato da immagine di riferimento: usare l'immagine di riferimento come ancora visiva, vincolando soggetto, palette o impaginazione della nuova immagine.
La differenza rispetto al text-to-image puro sta nell'input. Il text-to-image ha solo un prompt, il modello ha un alto grado di libertà e la qualità dipende fortemente dalla fortuna del prompt; l'image-to-image ha un'immagine di input in più come vincolo, e la coerenza e controllabilità tra output e input sono più facilmente gestibili con mezzi ingegneristici — è anche per questo che nei prodotti reali, quando si implementa la funzione di "modifica immagine", l'image-to-image è di solito la scelta predefinita, invece di far riscrivere ripetutamente il prompt all'utente.
Viceversa, se la tua esigenza è solo "generare un'immagine da zero", senza immagine di riferimento né scena originale da preservare, allora questo modello non è il percorso più breve. Il primo passo della selezione non è confrontare la forza dei modelli, ma confermare se nella tua input c'è effettivamente quell'immagine.
Cosa significa la fatturazione a immagine
Il criterio di fatturazione di questo modello è per numero di immagini generate, non per token. Questa differenza influisce direttamente sul modo in cui stimi il budget.
Differenza di stima tra a immagine e a token
Con la fatturazione a token, il costo singolo dipende da fattori come la lunghezza del prompt e la risoluzione di output; la spesa per la stessa funzione varia con input diversi, e il budget spesso richiede un margine ampio. La fatturazione a immagine fissa il costo della singola chiamata, e il costo totale è approssimativamente pari a:
costo totale ≈ numero di immagini generate × costo per immagine
Il vantaggio di questa relazione lineare è che è invertibile. Se sai quante immagini genera in media ogni operazione utente (ad esempio "genera 4 candidati" significa 4 immagini), puoi calcolare direttamente il costo marginale per utente attivo e per punto di accesso alla funzione, senza dover prima eseguire un ciclo di campionamento per sapere quanto costa approssimativamente una singola chiamata.
Come applicarlo alla propria scala
Si consiglia una stima in tre passaggi:
- Chiarire il conteggio delle immagini: una richiesta restituisce una o più immagini? I tentativi falliti contano come immagini aggiuntive?
- Stimare la frequenza delle chiamate: volume medio giornaliero di richieste reali × numero medio di immagini per richiesta, per ottenere il numero di immagini generate al giorno/mese.
- Lasciare margine per retry e rollout graduale: conteggiare separatamente i volumi di retry falliti, esperimenti A/B e test interni.
Da notare che, con la fatturazione a immagine, se risoluzione o livello di qualità influenzano il prezzo unitario è un dettaglio dell'interfaccia; i criteri variano tra modelli, quindi prima del lancio va verificato nel pannello prezzi e nella documentazione dell'API, invece di dare per scontato che "un'immagine è un'immagine". Inoltre, l'image-to-image è spesso accompagnato da costi di upload e storage; hosting delle immagini e traffico CDN sono spesso dello stesso ordine di grandezza dei costi di inferenza, quindi non calcolare solo la parte del modello.
Quali dimensioni considerare nel confronto trasversale
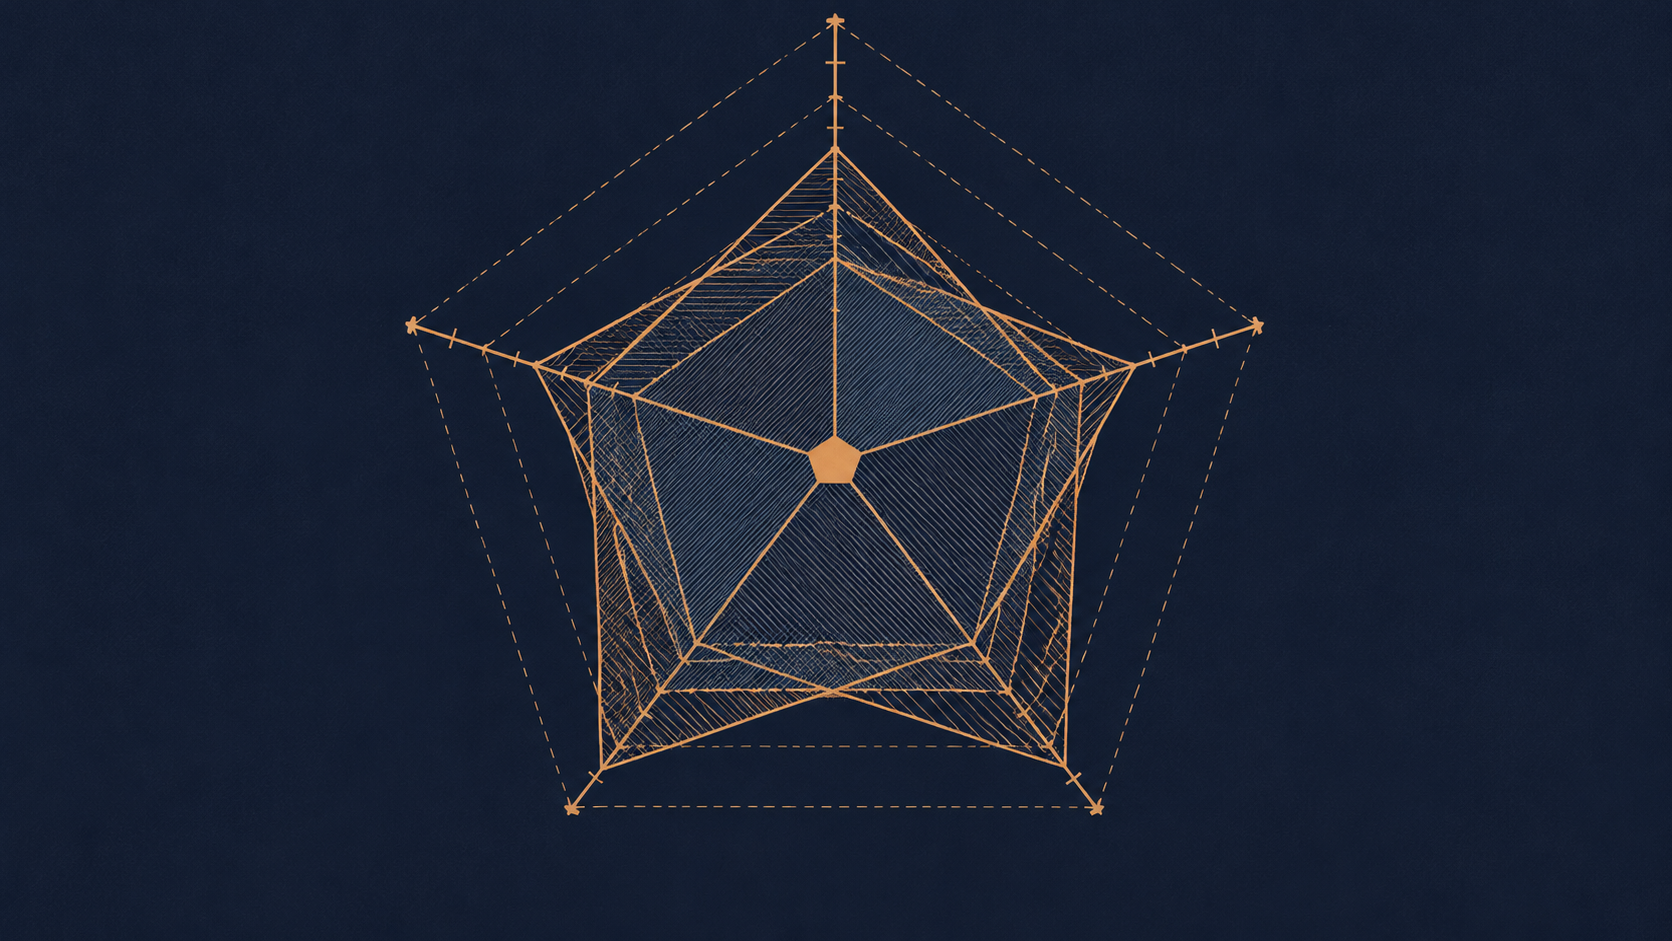
L'errore più comune nella selezione image-to-image è "confrontare solo il prezzo unitario". Il costo per immagine è solo un quinto dell'informazione; si consiglia di considerare insieme le seguenti dimensioni.
1. Coerenza con l'input
Il valore centrale dell'image-to-image è "somigliare all'immagine originale". Va valutata la stabilità del modello nel preservare contorni del soggetto, volti, testo e impaginazione. Un modello con scarsa coerenza dà la sensazione che "dopo la modifica è diventata un'altra immagine", e l'utente se ne accorge subito.
2. Controllabilità
Puoi dirigere con precisione l'ambito della modifica tramite parametri e prompt? La modifica locale supporta vincoli di area? L'intensità del trasferimento di stile è regolabile? Un modello con scarsa controllabilità rende impossibile progettare l'interazione lato prodotto — perché non puoi promettere all'utente "modifichi dove cerchi".
3. Costo per immagine
Ovvero il prezzo unitario della fatturazione a immagine. È l'unica cosa che può essere scritta come una linea retta, ma è confrontabile solo con modelli con lo stesso criterio di fatturazione; confrontare direttamente un prezzo a immagine con un prezzo a token porta di solito a conclusioni errate.
4. Latenza e throughput
La modifica immagine è uno scenario fortemente interattivo: l'utente clicca il pulsante e aspetta. Tempo al primo byte, tempo di generazione per immagine e l'eventuale accodamento in caso di alta concorrenza determinano direttamente se questa funzione può essere realizzata come anteprima in tempo reale. Per le attività batch offline, invece, conta più il throughput della latenza per singola immagine.
5. Forma dell'interfaccia e dei parametri
Come si passa l'immagine di input (URL, base64 o upload preventivo)? Come viene restituito l'output (direttamente o con ID attività da interrogare)? Ci sono parametri come seed, dimensione, intensità? Questi determinano il lavoro di integrazione e anche il costo di migrazione.
Trasforma le cinque voci sopra in una tabella di valutazione comparativa, assegnando un punteggio a ogni candidato invece di scrivere solo il prezzo: scoprirai che le differenze tra i candidati spesso non stanno nel denaro.
Come fare un esperimento di selezione affidabile su piccolo campione
Non scegliere il modello a sensazione. Con un esperimento di confronto su piccolo campione che si completa in mezza giornata, le conclusioni sono più affidabili di qualsiasi articolo di recensione.
Primo passo: scegliere 8–15 input rappresentativi
Il campione deve coprire la distribuzione reale del tuo business, non solo "immagini belle":
- Immagini di scenari tipici (illuminazione normale, composizione standard)
- Campioni difficili (bassa risoluzione, testo denso, foto di gruppo)
- Campioni limite (proporzioni estreme, materiali non fotografici)
Per ogni immagine, un'istruzione di modifica fissa; tutti i modelli candidati usano input e istruzioni completamente identici.
Secondo passo: definire i criteri di valutazione
Scrivi in anticipo i criteri di valutazione, per evitare giustificazioni a posteriori. Si consigliano quattro voci, ciascuna da 1 a 5 punti:
- Fedeltà: soggetto, struttura e testo sono stati preservati correttamente
- Aderenza all'istruzione: la modifica specificata è stata effettivamente completata
- Qualità dell'immagine: artefatti, distorsioni, cedimenti locali
- Usabilità: il risultato può essere consegnato direttamente all'utente
Terzo passo: valutazione cieca e registrazione
Mescola l'ordine dei nomi file di output prima di valutare, per ridurre il pregiudizio dovuto al sapere "chi ha prodotto l'immagine". La tabella di registrazione deve contenere almeno: ID campione, modello, quattro punteggi, tempo di generazione, se fallito, costo singolo.
Quarto passo: calcolare la conclusione complessiva
punteggio complessivo = ponderato(fedeltà, aderenza all'istruzione, qualità dell'immagine, usabilità)
rapporto qualità-prezzo = punteggio complessivo / costo per immagine
I pesi dipendono dal business: i materiali marketing privilegiano la qualità, gli strumenti in tempo reale la latenza. Alla fine non produrre solo un vincitore, ma una conclusione del tipo "in quali condizioni scegliere A, in quali B": è molto più utile di una classifica.
Note sulla migrazione a un nuovo modello
Passando dalla pipeline image-to-image esistente a gpt-image-2.6-flare/image-to-image, il rischio non è principalmente nel modello stesso, ma nelle giunzioni. Prima del lancio si consiglia di verificare voce per voce:
Interfaccia e livello applicativo
- Forma di chiamata: restituzione sincrona o attività asincrona? Se asincrona, intervallo di polling e timeout vanno adattati di conseguenza.
- Vincoli di input: quali sono i limiti di formato, dimensione e proporzioni dell'immagine di input? Il superamento genera errore o ritaglio automatico? Comportamenti diversi richiedono messaggi frontend diversi.
- Forma di output: viene restituito il binario dell'immagine, un URL o base64? Determina direttamente se la tua catena di storage deve cambiare.
- Mappatura dei parametri: i parametri di intensità, dimensione, campionamento della vecchia pipeline hanno corrispondenze nella nuova interfaccia? Se no, come esprimerli in forma degradata?
Resilienza ingegneristica
- Classificazione degli errori: distinguere e gestire separatamente rifiuto per moderazione contenuti, parametri non validi, rate limiting e timeout; non riprovare tutto allo stesso modo — i retry su errori di moderazione peggiorano solo la situazione.
- Budget di retry: con la fatturazione a immagine ogni retry genera nuovi costi; la strategia di retry deve avere un limite e essere registrata.
- Livello di adattamento: convogliare le chiamate al modello dietro un sottile livello di adattamento, per evitare che il codice business sia disseminato di nomi di parametri di un particolare fornitore.
- Rollout graduale e fallback: collegare prima il nuovo modello a poco traffico, mantenere l'interruttore del vecchio modello, e aumentare gradualmente dopo aver confermato le metriche.
- Tracciamento comparativo: registrare per ogni richiesta versione del modello, tempo di esecuzione, esito e se è stata rifiutata manualmente; sono la base per le decisioni successive.
La migrazione non è una sostituzione, ma un passaggio reversibile. Solo se puoi tornare alla vecchia pipeline con un clic osi davvero aumentare il traffico.
Quando non sceglierlo
Viceversa, ci sono scenari in cui gpt-image-2.6-flare/image-to-image non è la prima scelta:
- Non c'è affatto un'immagine di input. Per esigenze di pura generazione creativa o composizione da zero, il text-to-image è più diretto; forzare l'image-to-image aggiunge solo un passaggio di upload.
- Modifiche che richiedono certezza a livello di pixel. Ad esempio regolare con precisione l'impaginazione del testo, cambiare numeri, modificare blocchi di colore per coordinate: per queste attività è più affidabile l'elaborazione deterministica delle immagini o il rendering da template; i modelli generativi hanno intrinsecamente incertezza.
- Interazione fortemente in tempo reale a latenza estremamente bassa. Se il prodotto richiede risposte a livello di millisecondi (come anteprime in stile filtro in tempo reale), è necessario prima fare test di carico per verificare se la latenza è raggiungibile; se non lo è, non va adottato.
- Funzioni gratuite estremamente sensibili ai costi. La fatturazione a immagine è lineare, ma il numero di immagini su funzioni gratuite cresce linearmente con la base utenti; va prima calcolato con chiarezza il modello di economia unitaria prima di decidere se aprire la funzione.
- Elaborazione batch che richiede stretta riproducibilità. Quando lo stesso input deve produrre sempre lo stesso output, i modelli generativi di solito non possono garantire una coerenza totale.
Il metodo di giudizio è semplice: se la tua esigenza può essere risolta stabilmente con "regole + librerie di elaborazione immagini", non introdurre il modello; se la difficoltà centrale è proprio la comprensione semantica e il ridisegno dell'immagine, allora è un candidato adatto.
Articoli correlati
Vedi tutti gli articoli →-

Confronto e valutazione
Checklist di selezione di Gemini Omni 1.2 Flash: modalità di input, specifiche e budget
Verifica modalità di input, specifiche, budget e confini degli effetti, e completa la validazione di selezione con i tuoi campioni
-
Confronto e valutazione
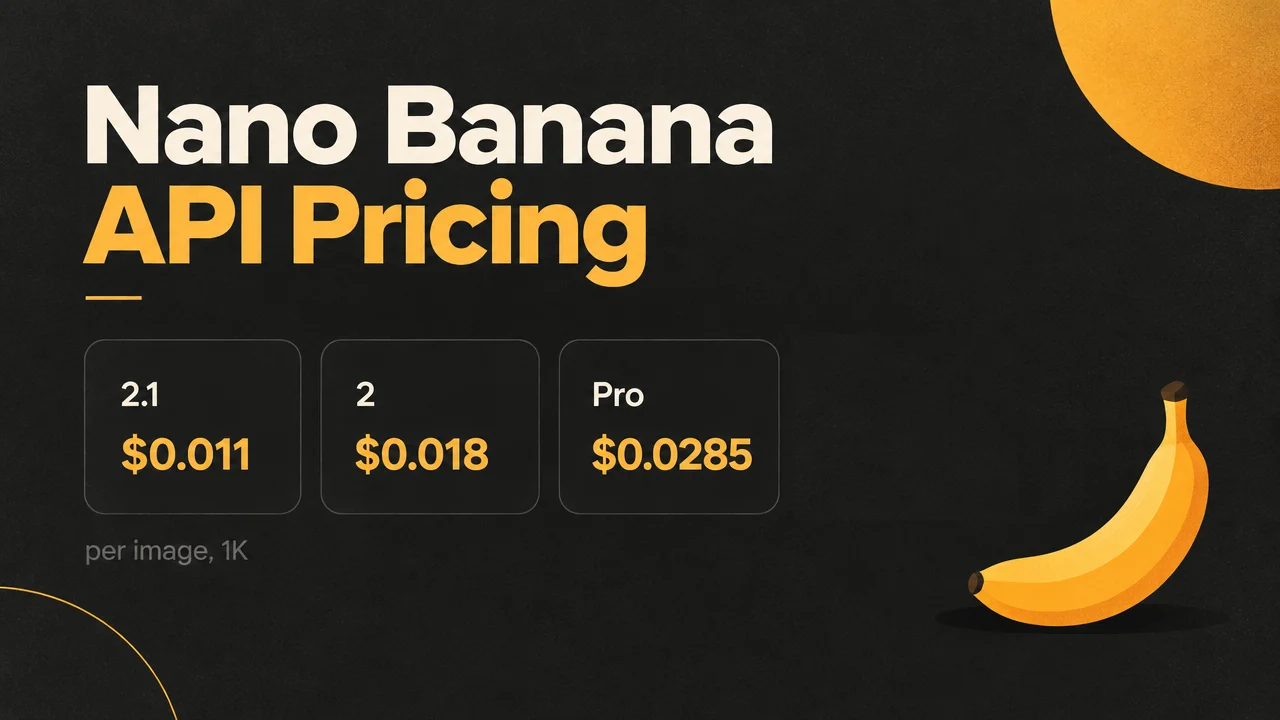
Nano Banana Black Friday, meno di 1 centesimo per immagine: confronto tra 2.1, 2 e Pro con lo stesso prompt
Prezzo pieno e prezzo Black Friday delle tre versioni 2.1, 2 e Pro, con confronto delle immagini generate dallo stesso prompt
-
Confronto e valutazione
Prezzi delle API video AI per il Black Friday: Veo, Seedance e Kling costano fino al 23% in meno al secondo
Prezzi al secondo e per video di Veo 3.1, Seedance e Kling 3.0, con i prezzi scontati del Black Friday