
Tutoriale
gemini-3.8-flash in pratica: 5 scenari applicativi ad alto valore per il testo e punti chiave per l'implementazione
Dalla selezione all'integrazione: portare un modello testuale nei reali flussi di lavoro aziendali
In questa pagina
Perché partire dagli scenari e non dai parametri del modello
Molti team, quando scelgono un modello testuale, reagiscono istintivamente confrontando una tabella di parametri voce per voce: lunghezza del contesto, velocità di inferenza, punteggi in classifica. Ma ciò che decide davvero se un progetto può andare in produzione spesso non sono questi numeri, bensì se lo scenario di business è stato ridotto a un contratto di input/output chiaro.
Lo stesso modello, usato per «convertire un'email di un cliente in campi strutturati» e per «scrivere un testo creativo aperto», presenta una difficoltà ingegneristica completamente diversa. Il primo caso richiede solo stabilità e verificabilità; il secondo richiede controllo dello stile e selezione umana. Quindi l'ordine corretto è:
- Scrivere prima chiaramente il compito di business: che forma ha il testo in input, a chi va consegnato l'output, da quale sistema a valle viene consumato.
- Poi definire il contratto di input/output: campi, formato, limite di lunghezza, come esprimere i valori mancanti, cosa restituire in caso di errore.
- Solo alla fine scegliere il modello: usare il contratto per eseguire la suite di valutazione, non la tabella dei parametri per indovinare i risultati.
Mettere lo scenario al primo posto ha anche un vantaggio pratico: una volta fissato il contratto, il modello diventa un dettaglio implementativo sostituibile. Oggi si fa funzionare il flusso con gemini-3.8-flash, domani si cambia modello o si modificano le strategie di retry e fallback, e il codice di business quasi non cambia — a condizione che tutte le chiamate siano convogliate in un livello di interfaccia unificato, e non sparse nei vari moduli di business.
Tutti gli esempi in questo articolo usano l'interfaccia compatibile Chat Completions: le richieste vengono inviate a https://api.hiapi.ai/v1/chat/completions, con supporto per l'output in streaming. Sul lato input sono accettati solo testo e immagini, il limite di contesto è 1.048.576 token, l'output massimo per singola richiesta è 65.536 token; l'intensità di ragionamento viene passata tramite reasoning_effort con low / medium / high, e si consiglia di scegliere il livello in base alla valutazione del compito effettivo. Va precisato in anticipo che questa interfaccia attualmente non offre function calling, ricerca web, computer use e output strutturato (modalità JSON): tutti i vincoli di formato vanno scritti nel prompt e verificati nel proprio codice.
Ogni modello ha due percorsi: il percorso standard usa direttamente il nome del modello (ad esempio gemini-3.8-flash), il percorso Vertex aggiunge @vertex dopo il nome del modello (ad esempio gemini-3.8-flash@vertex). I nomi dei modelli e la fatturazione dei due percorsi sono diversi; nel seguito gli esempi usano uniformemente il percorso standard.
from openai import OpenAI

client = OpenAI(base_url="https://api.hiapi.ai/v1", api_key="YOUR_KEY")

resp = client.chat.completions.create(
    model="gemini-3.8-flash",
    messages=[{"role": "user", "content": "Estrai in JSON contatto, azienda e intento da questa email del cliente"}],
    reasoning_effort="medium",
    stream=True,
)
I 5 scenari seguenti coprono la maggior parte delle esigenze di tipo testuale: estrazione strutturata, generazione di contenuti in batch, classificazione ed etichettatura, sintesi e riscrittura, domande e risposte conversazionali. Il loro punto comune è confini del compito chiari e risultati valutabili: è proprio qui che i modelli testuali tendono a generare valore stabile.
Scenario uno: estrazione strutturata da testo non strutturato
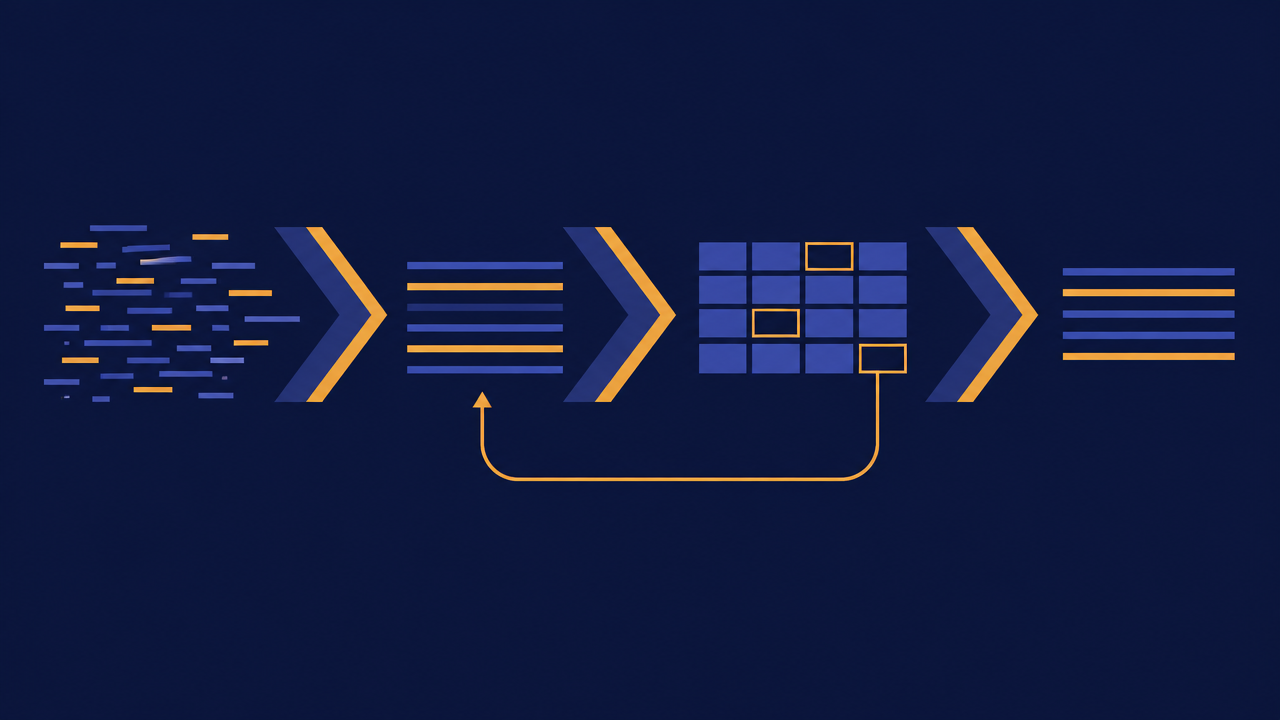
Questo è uno degli scenari con il miglior rapporto costo-beneficio. L'input è testo libero come email, paragrafi di contratti, descrizioni di ticket, note di moduli; l'output è un JSON che i sistemi a valle possono consumare direttamente.
La definizione dei campi deve permettere di «valutare il vuoto»
La causa più frequente di fallimento nei compiti di estrazione, oltre alle capacità del modello, è la definizione ambigua dei campi. Per ogni campo vanno chiarite tre cose: il tipo, se è obbligatorio e come esprimere l'assenza. Ad esempio, se l'importo non viene estratto, restituire null invece di una stringa vuota, così il sistema a valle può distinguere tra «questa informazione non c'è» e «è stato estratto un valore vuoto».
{
  "contact_name": "string|null",
  "company": "string|null",
  "intent": "purchase|support|other",
  "deadline": "YYYY-MM-DD|null",
  "confidence_notes": "string"
}
Fornire enum nel contratto, invece di lasciare il modello libero
Per tutti i campi che possono essere enumerati, elencare nel prompt tutti i valori ammessi. La classificazione a insieme aperto è il peggior nemico della stabilità dell'estrazione: il modello inventerà un'etichetta apparentemente ragionevole che però non esiste nel dizionario a valle.
L'output deve passare attraverso un livello di validazione
Non dare per scontato che l'output del modello sia sempre JSON valido. Questa interfaccia non offre output strutturato (modalità JSON), quindi il formato dell'output può essere garantito solo tramite il prompt e il livello di validazione non è opzionale. Fallimenti di parsing, tipi di campo non conformi, valori di enum fuori intervallo: tutto deve essere intercettato nel codice, con retry o passaggio a un operatore umano. Un approccio semplice è: parsing → validazione dei tipi → validazione delle regole di business (ad esempio, la data non può essere precedente a oggi) → inserimento nel database solo se tutto passa.
La gestione dei valori mancanti deve avere una strategia
Quando mancano campi obbligatori, non lasciare che il flusso prosegua silenziosamente. Si può scegliere di riprovare automaticamente una volta (sottolineando nel prompt che quel campo va estratto con ogni sforzo); se manca ancora, marcarlo come da integrare manualmente e registrare il motivo. Questo costa molto meno che lasciare che dati sporchi entrino nel database principale.
Scenario due: generazione di contenuti in batch e testi basati su template
Testi di marketing, titoli e descrizioni di prodotti, paragrafi per landing page SEO: questi compiti sono caratterizzati da grande volume, struttura simile, requisiti non elevati per singolo elemento ma sensibilità alla coerenza di stile.
Fissare lo scheletro con un template, riempire le differenze con variabili
Non trattare l'intero prompt come un unico testo libero da modificare continuamente. Scomporre il prompt in due livelli:
- Livello fisso: ruolo, tono, parole vietate, intervallo di lunghezza, formato di output. Questa parte deve rimanere stabile nel tempo.
- Livello variabile: nome del prodotto, punti di forza, pubblico target, canale. Questa parte viene sostituita a ogni chiamata.
Così basta mantenere un solo template e i problemi di qualità della generazione possono essere ricondotti a «è un problema del template o delle variabili?».
La lunghezza dell'output va vincolata esplicitamente
La fatturazione a token significa che più lungo è l'output, più alto è il costo, e negli scenari batch questa differenza si amplifica. Indicare nel prompt un intervallo preciso (ad esempio «non più di 80 caratteri») e impostare nel codice un limite massimo di output come rete di sicurezza. Non aspettarti che il modello capisca da solo quando «basta».
I compiti batch vanno suddivisi in lotti e deduplicati
Inviare migliaia di elementi in una volta sola porta facilmente a limitazioni di frequenza e timeout. Si consiglia di suddividere in lotti di dimensione fissa, rieseguire solo gli elementi falliti di ogni lotto e registrare l'hash di ogni input per la deduplicazione: rigenerare è sia uno spreco di token sia una fonte di contenuti omogenei che inquinano la libreria di materiali.
Prevedere una fase di selezione manuale a valle
L'uso pratico della generazione in batch è di solito «generare N elementi, selezionarne M manualmente». Generare più varianti per chiamata e lasciare la selezione finale agli operatori è più conveniente che cercare la perfezione nel singolo elemento, ed è anche più in linea con le abitudini dei team di contenuti.
Scenario tre: classificazione, etichettatura e riconoscimento dell'intento
I compiti di classificazione sembrano i più semplici, ma la difficoltà per andare in produzione in modo stabile sta nel sistema di etichette, non nel modello.
L'insieme delle etichette deve essere chiuso e definito
Per ogni etichetta fornire una definizione in una frase, con esempi positivi e negativi. Le etichette dovrebbero essere il più possibile mutuamente esclusive: se «consulenza post-vendita» e «resi e cambi» si sovrappongono ampiamente, la scelta del modello diventa casuale e la valutazione non riesce a individuare i problemi.
I campioni di confine sono più importanti di quelli ordinari
Quando si costruisce la suite di valutazione, concentrarsi sui confini: una frase che assomiglia a due categorie contemporaneamente, che contiene solo metà di una parola chiave, con tono sarcastico, mescolata con informazioni irrilevanti. Sui campioni ordinari il modello quasi non sbaglia; sono i campioni di confine la fonte degli incidenti in produzione.
Far produrre al modello informazioni di confidenza
Un approccio pratico è chiedere al modello di restituire, oltre all'etichetta assegnata, anche un giudizio «appartiene a una delle categorie sopra» e una breve motivazione. Il campo della motivazione non entra nel database di business, ma è estremamente utile per diagnosticare classificazioni errate.
Instradare i casi a bassa confidenza verso gli operatori
Non puntare alla classificazione completamente automatica. Stabilire una strategia: se l'etichetta principale è chiara, salvataggio automatico; se il modello indica «incerto» o corrisponde a più candidati, invio alla coda di revisione manuale. I risultati della revisione manuale possono tornare come nuovi campioni di valutazione, creando un ciclo virtuoso.
Documentare l'evoluzione del sistema di etichette nel tempo
Una volta in produzione, l'insieme delle etichette viene continuamente modificato dal business. Conservare una versione per ogni modifica e registrare nei dati «con quale versione dell'insieme di etichette è stato etichettato questo elemento», altrimenti i dati storici non saranno confrontabili.
Scenario quattro: sintesi di testi lunghi e riscrittura stilistica
Sintesi e riscrittura hanno in comune input lungo e output breve, il che li rende naturalmente adatti a modelli fatturati a token, ma sono anche i più soggetti al problema del «sembra giusto ma sbaglia nei dettagli».
Gli input lunghi vanno suddivisi e poi ricomposti
Il limite di contesto è 1.048.576 token, un singolo documento di solito può essere inserito in una volta; ma con raccolte di più documenti o quando è necessario citare molte evidenze, bisogna comunque suddividere in blocchi secondo confini semantici (capitoli, paragrafi, righe vuote), generare sintesi parziali per ogni blocco e poi ricomporle in una sintesi complessiva. Mantenere le informazioni di titolo come contesto per ogni blocco migliora significativamente la qualità della ricomposizione.
Chiarire quale tipo di sintesi si vuole
«Estrattiva» e «generativa» sono due cose diverse. Il business vuole «conservare tutti i numeri e le conclusioni chiave» o «una lettura scorrevole»? Nel primo caso si dovrebbe chiedere al modello di citare il più possibile le formulazioni originali e di non aggiungere fatti; nel secondo si può essere più permissivi, ma bisogna accettare un rischio di deviazione più elevato.
La riscrittura deve avere vincoli verificabili
La riscrittura stilistica tende facilmente a scivolare verso la «creazione libera». Rendere i requisiti concreti: pubblico di riferimento, tono, se mantenere i termini tecnici, limiti minimo e massimo di lunghezza, struttura dei paragrafi da preservare. Più i vincoli sono specifici, meno rilavorazioni ci saranno.
La verifica di coerenza è indispensabile
Numeri, date, nomi di persone, nomi propri sono i contenuti più facilmente alterati durante la riscrittura. Prima del rilascio deve esserci almeno un passaggio di verifica automatica: estrarre entità e numeri chiave dal testo originale e controllare che compaiano identici nell'output. Se il tasso di corrispondenza non raggiunge la soglia, riscrivere o passare a un operatore umano.
Impostare un limite massimo alla lunghezza dell'output
È comune che le sintesi si allunghino in modo incontrollato. Oltre a indicare la lunghezza nel prompt, impostare anche un limite di output a livello di richiesta, per evitare che singoli documenti lunghi facciano lievitare il costo della singola chiamata.
Scenario cinque: domande e risposte conversazionali e assistente di business
Le applicazioni di domanda-risposta sono le più sottovalutate: una demo si avvia in tre minuti, ma per fornire un servizio esterno come assistente di business serve un'intera gestione dei confini.
L'organizzazione del contesto determina la qualità della risposta
Cosa inserire in una richiesta è più importante di come scrivere il prompt. La struttura tipica è: ruolo e regole di sistema, materiale di contesto aziendale (frammenti recuperati per rilevanza), ultimi n turni di conversazione, domanda del turno corrente. I frammenti di materiale devono essere annotati con la fonte e si deve dire esplicitamente al modello «rispondi solo in base al materiale fornito».
Il rifiuto a rispondere è una funzionalità, non un difetto
Bisogna progettare esplicitamente il percorso di rifiuto: quando nel materiale non c'è la risposta, quando la domanda esce dall'ambito di business, quando si tratta di operazioni sensibili, il modello deve fornire una formula di fallback fissa e indirizzare l'utente verso il canale umano. Le formule di rifiuto vanno scritte nel prompt di sistema, non lasciate all'improvvisazione del modello.
Lo stato multi-turno va gestito nel proprio codice
Non far «ricordare» tutto al modello. Informazioni deterministiche come lo stato della sessione, l'identità dell'utente, il numero d'ordine confermato devono essere mantenute dal sistema di business e iniettate a ogni turno di richiesta; il modello si occupa solo di organizzare il linguaggio. Così la conversazione è riproducibile e verificabile.
Controllare la lunghezza del contesto iniettato a ogni turno
Più lunga è la conversazione, più storia viene trasportata a ogni turno, più alto è il costo per turno. L'approccio è conservare il testo originale degli ultimi n turni e comprimere i turni precedenti in una sintesi di poche frasi chiave. Questa è una delle principali variabili di costo per le applicazioni in esecuzione continua.
Prevedere un controllo separato per le azioni eseguibili
Se l'assistente può attivare rimborsi, modificare ordini, inviare messaggi e azioni simili, l'output del modello può essere solo un suggerimento; l'esecuzione effettiva deve passare attraverso la validazione dei parametri e il controllo dei permessi, con eventuale conferma umana. Un modello testuale non dovrebbe avere direttamente permessi di scrittura.
Controllo di costi e prestazioni con la fatturazione a token
La fatturazione a token significa che il costo è quasi interamente determinato da «lunghezza input + lunghezza output». Le azioni di controllo dei costi si possono praticamente tutte ricondurre a questi due lati.
Lato input: prima ridurre, poi parlare di ottimizzazione
- Inviare solo il contenuto necessario: inserire l'intero documento nel prompt è lo spreco più comune. Fare prima una selezione dei paragrafi o un recupero, e inviare solo i frammenti rilevanti.
- Rimuovere i testi boilerplate: piè di pagina, disclaimer, firme ripetute non contribuiscono al risultato ma vengono comunque fatturati.
- Controllare il numero di turni storici: la storia delle applicazioni conversazionali va compressa con sintesi, non accodata all'infinito.
- Il prompt stesso deve essere snello: i prompt di sistema mantenuti a lungo tendono ad allungarsi; rivederli periodicamente ed eliminare gli esempi ridondanti.
Lato output: impostare limiti e usare formati brevi
Il limite di output è la valvola di controllo dei costi più diretta; l'output massimo per singola richiesta di 65.536 token è il confine dell'interfaccia, ma il lato business dovrebbe impostare limiti più piccoli in base alle esigenze. Inoltre, chiedere nel prompt al modello di rispondere con JSON compatto (l'interfaccia non offre la modalità JSON, la validazione è a carico del richiedente) di solito accorcia significativamente l'output; chiedere «prima la conclusione, poi una frase di motivazione» è molto più economico che chiedere lunghe spiegazioni.
Sostituire le chiamate ripetute con la cache
Chiamare più volte con lo stesso input è puro spreco. Per compiti altamente deterministici (classificazione, estrazione), memorizzare i risultati in cache usando l'hash dell'input come chiave; per i compiti generativi, si possono memorizzare in cache i frammenti di materiale recuperati invece del testo finale.
Unire le richieste in batch
Per i compiti su testi brevi si possono combinare più input in una singola chiamata, chiedendo al modello di fornire le risposte in ordine. Questo riduce il numero di richieste e il costo ripetuto del prompt di sistema, ma attenzione: il fallimento di un singolo elemento influisce sull'intero lotto, quindi bisogna analizzare per singolo elemento e mantenere la capacità di retry.
Valutare insieme risultati e costi
Non guardare solo il costo della singola chiamata, ma il «costo totale per completare un'azione di business»: include il numero di retry, la percentuale di revisione manuale, le rilavorazioni a valle. Una configurazione economica ma che richiede molte rilavorazioni è spesso più costosa di una configurazione stabile ma con prezzo unitario più alto. Solo usando una suite di valutazione fissa e registrando contemporaneamente accuratezza e consumo di token si può fare un vero compromesso.
Le diverse opzioni e i prezzi sotto la stessa interfaccia
- gemini-4-carbon: il modello più potente della serie Gemini 4, pensato per i compiti multi-fase e a lungo ciclo più complessi. Percorso standard 1,00 / 0,05 / 5,00, percorso @vertex 1,64 / 0,09 / 8,20.
- gemini-4-argon: adatto alla maggior parte dell'ingegneria del software e del lavoro intellettuale, con equilibrio tra capacità e costo. Percorso standard 1,00 / 0,05 / 5,00, percorso @vertex 1,64 / 0,09 / 8,20.
- gemini-3.8-flash: veloce ed economico, adatto a compiti ad alta concorrenza e bassa latenza. Percorso standard 0,19 / 0,02 / 0,92, percorso @vertex 0,62 / 0,07 / 3,08.
I prezzi sono in dollari per milione di token, nell'ordine input / input in cache / output. Per la scelta, considerare insieme complessità del compito, esigenze di contesto, intensità di ragionamento e costo: per compiti ad alta concorrenza, bassa latenza e con esigenze non elevate di ragionamento preferire gemini-3.8-flash; per compiti complessi multi-fase e a lungo ciclo considerare gemini-4-carbon o gemini-4-argon.
Validazione e progettazione del fallback da completare prima del rilascio
L'incertezza dell'output del modello non scompare con il rilascio, diventa un incidente solo per la mancanza di fallback. Passare in rassegna questa checklist prima del rilascio permette di evitare la maggior parte dei problemi.
Uno: costruire una suite di valutazione fissa
Estrarre campioni dai dati di business reali, coprendo situazioni tipiche e di confine, con l'output atteso annotato per ogni elemento. Questa suite di valutazione deve essere conservata con versioning ed eseguita ogni volta che si modifica il prompt, si cambia modello o si regolano i parametri, confrontando accuratezza e consumo di token. Senza una suite di valutazione non esiste la frase «i risultati sono migliorati».
Due: definire criteri di accettazione quantificabili
Non accettare con «mi sembra vada bene». Definire metriche per ogni scenario: per l'estrazione, accuratezza dei campi e tasso di successo del parsing; per la classificazione, accuratezza e percentuale di bassa confidenza; per la sintesi, tasso di conservazione delle entità chiave; per la domanda-risposta, tasso di risposte di rifiuto corrette e percentuale di intervento umano. I criteri vanno confermati dal business prima dello sviluppo.
Tre: progettare i percorsi di fallimento
- Fallimento del parsing: riprovare una volta; se fallisce ancora, inviare alla coda di elaborazione, senza scartare silenziosamente.
- Timeout e limitazione di frequenza: retry con backoff esponenziale e limite di tempo totale, per evitare accumulo di richieste.
- Strategia di fallback: se il modello principale non è disponibile, esiste un modello di riserva o una regola di fallback? La differenza di qualità dell'output dopo il fallback è accettabile? Va concordata in anticipo con il business.
- Idempotenza: l'elaborazione ripetuta della stessa richiesta di business non deve produrre risultati duplicati.
Quattro: i percorsi critici devono prevedere revisione manuale
Tutte le azioni in cui l'output del modello influisce direttamente sui diritti dell'utente o sui fondi devono passare attraverso revisione manuale o validazione rigorosa. Il modello si occupa di migliorare l'efficienza, la persona della decisione finale: questo divisione dei compiti non va invertita.
Cinque: istituire campionamento e monitoraggio in produzione
Dopo il rilascio, continuare a campionare una percentuale per la revisione manuale, registrando l'andamento dell'accuratezza, la distribuzione dei tipi di fallimento e il consumo di token per richiesta. In caso di anomalie, poter individuare rapidamente se sono cambiati i dati, se il prompt è stato modificato o se c'è una deriva nel comportamento del modello.
Sei: convogliare le chiamate in un livello di interfaccia unificato
Con chiamate ai modelli sparse nel codice di business non è possibile fare quanto sopra. Dopo aver convogliato le chiamate in un livello di accesso unificato, cambio di modello, regolazione dei parametri, retry e fallback si possono gestire in un unico punto, e il lato business si confronta solo con un contratto di input/output stabile. Questo rende anche «confrontare modelli diversi con la stessa suite di valutazione» un'operazione a basso costo.
Solo con scenari definiti, contratto prima di tutto e fallback completo i modelli testuali possono entrare davvero nel processo produttivo, invece di fermarsi alla fase dimostrativa.
Articoli correlati
Vedi tutti gli articoli →-

Tutoriale
Come chiamare kimi-k3.1-pro tramite l'API HiAPI: curl, Python e richieste eseguibili direttamente
Una guida pratica all'integrazione, che copre endpoint, parametri della richiesta, streaming, tool calling e risoluzione dei problemi
-

Tutoriale
API ElevenLabs Music su HiAPI: generare musica con curl, Python e ricette di prompt
Un tutorial pratico per chiamare elevenlabs/music-v2.5 tramite HiAPI, con ricette di prompt pronte da copiare per stile, mood e durata
-

Tutoriale
Come usare gpt-image-2.5-sunburst/image-to-image tramite l'API HiAPI: curl e Python
Richieste eseguibili per sviluppatori, flusso di caricamento dell'immagine di riferimento e risoluzione degli errori