
Guida all'uso
Guida introduttiva a gemini-4-hydrogen: confini delle capacità, punti chiave sui parametri e pratiche di integrazione
Riferimento per l'integrazione e la selezione di modelli testuali per i team di ingegneria
In questa pagina
Posizionamento e confini delle capacità di gemini-4-hydrogen
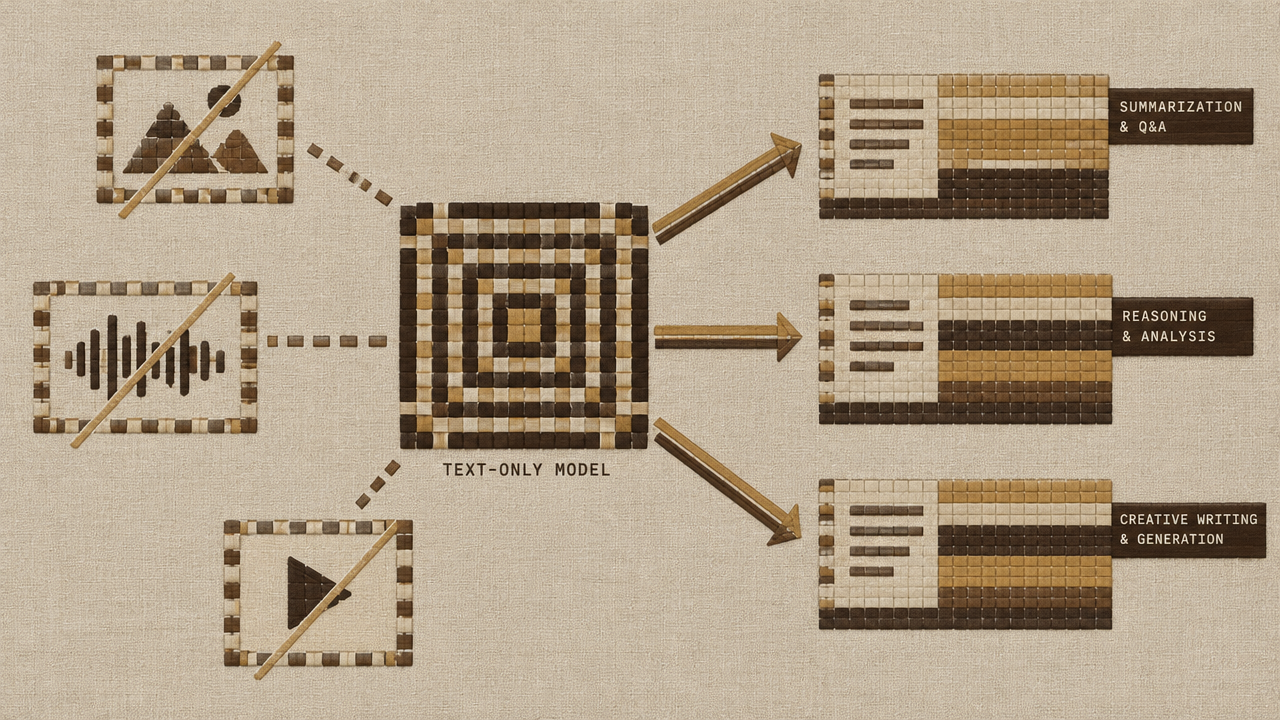
gemini-4-hydrogen è un modello testuale presentato da Google. Il suo tipo di output è testo puro — questo determina dove collocarlo nella tua architettura: nei passaggi testo in ingresso, testo in uscita, non come anello di una pipeline multimodale.
In cosa eccelle
Dal punto di vista ingegneristico, i punti di applicazione più tipici di un modello a output testuale puro sono i compiti in cui «il prodotto intermedio è proprio un pezzo di testo»:
- Estrazione e conversione strutturata: trasformare testo non strutturato in JSON, righe di tabella, elenchi di campi e altri formati concordati;
- Sintesi e riscrittura: compressione di documenti lunghi, adeguamento del tono, uniformazione dell'espressione multilingue;
- Classificazione e giudizio: riconoscimento dell'intento, classificazione dei contenuti, instradamento dei ticket, con output brevi in cambio di bassa latenza;
- Supporto alla generazione: stesura di bozze, completamento di commenti al codice, espansione di prompt e altri passaggi preliminari alla revisione umana;
- Conversazione e domande-risposte: organizzazione delle risposte a condizione di disporre di un contesto di retrieval.
La caratteristica comune di questi compiti è: l'input è serializzabile in testo, l'output è interpretabile da programmi a valle, il risultato è verificabile a campione.
Per cosa non è adatto
Sempre in termini di valutazione ingegneristica, occorre delineare in anticipo i confini:
- Non aspettarti che produca direttamente immagini, audio o video. La forma dell'output è testo; le catene che implicano generazione multimodale vanno assemblate altrove;
- Non trattarlo come una calcolatrice fortemente deterministica. Logiche come aritmetica precisa e validazione rigorosa di regole vanno affidate al codice, non al modello;
- Non fargli sostenere affermazioni fattuali senza contesto. Nei casi che richiedono conoscenza esterna, inserisci prima i materiali nell'input tramite retrieval e poi lascia che organizzi la risposta;
- Non considerarlo l'unica fonte di informazione per eventi in tempo reale. La conoscenza interna del modello ha un limite temporale; i contenuti con forti requisiti di attualità devono essere iniettati dal tuo sistema.
Scrivere questi punti nel documento di progettazione del team costa molto meno che rattoppare a valle in seguito.
Cose da confermare prima dell'integrazione
Prima di scrivere la prima riga di codice di chiamata, vale la pena chiarire alcune cose, altrimenti in fase di debug si accumuleranno molte verifiche inutili.
Definire la forma del compito e il contratto di output
Rispondi prima a tre domande: l'input è a turno singolo o multi-turno? L'output è testo libero o deve rispettare una certa struttura? In caso di errore, il sistema a valle tollera i retry? Queste tre risposte determineranno direttamente come scrivere i prompt, come impostare il limite massimo di lunghezza dell'output e come effettuare la validazione.
Credenziali e punto di accesso alle chiamate
Qualunque modalità di integrazione si scelga alla fine, serve un set di credenziali API gestibile e ruotabile, e non bisogna inserire le credenziali nel codice frontend né commetterle nel repository. La pratica consigliata è: collocare le credenziali nelle variabili d'ambiente o in un servizio di gestione dei segreti lato server, far chiamare il modello dal backend come uscita unificata, e far comunicare il frontend solo con il tuo backend. Così si evitano fughe di dati e si facilita la successiva applicazione di quote e audit per dimensione di business.
Rete e budget di timeout
La durata di una richiesta a un modello testuale varia con la lunghezza dell'input e dell'output. Prima del rilascio stabilisci: qual è il tempo massimo di risposta accettabile per il tuo business? Da lì ricava all'indietro timeout della richiesta, numero di retry e strategia di degradazione. Molti feedback di «modello instabile» sono in realtà dovuti a impostazioni di timeout non allineate alle aspettative del business.
L'osservabilità prima delle funzionalità
Prima di scrivere la logica di business, definisci i campi di log: ID richiesta, token di input, token di output, tempo impiegato, codice di errore. Questi elementi sono quasi indispensabili in seguito per il calcolo dei costi e la localizzazione dei problemi; aggiungerli dopo spesso richiede di modificare un giro di codice.
Conformità e confini dei dati
Verifica se i contenuti che intendi inviare contengono informazioni sensibili come dati personali degli utenti, chiavi, documenti interni, e stabilisci quali campi devono essere anonimizzati prima di essere inviati al modello.
Punti chiave sui parametri di chiamata e sull'organizzazione della richiesta
Una chiamata tipica è composta da tre parti: contenuto di input, parametri di controllo, risultato restituito. Ciò che realmente influenza la qualità del risultato e il costo è di solito solo un piccolo numero di parametri.
Come organizzare il contenuto di input
Considera l'input su tre livelli: «istruzioni + contesto + dati da elaborare»:
- Le istruzioni vanno all'inizio, indicando ruolo e obiettivo del compito;
- Il contesto (materiali recuperati, cronologia della conversazione) va nel mezzo, con una chiara separazione;
- I dati da elaborare vanno alla fine, immediatamente adiacenti all'oggetto su cui le istruzioni devono agire.
Nelle conversazioni multi-turno, conserva solo gli ultimi turni invece di accumulare storia senza limiti — più lunga è la storia, maggiore è il consumo lato input, e il rumore diluisce le informazioni chiave. Per i contenuti che richiedono memoria a lungo termine, si consiglia di iniettarli come sintesi, non di portarli integralmente in forma originale.
Parametri chiave
- Limite massimo di lunghezza dell'output: è il parametro più facilmente trascurato, ma influisce sia sui costi sia sull'esperienza. Se troppo piccolo, la risposta viene troncata; se troppo grande, si lascia al modello spazio per essere «loquace». Si consiglia di differenziare per tipo di compito: per i compiti di classificazione assegnare un limite molto piccolo, e lasciarlo ampio solo per la generazione di testi lunghi.
- Parametri di campionamento come temperature/top-p: per compiti che richiedono output stabile come estrazione, classificazione e conversione di formato, abbassa la casualità; per la generazione di testi si può allentare moderatamente. Mantieni la coerenza all'interno dello stesso business per facilitare il confronto in regressione.
- Condizioni di arresto: se il sistema a valle richiede che l'output termini in un certo punto (ad esempio prendere solo il primo blocco JSON), vincolare con sequenze di stop è più affidabile che ritagliare a posteriori con espressioni regolari.
- Vincoli di output strutturato: quando serve l'interpretazione da parte di un programma, fornisci nelle istruzioni nomi dei campi, tipi ed esempi, e specifica «restituisci solo JSON, senza spiegazioni aggiuntive».
Alcune esperienze sull'organizzazione delle richieste
- Separare i prompt dal codice di business, rendendoli template versionabili per facilitare i confronti A/B;
- Predisporre un fallback per l'interpretazione dell'output: in caso di fallimento della parsing registrare la risposta originale invece di restituire direttamente un errore all'utente;
- Impostare una chiave di idempotenza per la stessa richiesta, evitando addebiti duplicati ed effetti collaterali ripetuti causati dai retry;
- Nei casi con input lunghi, eseguire prima suddivisione e selezione, tenendo fuori dal modello i paragrafi irrilevanti — è il modo più diretto per risparmiare.
Come stimare e controllare i costi con la tariffazione a token
gemini-4-hydrogen è tariffato a token. Ciò significa che il tuo costo è quasi interamente determinato da due cose: quanti token vengono inviati in input a ogni richiesta e quanti token il modello restituisce in output. Per i numeri dei prezzi fai riferimento al pannello prezzi del sito; qui si parla solo del metodo.
Creare l'abitudine alla stima
Non stimare a sensazione. Il metodo è: eseguire prima un lotto di campioni reali, registrare per ogni richiesta il numero di token di input e di output, e statisticamente per gruppo di scenari di business calcolare media e percentili. Usa «numero medio di token × chiamate giornaliere medie» per ottenere una stima dell'ordine di grandezza, poi usa il P95 per vedere il caso peggiore. Scoprirai che le distribuzioni dei diversi scenari sono estremamente diverse, e stimare con una media unica porta spesso a deviazioni gravi.
Strumenti concreti per il controllo dei costi
- Comprimere l'input: rimuovere prompt di sistema ripetuti, ritagliare contesti irrilevanti, riassumere prima i documenti lunghi e poi inviarli. Il lato input è di solito la voce di costo principale, e il beneficio è il più diretto;
- Limitare l'output: tramite il limite massimo di lunghezza dell'output e istruzioni del tipo «rispondi in modo conciso», ridurre direttamente l'output ridondante;
- Chiamate a livelli: risolvere classificazioni semplici e validazioni di formato con richieste piccole, e ricorrere alla chiamata completa solo quando serve davvero capacità generativa;
- Cache e deduplicazione: mettere in cache i risultati di richieste identiche o molto simili, soprattutto per i compiti batch offline;
- Batch e asincrono: accumulare ed elaborare in batch i compiti non real-time, riducendo la parte ripetuta di costi fissi.
Trasformare i costi in metriche osservabili
Registra nei log il consumo di token per linea di business e crea dashboard di tendenza giornaliera/settimanale. Quando un giorno il consumo aumenta in modo anomalo, di solito corrisponde a tre cause: crescita del volume di chiamate, input più lungo (ad esempio logica di concatenazione del contesto modificata), output più lungo (ad esempio prompt modificati). Rendere questi tre punti elementi di monitoraggio fa risparmiare un gran numero di indagini a posteriori.
Un'ultima raccomandazione: l'ottimizzazione dei costi non deve andare a scapito della qualità dell'output. Prima costruisci il set di valutazione, poi parla di compressione.
Integrazione su una piattaforma API aggregata e confronto multi-modello
Per la maggior parte dei team, il costo maggiore in fase di selezione non è scrivere codice, ma «cambiare un modello significa rifare il livello di integrazione». Integrare tramite un ingresso unificato riduce al minimo questo costo.
I vantaggi dell'interfaccia unificata
Su una piattaforma API aggregata, le modalità di chiamata dei modelli sono uniformate alla stessa struttura di richiesta: stesso metodo di autenticazione, stesso formato dei messaggi, stessa logica di parsing della risposta. Quando si cambia modello di solito basta modificare l'identificatore del modello, e il codice di business resta pressoché invariato. Il beneficio diretto è:
- Il livello di integrazione si scrive una volta sola ed è condiviso da più modelli;
- In fase di valutazione si possono confrontare trasversalmente i modelli a basso costo;
- In produzione si possono fare rilasci graduali e rollback rapidi — quando un modello ha problemi, passare all'alternativa richiede solo una modifica di configurazione.
Le informazioni di integrazione e la disponibilità di questo modello si possono ottenere dalla pagina del modello: /models/gemini-4-hydrogen.
Fare un confronto sullo stesso insieme di compiti
Non guardare solo le classifiche. Il metodo è preparare un tuo set di valutazione che copra da 20 a 50 campioni della distribuzione reale del business, includendo casi semplici, casi limite e casi con input lunghi, quindi:
- Eseguire più modelli candidati con lo stesso template di prompt;
- Registrare la qualità dell'output (punteggio manuale o a regole), il tempo impiegato, il consumo di token;
- Guardare soprattutto il tasso di successo e le modalità di fallimento, non il punteggio medio;
- Per i campioni con differenze evidenti, fare un'attribuzione: è un problema di rispetto delle istruzioni, di formato, o di troncamento del contesto lungo?
Strategia di commutazione e coesistenza
La conclusione della valutazione spesso non è «usare un solo modello», ma «dividere il lavoro per scenario». Ad esempio: usare modelli a bassa latenza per classificazione ed estrazione, e modelli con migliore qualità dell'output per la generazione di testi lunghi. L'ingresso unificato consente di esprimere questa divisione a livello di configurazione, senza dover mantenere più SDK. Si consiglia inoltre di mantenere nel livello di integrazione un interruttore di configurazione per l'identificatore del modello, accompagnato da rilasci graduali che aumentano progressivamente il traffico.
Checklist di verifica pre-rilascio e troubleshooting dei problemi comuni
Checklist di verifica pre-rilascio
Completa questi passaggi in ordine prima di considerare l'aumento del traffico:
- Smoke test: una richiesta minima ritorna correttamente? Autenticazione e rete funzionano?
- Validazione del formato: negli scenari con output strutturato, qual è il tasso di successo del parsing su campioni batch e che aspetto ha la risposta in caso di fallimento?
- Input limite: come si comporta con input molto lunghi, input vuoti, input contenenti caratteri speciali e più lingue?
- Lunghezza dell'output: nel caso peggiore l'output viene troncato? In caso di troncamento il sistema a valle è in grado di riconoscerlo?
- Concorrenza e timeout: al picco di concorrenza atteso, il tasso di timeout e quello di errore sono accettabili?
- Percorso di degradazione: quando il modello principale non è disponibile, la catena che passa all'alternativa o restituisce un risultato di fallback funziona davvero?
- Baseline dei costi: registrare il consumo di token in un ciclo di traffico tipico come riferimento per il monitoraggio successivo.
Problemi comuni e ordine di indagine
Timeout della richiesta: controlla prima se l'input è troppo lungo (soprattutto se è stato inserito un intero documento), poi se il limite dell'output è troppo alto, infine se il timeout del client e la strategia di retry sono ragionevoli. I retry devono includere un backoff per evitare valanghe.
Output troncato: verifica il limite massimo di lunghezza dell'output e se nei prompt è richiesto un contenuto troppo lungo; a volte è una sequenza di stop impostata male a causare la fine anticipata.
Output instabile, formato altalenante: riduci prima la casualità del campionamento; poi verifica che le istruzioni siano chiare (nomi dei campi, tipi, esempi completi); infine controlla che nell'input non siano mescolati esempi contraddittori.
Contenuto che si discosta dalle istruzioni: la causa comune è un contesto troppo lungo che diluisce le istruzioni chiave. Spostare le istruzioni alla fine dell'input e ripeterle una volta, oppure comprimere il contesto, di solito migliora la situazione.
Aumento anomalo dei costi: attribuisci secondo i tre punti citati prima — volume di chiamate, lunghezza dell'input, lunghezza dell'output — confrontandoli uno per uno con le tendenze nei log.
Risultati non riproducibili: registra i parametri della richiesta e la versione del template; l'output del modello è di per sé casuale, non aspettarti una riproduzione letterale, e la verifica deve basarsi su regole o valutazione manuale.
Consolidare questa checklist nel processo di rilascio è molto più stabile che improvvisare a ogni messa in produzione. Per i dettagli specifici di selezione e integrazione, puoi iniziare a confermare dalla pagina del modello /models/gemini-4-hydrogen.
Articoli correlati
Vedi tutti gli articoli →-

Guida all'uso
Guida alla generazione di immagini da testo con Nano Banana versione base: formato, spazio negativo e uso dei prompt
Usare i campi aspect_ratio e prompt dell'API delle attività per generare immagini con composizione chiara per banner e card social
-

Guida all'uso
Gestione delle risposte di Kimi K3 in pratica: JSON completo, interruzioni dello streaming e limiti dei tentativi
-

Guida all'uso
Estrazione strutturata con GLM 5.3 in pratica: dare a ogni campo JSON una base nel testo originale
Estrarre campi con la modalità JSON object, affidandosi a valori mancanti, citazioni e validazione di business per fermare gli errori prima dell'inserimento nel database