
Guida all'uso
Generare video brevi con heygen-avatar-iv tramite l'API HiAPI: guida per sviluppatori
Input di avatar e audio, ritmo del copione, proporzioni e durata, e generazione in batch — con richieste HiAPI funzionanti
In questa pagina
Perché scegliere heygen-avatar-iv per i video brevi
I video brevi sono diventati il canale di distribuzione predefinito per lanci di prodotto, annunci di aggiornamenti, spiegazioni della documentazione e clip per i social media. Per la maggior parte dei team di ingegneria, il collo di bottiglia non è il montaggio, ma la produzione costante di contenuti parlati con una persona in video, senza dover prenotare uno studio né scambiare materiali con un presentatore reale.
È proprio qui che la generazione di video con avatar digitali colma il vuoto. Fornisci l'aspetto visivo e la fonte audio/voce, e il modello restituisce una clip renderizzata in cui l'avatar digitale legge il copione. heygen-avatar-iv è l'endpoint del catalogo HiAPI pensato per questo flusso di lavoro: clip brevi con priorità al formato verticale, in cui il presentatore guarda direttamente la telecamera.
Il modello è adatto ai seguenti scenari:
- Devi produrre su larga scala. Dieci versioni localizzate dello stesso annuncio, o una clip giornaliera per ogni rilascio: è un ciclo, non un singolo servizio fotografico.
- Il contenuto è guidato dal copione. Se il messaggio è nel testo, un presentatore digitale è sufficiente.
- Vuoi riproducibilità. Una richiesta equivale a un file, che puoi confrontare, versionare e rieseguire, a differenza di una sessione di registrazione.
- Stai già chiamando l'API. Una singola chiamata HTTP si integra nella pipeline esistente, senza introdurre un nuovo strumento con interfaccia separata.
Non è adatto a performance improvvisate con gesti ampi, né a scenari in cui la presenza fisica di una persona specifica è il punto di forza. Considera heygen-avatar-iv come un renderer: con gli stessi input dovresti ottenere lo stesso tipo di output, ed è proprio questo che lo rende scriptabile.
Il resto della guida va da una singola chiamata di test a un ciclo batch, con curl e Python funzionanti che puoi adattare. Dettagli del modello e parametri sono nella pagina del modello heygen-avatar-iv.
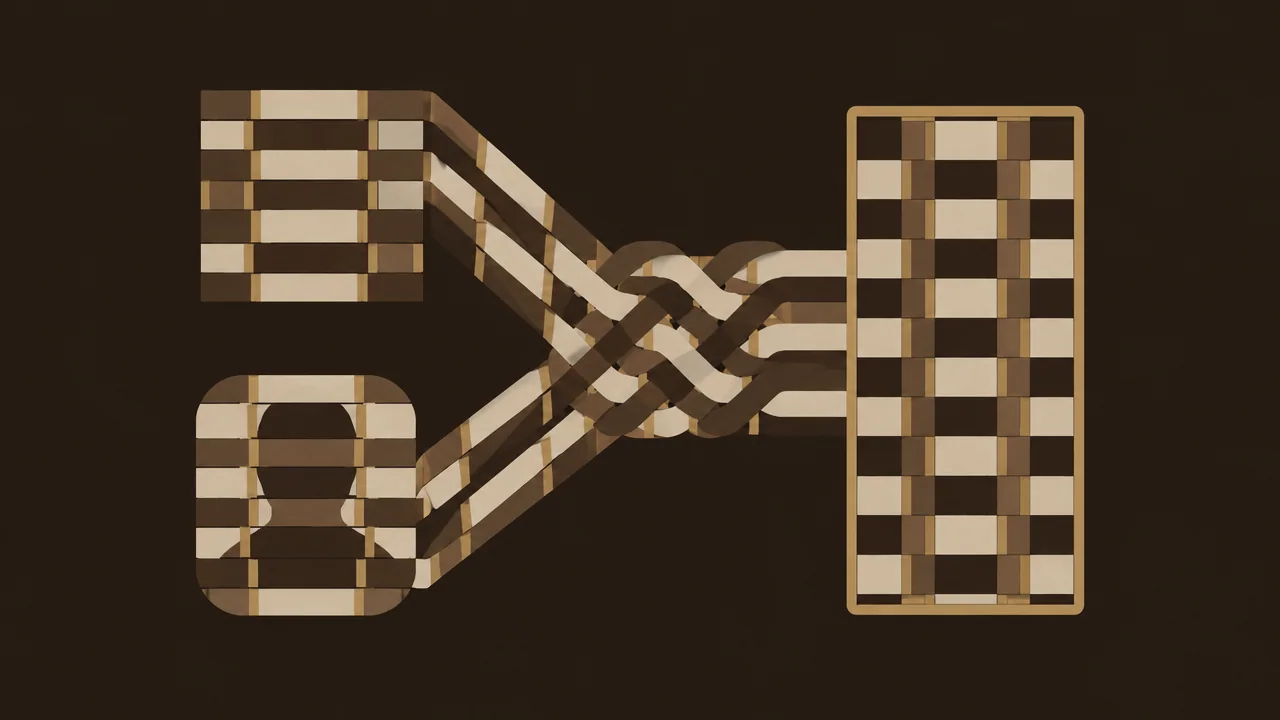
Composizione di una richiesta a heygen-avatar-iv
Prima di scrivere il codice di generazione, modella la richiesta come due gruppi di input separati. Quasi tutti i bug iniziali derivano dal confonderli.
Primo gruppo: l'aspetto visivo
È chi appare: la scelta dell'avatar digitale che determina il volto del presentatore, la composizione e l'aspetto complessivo. Mantieni questo gruppo stabile all'interno di una campagna. Se produci cinque clip sullo stesso prodotto, devono condividere lo stesso blocco avatar, così la serie sembra avere lo stesso presentatore.
Secondo gruppo: audio e voce
È cosa si dice e come. A seconda della richiesta, la fonte audio può essere la scelta di una voce che legge il testo del copione, oppure una traccia audio fornita. Questo gruppo cambia per ogni clip: nuovo copione, nuovo ritmo, a volte una nuova voce per la localizzazione.
Come si mappano sulla chiamata
La richiesta HiAPI invia entrambi i gruppi nello stesso payload all'endpoint di generazione. Concettualmente:
request
├── blocco avatar / identità   → stabile all'interno di una serie
└── blocco audio / voce        → cambia per ogni clip
        └── testo del copione o fonte audio
Questa separazione porta a due regole pratiche:
- Parametrizza il gruppo audio, congela il gruppo avatar. Nel codice, mantieni l'avatar come costante a livello di modulo e passa copione e voce come parametri della funzione. Questo garantisce strutturalmente la coerenza visiva di una serie.
- Durante il debug, cambia un solo gruppo alla volta. Se la clip sembra sbagliata, sostituisci solo l'avatar; se suona sbagliata, sostituisci solo il gruppo audio. Fare debug a due variabili su chiamate di rendering a pagamento è costoso.
Decidi inoltre fin da subito se il tuo gruppo audio è guidato dal testo o da una traccia audio, perché questa scelta determina il ritmo della sezione successiva: una traccia audio fornita impone i tempi, mentre la voce generata segue il tuo copione.
I nomi esatti dei campi, i valori accettati e i valori predefiniti sono elencati nella pagina del modello; leggili e fissali in un oggetto di configurazione, invece di spargere valori letterali nel codice.
Prima chiamata con curl
Inizia con una clip breve. L'obiettivo di questa chiamata non è la qualità dell'output, ma verificare end-to-end credenziali, forma del payload e percorso di download, prima di qualsiasi automazione.
Imposta la chiave come variabile d'ambiente, così non finisce mai in chiaro nella cronologia della shell:
export HIAPI_API_KEY="your_key_here"
Poi invia una richiesta minima. Sostituisci con la tua scelta di avatar e un copione breve:
curl -X POST "https://api.hiapi.ai/v1/generate" \
  -H "Authorization: Bearer $HIAPI_API_KEY" \
  -H "Content-Type: application/json" \
  -d '{
    "model": "heygen-avatar-iv",
    "input": {
      "avatar": "<avatar_identifier>",
      "script": "Questo è un test di trenta secondi per la pipeline degli avatar digitali. Se riesci a leggere questa frase sullo schermo, la forma della richiesta è corretta.",
      "voice": "<voice_identifier>",
      "aspect_ratio": "9:16",
      "duration": 30
    }
  }'
Controlla in ordine:
- Autenticazione. Un errore di credenziali qui significa fermarsi: tutto il resto a valle non ha importanza.
- Validazione del payload. Gli errori di schema indicano il campo problematico. Correggi un campo alla volta.
- Accettazione del job. Una chiamata riuscita restituisce un riferimento a un job o task, non necessariamente il file finito. La generazione è asincrona; registra l'identificatore.
- Recupero del risultato. Secondo il contratto di risposta nella pagina del modello, usa il riferimento restituito per interrogare lo stato o ottenere l'URL del risultato.
- Riproduzione. Scarica la clip e guardala. Verifica che composizione, orientamento e contenuto letto corrispondano al copione.
Salva questo comando curl in un file di bozza, con i tuoi identificatori reali. Diventerà il tuo esperimento di controllo: quando la versione Python non funziona, riesegui il curl per dimostrare se il problema è nel codice o negli input.
Passare a Python per una generazione ripetibile
Dopo che la chiamata curl funziona, avvolgila in una funzione. Il punto non è l'astrazione fine a sé stessa, ma rendere ogni parametro esplicito, così la clip è completamente descritta dal punto di chiamata.
import os
import requests

API_URL = "https://api.hiapi.ai/v1/generate"
API_KEY = os.environ["HIAPI_API_KEY"]

# Stabile all'interno di una serie
AVATAR = "<avatar_identifier>"


def generate_clip(script: str, voice: str, aspect_ratio: str = "9:16",
                  duration: int = 30) -> dict:
    payload = {
        "model": "heygen-avatar-iv",
        "input": {
            "avatar": AVATAR,
            "script": script,
            "voice": voice,
            "aspect_ratio": aspect_ratio,
            "duration": duration,
        },
    }
    resp = requests.post(
        API_URL,
        headers={
            "Authorization": f"Bearer {API_KEY}",
            "Content-Type": "application/json",
        },
        json=payload,
        timeout=120,
    )
    resp.raise_for_status()
    return resp.json()


if __name__ == "__main__":
    job = generate_clip(
        script="Questo è un test di trenta secondi per la pipeline degli avatar digitali.",
        voice="<voice_identifier>",
    )
    print(job)
Scelte di progettazione che daranno frutti in futuro:
- I valori predefiniti riflettono le clip che usi di più. Se la maggior parte degli output sono clip brevi verticali, impostali come predefiniti e sovrascrivili raramente.
- L'avatar a livello di modulo. La scelta dell'avatar digitale esiste in un solo posto; per rifare il branding basta cambiare una riga.
- Restituisci la risposta completa. Non estrarre subito l'URL e scartare l'oggetto job; ti servirà l'identificatore per i log e i retry.
- Solleva un'eccezione sugli errori HTTP. Un fallimento silenzioso in un ciclo batch è peggio di un crash.
- Gestisci esplicitamente la fase asincrona. Aggiungi una piccola funzione di supporto
poll(job_id)invece di fare sleep dentro la funzione di generazione.
Fissa la logica di gestione della risposta al contratto documentato nella pagina del modello: i nomi dei campi per lo stato del job e il recupero del risultato sono la parte più soggetta a divergenze rispetto alle tue ipotesi.
Scrivere il copione parlato e controllare il ritmo
I video con avatar digitale sono audio-first. Un copione che funziona sulla carta è spesso troppo lungo se letto ad alta voce, e tagliare dopo la generazione significa pagare il rendering per testo che verrà rimosso.
Scrivi in base alla lunghezza, poi taglia
Stima la durata prima di chiamare l'API. Una velocità di lettura confortevole è di circa 130–160 parole al minuto; per contenuti tecnici che il pubblico deve seguire, usa l'estremo inferiore. Quindi una clip di 30 secondi richiede circa 65–80 parole, una di 60 secondi circa 130–160. Abbozza su questo budget, leggi ad alta voce con un cronometro, poi taglia. Se devi tagliare, rimuovi intere frasi anziché singole parole: i tagli a livello di frase mantengono il ritmo intatto.
Scrivi per l'orecchio
- Frasi brevi. Un concetto per frase. Le subordinate sono il punto in cui la comprensione cala.
- Nessun riferimento solo visivo. "Come mostrato di seguito" non funziona senza una slide.
- Metti in primo piano il punto chiave. Il pubblico dei video brevi decide nei primi secondi; metti l'affermazione principale nella prima frase.
- Scrivi per esteso ciò che il TTS leggerebbe male. Abbreviazioni, stringhe di versione e nomi di prodotto con maiuscole anomale vanno scritti come dovrebbero essere pronunciati.
Controlla il ritmo sulla timeline
Distribuisci il copione in blocchi temporali in base alla durata target:
0–5s    gancio: affermazione o problema
5–20s   corpo: il meccanismo, due o tre frasi
20–28s  dettaglio: un numero o esempio da ricordare
28–30s  chiusura: un'unica call to action
Questa struttura a blocchi funge anche da artefatto di revisione: i revisori possono bocciare un blocco senza che tu debba rieseguire il rendering di nulla. Tieni il copione di ogni clip in un file separato, versionato insieme al codice che lo renderizza, e il ciclo batch della sezione successiva diventa completamente riproducibile.
Impostare proporzioni, durata e output
Decidi orientamento e lunghezza in base alla piattaforma di destinazione prima del primo rendering. Rieseguire il rendering di una clip finita in un secondo orientamento è puro spreco, e rimontare una clip troppo lunga significa rigenerare anche l'audio.
Proporzioni
- 9:16 verticale — il formato predefinito per i feed di video brevi: shorts, reel, storie e posizionamenti mobile-first. Progetta la composizione per questo formato per primo; ritaglia gli altri formati da un master verticale quando possibile.
- 16:9 orizzontale — player incorporati, landing page, video di documentazione e presentazioni.
- 1:1 quadrato — posizionamenti nei feed che preferiscono il quadrato. Utile come variante secondaria.
Se la tua campagna richiede due orientamenti, trattali come due attività distinte con copioni diversi, non come lo stesso copione renderizzato due volte: una battuta adatta a un verticale di 30 secondi spesso lascia dei vuoti in un montaggio quadrato più breve.
Durata
Imposta la durata in base al budget del copione della sezione precedente, non il contrario. Passa una durata che corrisponda alla lunghezza effettiva della lettura; una clip riempita o troncata a metà frase sembra rotta. Metti gli obiettivi delle varie piattaforme in configurazione, così sono facili da modificare:
TARGETS = {
    "vertical": {"aspect_ratio": "9:16", "duration": 30},
    "horizontal": {"aspect_ratio": "16:9", "duration": 45},
}
Output
Scarica e archivia tu stesso le clip finite, invece di affidarti a URL temporanei dei risultati. Una convenzione semplice — {clip_id}-{orientation}-{version}.mp4 — mantiene tracciabili le varianti e rende evidenti i file obsoleti. Registra l'identificatore del job insieme al file, così ogni clip può essere ricondotta alla sua richiesta esatta.
La fatturazione si basa sulle generazioni richieste, in base a durata e numero di clip, quindi ridurre il copione prima del rendering è l'ottimizzazione più economica a tua disposizione. Le tariffe attuali sono nel pannello dei prezzi.
Generare più clip in batch
Con una funzione funzionante, il batch è un ciclo su una lista di attività. Il punto chiave è che ogni attività è la descrizione completa di una clip.
JOBS = [
    {"id": "launch-vertical", "script_file": "scripts/launch.txt",
     "voice": "<voice_a>", "aspect_ratio": "9:16", "duration": 30},
    {"id": "launch-square", "script_file": "scripts/launch_sq.txt",
     "voice": "<voice_a>", "aspect_ratio": "1:1", "duration": 20},
    {"id": "changelog-vertical", "script_file": "scripts/changelog.txt",
     "voice": "<voice_b>", "aspect_ratio": "9:16", "duration": 30},
]

results = []
for job in JOBS:
    with open(job["script_file"]) as f:
        script = f.read().strip()
    print(f"invio di {job['id']} ({len(script.split())} parole)")
    resp = generate_clip(
        script=script,
        voice=job["voice"],
        aspect_ratio=job["aspect_ratio"],
        duration=job["duration"],
    )
    results.append({"id": job["id"], "job": resp})
Pattern da adottare:
- Copioni come file, non come stringhe letterali. Possono essere revisionati, confrontati e riutilizzati tra orientamenti diversi.
- Log del conteggio parole. Stampa il conteggio parole di ogni attività per individuare, prima di spendere per il rendering, i copioni che supereranno la durata.
- ID job stabili. Usali nei nomi dei file di output e nei log, così le clip fallite in venti esecuzioni sono identificabili.
- Fallimento soft, poi report. Avvolgi ogni invio in un try/except, raccogli i fallimenti e continua: un copione sbagliato non deve interrompere l'intero batch.
- Rispetta i limiti di velocità e la concorrenza. Inizia in serie; aggiungi un pool di thread di lavoro limitato solo dopo che l'esecuzione seriale è stabile.
- Persisti la lista dei risultati. Scrivi gli ID job in un file JSON, così un batch parzialmente completato può essere ripreso invece che riavviato.
Punti di errore comuni e verifiche
Questi sono i problemi che emergono per primi. Ognuno ha una verifica di isolamento a basso costo.
Errori di formato dell'input
Gli errori di schema sono il primo fallimento più comune. Verifica: esegui il comando curl originale con gli stessi identificatori. Se curl funziona e Python fallisce, il bug è nella serializzazione: spesso un disallineamento di tipo, ad esempio una stringa passata dove serve duration intero, o un newline in più alla fine del file del copione.
Audio e copione non corrispondenti
Se la voce dice qualcosa di diverso da ciò che dovrebbe apparire sullo schermo, o la clip è muta, il gruppo audio è sbagliato. Verifica: controlla se la richiesta è guidata dal testo o da una traccia audio e assicurati di aver passato il campo corretto. Fornire sia la traccia audio che il campo del copione è un tipico conflitto silenzioso: decidi quale ha la precedenza e rimuovi l'altro.
Orientamento errato o bande nere
La clip arriva con bande nere o una cornice inattesa. Verifica: assicurati che aspect_ratio sia effettivamente arrivato nel payload: un valore predefinito nella funzione potrebbe sovrascrivere silenziosamente quello che pensavi di aver passato. Registra il payload assemblato prima dell'invio.
Disallineamento della durata
La clip viene troncata a metà frase o ha una coda. Verifica: confronta il conteggio parole del copione con il budget di durata. Correggi il copione, non la durata, a meno che l'obiettivo stesso non sia sbagliato.
Deriva dell'avatar nella serie
Clip della stessa campagna sembrano avere presentatori diversi. Verifica: assicurati che l'identificatore dell'avatar digitale provenga da un'unica costante, non da una configurazione per singola attività.
Output troncato o mancante
Il job ha successo ma il file è incompleto. Verifica: prima di scaricare, assicurati che il job abbia raggiunto lo stato finale di successo e che tu abbia seguito il contratto di recupero nella pagina del modello, invece di indovinare l'URL.
Regola generale: una clip di test, una richiesta curl, una variabile alla volta. Fai prima un breve rendering verticale con heygen-avatar-iv, verificalo end-to-end, poi lascia che il ciclo si espanda.
Articoli correlati
Vedi tutti gli articoli →-

Guida all'uso
Guida introduttiva a gpt-6.2-sol: limiti delle capacità, integrazione API e note sui prezzi per token
Punti decisionali e pratici per l'integrazione rivolti ai team di ingegneria
-

Guida all'uso
Guida introduttiva a gpt-6.2-astra: confini delle capacità del modello testuale, punti di integrazione e controllo dei costi
-

Guida all'uso
Guida introduttiva a Tripo H3.1: come scegliere tra tre modalità di input, parametri e prezzi
Guida pratica per sviluppatori: decisioni di integrazione e controllo dei costi nella generazione 3D