
Guida all'uso
Guida introduttiva a Vidu Q3 Mix reference-to-video: confini delle capacità, parametri API e aspetti di fatturazione
Prospettiva decisionale e operativa sull'integrazione per sviluppatori
In questa pagina
Quale problema risolve questo modello
La forma di input di un modello di generazione video determina se puoi tenere il "controllo" nelle tue mani. Il text-to-video fornisce solo un prompt e l'andamento delle immagini è lasciato libero al modello; l'image-to-video fornisce un primo fotogramma e il modello si occupa di "muoverlo". Il reference-to-video segue invece una terza strada: fornisci materiale di riferimento e il modello lo consulta continuamente durante la generazione, anziché trattarlo solo come primo fotogramma.
vidu-q3-mix/reference-to-video si colloca proprio in questo ramo. È adatto a esigenze come queste:
- Il personaggio o il soggetto deve rimanere coerente tra inquadrature diverse: non hai materiale video già pronto, ma hai una o più immagini di riferimento che rappresentano l'aspetto del soggetto e vuoi che nel video finale il soggetto "sembri ancora lui".
- Lo stile e il tono devono essere ancorati: il materiale di riferimento trasmette luce, materiali e tendenze compositive; il video finale riprende questo linguaggio visivo, in modo più controllabile rispetto alla sola descrizione testuale.
- Creare contenuti dinamici partendo da asset statici: prodotti e-commerce, personaggi IP, bozzetti di concept design e altre immagini già disponibili da trasformare in brevi video.
In altre parole, se la tua esigenza è "dammi un video qualsiasi che corrisponda alla descrizione", il text-to-video è più diretto; se la tua esigenza è "questo video deve somigliare a ciò che ti ho dato", il reference-to-video è lo strumento adatto. Al momento della scelta chiediti prima: ho un punto di ancoraggio visivo che deve essere preservato? Se sì, usa questo.
Su HiAPI.ai, questo modello condivide lo stesso contesto di chiamata degli altri modelli video: non devi costruire una logica di integrazione separata, e quando cambi modello ciò che cambia sono principalmente i parametri di capacità, non la struttura ingegneristica.
Differenza chiave rispetto all'image-to-video
L'immagine di input dell'image-to-video è il "punto di partenza", mentre l'input del reference-to-video è un "vincolo". Il primo fornisce al modello un'immagine che deve necessariamente continuare, il secondo gli fornisce un insieme di caratteristiche da rispettare. Compreso questo, tutte le successive valutazioni sulla preparazione del materiale e sull'ottimizzazione dei parametri diventeranno naturali.
Confini delle capacità e scenari non adatti
Delineare chiaramente il perimetro di capacità del modello è più importante che ricordare cosa supporta. Sulla base della definizione di capacità di reference-to-video, si possono stabilire i seguenti confini:
Ciò che copre
- Generazione di video con materiale di riferimento come base visiva: le caratteristiche dell'immagine di riferimento vengono introdotte nel processo di generazione.
- Coerenza del soggetto e continuità dello stile: espressione dell'aspetto relativamente stabile in generazioni multiple.
- Controllo dell'andamento dei contenuti tramite prompt: il materiale di riferimento si occupa del "somiglia o no", il prompt si occupa del "cosa fa".
Ciò che non copre
- Non è un sostituto del text-to-video: in assenza di materiale di riferimento, non dovresti scrivere prompt estremamente lunghi per "simulare" un'immagine di riferimento; è un uso errato dello strumento, con risultati e costi sfavorevoli.
- Non è uno strumento di replica rigorosa fotogramma per fotogramma: il reference-to-video non equivale ad animare con precisione l'immagine di riferimento, e non aspettarti che risponda di ogni singolo pixel dell'immagine di riferimento. Se la tua esigenza è "questa immagine deve muoversi esattamente com'è", l'image-to-video è più adatto.
- Non promette durata illimitata: il limite massimo di durata per singola generazione è quello dei parametri disponibili nell'interfaccia e nel pannello della piattaforma; non progettare il flusso di prodotto pensando "genero quanto voglio".
- Non sostituisce la post-produzione: sottotitoli, montaggio, concatenazione di più segmenti e missaggio audio restano compiti della tua pipeline.
L'errore di scelta più comune
L'uso improprio più tipico è considerare il reference-to-video un "image-to-video più economico". Le semantiche di input sono diverse e le aspettative di output anche: quando hai davvero bisogno di un primo fotogramma allineato rigorosamente, usando il reference-to-video ottieni spesso risultati "simili nello spirito ma diversi", e ripetere i tentativi non fa che amplificare i costi. Al contrario, quando hai bisogno di stabilità del soggetto tra più inquadrature, usando l'image-to-video con immagini fornite segmento per segmento è più facile incorrere in derive dell'aspetto.
La regola di scelta può essere semplificata in una frase: se vuoi un punto di partenza, scegli l'image-to-video; se vuoi un vincolo, scegli il reference-to-video.
Parametri API e punti chiave del flusso di chiamata
La complessità ingegneristica dell'integrazione di questo tipo di modello non risiede tanto nell'"inviare la richiesta", quanto nella "preparazione degli input" e nell'"organizzazione del flusso". L'intera catena può essere suddivisa in quattro fasi:
1. Preparazione del materiale di riferimento
Prima di avviare la chiamata, normalizza il materiale di riferimento: uniforma dimensioni e proporzioni, rimuovi filigrane ed elementi di sfondo superflui, assicurati che il soggetto sia nitido e l'illuminazione coerente. Solo se questo passo è solido ha senso la successiva messa a punto dei parametri.
2. Costruzione della richiesta
Una chiamata tipica richiede di organizzare tre tipi di informazioni nella richiesta:
- Identificatore di capacità: specificare l'uso di
vidu-q3-mix/reference-to-video, in modo che la richiesta ricada nel ramo di capacità corretto. - Materiale di riferimento: posizione o handle di upload dell'immagine di riferimento; i nomi esatti dei campi e le forme accettate sono quelli della documentazione dell'interfaccia.
- Descrizione di generazione: il prompt, che descrive azioni, movimento di camera, ritmo e atmosfera, anziché ripetere la descrizione dell'aspetto già presente nell'immagine di riferimento.
Per i nomi esatti dei campi, i campi obbligatori e i valori ammessi, fai riferimento alla documentazione dell'interfaccia e alla pagina di dettaglio del modello su HiAPI.ai. Questo articolo non inventa campi: al momento dell'integrazione, componi la richiesta secondo la documentazione.
3. Attività di generazione
La generazione video è intrinsecamente asincrona: dopo l'invio della richiesta viene restituito un identificatore di attività e il modello impiega del tempo per completare l'inferenza. Il tuo server dovrebbe disaccoppiare "invio" e "recupero del risultato", usando l'identificatore di attività per il polling o la ricezione di callback, anziché attendere all'interno di una richiesta sincrona.
4. Recupero del risultato e nuovo tentativo
Una volta ottenuto il risultato, esegui prima una verifica di usabilità (il file si decodifica correttamente, la durata è quella prevista), poi decidi se riprovare. Il ramo di retry deve avere un limite massimo e registrare la causa di ogni fallimento: questo è essenziale per stimare i costi.
Come scrivere il prompt
Nel reference-to-video, il prompt dovrebbe concentrarsi sulle "informazioni oltre l'immagine di riferimento": cosa deve fare il soggetto nell'inquadratura, come si muove la camera, come cambia l'ambiente. Spendere spazio ripetendo ciò che è già nell'immagine di riferimento è uno spreco comune. Più la descrizione è specifica e vicina a un'istruzione visiva eseguibile, più il risultato è stabile.
Stimare i costi con $0,1865/secondo
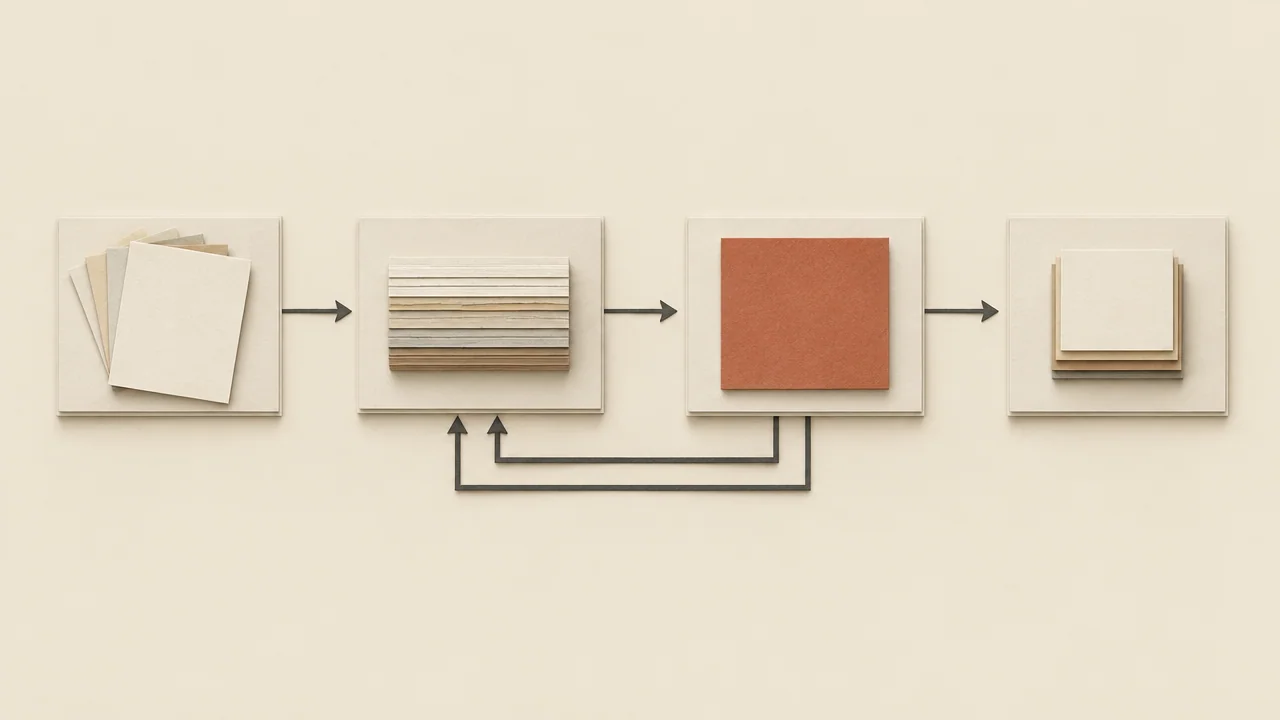
La modalità di fatturazione di questo modello è basata sui secondi del video di output, con un prezzo unitario di $0,1865 al secondo. Compreso questo, la stima dei costi diventa una semplice moltiplicazione.
Formula del costo per singolo video
costo singolo = durata output (secondi) × $0,1865
Un video finale di 5 secondi costa 5 × 0,1865; uno di 10 secondi costa 10 × 0,1865. Raddoppiando la durata, il costo raddoppia linearmente: non ci sono scaglioni né sconti impliciti del tipo "generare tutto in una volta conviene di più", quindi il budget di durata deve essere inserito nella progettazione del prodotto fin dall'inizio.
Includere i retry nel calcolo
Il costo reale non è mai "il prezzo di un video". La generazione presenta incertezza, e devi prevedere un budget di retry per fallimenti e risultati insoddisfacenti:
costo totale previsto = costo singolo × numero medio di tentativi
numero medio di tentativi ≈ 1 + tasso di retry
Ad esempio, se un'attività di generazione da 8 secondi richiede in media un retry per ottenere un risultato utilizzabile, il costo effettivo è 8 × 0,1865 × 2, non 8 × 0,1865. Per i team con un alto tasso di retry i costi si moltiplicano: è il costo nascosto che molti integratori scoprono solo dopo aver aumentato i volumi.
Tre leve per il controllo del budget
- Prima corto, poi lungo: in fase di debug usa la durata minima per verificare se prompt e materiale sono allineati, poi allunga dopo aver confermato l'efficacia. Il costo di sperimentazione dei video brevi è molto inferiore.
- Imposta un limite di retry: assegna a ogni attività un numero massimo di tentativi; oltre la soglia, intervieni manualmente o cambia il materiale, evitando che i retry automatici consumino il budget.
- Registra ogni chiamata: invia metriche su durata, presenza di retry e causa del fallimento. Senza questi dati non puoi distinguere se lo sforamento del budget derivi da problemi di prompt o di materiale.
I prezzi in tempo reale e le regole di fatturazione dettagliate sono quelli del pannello prezzi del sito HiAPI.ai; questo articolo discute solo i metodi di stima.
Preparazione e ottimizzazione del materiale di riferimento
In questa catena del reference-to-video, l'impatto della qualità del materiale sul video finale è solitamente maggiore della messa a punto dei parametri. Il motivo è che i parametri regolano la "tendenza" del modello, mentre il materiale determina la "base". Se la base non è chiara, nessuna tendenza, per quanto buona, può concretizzarsi.
Che tipo di materiale di riferimento è buono
- Soggetto chiaro: lo spettatore capisce in mezzo secondo "cosa va conservato" nell'immagine. Sfondi disordinati e soggetti troppo piccoli indeboliscono l'effetto del riferimento.
- Caratteristiche stabili: l'aspetto dello stesso soggetto dovrebbe essere coerente tra le diverse immagini di riferimento. Se più immagini di riferimento sono già in contraddizione tra loro (colori, forme, materiali incoerenti), il modello può solo oscillare tra le varie versioni.
- Illuminazione e angolazione ragionevoli: illuminazioni estreme e angolazioni fortemente distorte trasmettono al modello indizi visivi errati.
- Pulito: rimuovi filigrane, adesivi e testi superflui. Questi elementi potrebbero essere adottati insieme come caratteristiche del soggetto.
Priorità di ottimizzazione
Quando il risultato non è soddisfacente, si consiglia di indagare in questo ordine, anziché mettere subito mano ai parametri:
- Prima cambia il materiale: sostituire l'immagine di riferimento con una versione più nitida e con un soggetto più unico è spesso il mezzo di miglioramento più rapido.
- Poi modifica il prompt: esplicita azione e ambiente, elimina le descrizioni ridondanti rispetto all'immagine di riferimento.
- Solo alla fine tocca i parametri: valuta la messa a punto dopo che i primi due passi sono stabili, e modifica una variabile alla volta per facilitare l'attribuzione.
Coerenza con più immagini di riferimento
Se fornisci più materiali di riferimento, assicurati che siano "lo stesso soggetto". Inserire immagini di individui diversi o di stili diversi è una delle cause più comuni di deriva del risultato. Meglio fornirne una in meno che una contraddittoria.
Costruire una base di materiale
Si consiglia di creare per i tuoi soggetti principali un set fisso di materiale di riferimento da usare come base per tutte le generazioni successive. Partendo ogni volta da questa base e modificando solo il prompt, puoi distinguere nettamente "problemi di materiale" e "problemi di descrizione", e rendere più uniforme lo stile tra più video.
Fallimenti comuni e direzioni di troubleshooting
La maggior parte dei problemi in fase di integrazione rientra in alcune categorie ricorrenti. Indagare nell'ordine seguente è di solito più rapido che riprovare alla cieca.
1. Richiesta rifiutata o errore di parametri
Verifica prima che l'identificatore di capacità sia corretto, che i campi obbligatori del materiale di riferimento siano presenti e che la forma del materiale sia accettata dall'interfaccia. I nomi dei campi sono quelli della documentazione: non indovinarli per esperienza.
2. Attività senza risultato per molto tempo
La generazione video è un'attività asincrona: verifica prima di recuperare il risultato tramite l'identificatore di attività, anziché attendere in una richiesta sincrona. Se si verifica davvero un timeout, controlla se il volume del materiale è troppo grande.
3. Il risultato "non somiglia" al materiale di riferimento
È il problema più frequente; l'ordine di indagine è: il materiale è nitido → sono state fornite immagini di riferimento contraddittorie → il prompt descrive contenuti in conflitto con l'immagine di riferimento. Nella maggior parte dei casi il modello non è inadeguato, ma il materiale non è all'altezza.
4. Il soggetto deriva tra più segmenti
La causa è di solito l'uso di materiale di riferimento diverso per ogni segmento, oppure descrizioni incoerenti del soggetto nel prompt di ciascun segmento. Fissare un set di materiale di base e uniformare la descrizione del soggetto migliora sensibilmente la situazione.
5. Azioni nell'inquadratura diverse dalle attese
Se il prompt manca di istruzioni chiare su azioni e camera, il modello può solo improvvisare. Scrivi chiaramente "cosa fare, come muoversi, dov'è la camera".
6. Costi superiori alle attese
Riesamina i log delle chiamate: la durata è stata impostata troppo lunga o il tasso di retry è troppo alto? Nel primo caso regola la strategia di durata lato prodotto; nel secondo torna a indagare su materiale e prompt.
Principio di base del troubleshooting
Modifica una sola variabile alla volta e conserva i log. Modificando contemporaneamente materiale e prompt, anche se il risultato migliora non saprai quale dei due ha funzionato, e la prossima volta che incontri un problema simile dovrai ricominciare da capo.
Checklist pre-integrazione e passi successivi
Prima di aumentare i volumi, si consiglia di verificare punto per punto la checklist seguente, per contenere i rischi nella fase di piccolo traffico.
Checklist pre-lancio
- Capacità adeguata: verifica che il tuo scenario richieda davvero il reference-to-video, non il text-to-video o l'image-to-video.
- Base di materiale pronta: il soggetto principale dispone di un set fisso e pulito di materiale di riferimento.
- Prompt templatizzati: la descrizione di azioni, camera e ambiente ha una struttura riutilizzabile, non improvvisata ogni volta.
- Catena asincrona funzionante: invio, polling o callback, verifica del risultato e retry in caso di fallimento sono tutti implementati e sottoposti a test di carico.
- Retry con limite: i retry automatici hanno un numero massimo di tentativi; oltre la soglia si passa alla coda manuale.
- Dashboard dei costi: registrando durata e numero di retry per chiamata, è possibile calcolare in qualsiasi momento la spesa effettiva.
- Strategia di durata definita: il prodotto impone vincoli sulla durata generabile, evitando che l'utente la allunghi arbitrariamente causando costi fuori controllo.
Dal piccolo traffico al volume
Il percorso consigliato è: eseguire prima end-to-end richieste costruite manualmente per verificare l'efficacia di materiale e prompt; poi eseguire piccoli lotti di prova con la durata minima, misurando tasso di retry e tasso di risultati utilizzabili; una volta confermata la stabilità delle metriche, aumentare gradualmente concorrenza e durata. Ogni passo deve mantenere la possibilità di rollback.
Metriche chiave
In fase di volume, ciò che va davvero monitorato sono il tasso di successo al primo tentativo e il numero medio di tentativi. Il primo determina l'esperienza utente, il secondo determina direttamente i costi. Solo dopo aver stabilizzato queste due metriche ha senso parlare di espansione di durata e concorrenza.
Se non hai ancora iniziato, puoi prima consultare su HiAPI.ai i dettagli del modello e il prezzo in tempo reale di vidu-q3-mix/reference-to-video, e poi decidere quanto lungo generare il primo video.
Articoli correlati
Vedi tutti gli articoli →-

Guida all'uso
Guida introduttiva a gpt-6.2-sol: limiti delle capacità, integrazione API e note sui prezzi per token
Punti decisionali e pratici per l'integrazione rivolti ai team di ingegneria
-

Guida all'uso
Guida introduttiva a gpt-6.2-astra: confini delle capacità del modello testuale, punti di integrazione e controllo dei costi
-

Guida all'uso
Guida introduttiva a Tripo H3.1: come scegliere tra tre modalità di input, parametri e prezzi
Guida pratica per sviluppatori: decisioni di integrazione e controllo dei costi nella generazione 3D