
Guia de uso
Guia de introdução ao gemini-4-hydrogen: limites de capacidade, parâmetros essenciais e práticas de integração
Referência de integração e seleção de modelos de texto para equipes de engenharia
Nesta página
Posicionamento e limites de capacidade do gemini-4-hydrogen
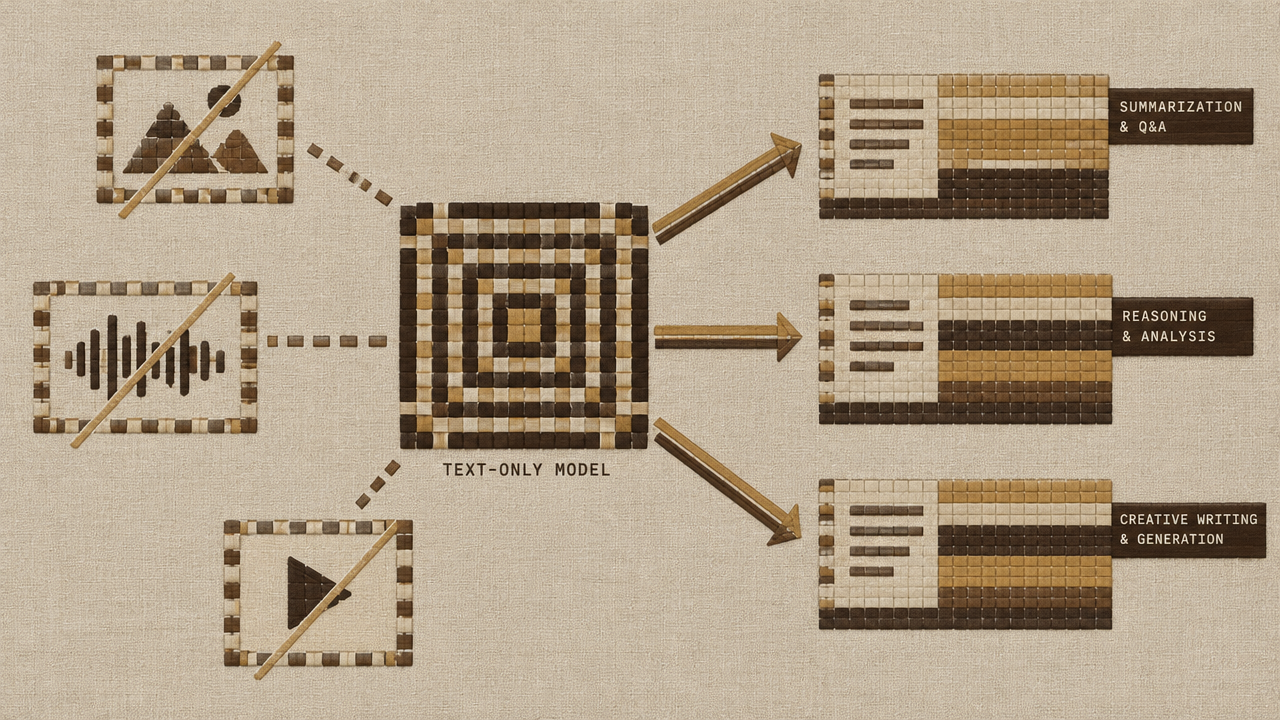
gemini-4-hydrogen é um modelo de texto lançado pelo Google. Seu tipo de saída é texto puro — isso determina onde você deve colocá-lo na arquitetura: em etapas de entrada de texto e saída de texto, e não como parte de um pipeline multimodal.
No que ele se destaca
Da perspectiva de engenharia, os pontos de aplicação mais típicos de um modelo com saída em texto puro são aquelas tarefas em que «o produto intermediário é um trecho de texto»:
- Extração e conversão estruturada: converter texto não estruturado em formatos acordados como JSON, linhas de tabela ou listas de campos;
- Resumo e reescrita: compressão de documentos longos, ajuste de tom, unificação de expressões em vários idiomas;
- Classificação e decisão: identificação de intenção, classificação de conteúdo, roteamento de tickets, trocando saídas curtas por baixa latência;
- Auxílio em tarefas generativas: redação de rascunhos, complemento de comentários de código, expansão de prompts e outras etapas anteriores à revisão humana;
- Diálogo e perguntas e respostas: organização de respostas com base em contexto de recuperação.
A característica comum dessas tarefas é: a entrada pode ser serializada como texto, a saída pode ser analisada por programas downstream e o resultado pode ser verificado por amostragem.
Para que ele não serve
Ainda sob a ótica de engenharia, é preciso delimitar as fronteiras com antecedência:
- Não espere que ele produza diretamente imagens, áudio ou vídeo. A forma de saída é texto; cadeias que envolvem geração multimodal precisam ser montadas em outro lugar;
- Não o trate como uma calculadora de alta determinabilidade. Cálculos aritméticos precisos e validação de regras rígidas devem ficar a cargo do código, não do modelo;
- Não deixe que ele faça afirmações factuais sem contexto. Em cenários que exigem conhecimento externo, primeiro coloque o material na entrada por meio de recuperação e depois deixe que ele organize a resposta;
- Não o trate como fonte única de informação sobre eventos em tempo real. O conhecimento interno do modelo tem um limite temporal; conteúdos com alta exigência de atualidade precisam ser injetados pelo seu sistema.
Registrar esses pontos no documento de design da equipe é muito mais barato do que corrigir problemas depois com remendos no downstream.
Pontos a confirmar antes da integração
Antes de escrever a primeira linha de código de chamada, vale a pena confirmar algumas coisas; caso contrário, a fase de depuração terá muitas investigações inúteis.
Definir o formato da tarefa e o contrato de saída
Responda primeiro a três perguntas: a entrada é de turno único ou de múltiplos turnos? A saída é texto livre ou precisa obedecer a alguma estrutura? Em caso de falha, o downstream tolera novas tentativas? Essas três respostas determinarão diretamente como você escreverá o prompt, como definirá o limite de comprimento da saída e como fará a validação.
Credenciais e ponto de entrada da chamada
Independentemente do modo de integração escolhido, você precisa de um conjunto de credenciais de API gerenciáveis e rotacionáveis, e não deve colocar credenciais no código front-end nem enviá-las ao repositório. A prática recomendada é: manter as credenciais em variáveis de ambiente do servidor ou em um serviço de gerenciamento de segredos, chamar o modelo de forma centralizada pelo back-end, e o front-end se comunicar apenas com o seu back-end. Isso evita vazamentos e também facilita cotas e auditoria por dimensão de negócio.
Rede e orçamento de timeout
O tempo de uma requisição a um modelo de texto varia com o comprimento da entrada e da saída. Antes de entrar em produção, defina: qual é o tempo máximo de resposta aceitável para o seu negócio? A partir disso, derive timeout de requisição, número de tentativas e estratégia de degradação. Muitos relatos de «modelo instável» são, na verdade, configurações de timeout incompatíveis com as expectativas do negócio.
Observabilidade antes da funcionalidade
Antes de escrever a lógica de negócio, defina os campos de log: ID da requisição, quantidade de tokens de entrada, quantidade de tokens de saída, tempo gasto, código de erro. Esses itens são praticamente indispensáveis para contabilidade de custos e localização de problemas mais adiante; adicioná-los depois costuma exigir alterações em uma rodada de código.
Conformidade e limites de dados
Confirme se o conteúdo que você vai enviar contém informações sensíveis, como dados pessoais dos usuários, chaves e documentos internos, e defina claramente quais campos devem ser mascarados antes de serem enviados ao modelo.
Parâmetros de chamada e pontos de organização da requisição
Uma chamada típica é composta de três partes: conteúdo de entrada, parâmetros de controle e resultado retornado. O que realmente afeta a qualidade do resultado e o custo costuma ser apenas alguns poucos parâmetros.
Como organizar o conteúdo de entrada
Pense na entrada em três camadas: «instrução + contexto + dados a processar»:
- A instrução vai no início, indicando o papel e o objetivo da tarefa;
- O contexto (materiais recuperados, histórico da conversa) vai no meio, com separação clara;
- Os dados a processar vão no final, próximos ao objeto sobre o qual a instrução deve atuar.
Em conversas de múltiplos turnos, mantenha apenas os últimos turnos em vez de empilhar histórico indefinidamente — quanto mais longo o histórico, maior o consumo na entrada, e o ruído dilui informações-chave. Para conteúdos que precisam de memória de longo prazo, recomenda-se gerar um resumo e injetá-lo, em vez de carregar o texto original por completo.
Parâmetros essenciais
- Limite de comprimento da saída: é o parâmetro mais facilmente negligenciado e que afeta ao mesmo tempo custo e experiência. Se for muito pequeno, a resposta será truncada; se for muito grande, o modelo terá espaço para «falar demais». Recomenda-se definir faixas por tipo de tarefa: valores bem pequenos para tarefas de classificação e limites maiores apenas para geração de textos longos.
- Parâmetros de amostragem como temperatura/top-p: para tarefas que exigem saída estável, como extração, classificação e conversão de formato, reduza a aleatoriedade; para geração de textos, pode-se abrir um pouco mais. Mantenha a consistência dentro do mesmo negócio para facilitar comparações de regressão.
- Condições de parada: se o downstream exige que a saída termine em um ponto específico (por exemplo, pegar apenas o primeiro bloco JSON), usar sequências de parada é mais confiável do que cortar depois com regex.
- Restrições de saída estruturada: quando for necessário que um programa faça a análise, informe na instrução os nomes dos campos, os tipos e exemplos, e deixe explícito «saída apenas em JSON, sem explicações adicionais».
Algumas experiências na organização de requisições
- Separe os prompts do código de negócio, transformando-os em modelos versionáveis para facilitar comparações A/B;
- Faça uma camada de fallback para a análise da saída: quando a análise falhar, registre o retorno original em vez de lançar erro diretamente ao usuário;
- Defina uma chave de idempotência para a mesma requisição, evitando cobrança duplicada e efeitos colaterais repetidos causados por novas tentativas;
- Em cenários de entrada longa, faça primeiro segmentação e filtragem, mantendo parágrafos irrelevantes fora do modelo — esta é a forma mais direta de economizar.
Como estimar e controlar o custo sob cobrança por token
gemini-4-hydrogen cobra por token. Isso significa que seu custo é quase totalmente determinado por duas coisas: quantos tokens são enviados em cada requisição e quantos tokens o modelo devolve. Para valores de preço, consulte o painel de preços do site; aqui tratamos apenas do método.
Criar o hábito de estimar
Não estime por intuição. O procedimento é: primeiro rodar um lote de amostras reais, registrar a quantidade de tokens de entrada e de saída de cada requisição e agrupar por cenário de negócio para calcular média e percentis. Use «número médio de tokens × volume diário de chamadas» para obter uma estimativa de ordem de grandeza e depois use o P95 para ver o pior caso. Você vai perceber que as distribuições variam muito entre cenários, e estimar com uma média única costuma gerar desvios graves.
Ações concretas para controlar custos
- Comprimir a entrada: remover prompts de sistema repetidos, cortar contexto irrelevante e resumir documentos longos antes de enviá-los. A entrada costuma ser a maior parte do custo, e o ganho também é o mais direto;
- Limitar a saída: por meio do limite de comprimento da saída e de instruções como «responda de forma concisa», eliminar diretamente a saída redundante;
- Chamadas em níveis: resolver classificações simples e validação de formato com requisições pequenas, e fazer a chamada completa apenas quando realmente for necessária capacidade de geração;
- Cache e deduplicação: armazenar em cache resultados de requisições iguais ou muito semelhantes, especialmente em tarefas em lote e offline;
- Lote e assíncrono: acumular tarefas não em tempo real em lotes, reduzindo a parte fixa de custo repetido.
Transformar custo em indicador observável
Registre o consumo de tokens por linha de negócio nos logs e monte painéis de tendência diária/semanal. Quando o consumo sobe de forma anormal em um dia, normalmente há três tipos de causa: aumento do volume de chamadas, entrada mais longa (por exemplo, mudança na lógica de montagem de contexto) ou saída mais longa (por exemplo, mudança no prompt). Transformar esses três pontos em itens de monitoramento economiza muita investigação posterior.
Um último lembrete: a otimização de custos não deve sacrificar a qualidade da saída. Primeiro estabeleça um conjunto de avaliação, depois fale em compressão.
Integração em plataforma de API agregadora e comparação entre múltiplos modelos
Para a maioria das equipes, o maior custo na fase de seleção não é escrever código, mas «ter que refazer a camada de integração toda vez que se troca de modelo». Integrar por um ponto de entrada unificado reduz esse custo ao mínimo.
Vantagens da interface unificada
Em uma plataforma de API agregadora, a chamada dos modelos é unificada na mesma estrutura de requisição: o mesmo modo de autenticação, o mesmo formato de mensagens, a mesma lógica de análise de retorno. Ao trocar de modelo, normalmente só é preciso alterar o identificador do modelo, e o código de negócio praticamente não muda. O ganho direto disso é:
- A camada de integração é escrita uma única vez e compartilhada por vários modelos;
- Na fase de avaliação, é possível fazer comparações horizontais de baixo custo;
- Em produção, é possível fazer implantação gradual e rollback rápido — quando um modelo apresenta problema, basta alterar a configuração para migrar para a alternativa.
As informações de integração e disponibilidade desse modelo podem ser obtidas na página do modelo: /models/gemini-4-hydrogen.
Fazer uma comparação com as mesmas tarefas
Não olhe apenas os rankings. O procedimento é preparar um conjunto de avaliação próprio, cobrindo de 20 a 50 amostras da distribuição real do negócio, incluindo casos simples, casos de fronteira e casos de entrada longa, e então:
- Rodar vários modelos candidatos com o mesmo modelo de prompt;
- Registrar qualidade da saída (pontuação humana ou por regras), tempo gasto e consumo de tokens;
- Observar principalmente a taxa de aprovação e os modos de falha, em vez da média;
- Fazer atribuição nos casos com diferenças evidentes: é problema de aderência à instrução, problema de formato ou truncamento de contexto longo?
Estratégia de troca e coexistência
A conclusão da avaliação muitas vezes não é «usar um único modelo», mas «dividir por cenário». Por exemplo: usar um modelo de baixa latência para classificação e extração, e um modelo com melhor qualidade de saída para geração de textos longos. O ponto de entrada unificado permite expressar essa divisão na camada de configuração, sem precisar manter vários SDKs. Ao mesmo tempo, recomenda-se manter na camada de integração uma chave de configuração para o identificador do modelo, combinada com implantação gradual para liberar o tráfego aos poucos.
Checklist de validação antes do lançamento e solução de problemas comuns
Checklist de validação antes do lançamento
Execute estas etapas em ordem antes de considerar aumentar o tráfego:
- Teste de fumaça: uma requisição mínima retorna normalmente? Autenticação e rede estão funcionando?
- Validação de formato: em cenários de saída estruturada, qual é a taxa de sucesso de análise de um lote de amostras e como é o retorno quando a análise falha?
- Entradas de fronteira: como se comportam entradas muito longas, entradas vazias e entradas com caracteres especiais e vários idiomas?
- Comprimento da saída: no pior caso, a saída é truncada? Quando há truncamento, o downstream consegue identificar?
- Concorrência e timeout: sob a concorrência de pico esperada, as taxas de timeout e de erro são aceitáveis?
- Caminho de degradação: quando o modelo principal está indisponível, a cadeia de migrar para a alternativa ou retornar um resultado de fallback realmente funciona?
- Linha de base de custo: registrar o consumo de tokens em uma rodada de tráfego típico como referência para monitoramento posterior.
Problemas comuns e ordem de investigação
Timeout de requisição: primeiro verifique se a entrada está longa demais (especialmente se o documento inteiro foi incluído), depois se o limite de saída está grande demais e, por fim, confirme se o timeout do cliente e a política de novas tentativas são razoáveis. As novas tentativas devem ter backoff para evitar efeito avalanche.
Saída truncada: verifique o limite de comprimento da saída e se o prompt exige conteúdo longo demais; às vezes, uma configuração inadequada de sequência de parada faz a geração terminar antes da hora.
Saída instável, formato ora bom ora ruim: priorize reduzir a aleatoriedade da amostragem; em seguida, verifique se a instrução está clara (nomes de campos, tipos e exemplos estão completos); depois, verifique se há exemplos contraditórios misturados na entrada.
Conteúdo se desvia da instrução: a causa comum é um contexto longo demais que dilui a instrução-chave. Repetir a instrução no final da entrada uma vez ou comprimir o contexto costuma melhorar.
Aumento anormal de custo: faça a atribuição pelos três itens mencionados anteriormente — volume de chamadas, comprimento da entrada e comprimento da saída — comparando um a um com a tendência dos logs.
Resultado não reproduzível: registre os parâmetros da requisição e a versão do template; a saída do modelo em si tem aleatoriedade, não espere reproduzir palavra por palavra, e valide com base em regras ou pontuação humana.
Fixar este checklist no processo de release é muito mais estável do que improvisar a cada lançamento. Para detalhes específicos de seleção e integração, comece confirmando na página do modelo /models/gemini-4-hydrogen.
Artigos relacionados
Ver todos os artigos →-

Guia de uso
Guia de geração de imagens a partir de texto com o Nano Banana Basic: proporção, espaço em branco e uso de prompts
Use os campos aspect_ratio e prompt da API de tarefas para gerar imagens com composição clara para banners e cards sociais
-

Guia de uso
Kimi K3 na prática: tratamento de respostas, streaming interrompido e limites de retry
-

Guia de uso
GLM 5.3 na prática: extração estruturada com base textual para cada campo JSON
Extração de campos com o modo de objeto JSON: use valores ausentes, citações e validação de negócio para bloquear erros antes da gravação no banco