
Tutorial
Como chamar gpt-6-luna pela API do hiapi: curl, Python e requisições executáveis
Duas formas de integração, Chat Completions e Responses, com requisições testadas na prática de streaming, chamada de ferramentas, JSON estrito e níveis de raciocínio, além dos erros realmente reproduzidos.
TL;DR
- O que é: o mais recente modelo de texto econômico da OpenAI, projetado para processamento em lote e cenários de alto throughput. Já disponível no HiAPI, abra a página do modelo para conversar diretamente, novos usuários ganham 200 créditos ao se registrar.
- Quanto custa: cobrado por token, nível padrão entrada $0.025/M, saída $0.125/M, acerto de cache $0.0025/M, é o modelo de texto GPT mais barato no HiAPI.
- Como chamar a API: o protocolo padrão é a Responses API (
POST /v1/responses), também suporta Chat Completions (POST /v1/chat/completions). Contexto de 1.05M, saída máxima de 128K. - Parâmetros principais: seis níveis de esforço de raciocínio
reasoning.effort(none/low/medium/high/xhigh/max),temperature,top_p,text.format(json_schema).
O recém-lançado GPT-6 Luna gera duas perguntas mais frequentes: como chamar e qual a diferença em relação ao Chat Completions. As respostas estão todas neste artigo.
O que o GPT-6 Luna pode fazer?
- Classificação de texto em lote. Análise de avaliações de produtos, classificação de tickets, rotulagem de conteúdo, rodar cem mil itens com preço de entrada de $0.025/M não pesa no bolso.
- Extração de dados estruturados. Extrair JSON de textos não estruturados, basta configurar
text.formatcomjson_schemapara restringir a saída. - Reescrita e formatação de conteúdo. Redução de similaridade de artigos, polimento multilíngue, padronização de formato, rodar em lote com um único prompt resolve tudo.
- Respostas automáticas de FAQ. Atendimento de baixa complexidade, defina
reasoning.effort=nonepara desligar o raciocínio, rápido e econômico. - Loops simples de agent. Chamada de ferramentas + diálogo de múltiplos turnos, adequado para fluxos de automação que não exigem raciocínio profundo.
Duas rotas de introdução: teste online ou API?
Para ver o resultado primeiro, escolha o teste online; para integrar ao produto, escolha a API. As duas rotas usam o mesmo modelo e a mesma tabela de preços.
Teste online (cerca de 1 minuto)
- Abra a página do modelo GPT-6 Luna.
- Registre-se ou faça login, novas contas vêm com 200 créditos.
- Digite seu prompt diretamente e ajuste os parâmetros no Playground para ver o resultado.
Integração via API (cerca de 5 minutos)
- Crie uma API Key (
sk-...) no console do HiAPI. POST /v1/responsespara usar a Responses API (padrão) ouPOST /v1/chat/completionspara usar Chat Completions.- O resultado retornado fica em
output.
Primeira chamada: versão curl (Responses API, recomendada)
curl -s https://api.hiapi.ai/v1/responses \
  -H "Authorization: Bearer sk-YOUR_KEY" \
  -H "Content-Type: application/json" \
  -d '{
    "model": "gpt-6-luna",
    "input": [
      {"role": "user", "content": "用一句话介绍 HiAPI 是什么,用中文回复。"}
    ]
  }'
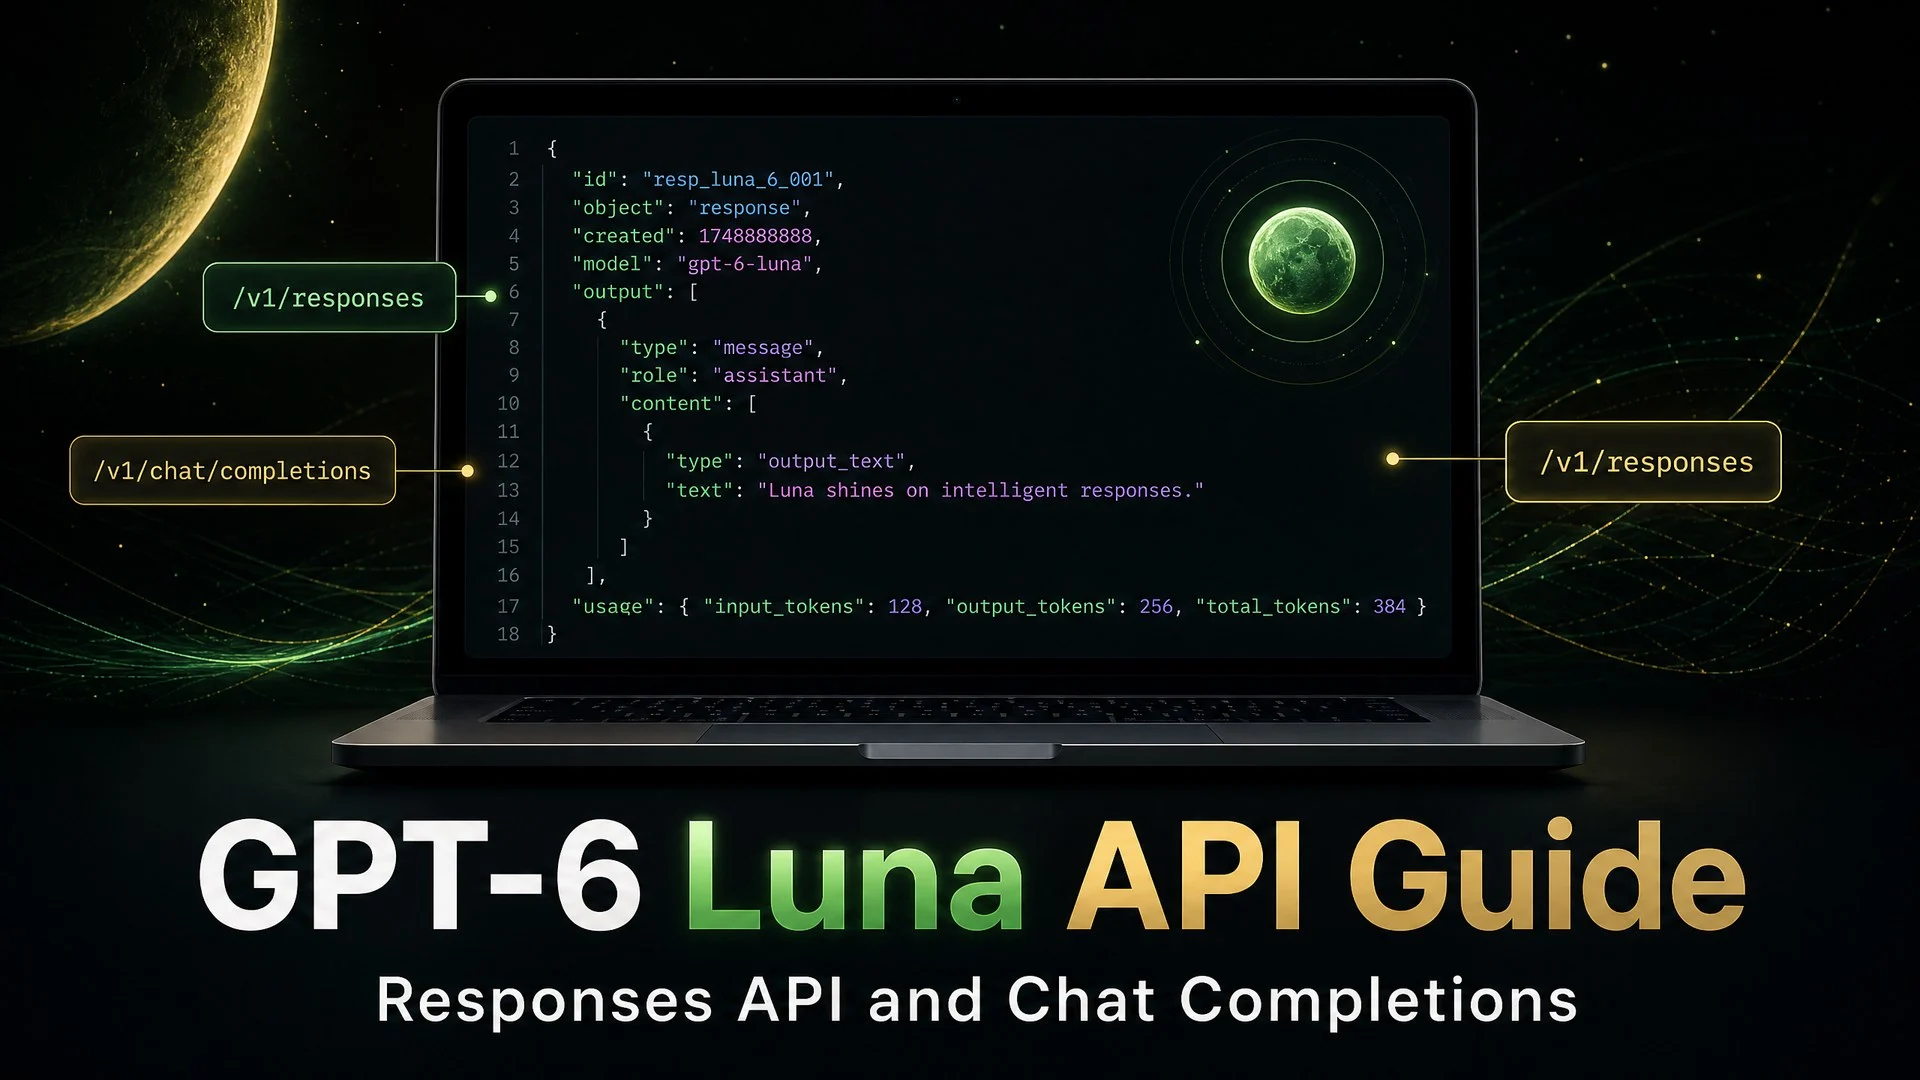
Exemplo de retorno abaixo, a resposta está em output[0].content[0].text:
{
  "id": "resp_...",
  "model": "gpt-6-luna",
  "output": [
    {
      "type": "message",
      "role": "assistant",
      "content": [
        {
          "type": "output_text",
          "text": "HiAPI 是一个聚合多种 AI 模型的 API 中间层平台..."
        }
      ]
    }
  ],
  "usage": {
    "input_tokens": 25,
    "output_tokens": 32,
    "total_tokens": 57
  }
}
Esta chamada consome 57 tokens, cerca de $0.0056 no nível padrão, praticamente sem custo.
Primeira chamada: versão Python (Responses API)
import requests

API = "https://api.hiapi.ai/v1/responses"
HEADERS = {
    "Authorization": "Bearer sk-YOUR_KEY",
    "Content-Type": "application/json"
}

payload = {
    "model": "gpt-6-luna",
    "input": [
        {"role": "user", "content": "用一句话介绍 HiAPI 是什么,用中文回复。"}
    ]
}

resp = requests.post(API, headers=HEADERS, json=payload, timeout=60)
data = resp.json()
text = data["output"][0]["content"][0]["text"]
usage = data["usage"]
print(f"回复: {text}")
print(f"消耗: {usage['total_tokens']} tokens (输入 {usage['input_tokens']} + 输出 {usage['output_tokens']})")
Forçar saída estruturada com json_schema
Este é o uso central do Luna em cenários de extração em lote. Defina text.format como json_schema, defina name e schema, e a saída do modelo seguirá estritamente a estrutura JSON que você especificar:
curl -s https://api.hiapi.ai/v1/responses \
  -H "Authorization: Bearer sk-YOUR_KEY" \
  -H "Content-Type: application/json" \
  -d '{
    "model": "gpt-6-luna",
    "input": [
      {
        "role": "user",
        "content": "产品评论:颜色好看,但用了两周底就掉了。不推荐。"
      }
    ],
    "text": {
      "format": {
        "type": "json_schema",
        "name": "review_analysis",
        "schema": {
          "type": "object",
          "properties": {
            "sentiment": {"type": "string", "enum": ["positive", "neutral", "negative"]},
            "pros": {"type": "array", "items": {"type": "string"}},
            "cons": {"type": "array", "items": {"type": "string"}},
            "recommend": {"type": "boolean"}
          },
          "required": ["sentiment", "pros", "cons", "recommend"]
        }
      }
    }
  }'
O modelo retornará um JSON compatível com o schema, sem necessidade de análise manual.
Interface alternativa Chat Completions
Se o seu código existente já usa o protocolo Chat Completions, basta trocar o model:
curl -s https://api.hiapi.ai/v1/chat/completions \
  -H "Authorization: Bearer sk-YOUR_KEY" \
  -H "Content-Type: application/json" \
  -d '{
    "model": "gpt-6-luna",
    "messages": [
      {"role": "user", "content": "用一句话介绍 HiAPI 是什么,用中文回复。"}
    ]
  }'
A Responses API é a recomendação padrão: o formato de entrada é um array input, suporta configuração de reasoning e saída estruturada com text.format. O Chat Completions não suporta max_completion_tokens nem max_tokens (o Luna nos dois protocolos usa apenas o formato input).
Parâmetros principais
| Parâmetro | Obrigatório | Descrição |
|---|---|---|
model |
Sim | gpt-6-luna |
input |
Sim | Array de mensagens, cada uma com role e content |
reasoning.effort |
Não | Esforço de raciocínio, seis níveis: none/low/medium(padrão)/high/xhigh/max |
temperature |
Não | Controla a aleatoriedade, ajustável quando reasoning.effort=none |
top_p |
Não | Amostragem de núcleo, ajustável quando reasoning.effort=none |
text.format |
Não | Controle do formato de saída, suporta json_schema e strict |
max_output_tokens |
Não | Número máximo de tokens de saída |
tools |
Não | Definição de ferramentas, para cenários de agent |
tool_choice |
Não | Estratégia de seleção de ferramentas |
Sobre o uso de reasoning.effort:
none: desliga o raciocínio, adequado para classificação, extração e perguntas e respostas simples. Neste caso,temperatureetop_ppodem ser ajustados livremente.low/medium(padrão): raciocínio leve a moderado, adequado para perguntas e respostas gerais e geração de conteúdo.high/xhigh/max: raciocínio profundo, para análises complexas. Atenção: quanto mais alto o nível, mais tokens de raciocínio são consumidos.
Para tarefas em lote, defina none; para conversas diárias, o padrão medium já basta; para análises complexas, aumente conforme necessário.
Erros comuns
- 400
model not found→ campomodelescrito errado → confirme que está escritogpt-6-luna. - 400
additional properties not allowed→ foi passado um campo não suportado (comomax_tokensdo Chat Completions) → remova os campos extras. - 401
permission_denied→ Key ausente ou incorreta → verifiqueAuthorization: Bearer sk-.... - 400
json_schema validation failed→ definição do schema fora do padrão → verifique o arrayrequirede otypede cada campo emproperties.
Perguntas frequentes
Devo usar Responses API ou Chat Completions?
Para novas integrações, use a Responses API. Ela suporta entrada em array input, reasoning.effort, saída json_schema com text.format e outros recursos novos. Se você já tem código com Chat Completions e não quer alterar, basta trocar o model para usar.
Qual a diferença entre reasoning.effort=none e desligar o raciocínio?
Com none, o modelo não gera tokens de raciocínio, a saída contém apenas o texto final da resposta. Nesse caso, temperature e top_p podem ser ajustados manualmente. Para cenários de classificação, extração e formatação, none já basta, economiza tokens e é mais rápido.
Como o cache funciona? Funciona automaticamente. As partes repetidas do system prompt e do histórico da conversa acertam o cache, cobrado apenas $0.0025/M. Não requer configuração extra.
Como usar o Batch para tarefas em lote?
Adicione "processing_mode": "batch" à requisição, a tarefa entra em uma fila assíncrona, com 50% de desconto no preço. Adequado para tarefas que não exigem resposta em tempo real.
O que mudou em relação ao gpt-5.6-luna? Preço reduzido pela metade (entrada $0.025 vs $0.05), saída 2,4 vezes mais barata, novo protocolo padrão Responses API, seis níveis de esforço de raciocínio (idêntico ao 6-luna, com os seis níveis completos), contexto ampliado para 1.05M. Veja mais em Comparativo GPT-6 Luna vs GPT-5.6 Luna.
Série de artigos sobre GPT-6 Luna
- Página do modelo GPT-6 Luna: conversa online, registro com 200 créditos de bônus
- Preço da API GPT-6 Luna: entrada $0.025/M, o GPT mais barato do HiAPI
- GPT-6 Luna vs GPT-5.6 Luna: preço pela metade, vale trocar?
- Exemplos de prompts do GPT-6 Luna: 5 cenários em lote para copiar diretamente
Experimente agora: copie o comando curl acima, substitua pela sua API Key e faça sua primeira chamada funcionar. Ou abra a página do modelo para conversar diretamente online.
Artigos relacionados
Ver todos os artigos →-

Tutorial
Casos do Recraft Creative Upscale: upscale de paisagens e aquarela
Veja as mudanças de textura na cabana, no lago e na cidade em aquarela, diferencie o resultado completo da prévia e verifique os detalhes redesenhados.
-

Tutorial
Chave de API da OpenAI inválida: diagnóstico de 401, variáveis de ambiente e configuração de projeto
Diferencie 401, 403 e 429 da OpenAI, verifique variáveis de ambiente e configurações de organização e projeto, e valide as credenciais com uma requisição somente leitura.
-

Tutorial
Coleção de prompts do Kling 4.0: 6 cenas para copiar e gerar vídeos diretamente
Produto de e-commerce, comida, paisagem de viagem, cena cotidiana, plano vazio com som e imagem para vídeo: cada cena traz um vídeo real, o prompt completo e um link de preenchimento com um clique.