
チュートリアル
hiapi API で gpt-6-luna を呼び出す方法:curl、Python、実行可能なリクエスト
Chat Completions と Responses の2つの接続方法、ストリーミング、ツール呼び出し、厳格な JSON、推論レベルの実測リクエスト、そして実際に再現したエラー。
TL;DR
- これは何か:OpenAI の最新の低コストテキストモデルで、バッチ処理と高スループットのシナリオ向けに設計されています。すでに HiAPI で提供開始しており、モデルページを開く と直接対話できます。新規ユーザー登録で 200 クレジットを進呈。
- 料金:token 課金で、標準ティアの入力 $0.025/M、出力 $0.125/M、キャッシュヒット $0.0025/M。HiAPI 上で最も安い GPT テキストモデルです。
- API の呼び出し方:デフォルトのプロトコルは Responses API(
POST /v1/responses)で、Chat Completions(POST /v1/chat/completions)にも対応しています。コンテキスト 1.05M、最大出力 128K。 - 主要パラメータ:6段階の推論強度
reasoning.effort(none/low/medium/high/xhigh/max)、temperature、top_p、text.format(json_schema)。
登場したばかりの GPT-6 Luna について、最も多く聞かれるのは2つ:どう呼び出すか、Chat Completions と何が違うか。その答えはすべてこの記事にあります。
GPT-6 Luna にできること
- バッチテキスト分類。 製品レビュー分析、チケット分類、コンテンツタグ付けなど、$0.025/M の入力価格なら10万件を処理しても負担になりません。
- 構造化データ抽出。 非構造化テキストから JSON を抽出し、
text.formatにjson_schemaを指定して出力を制約できます。 - コンテンツの書き換えと整形。 記事のリライト、多言語の推敲、フォーマットの統一など、1つの prompt で一括処理できます。
- FAQ の自動回答。 低複雑度のカスタマーサポート Q&A では、
reasoning.effort=noneに設定して推論をオフにすると、高速かつ低コストです。 - シンプルな agent ループ。 ツール呼び出し+マルチターン対話で、深い推論を必要としない自動化フローに適しています。
2つの導入ルート:オンライン試用か API か?
まず効果を確認するならオンライン試用、製品に組み込むなら API を選びます。どちらのルートも同じモデル、同じ価格体系です。
オンライン試用(約1分)
- GPT-6 Luna モデルページ を開きます。
- 登録またはログインします。新規アカウントには 200 クレジットが付与されます。
- そのまま prompt を入力し、Playground でパラメータを調整して効果を確認します。
API 接続(約5分)
- HiAPI コンソール で API Key(
sk-...)を作成します。 POST /v1/responsesで Responses API(デフォルト)、またはPOST /v1/chat/completionsで Chat Completions を使用します。- 返却結果は
outputに含まれます。
最初の呼び出し:curl 版(Responses API、推奨)
curl -s https://api.hiapi.ai/v1/responses \
  -H "Authorization: Bearer sk-YOUR_KEY" \
  -H "Content-Type: application/json" \
  -d '{
    "model": "gpt-6-luna",
    "input": [
      {"role": "user", "content": "HiAPI とは何かを一文で紹介し、中国語で回答してください。"}
    ]
  }'
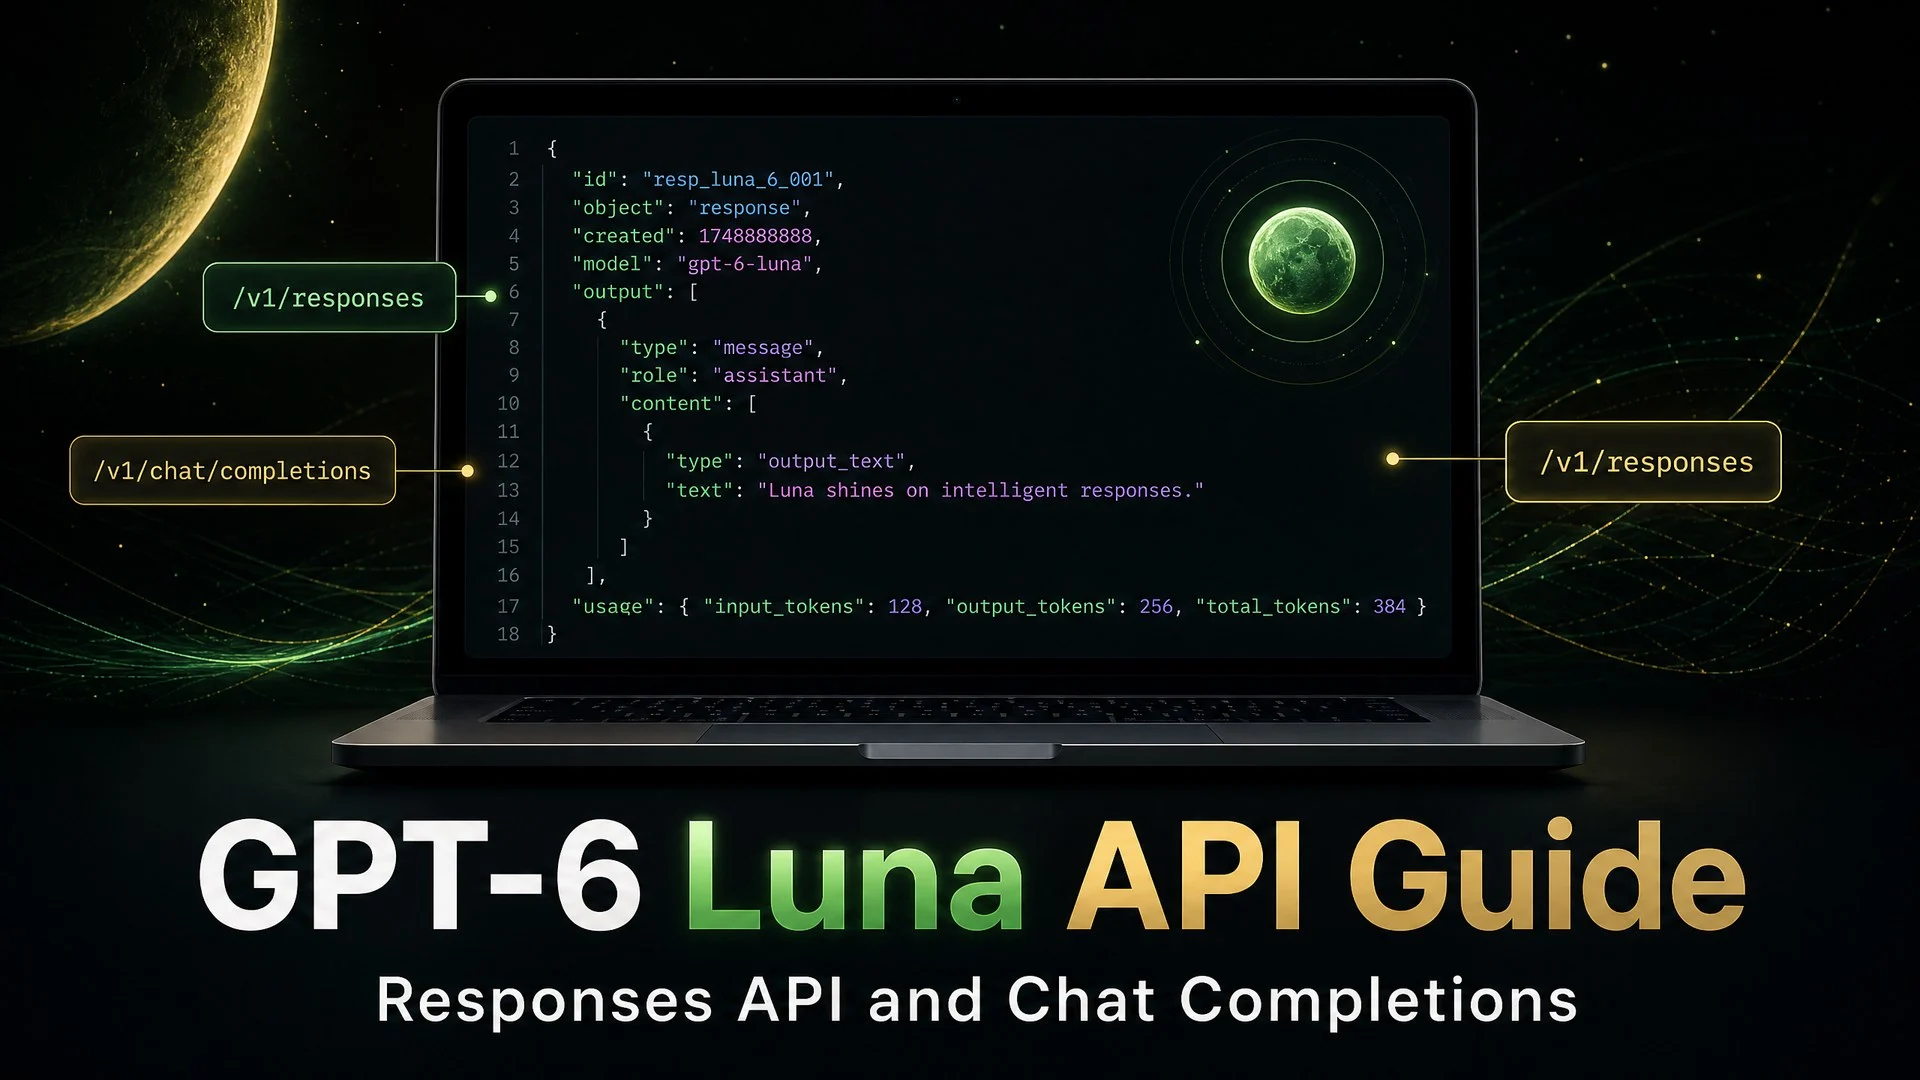
返却例は以下のとおりで、回答は output[0].content[0].text に含まれます:
{
  "id": "resp_...",
  "model": "gpt-6-luna",
  "output": [
    {
      "type": "message",
      "role": "assistant",
      "content": [
        {
          "type": "output_text",
          "text": "HiAPI は複数の AI モデルを集約する API 中間層プラットフォームです..."
        }
      ]
    }
  ],
  "usage": {
    "input_tokens": 25,
    "output_tokens": 32,
    "total_tokens": 57
  }
}
この呼び出しの消費は 57 token で、標準ティアでは約 $0.0056 と、ほとんど費用はかかりません。
最初の呼び出し:Python 版(Responses API)
import requests

API = "https://api.hiapi.ai/v1/responses"
HEADERS = {
    "Authorization": "Bearer sk-YOUR_KEY",
    "Content-Type": "application/json"
}

payload = {
    "model": "gpt-6-luna",
    "input": [
        {"role": "user", "content": "HiAPI とは何かを一文で紹介し、中国語で回答してください。"}
    ]
}

resp = requests.post(API, headers=HEADERS, json=payload, timeout=60)
data = resp.json()
text = data["output"][0]["content"][0]["text"]
usage = data["usage"]
print(f"返信: {text}")
print(f"消費: {usage['total_tokens']} tokens (入力 {usage['input_tokens']} + 出力 {usage['output_tokens']})")
json_schema で構造化出力を強制する
これはバッチ抽出シーンにおける Luna の核心的な使い方です。text.format を json_schema に設定し、name と schema を定義すると、モデルの出力は指定した JSON 構造に厳密に従います:
curl -s https://api.hiapi.ai/v1/responses \
  -H "Authorization: Bearer sk-YOUR_KEY" \
  -H "Content-Type: application/json" \
  -d '{
    "model": "gpt-6-luna",
    "input": [
      {
        "role": "user",
        "content": "製品レビュー:色はきれいだが、2週間使ったら底が取れた。おすすめしない。"
      }
    ],
    "text": {
      "format": {
        "type": "json_schema",
        "name": "review_analysis",
        "schema": {
          "type": "object",
          "properties": {
            "sentiment": {"type": "string", "enum": ["positive", "neutral", "negative"]},
            "pros": {"type": "array", "items": {"type": "string"}},
            "cons": {"type": "array", "items": {"type": "string"}},
            "recommend": {"type": "boolean"}
          },
          "required": ["sentiment", "pros", "cons", "recommend"]
        }
      }
    }
  }'
モデルは schema に準拠した JSON を返すため、手動での解析は不要です。
Chat Completions 代替インターフェース
既存のコードで Chat Completions プロトコルをすでに使用している場合は、model を切り替えるだけで使えます:
curl -s https://api.hiapi.ai/v1/chat/completions \
  -H "Authorization: Bearer sk-YOUR_KEY" \
  -H "Content-Type: application/json" \
  -d '{
    "model": "gpt-6-luna",
    "messages": [
      {"role": "user", "content": "HiAPI とは何かを一文で紹介し、中国語で回答してください。"}
    ]
  }'
Responses API がデフォルトの推奨です:入力形式は input 配列で、reasoning 設定や text.format による構造化出力に対応しています。Chat Completions は max_completion_tokens と max_tokens をサポートしていません(Luna はどちらのプロトコルでも input 形式のみを使用します)。
主要パラメータ
| パラメータ | 必須 | 説明 |
|---|---|---|
model |
はい | gpt-6-luna |
input |
はい | メッセージ配列で、各要素に role と content を含みます |
reasoning.effort |
いいえ | 推論強度、6段階:none/low/medium(デフォルト)/high/xhigh/max |
temperature |
いいえ | ランダム性を制御、reasoning.effort=none のときに調整可能 |
top_p |
いいえ | 核サンプリング、reasoning.effort=none のときに調整可能 |
text.format |
いいえ | 出力形式の制御、json_schema と strict に対応 |
max_output_tokens |
いいえ | 最大出力 token 数 |
tools |
いいえ | ツール定義、agent シーンで使用 |
tool_choice |
いいえ | ツール選択ポリシー |
reasoning.effort の使い方について:
none:推論をオフにします。分類、抽出、簡単な Q&A に適しています。このときtemperatureとtop_pを自由に調整できます。low/medium(デフォルト):軽度から中度の推論で、一般的な Q&A やコンテンツ生成に適しています。high/xhigh/max:深い推論で、複雑な分析に使用します。レベルが高いほど推論 token の消費が増える点に注意してください。
バッチタスクでは none を設定し、日常会話ではデフォルトの medium で十分、複雑な分析では必要に応じて引き上げます。
よくあるエラー
- 400
model not found→modelフィールドの綴り間違い →gpt-6-lunaと書かれているか確認してください。 - 400
additional properties not allowed→ サポートされていないフィールド(Chat Completions のmax_tokensなど)を送信している → 余分なフィールドを削除してください。 - 401
permission_denied→ Key の欠落または誤り →Authorization: Bearer sk-...を確認してください。 - 400
json_schema validation failed→ schema 定義が仕様に準拠していない →required配列とproperties内の各フィールドのtypeを確認してください。
よくある質問
Responses API と Chat Completions のどちらを使うべき?
新規接続には Responses API を使用してください。input 配列入力、reasoning.effort、text.format の json_schema などの新機能に対応しています。既存の Chat Completions コードを変更したくない場合は、model を切り替えるだけでも使用できます。
reasoning.effort=none と推論オフの違いは?
none を設定するとモデルは推論 token を生成せず、出力には最終的な返信テキストのみが含まれます。このとき temperature と top_p を手動で調整できます。分類、抽出、整形のシーンでは none で十分で、token を節約でき、速度も速くなります。
キャッシュはどうやって有効になる? 自動的に有効になります。システムプロンプトや対話履歴の重複部分がキャッシュにヒットし、$0.0025/M のみ課金されます。追加の設定は不要です。
バッチタスクはどうやって Batch を使う?
リクエストに "processing_mode": "batch" を追加すると、タスクは非同期キューに入り、価格は50%オフになります。リアルタイム応答が不要なタスクに適しています。
gpt-5.6-luna と比べて何が変わった? 価格は半額(入力 $0.025 対 $0.05)、出力は2.4倍感安、Responses API がデフォルトプロトコルとして新規追加、6段階の推論強度(6-luna と完全に一致し、6段階が揃っています)、コンテキストは 1.05M にアップグレード。詳細は GPT-6 Luna vs GPT-5.6 Luna 比較 をご覧ください。
GPT-6 Luna シリーズ記事
- GPT-6 Luna モデルページ:オンライン対話、登録で 200 クレジット進呈
- GPT-6 Luna API 価格:入力 $0.025/M、HiAPI で最も安い GPT
- GPT-6 Luna vs GPT-5.6 Luna:価格半額、乗り換えるべきか
- GPT-6 Luna プロンプト事例:そのままコピーできる5つのバッチシーン
今すぐ試す:上記の curl コマンドをコピーし、あなたの API Key に置き換えて、最初の呼び出しを成功させましょう。または モデルページを開く とオンラインで直接対話できます。
関連記事
すべての記事を見る →-

チュートリアル
Recraft Creative Upscale 事例:風景と水彩のアップスケール
山小屋、湖、水彩の町のテクスチャ変化を確認し、完全な結果とプレビューを区別して、描き直された細部をチェックします。
-

チュートリアル
OpenAI API キーが無効:401、環境変数とプロジェクト設定の調査
OpenAI の 401、403、429 を区別し、環境変数、組織とプロジェクトの設定を確認し、読み取り専用リクエストで認証情報を検証します。
-

チュートリアル
Kling 4.0 プロンプト大全:6つのシーンをそのままコピーして動画を生成
EC商品、グルメ、旅行風景、日常のワンシーン、音声付きの空撮カット、イメージ・トゥ・ビデオ。各シーンに実写動画、完全なプロンプト、ワンクリックで自動入力されるリンクをご用意。