
Tutoriale
Come chiamare gpt-6-luna tramite l'API hiapi: curl, Python e richieste funzionanti
Due modalità di integrazione, Chat Completions e Responses: richieste testate per streaming, tool calling, JSON rigoroso e livelli di ragionamento, più gli errori realmente riprodotti.
TL;DR
- Cos'è: il più recente modello testuale economico di OpenAI, progettato per elaborazione in batch e scenari ad alto throughput. Già disponibile su HiAPI: apri la pagina del modello per conversare direttamente, i nuovi utenti ricevono 200 crediti alla registrazione.
- Quanto costa: fatturazione a token, fascia standard input $0.025/M, output $0.125/M, cache hit $0.0025/M; è il modello GPT testuale più economico su HiAPI.
- Come chiamare l'API: il protocollo predefinito è Responses API (
POST /v1/responses), supporta anche Chat Completions (POST /v1/chat/completions). Contesto da 1.05M, output massimo 128K. - Parametri chiave: sei livelli di intensità di ragionamento
reasoning.effort(none/low/medium/high/xhigh/max),temperature,top_p,text.format(json_schema).
Del GPT-6 Luna appena lanciato, le due domande più frequenti sono: come si chiama e in cosa differisce da Chat Completions. Le risposte sono tutte in questo articolo.
Cosa può fare GPT-6 Luna?
- Classificazione testuale in batch. Analisi di recensioni di prodotti, categorizzazione di ticket, tagging di contenuti: con un prezzo di input di $0.025/M puoi processare centomila elementi senza preoccupazioni.
- Estrazione di dati strutturati. Estrarre JSON da testo non strutturato, impostando direttamente
text.formatconjson_schemaper vincolare l'output. - Riscrittura e formattazione di contenuti. Riduzione della similarità di articoli, rifinitura multilingue, uniformazione del formato: basta un solo prompt eseguito in batch.
- Risposte automatiche alle FAQ. Q&A di assistenza clienti a bassa complessità: imposta
reasoning.effort=noneper disattivare il ragionamento, è veloce ed economico. - Cicli di agent semplici. Tool calling + conversazione multi-turno, adatto a flussi di automazione che non richiedono ragionamento profondo.
Due percorsi per iniziare: prova online o API?
Per valutare prima i risultati scegli la prova online; per integrare nel prodotto scegli l'API. Entrambi i percorsi usano lo stesso modello e lo stesso listino prezzi.
Prova online (circa 1 minuto)
- Apri la pagina del modello GPT-6 Luna.
- Registrati o accedi: i nuovi account hanno 200 crediti inclusi.
- Inserisci direttamente il tuo prompt e regola i parametri nel Playground per vedere i risultati.
Integrazione via API (circa 5 minuti)
- Crea una API Key (
sk-...) nella console HiAPI. - Usa
POST /v1/responsesper Responses API (predefinita) oppurePOST /v1/chat/completionsper Chat Completions. - Il risultato restituito si trova in
output.
Prima chiamata: versione curl (Responses API, consigliata)
curl -s https://api.hiapi.ai/v1/responses \
  -H "Authorization: Bearer sk-YOUR_KEY" \
  -H "Content-Type: application/json" \
  -d '{
    "model": "gpt-6-luna",
    "input": [
      {"role": "user", "content": "用一句话介绍 HiAPI 是什么,用中文回复。"}
    ]
  }'
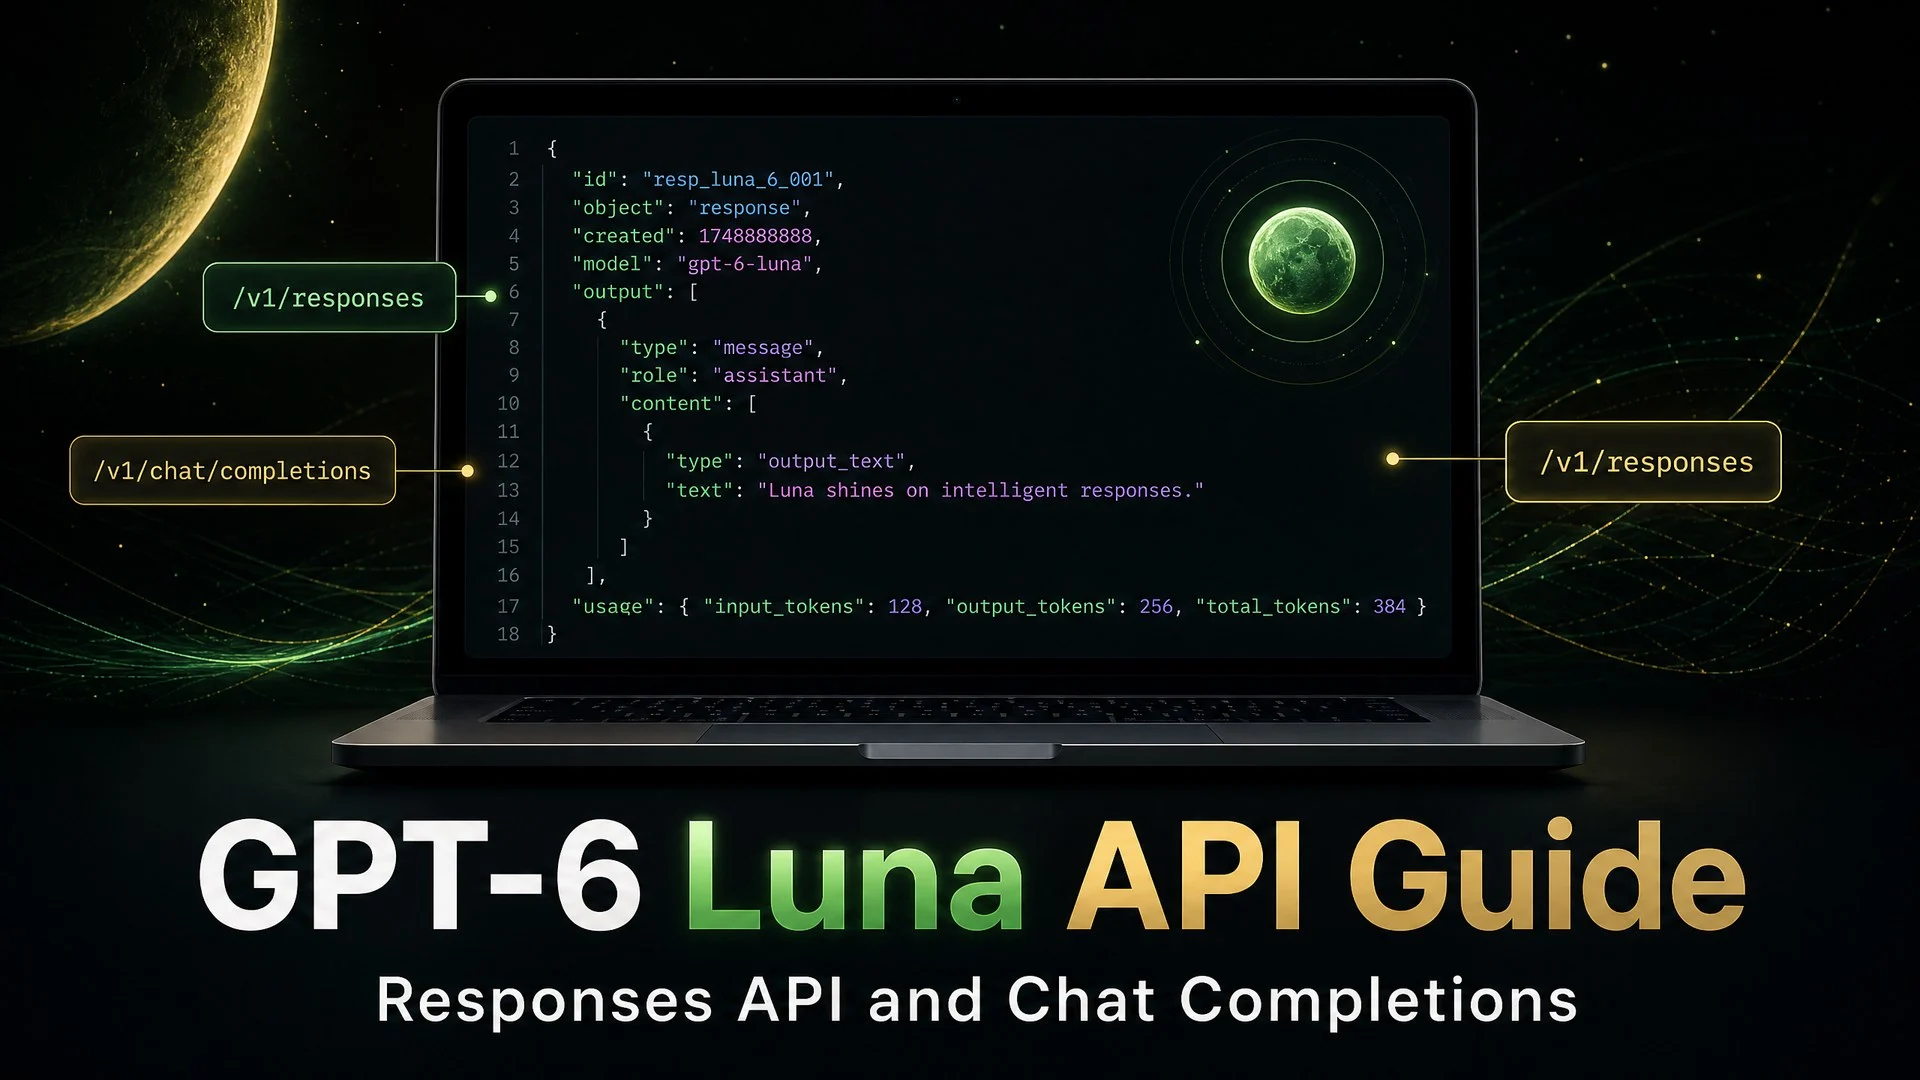
Di seguito un esempio di risposta, la risposta si trova in output[0].content[0].text:
{
  "id": "resp_...",
  "model": "gpt-6-luna",
  "output": [
    {
      "type": "message",
      "role": "assistant",
      "content": [
        {
          "type": "output_text",
          "text": "HiAPI è una piattaforma API intermedia che aggrega diversi modelli AI..."
        }
      ]
    }
  ],
  "usage": {
    "input_tokens": 25,
    "output_tokens": 32,
    "total_tokens": 57
  }
}
Questa chiamata consuma 57 token, circa $0.0056 in fascia standard: praticamente nulla.
Prima chiamata: versione Python (Responses API)
import requests

API = "https://api.hiapi.ai/v1/responses"
HEADERS = {
    "Authorization": "Bearer sk-YOUR_KEY",
    "Content-Type": "application/json"
}

payload = {
    "model": "gpt-6-luna",
    "input": [
        {"role": "user", "content": "用一句话介绍 HiAPI 是什么,用中文回复。"}
    ]
}

resp = requests.post(API, headers=HEADERS, json=payload, timeout=60)
data = resp.json()
text = data["output"][0]["content"][0]["text"]
usage = data["usage"]
print(f"回复: {text}")
print(f"消耗: {usage['total_tokens']} tokens (输入 {usage['input_tokens']} + 输出 {usage['output_tokens']})")
Forzare l'output strutturato con json_schema
Questo è l'uso centrale di Luna negli scenari di estrazione in batch. Imposta text.format su json_schema, definisci name e schema, e l'output del modello rispetterà rigorosamente la struttura JSON specificata:
curl -s https://api.hiapi.ai/v1/responses \
  -H "Authorization: Bearer sk-YOUR_KEY" \
  -H "Content-Type: application/json" \
  -d '{
    "model": "gpt-6-luna",
    "input": [
      {
        "role": "user",
        "content": "产品评论:颜色好看,但用了两周底就掉了。不推荐。"
      }
    ],
    "text": {
      "format": {
        "type": "json_schema",
        "name": "review_analysis",
        "schema": {
          "type": "object",
          "properties": {
            "sentiment": {"type": "string", "enum": ["positive", "neutral", "negative"]},
            "pros": {"type": "array", "items": {"type": "string"}},
            "cons": {"type": "array", "items": {"type": "string"}},
            "recommend": {"type": "boolean"}
          },
          "required": ["sentiment", "pros", "cons", "recommend"]
        }
      }
    }
  }'
Il modello restituirà un JSON conforme allo schema, senza bisogno di parsing manuale.
Interfaccia alternativa Chat Completions
Se il tuo codice esistente usa già il protocollo Chat Completions, basta cambiare model:
curl -s https://api.hiapi.ai/v1/chat/completions \
  -H "Authorization: Bearer sk-YOUR_KEY" \
  -H "Content-Type: application/json" \
  -d '{
    "model": "gpt-6-luna",
    "messages": [
      {"role": "user", "content": "用一句话介绍 HiAPI 是什么,用中文回复。"}
    ]
  }'
Responses API è quella consigliata per impostazione predefinita: il formato di input è l'array input, supporta la configurazione reasoning e l'output strutturato text.format. Chat Completions non supporta max_completion_tokens e max_tokens (Luna in entrambi i protocolli usa solo il formato input).
Parametri chiave
| Parametro | Obbligatorio | Descrizione |
|---|---|---|
model |
Sì | gpt-6-luna |
input |
Sì | Array di messaggi, ciascuno con role e content |
reasoning.effort |
No | Intensità di ragionamento, sei livelli: none/low/medium (predefinito)/high/xhigh/max |
temperature |
No | Controlla la casualità, regolabile quando reasoning.effort=none |
top_p |
No | Nucleus sampling, regolabile quando reasoning.effort=none |
text.format |
No | Controllo del formato di output, supporta json_schema e strict |
max_output_tokens |
No | Numero massimo di token di output |
tools |
No | Definizione degli strumenti, per scenari di agent |
tool_choice |
No | Strategia di selezione degli strumenti |
Come usare reasoning.effort:
none: disattiva il ragionamento, adatto a classificazione, estrazione e Q&A semplici. In questo caso puoi regolare liberamentetemperatureetop_p.low/medium(predefinito): ragionamento da leggero a moderato, adatto a domande generiche e generazione di contenuti.high/xhigh/max: ragionamento profondo, per analisi complesse. Attenzione: più alto è il livello, più token di ragionamento vengono consumati.
Per i task in batch imposta none; per le conversazioni quotidiane medium è sufficiente; per analisi complesse alza secondo necessità.
Errori comuni
- 400
model not found→ campomodelscritto male → verifica che siagpt-6-luna. - 400
additional properties not allowed→ è stato passato un campo non supportato (comemax_tokensdi Chat Completions) → rimuovi i campi superflui. - 401
permission_denied→ chiave mancante o errata → controllaAuthorization: Bearer sk-.... - 400
json_schema validation failed→ definizione dello schema non conforme → controlla l'arrayrequirede iltypedi ogni campo inproperties.
Domande frequenti
Meglio Responses API o Chat Completions?
Per nuove integrazioni usa Responses API. Supporta input tramite array input, reasoning.effort, text.format json_schema e altre novità. Se hai già codice con Chat Completions e non vuoi modificarlo, funziona anche cambiando solo il model.
Che differenza c'è tra reasoning.effort=none e disattivare il ragionamento?
Impostando none il modello non genera token di ragionamento e l'output contiene solo il testo della risposta finale. In questo caso temperature e top_p sono regolabili manualmente. Per classificazione, estrazione e formattazione none è sufficiente: risparmi token ed è più veloce.
Come funziona la cache? Si attiva automaticamente. Le parti ripetute nel system prompt e nella cronologia della conversazione colpiscono la cache e vengono fatturate a soli $0.0025/M. Non serve alcuna configurazione aggiuntiva.
Come si usa Batch per i task in batch?
Aggiungi "processing_mode": "batch" nella richiesta: il task entra in coda asincrona e il prezzo è scontato del 50%. Adatto a task che non richiedono risposta in tempo reale.
Cosa cambia rispetto a gpt-5.6-luna? Prezzo dimezzato (input $0.025 vs $0.05), output più economico di 2,4 volte, nuovo protocollo predefinito Responses API, sei livelli di intensità di ragionamento (identici a 6-luna, tutti e sei disponibili), contesto aumentato fino a 1.05M. Dettagli in Confronto GPT-6 Luna vs GPT-5.6 Luna.
Articoli della serie GPT-6 Luna
- Pagina del modello GPT-6 Luna: chat online, 200 crediti in omaggio alla registrazione
- Prezzi API GPT-6 Luna: input $0.025/M, il GPT più economico su HiAPI
- GPT-6 Luna vs GPT-5.6 Luna: prezzo dimezzato, conviene cambiare
- Esempi di prompt per GPT-6 Luna: 5 scenari batch da copiare direttamente
Provalo subito: copia il comando curl qui sopra, sostituisci la tua API Key ed esegui la prima chiamata. Oppure apri la pagina del modello per conversare direttamente online.
Articoli correlati
Vedi tutti gli articoli →-

Tutoriale
Casi di Recraft Creative Upscale: paesaggi e acquerelli ingranditi
Osserva le variazioni di texture su baita, lago e cittadina ad acquerello, distingui il risultato completo dall'anteprima e controlla i dettagli ridisegnati.
-

Tutoriale
Chiave API OpenAI non valida: 401, variabili d'ambiente e verifica della configurazione di progetto
Distingui gli errori 401, 403 e 429 di OpenAI, controlla variabili d'ambiente, impostazioni di organizzazione e progetto e verifica le credenziali con una richiesta in sola lettura.
-

Tutoriale
Raccolta completa di prompt per Kling 4.0: 6 scene da cui copiare direttamente per creare video
Prodotti e-commerce, cibo, paesaggi di viaggio, momenti di vita quotidiana, b-roll con audio e image-to-video: ogni scena ha un video reale, il prompt completo e un link con compilazione automatica con un clic.