
Tutorial
So rufen Sie gpt-6-luna über die hiapi API auf: curl, Python und lauffähige Anfragen
Zwei Integrationswege – Chat Completions und Responses – mit getesteten Anfragen zu Streaming, Tool-Aufrufen, striktem JSON und Reasoning-Stufen sowie tatsächlich reproduzierten Fehlermeldungen.
TL;DR
- Was ist es: Das neueste kostengünstige Textmodell von OpenAI, speziell für Batch-Verarbeitung und hohen Durchsatz entwickelt. Bereits auf HiAPI verfügbar; Modellseite öffnen und direkt chatten. Neue Nutzer erhalten bei der Registrierung 200 Guthabenpunkte.
- Was kostet es: Abrechnung pro Token; Standardstufe: Eingabe $0,025/M, Ausgabe $0,125/M, Cache-Treffer $0,0025/M – das günstigste GPT-Textmodell auf HiAPI.
- Wie ruft man die API auf: Standardprotokoll ist die Responses API (
POST /v1/responses), aber auch Chat Completions (POST /v1/chat/completions) wird unterstützt. 1,05 Mio. Kontext, max. 128K Ausgabe. - Wichtige Parameter: Sechs Reasoning-Stufen
reasoning.effort(none/low/medium/high/xhigh/max),temperature,top_p,text.format(json_schema).
Zum neu veröffentlichten GPT-6 Luna werden am häufigsten zwei Fragen gestellt: Wie ruft man es auf, und worin unterscheidet es sich von Chat Completions? Die Antworten finden Sie in diesem Artikel.
Was kann GPT-6 Luna?
- Batch-Textklassifikation. Produktbewertungsanalyse, Ticket-Kategorisierung, Content-Tagging – bei $0,025/M Eingabepreis sind auch 100.000 Einträge kein Problem.
- Strukturierte Datenextraktion. JSON aus unstrukturiertem Text extrahieren; legen Sie einfach
text.formatmitjson_schemafest, um die Ausgabe zu beschränken. - Inhaltsumschreibung und -formatierung. Artikel umformulieren, mehrsprachige Überarbeitung, Formatvereinheitlichung – ein Prompt für alles im Batch.
- Automatische FAQ-Antworten. Kundenservice-Fragen mit geringer Komplexität; setzen Sie
reasoning.effort=none, um das Reasoning abzuschalten – schnell und kostensparend. - Einfache Agent-Schleifen. Tool-Aufrufe + mehrstufige Dialoge, geeignet für Automatisierungsabläufe ohne tiefgehendes Reasoning.
Zwei Einstiegswege: Online testen oder API?
Zum Ausprobieren wählen Sie den Online-Test, für die Produktintegration die API. Beide Wege nutzen dasselbe Modell und dieselbe Preisstruktur.
Online testen (ca. 1 Minute)
- Öffnen Sie die GPT-6 Luna Modellseite.
- Registrieren oder anmelden – neue Konten erhalten 200 Guthabenpunkte.
- Geben Sie Ihren Prompt ein und passen Sie die Parameter im Playground an, um die Ergebnisse zu sehen.
API-Integration (ca. 5 Minuten)
- Erstellen Sie einen API Key (
sk-...) in der HiAPI-Konsole. POST /v1/responsesfür die Responses API (Standard) oderPOST /v1/chat/completionsfür Chat Completions.- Die Antwort finden Sie in
output.
Erster Aufruf: curl-Version (Responses API, empfohlen)
curl -s https://api.hiapi.ai/v1/responses \
  -H "Authorization: Bearer sk-YOUR_KEY" \
  -H "Content-Type: application/json" \
  -d '{
    "model": "gpt-6-luna",
    "input": [
      {"role": "user", "content": "Erkläre in einem Satz, was HiAPI ist, und antworte auf Deutsch."}
    ]
  }'
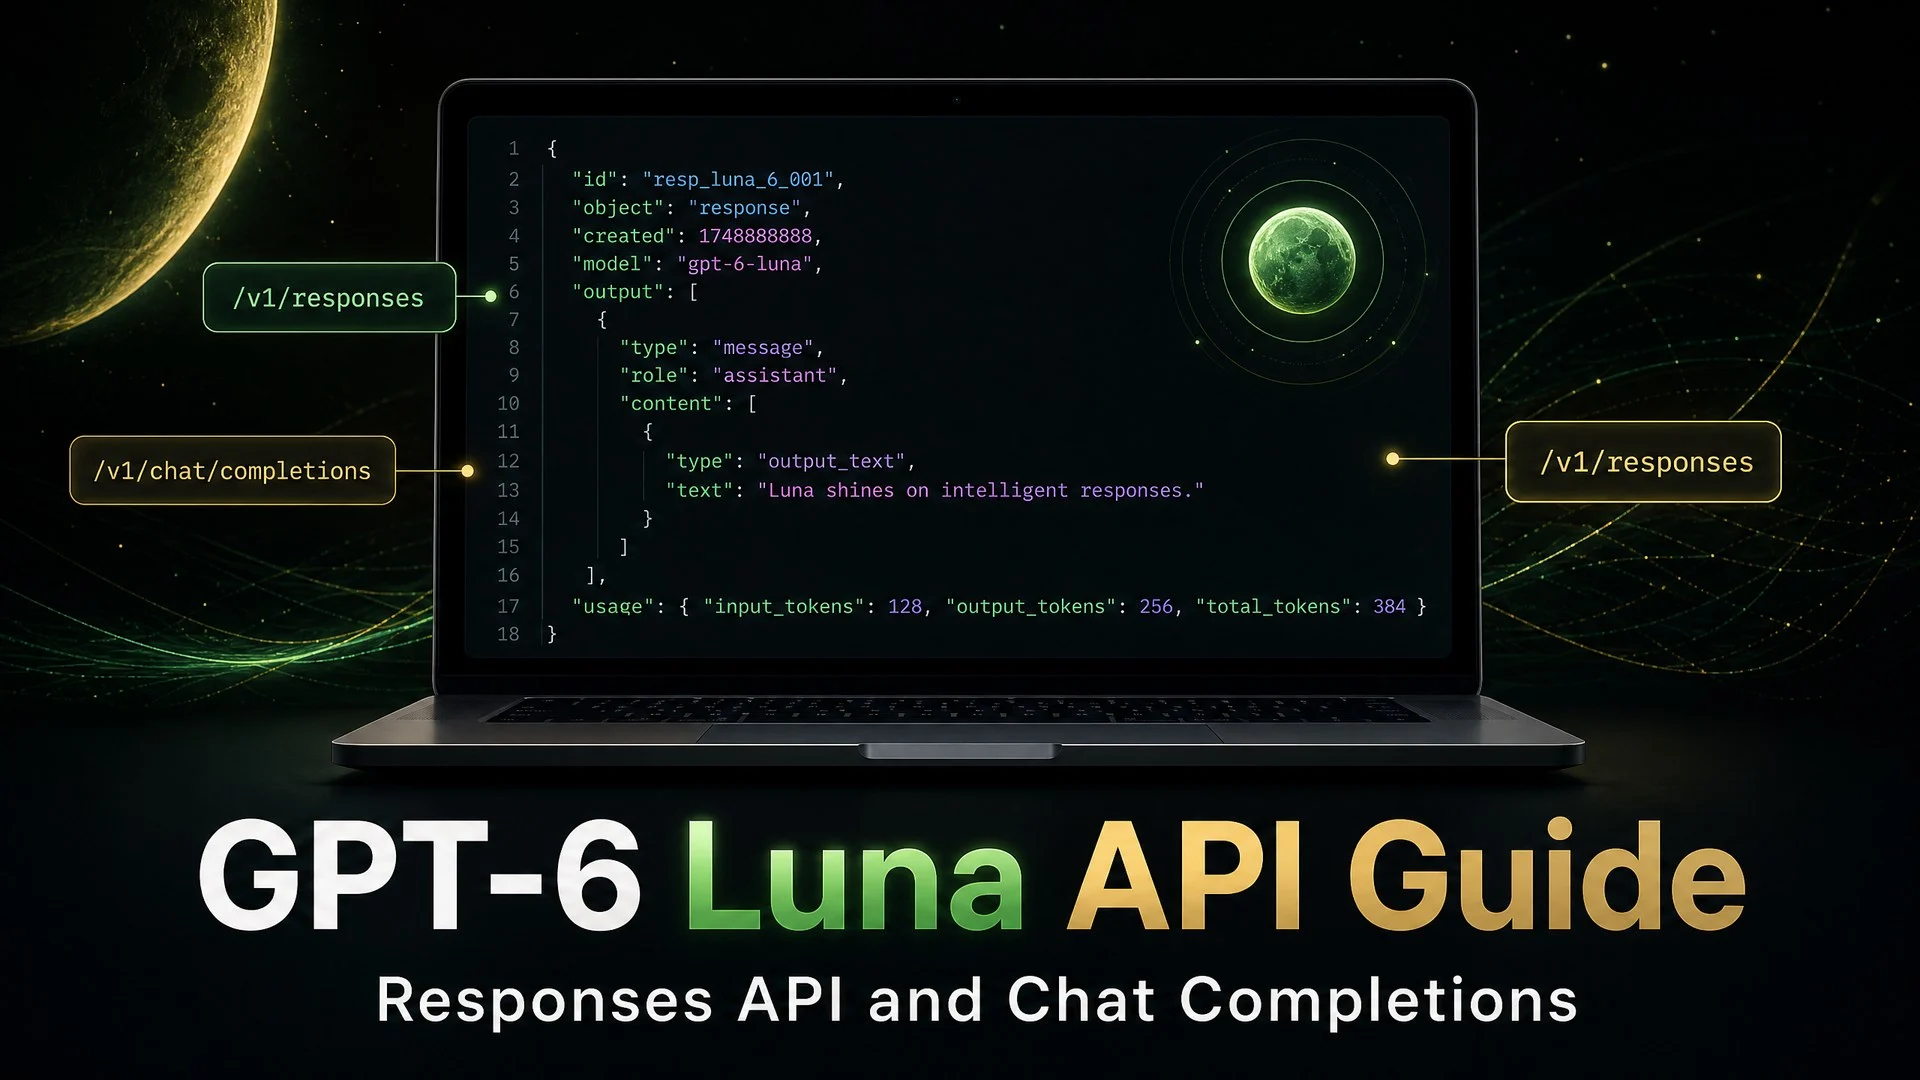
Beispielantwort: Die Antwort steht in output[0].content[0].text:
{
  "id": "resp_...",
  "model": "gpt-6-luna",
  "output": [
    {
      "type": "message",
      "role": "assistant",
      "content": [
        {
          "type": "output_text",
          "text": "HiAPI ist eine API-Zwischenschichtplattform, die verschiedene KI-Modelle bündelt..."
        }
      ]
    }
  ],
  "usage": {
    "input_tokens": 25,
    "output_tokens": 32,
    "total_tokens": 57
  }
}
Dieser Aufruf verbraucht 57 Token, was in der Standardstufe etwa $0,0056 entspricht – praktisch kostenlos.
Erster Aufruf: Python-Version (Responses API)
import requests

API = "https://api.hiapi.ai/v1/responses"
HEADERS = {
    "Authorization": "Bearer sk-YOUR_KEY",
    "Content-Type": "application/json"
}

payload = {
    "model": "gpt-6-luna",
    "input": [
        {"role": "user", "content": "Erkläre in einem Satz, was HiAPI ist, und antworte auf Deutsch."}
    ]
}

resp = requests.post(API, headers=HEADERS, json=payload, timeout=60)
data = resp.json()
text = data["output"][0]["content"][0]["text"]
usage = data["usage"]
print(f"Antwort: {text}")
print(f"Verbrauch: {usage['total_tokens']} Tokens (Eingabe {usage['input_tokens']} + Ausgabe {usage['output_tokens']})")
Erzwungene strukturierte Ausgabe mit json_schema
Dies ist die Kernanwendung von Luna in Batch-Extraktionsszenarien. Setzen Sie text.format auf json_schema, definieren Sie name und schema, und die Modellausgabe entspricht strikt der von Ihnen vorgegebenen JSON-Struktur:
curl -s https://api.hiapi.ai/v1/responses \
  -H "Authorization: Bearer sk-YOUR_KEY" \
  -H "Content-Type: application/json" \
  -d '{
    "model": "gpt-6-luna",
    "input": [
      {
        "role": "user",
        "content": "Produktbewertung: Die Farbe ist schön, aber nach zwei Wochen ist die Sohle abgefallen. Nicht zu empfehlen."
      }
    ],
    "text": {
      "format": {
        "type": "json_schema",
        "name": "review_analysis",
        "schema": {
          "type": "object",
          "properties": {
            "sentiment": {"type": "string", "enum": ["positive", "neutral", "negative"]},
            "pros": {"type": "array", "items": {"type": "string"}},
            "cons": {"type": "array", "items": {"type": "string"}},
            "recommend": {"type": "boolean"}
          },
          "required": ["sentiment", "pros", "cons", "recommend"]
        }
      }
    }
  }'
Das Modell gibt JSON zurück, das dem Schema entspricht, ohne manuelle Verarbeitung.
Alternative Schnittstelle: Chat Completions
Wenn Ihr bestehender Code bereits das Chat-Completions-Protokoll verwendet, wechseln Sie einfach das Modell:
curl -s https://api.hiapi.ai/v1/chat/completions \
  -H "Authorization: Bearer sk-YOUR_KEY" \
  -H "Content-Type: application/json" \
  -d '{
    "model": "gpt-6-luna",
    "messages": [
      {"role": "user", "content": "Erkläre in einem Satz, was HiAPI ist, und antworte auf Deutsch."}
    ]
  }'
Die Responses API ist die Standardempfehlung: Das Eingabeformat ist ein input-Array, und sie unterstützt reasoning-Konfiguration sowie strukturierte Ausgabe über text.format. Chat Completions unterstützt max_completion_tokens und max_tokens nicht (Luna verwendet unter beiden Protokollen ausschließlich das input-Format).
Wichtige Parameter
| Parameter | Erforderlich | Beschreibung |
|---|---|---|
model |
Ja | gpt-6-luna |
input |
Ja | Nachrichten-Array, jede mit role und content |
reasoning.effort |
Nein | Reasoning-Stärke, sechs Stufen: none/low/medium(Standard)/high/xhigh/max |
temperature |
Nein | Steuert die Zufälligkeit; einstellbar bei reasoning.effort=none |
top_p |
Nein | Nucleus-Sampling; einstellbar bei reasoning.effort=none |
text.format |
Nein | Steuerung des Ausgabeformats; unterstützt json_schema und strict |
max_output_tokens |
Nein | Maximale Anzahl an Ausgabe-Token |
tools |
Nein | Tool-Definitionen für Agent-Szenarien |
tool_choice |
Nein | Strategie zur Tool-Auswahl |
Zur Verwendung von reasoning.effort:
none: Reasoning deaktiviert; geeignet für Klassifikation, Extraktion, einfache Q&A.temperatureundtop_pkönnen frei angepasst werden.low/medium(Standard): leichtes bis mittleres Reasoning; geeignet für allgemeine Q&A und Inhaltsgenerierung.high/xhigh/max: tiefgehendes Reasoning für komplexe Analysen. Beachten Sie: Je höher die Stufe, desto mehr Reasoning-Token werden verbraucht.
Für Batch-Aufgaben none setzen; für alltägliche Dialoge reicht standardmäßig medium; für komplexe Analysen bei Bedarf erhöhen.
Häufige Fehler
- 400
model not found→model-Feld falsch geschrieben → Prüfen Sie, obgpt-6-lunaangegeben ist. - 400
additional properties not allowed→ Nicht unterstütztes Feld übergeben (z. B.max_tokensbei Chat Completions) → Entfernen Sie überflüssige Felder. - 401
permission_denied→ Key fehlt oder ist falsch → Prüfen SieAuthorization: Bearer sk-.... - 400
json_schema validation failed→ Schema-Definition entspricht nicht der Spezifikation → Prüfen Sie dasrequired-Array und dentypejedes Feldes inproperties.
Häufige Fragen
Responses API oder Chat Completions verwenden?
Für neue Integrationen die Responses API verwenden. Sie unterstützt input-Array-Eingabe, reasoning.effort, text.format json_schema und weitere neue Funktionen. Wenn Sie bereits Chat-Completions-Code haben und ihn nicht ändern möchten, funktioniert auch einfach der Modellwechsel.
Was ist der Unterschied zwischen reasoning.effort=none und dem Abschalten des Reasonings?
Bei none erzeugt das Modell keine Reasoning-Token; die Ausgabe enthält nur den endgültigen Antworttext. temperature und top_p können manuell angepasst werden. Für Klassifikation, Extraktion und Formatierung reicht none aus – spart Token und ist schneller.
Wie funktioniert der Cache? Automatisch. Wiederholte Teile in System-Prompts und Dialogverlauf werden aus dem Cache bedient und nur mit $0,0025/M berechnet. Keine zusätzliche Konfiguration erforderlich.
Wie nutzt man Batch für Massenaufgaben?
Fügen Sie der Anfrage "processing_mode": "batch" hinzu. Die Aufgabe wird in eine asynchrone Warteschlange eingereiht; der Preis beträgt 50 % Rabatt. Geeignet für Aufgaben, die keine Echtzeitantwort erfordern.
Was hat sich im Vergleich zu gpt-5.6-luna geändert? Der Preis halbiert (Eingabe $0,025 vs. $0,05), die Ausgabe ist 2,4-mal günstiger, die Responses API ist nun das Standardprotokoll, sechs Reasoning-Stufen (identisch mit 6-luna, alle sechs Stufen verfügbar) und der Kontext wurde auf 1,05 Mio. erweitert. Details im Vergleich GPT-6 Luna vs. GPT-5.6 Luna.
Artikel zur GPT-6 Luna-Serie
- GPT-6 Luna Modellseite: Online-Chat, 200 Guthabenpunkte bei Registrierung
- GPT-6 Luna API-Preise: $0,025/M Eingabe, das günstigste GPT auf HiAPI
- GPT-6 Luna vs. GPT-5.6 Luna: Preis halbiert – wechseln oder nicht?
- GPT-6 Luna Prompt-Beispiele: 5 Batch-Szenarien zum direkten Kopieren
Jetzt ausprobieren: Kopieren Sie den curl-Befehl oben, setzen Sie Ihren API-Key ein und führen Sie den ersten Aufruf aus. Oder öffnen Sie die Modellseite und chatten Sie direkt online.
Ähnliche Artikel
Alle Artikel ansehen →-

Tutorial
Recraft Creative Upscale Praxisbeispiele: Landschaften und Aquarell hochskalieren
Betrachten Sie die Texturveränderungen bei Holzhütte, See und Aquarellstadt, unterscheiden Sie vollständige Ergebnisse von Vorschauen und prüfen Sie neu gezeichnete Details.
-

Tutorial
Ungültiger OpenAI API key: Fehlerbehebung bei 401, Umgebungsvariablen und Projektkonfiguration
OpenAI 401, 403 und 429 unterscheiden, Umgebungsvariablen sowie Organisations- und Projekteinstellungen prüfen und Zugangsdaten mit einer schreibgeschützten Anfrage verifizieren.
-

Tutorial
Kling 4.0 Prompt-Sammlung: 6 Szenen zum direkten Kopieren für deine Videos
E-Commerce-Produkt, Food, Reise-Landschaft, Alltagsszene, leere Szene mit Ton und Bild-zu-Video – jede Szene mit echtem Ergebnisvideo, vollständigem Prompt und Ein-Klick-Vorausfüll-Link.