
Tutorial
Como usar a API Qwen Image 2.1 Pro? Texto para imagem e edição de imagem funcionando em 5 minutos
Teste online em 5 passos, integração via API em 4 passos, com curl e Python executáveis, além de image_urls, referência a múltiplas imagens, prompt_extend e como escrever fundo transparente.
TL;DR
- O que é: o Qwen Image 2.1 Pro já está disponível no HiAPI. Abra a página do modelo e escreva um prompt para gerar uma imagem a partir de texto, ou coloque imagens de referência para editar; um único ID de modelo aceita até 10 imagens de referência, cinco formatos de nível 2K e o
prompt_extendvem ativado por padrão. Novos usuários ganham 200 créditos ao se cadastrar. - Quanto custa: $0.05 por imagem (100 créditos), cobrado por imagem gerada com sucesso, independentemente do formato; em caso de falha há reembolso e imagens de referência não custam a mais; $10 rendem cerca de 200 imagens. O Turbo tem o mesmo contrato a $0.02/imagem.
- Como chamar mais rápido: escreva o prompt na página do modelo e execute; para integrar ao produto, use
POST https://api.hiapi.ai/v1/taskscommodeldefinido comoqwen-image-2.1-pro.
O que é o Qwen Image 2.1 Pro? O que há de novo em relação ao 2.0
A geração de imagem a partir de texto e a edição compartilham o mesmo ID de modelo: sem image_urls ele gera uma nova imagem; com image_urls ele edita a partir das referências, sem precisar trocar de endpoint.
Quatro diferenças em relação ao 2.0 (o 2.0 usava size para especificar pixels livremente; o 2.1 passou a usar valores por formato):
- Um ID cobre os dois tipos de tarefa. Geração e edição compartilham o mesmo ID; a requisição difere apenas em
image_urls. - Até 10 imagens de referência. Imagens de produto e de cena podem ser enviadas de uma vez e referenciadas como "imagem 1" e "imagem 2".
- Cinco formatos de nível 2K. 1:1 2048×2048, 16:9 2688×1536, 9:16 1536×2688, 4:3 2368×1728, 3:4 1728×2368; não há campo
resolution. prompt_extendativado por padrão. O modelo expande automaticamente o prompt; para diagramação rígida ou reprodução literal de texto, definafalse.
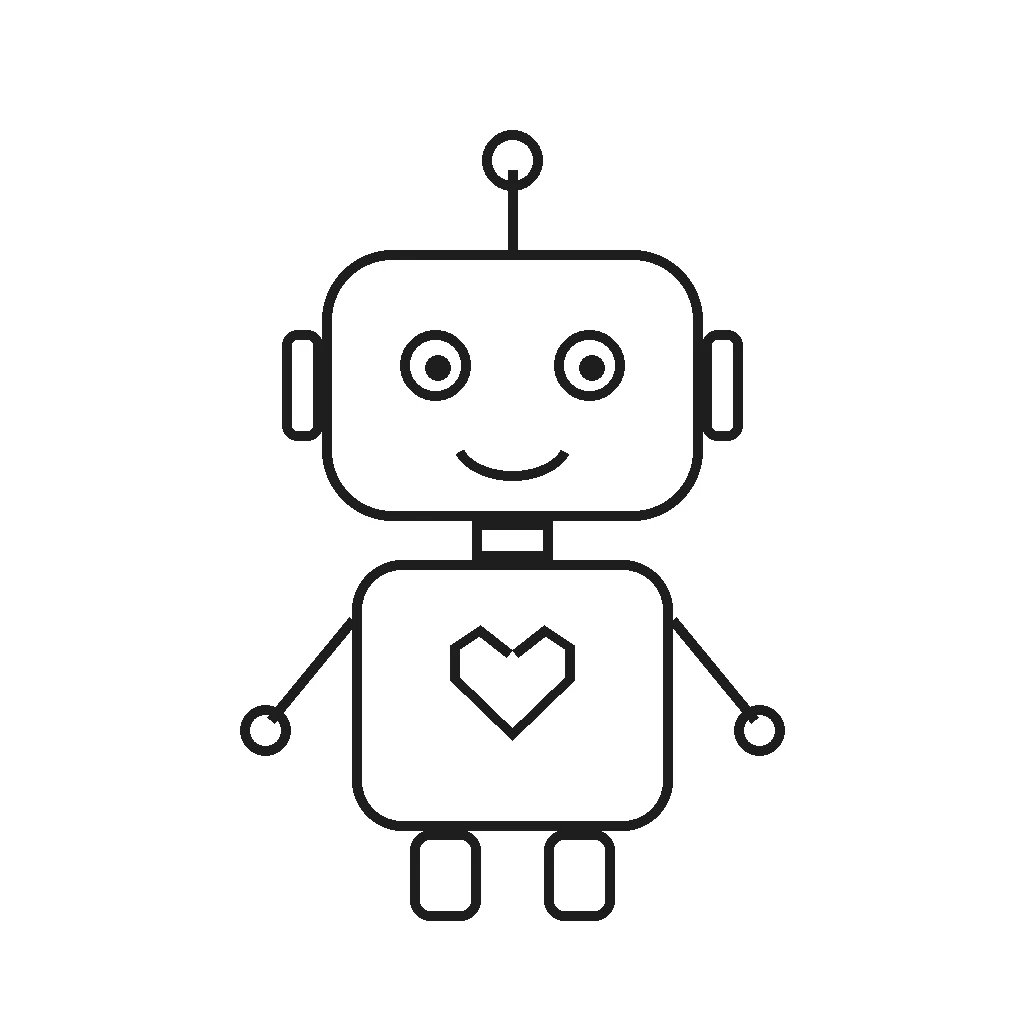
Do desenho de linha ao brinquedo 3D é uma única requisição de edição, preservando a forma, as proporções e a pose originais:
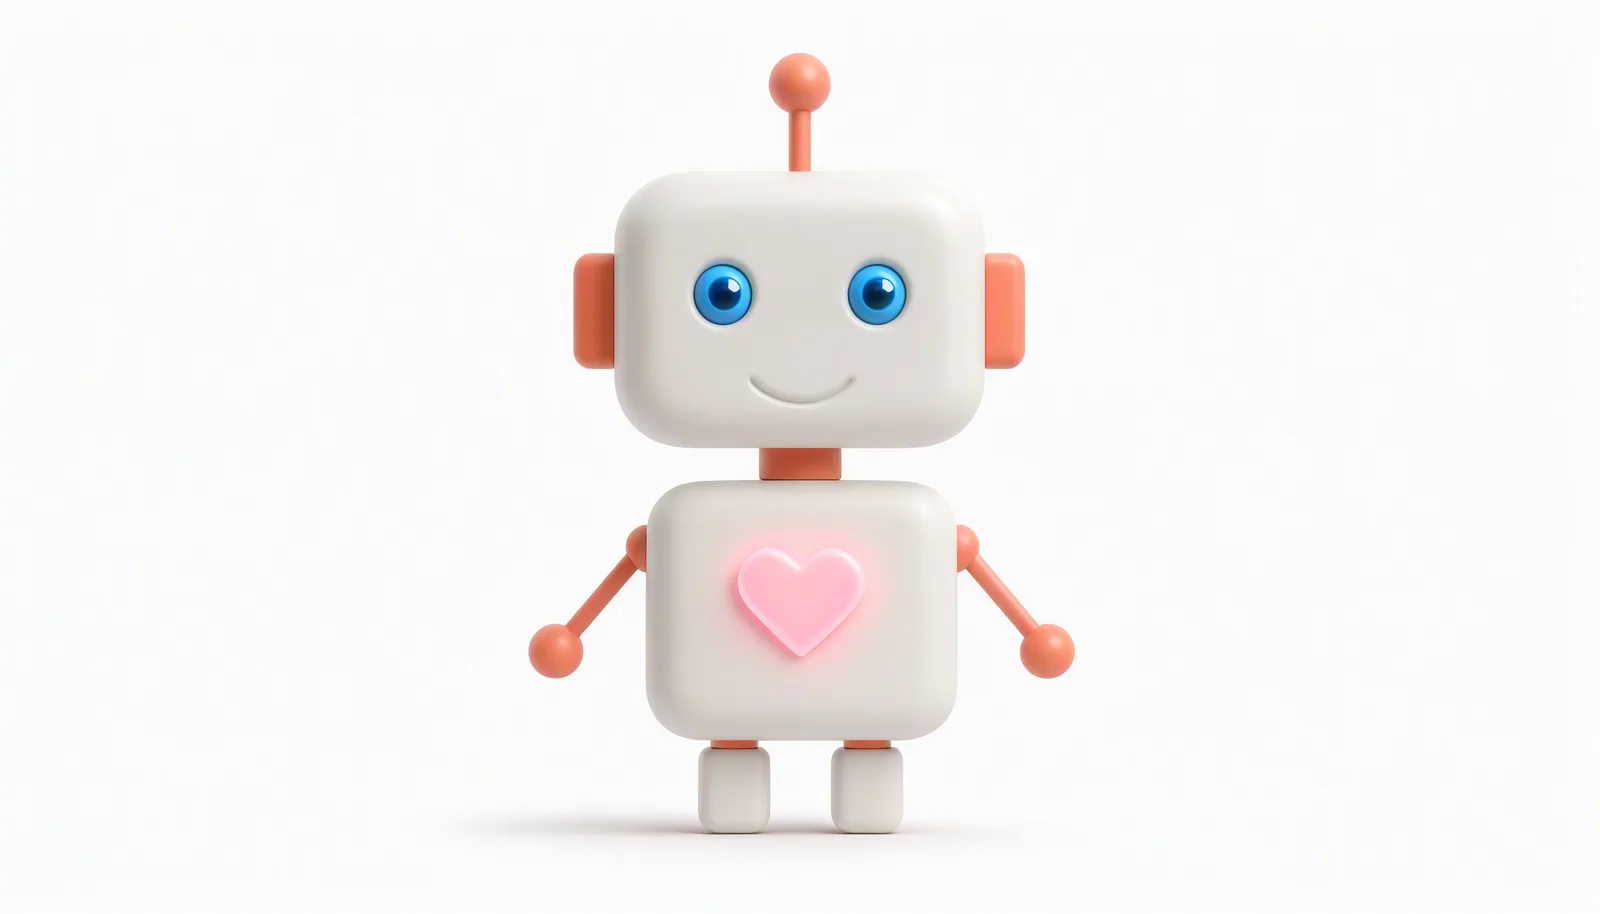
Transforme o pequeno robô do desenho de linha da imagem de referência em uma renderização refinada de brinquedo cartunesco 3D: carcaça branca fosca com juntas, orelhas e antena em laranja-coral, o coração no peito emitindo um brilho rosa suave, olhos em azul brilhante, mantendo a forma, as proporções e a pose originais, iluminação de estúdio suave, fundo cinza-claro esbranquiçado limpo, apenas o robô como elemento principal.
Gerar com este prompt → O link apenas preenche o prompt; ao abrir, envie o desenho de linha e escolha o formato 1:1.
Teste online: primeira imagem em 5 passos
- Abra a página do modelo Qwen Image 2.1 Pro; 200 créditos são suficientes para gerar 2 imagens Pro.
- Escreva o prompt; para edição, primeiro envie de 1 a 10 imagens de referência em
image_urls. - Escolha o formato ou deixe em branco para o modelo escolher automaticamente.
- O
prompt_extendvem ativado por padrão; para pôsteres em chinês com diagramação rígida, desative primeiro. - Envie e baixe a imagem gerada.
Integração via API: 4 passos para funcionar
- Crie uma API Key no console.
- Use
POST https://api.hiapi.ai/v1/taskscommodeldefinido comoqwen-image-2.1-pro. - Após obter o
taskId, faça polling emGET /v1/tasks/{taskId}ou configure umcallback. - Quando
statusforsuccess, baixe a imagem a partir deoutput[0].url.
curl executável: geração de imagem a partir de texto
curl -s -X POST https://api.hiapi.ai/v1/tasks \
  -H "Authorization: Bearer YOUR_API_KEY" \
  -H "Content-Type: application/json" \
  -d '{
    "model": "qwen-image-2.1-pro",
    "input": {
      "prompt": "Um pôster de evento minimalista em chinês, fundo de papel branco-creme, no centro da imagem apenas a diagramação das três linhas de texto em chinês a seguir, todas centralizadas horizontalmente: a primeira linha em fonte serifada preta grande com “春日茶会”, a segunda linha em cinza-escuro tamanho médio com “三月二十八日 下午两点”, a terceira linha em cinza tamanho pequeno com “城南茶室 免费入场”. Espaçamento uniforme entre caracteres, bastante espaço em branco ao redor, sem nenhum outro texto, forma, linha ou ornamento na imagem além dessas três linhas, textura de impressão fosca.",
      "aspect_ratio": "3:4",
      "prompt_extend": false,
      "seed": 42
    }
  }'
O ID da tarefa fica em data.taskId:
curl -s https://api.hiapi.ai/v1/tasks/YOUR_TASK_ID \
  -H "Authorization: Bearer YOUR_API_KEY"
O data.status passa por queued, handling, archiving, success ou fail; archiving indica que ainda está empacotando, não é falha.
Versão em Python: criar, fazer polling, baixar
import time
import requests

BASE = "https://api.hiapi.ai/v1/tasks"
HEADERS = {"Authorization": "Bearer YOUR_API_KEY"}

payload = {
    "model": "qwen-image-2.1-pro",
    "input": {
        "prompt": "Um shiba inu de chapéu de palha surfando em uma prancha, estilo adesivo achatado, paleta coral-laranja e azul-mar, fundo de cor sólida.",
        "aspect_ratio": "1:1",
        "seed": 42,
    },
}

task_id = requests.post(BASE, headers=HEADERS, json=payload, timeout=30).json()["data"]["taskId"]

while True:
    data = requests.get(f"{BASE}/{task_id}", headers=HEADERS, timeout=30).json()["data"]
    if data["status"] in ("success", "fail"):
        break
    time.sleep(3)

if data["status"] == "success":
    with open("qwen-image.png", "wb") as f:
        f.write(requests.get(data["output"][0]["url"], timeout=60).content)
    print("saved qwen-image.png")
else:
    print(data.get("error"))
Diferença entre geração e edição: image_urls
Sem image_urls, ele gera uma imagem totalmente nova; com 1 imagem é edição de imagem única; com 2–10 é referência de múltiplas imagens. As imagens de referência aceitam JPG/JPEG/PNG/BMP/TIFF/WEBP/GIF, até 10MB por imagem, largura e altura de 1–8000px, proporção entre lados maior e menor ≤10:1.
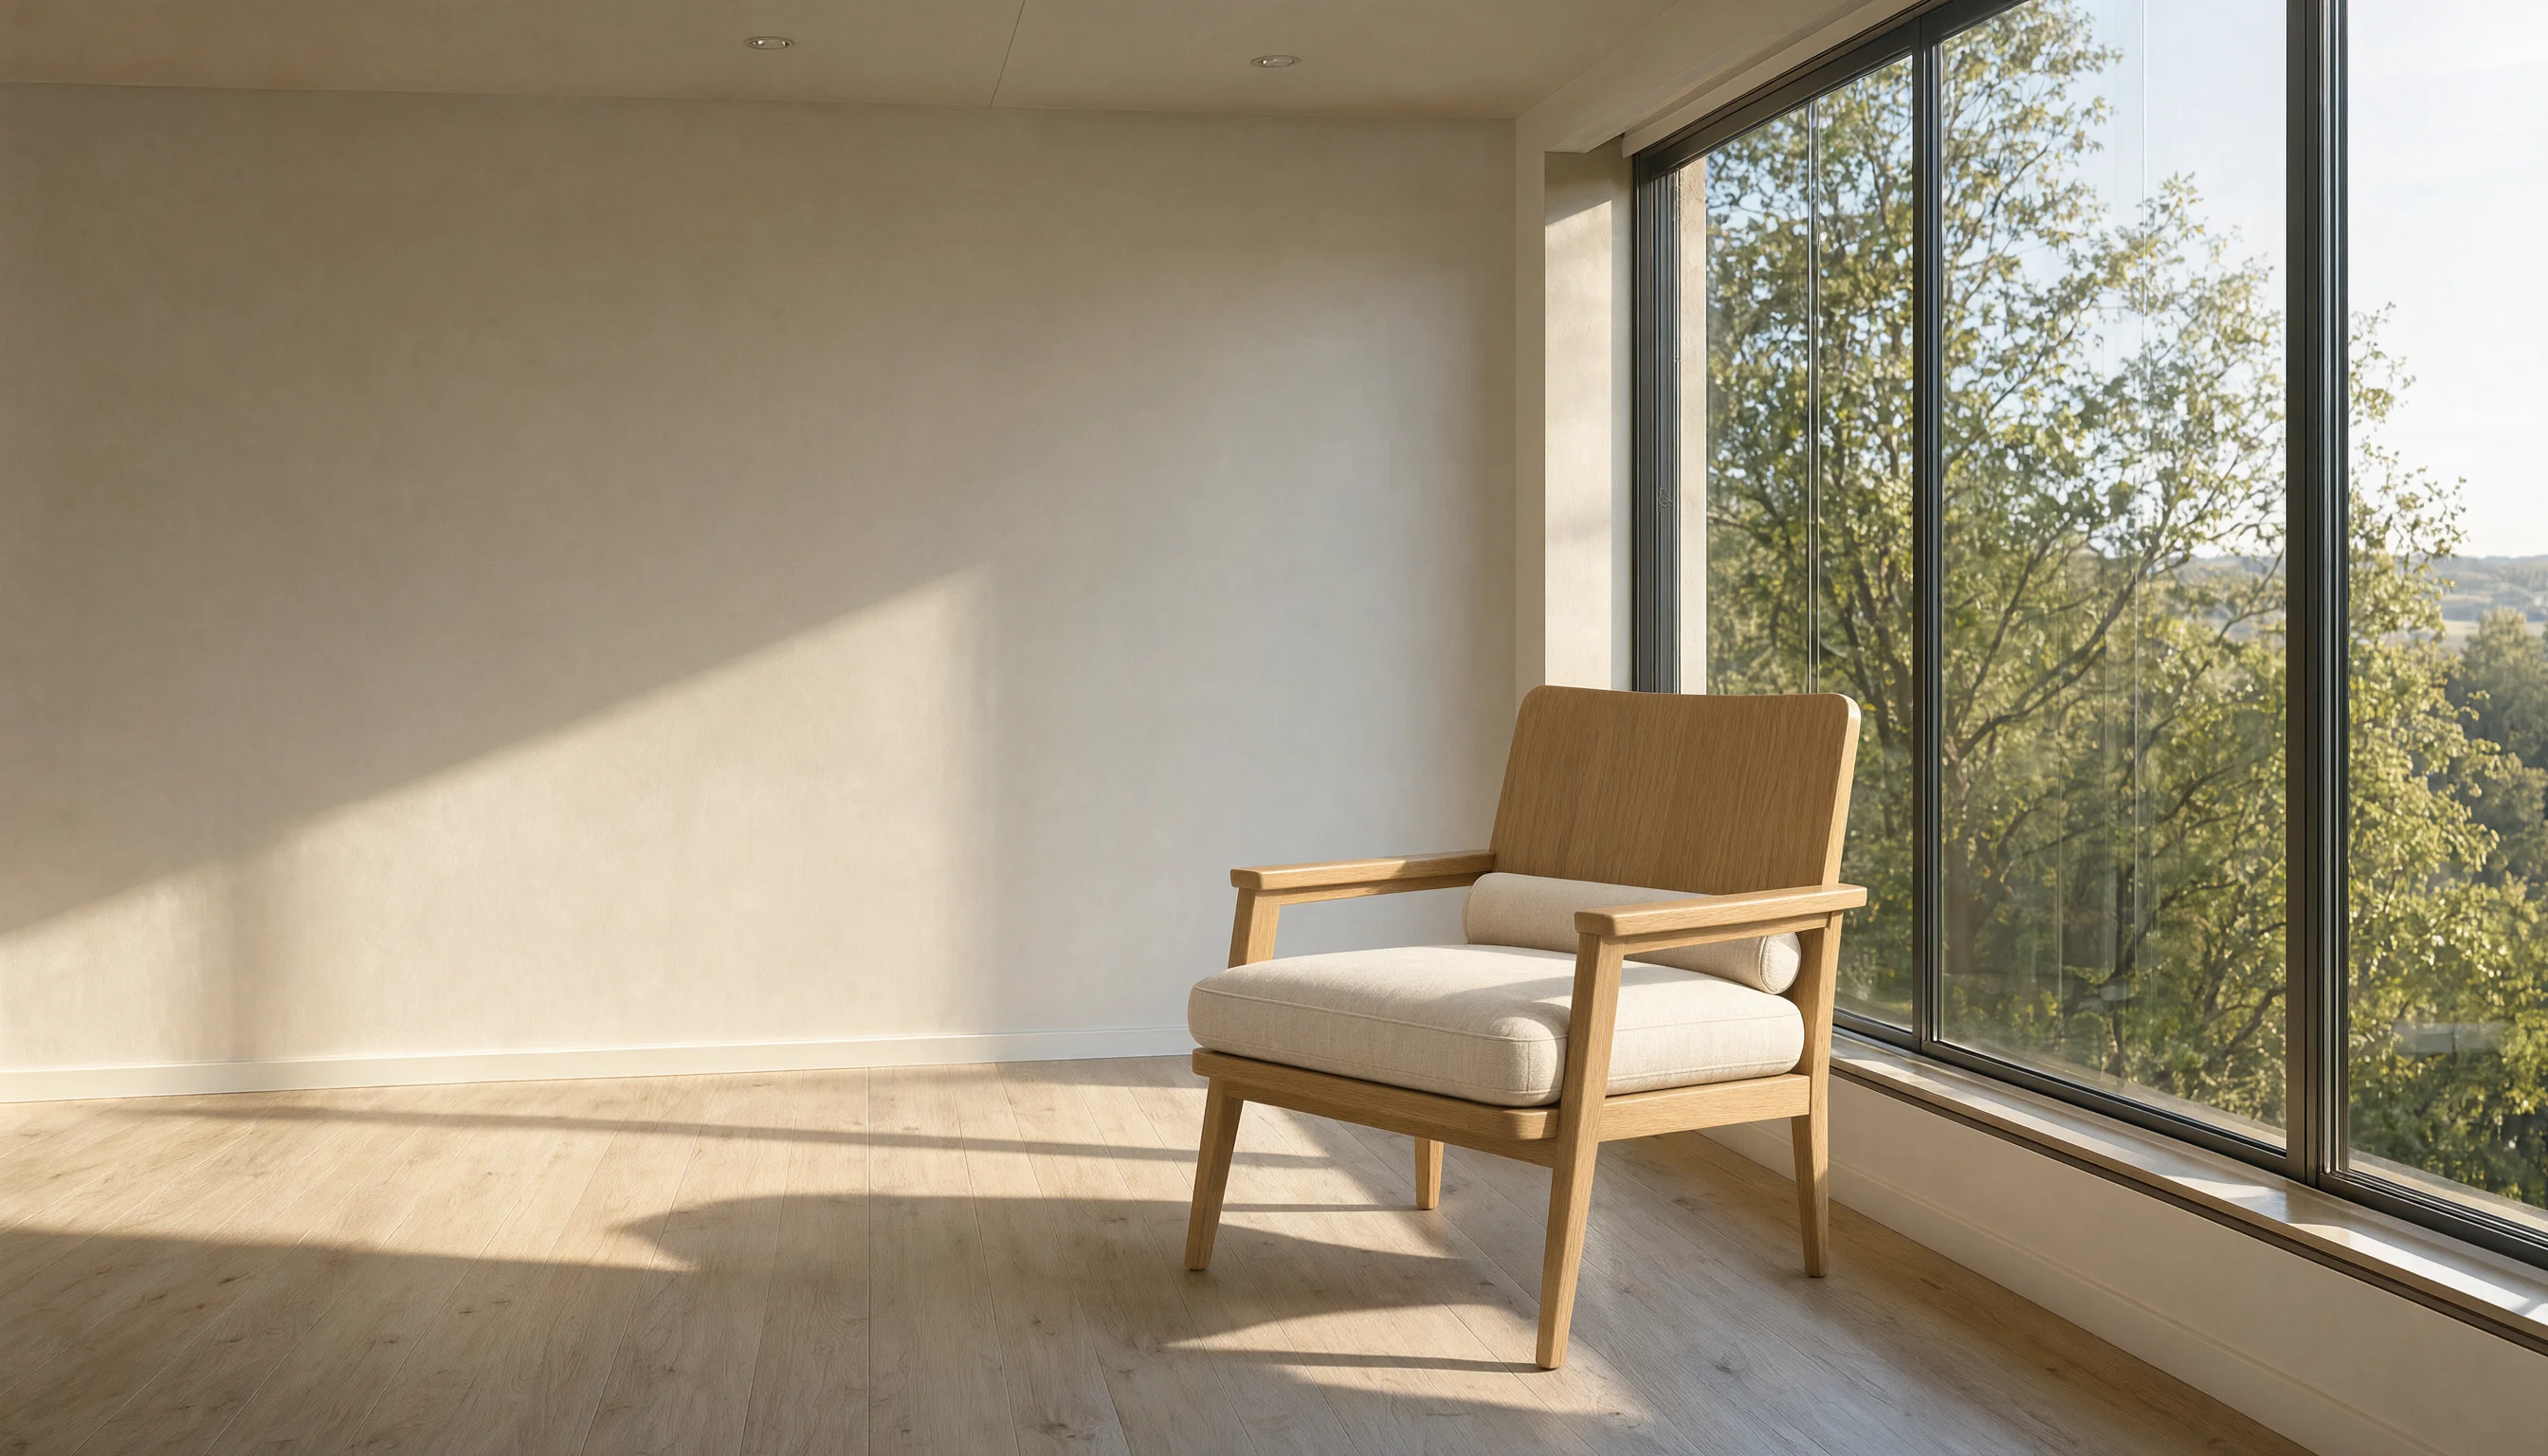
Com várias imagens, a ordem do array image_urls corresponde às "imagem 1" e "imagem 2" do prompt. Para colocar esta cadeira na sala, use duas imagens de referência e um prompt:
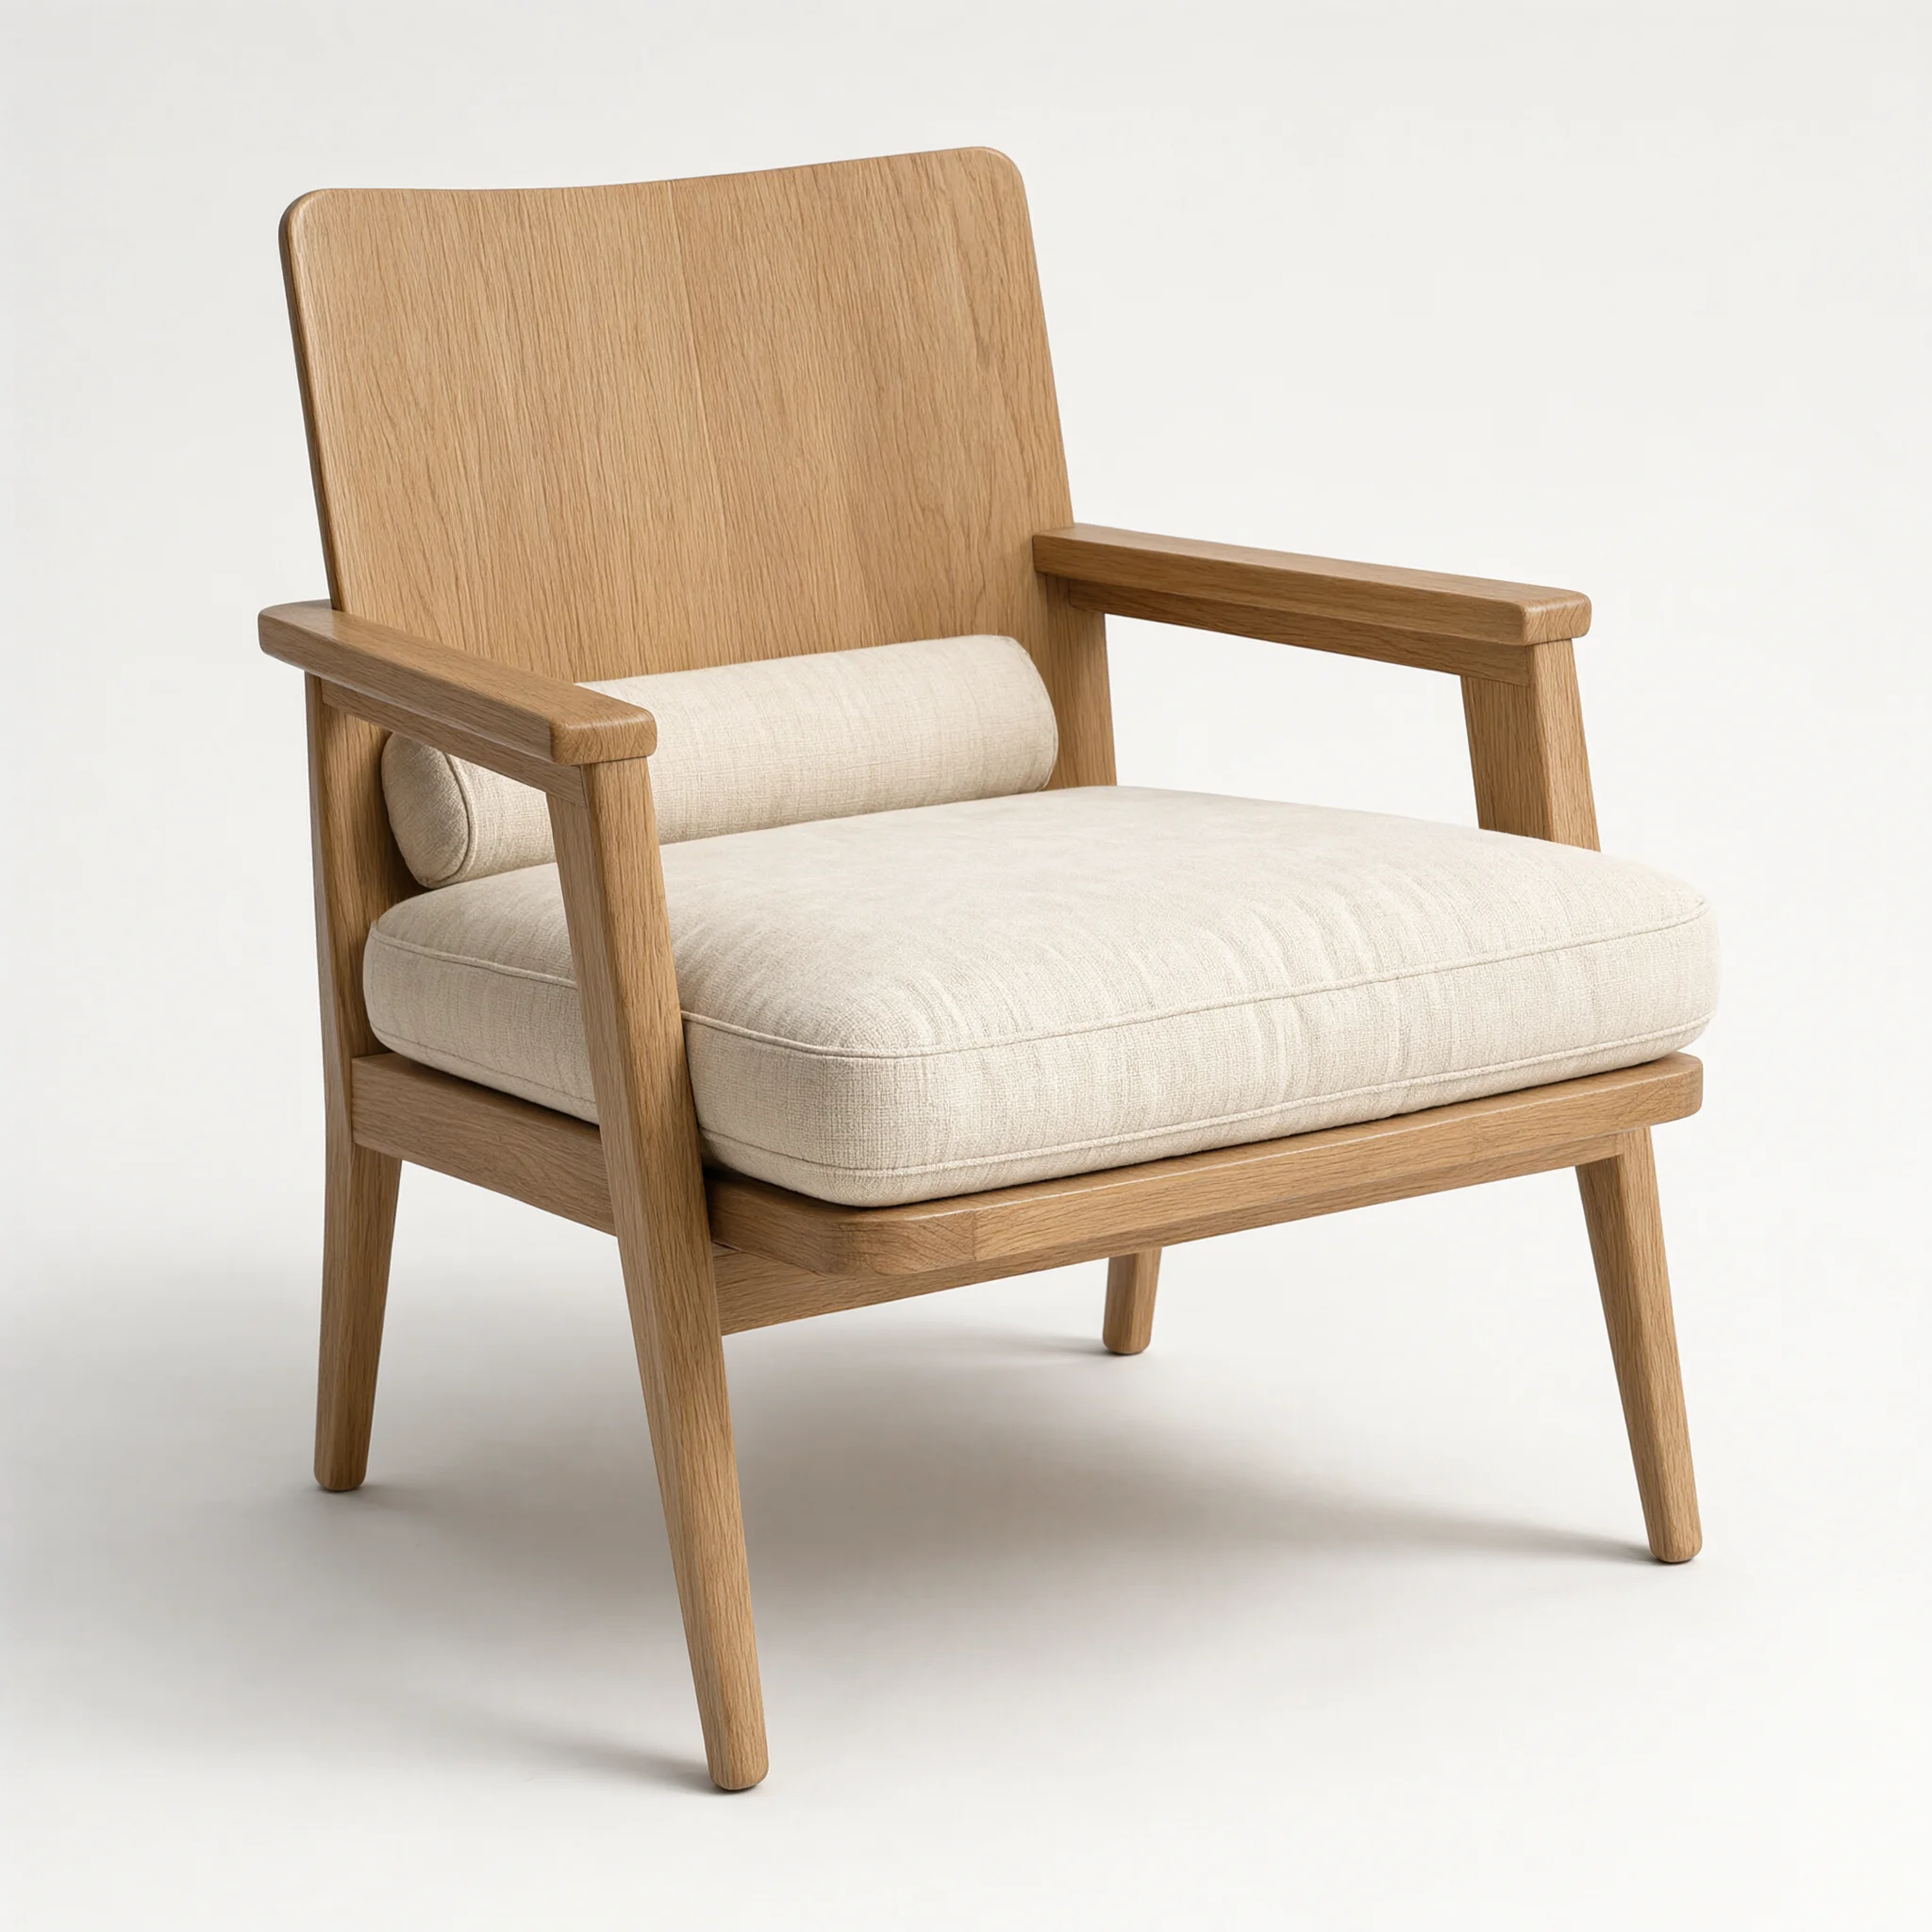
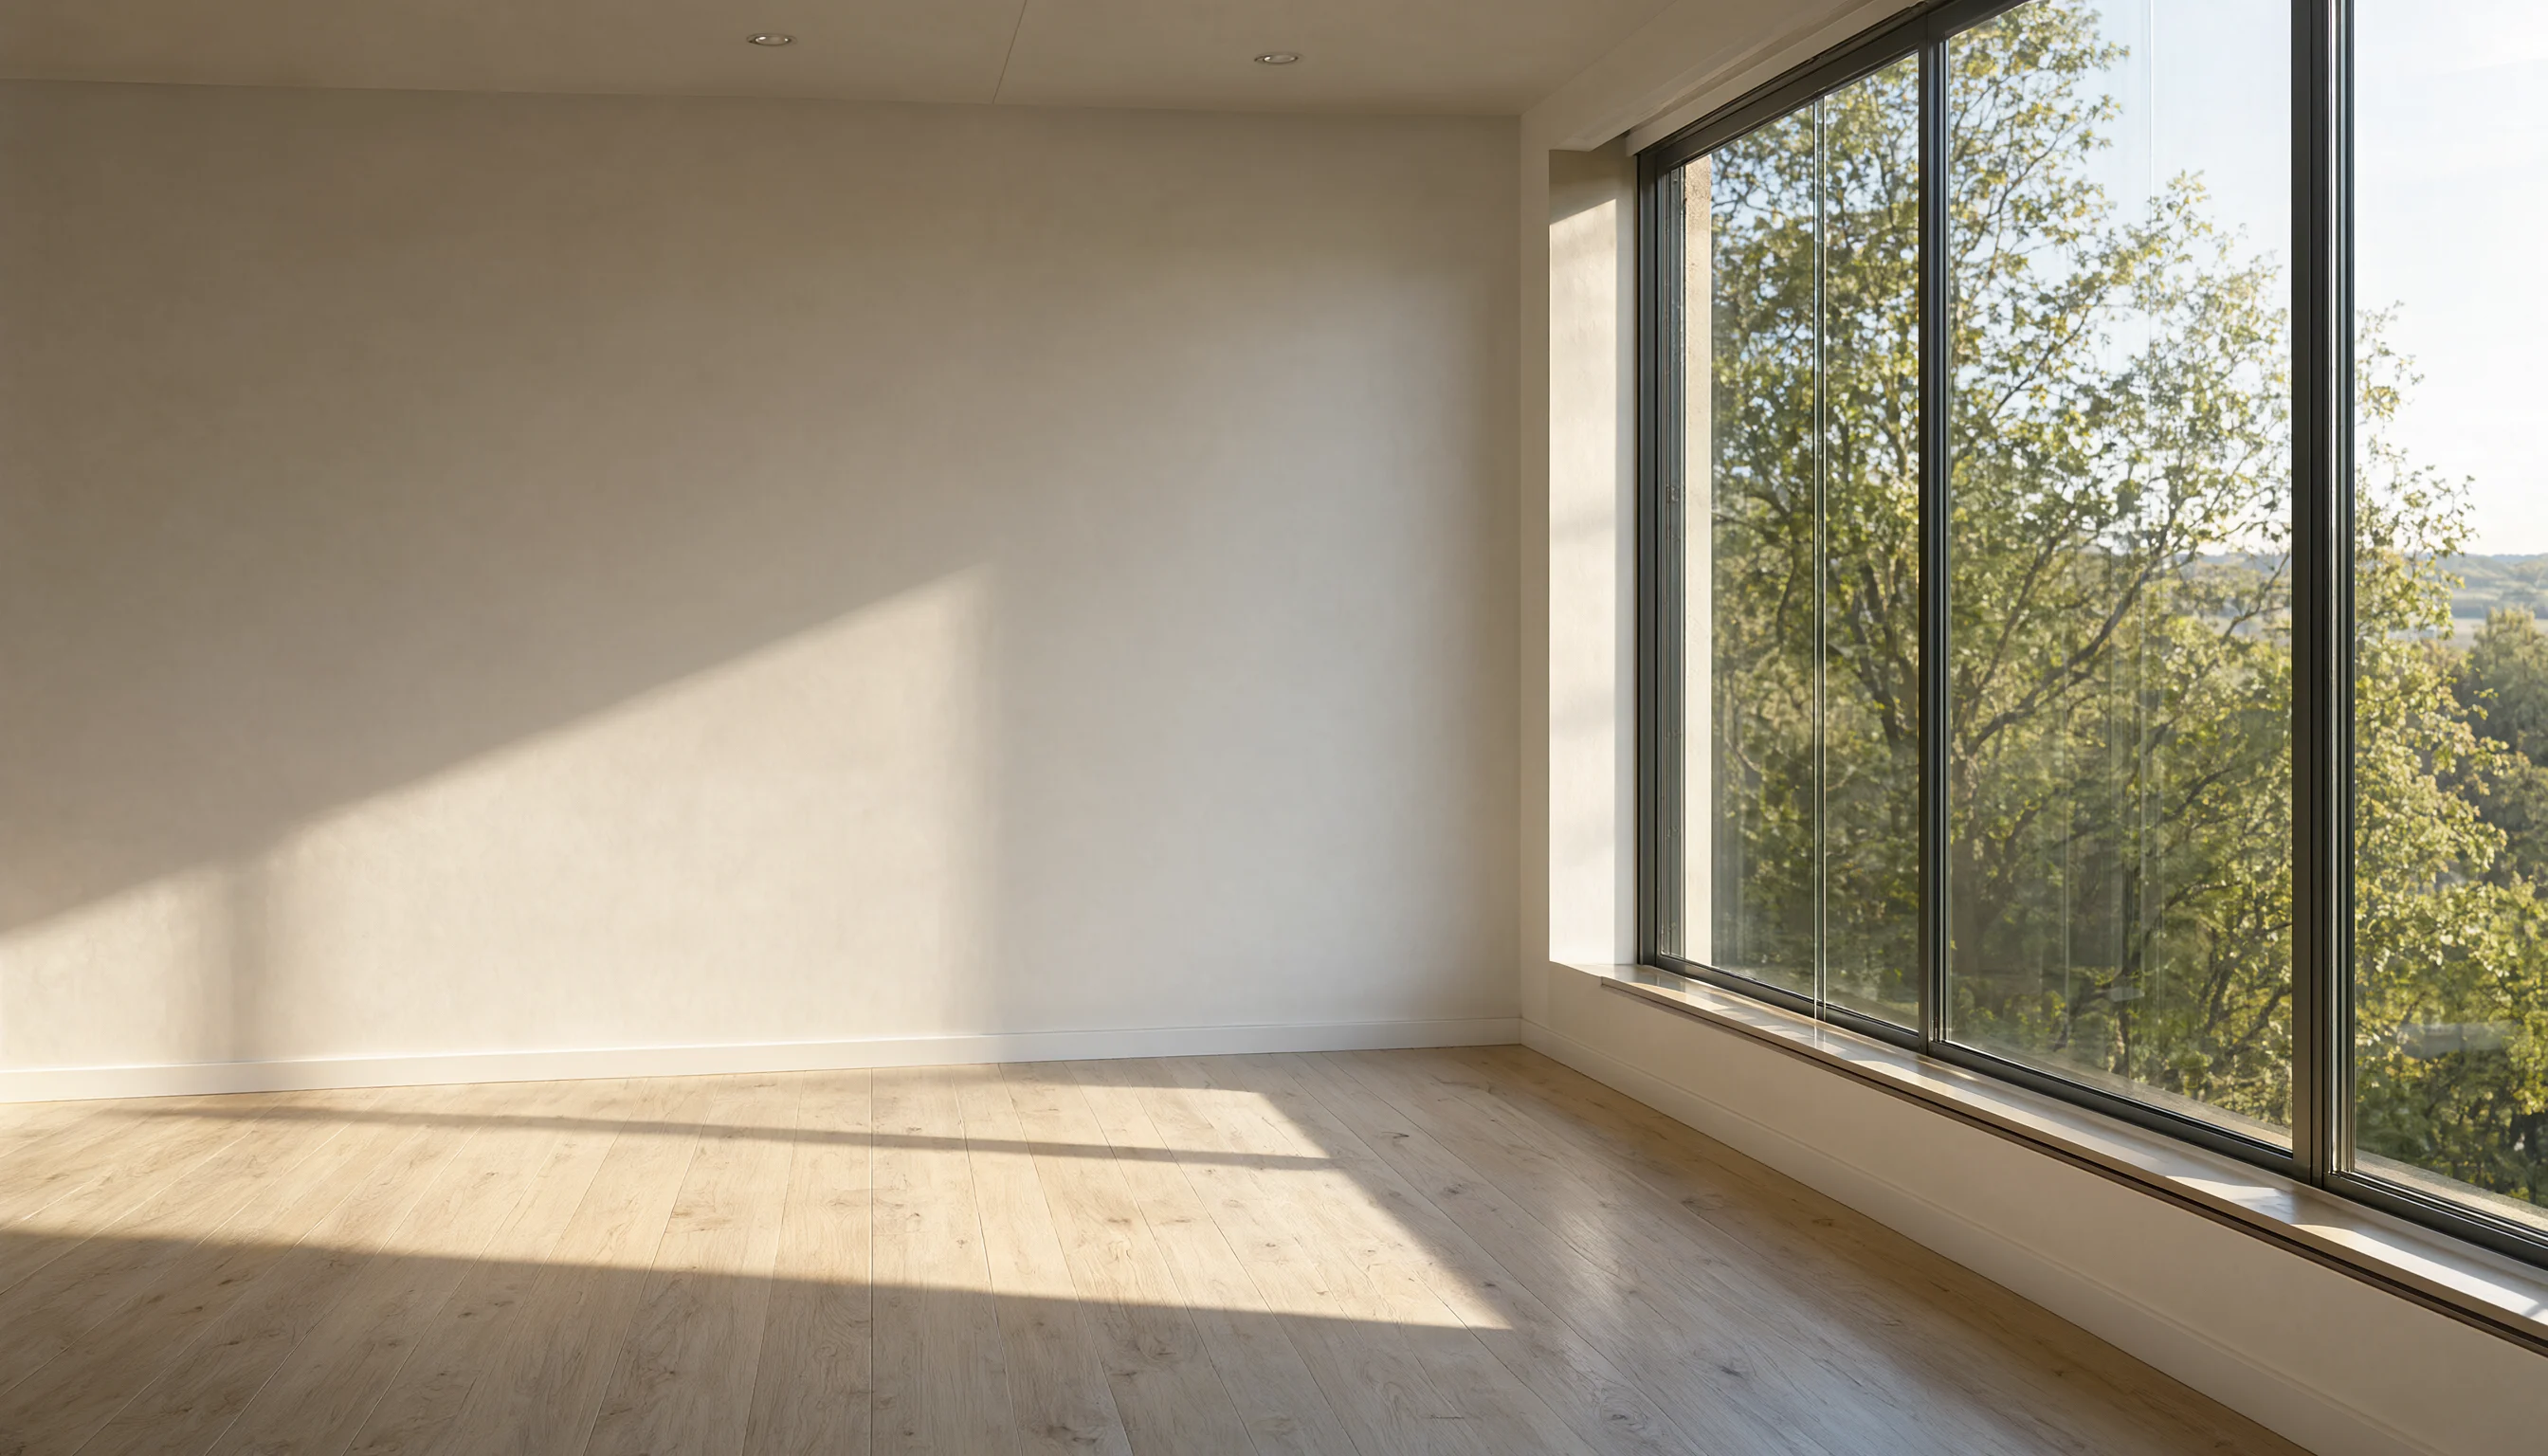
Coloque a poltrona de carvalho da imagem 1 na sala da imagem 2, posicionada sobre a mancha de luz no piso em frente à janela do chão ao teto, mantendo a mesma orientação da imagem 1, complete a poltrona com sombra de contato e sombra projetada coerentes com a cena, mantendo inalterados a parede, o piso de madeira, o rodapé, o caixilho da janela e a vista externa da sala da imagem 2, com iluminação natural lateral branca e quente de tarde unificada em todo o conjunto.
Gerar com este prompt → Ao abrir, envie em ordem a imagem 1 (cadeira) e a imagem 2 (sala); se inverter a ordem, o resultado também se inverte.
A edição de imagem única também usa image_urls; este frasco de perfume altera apenas o material e a cena:
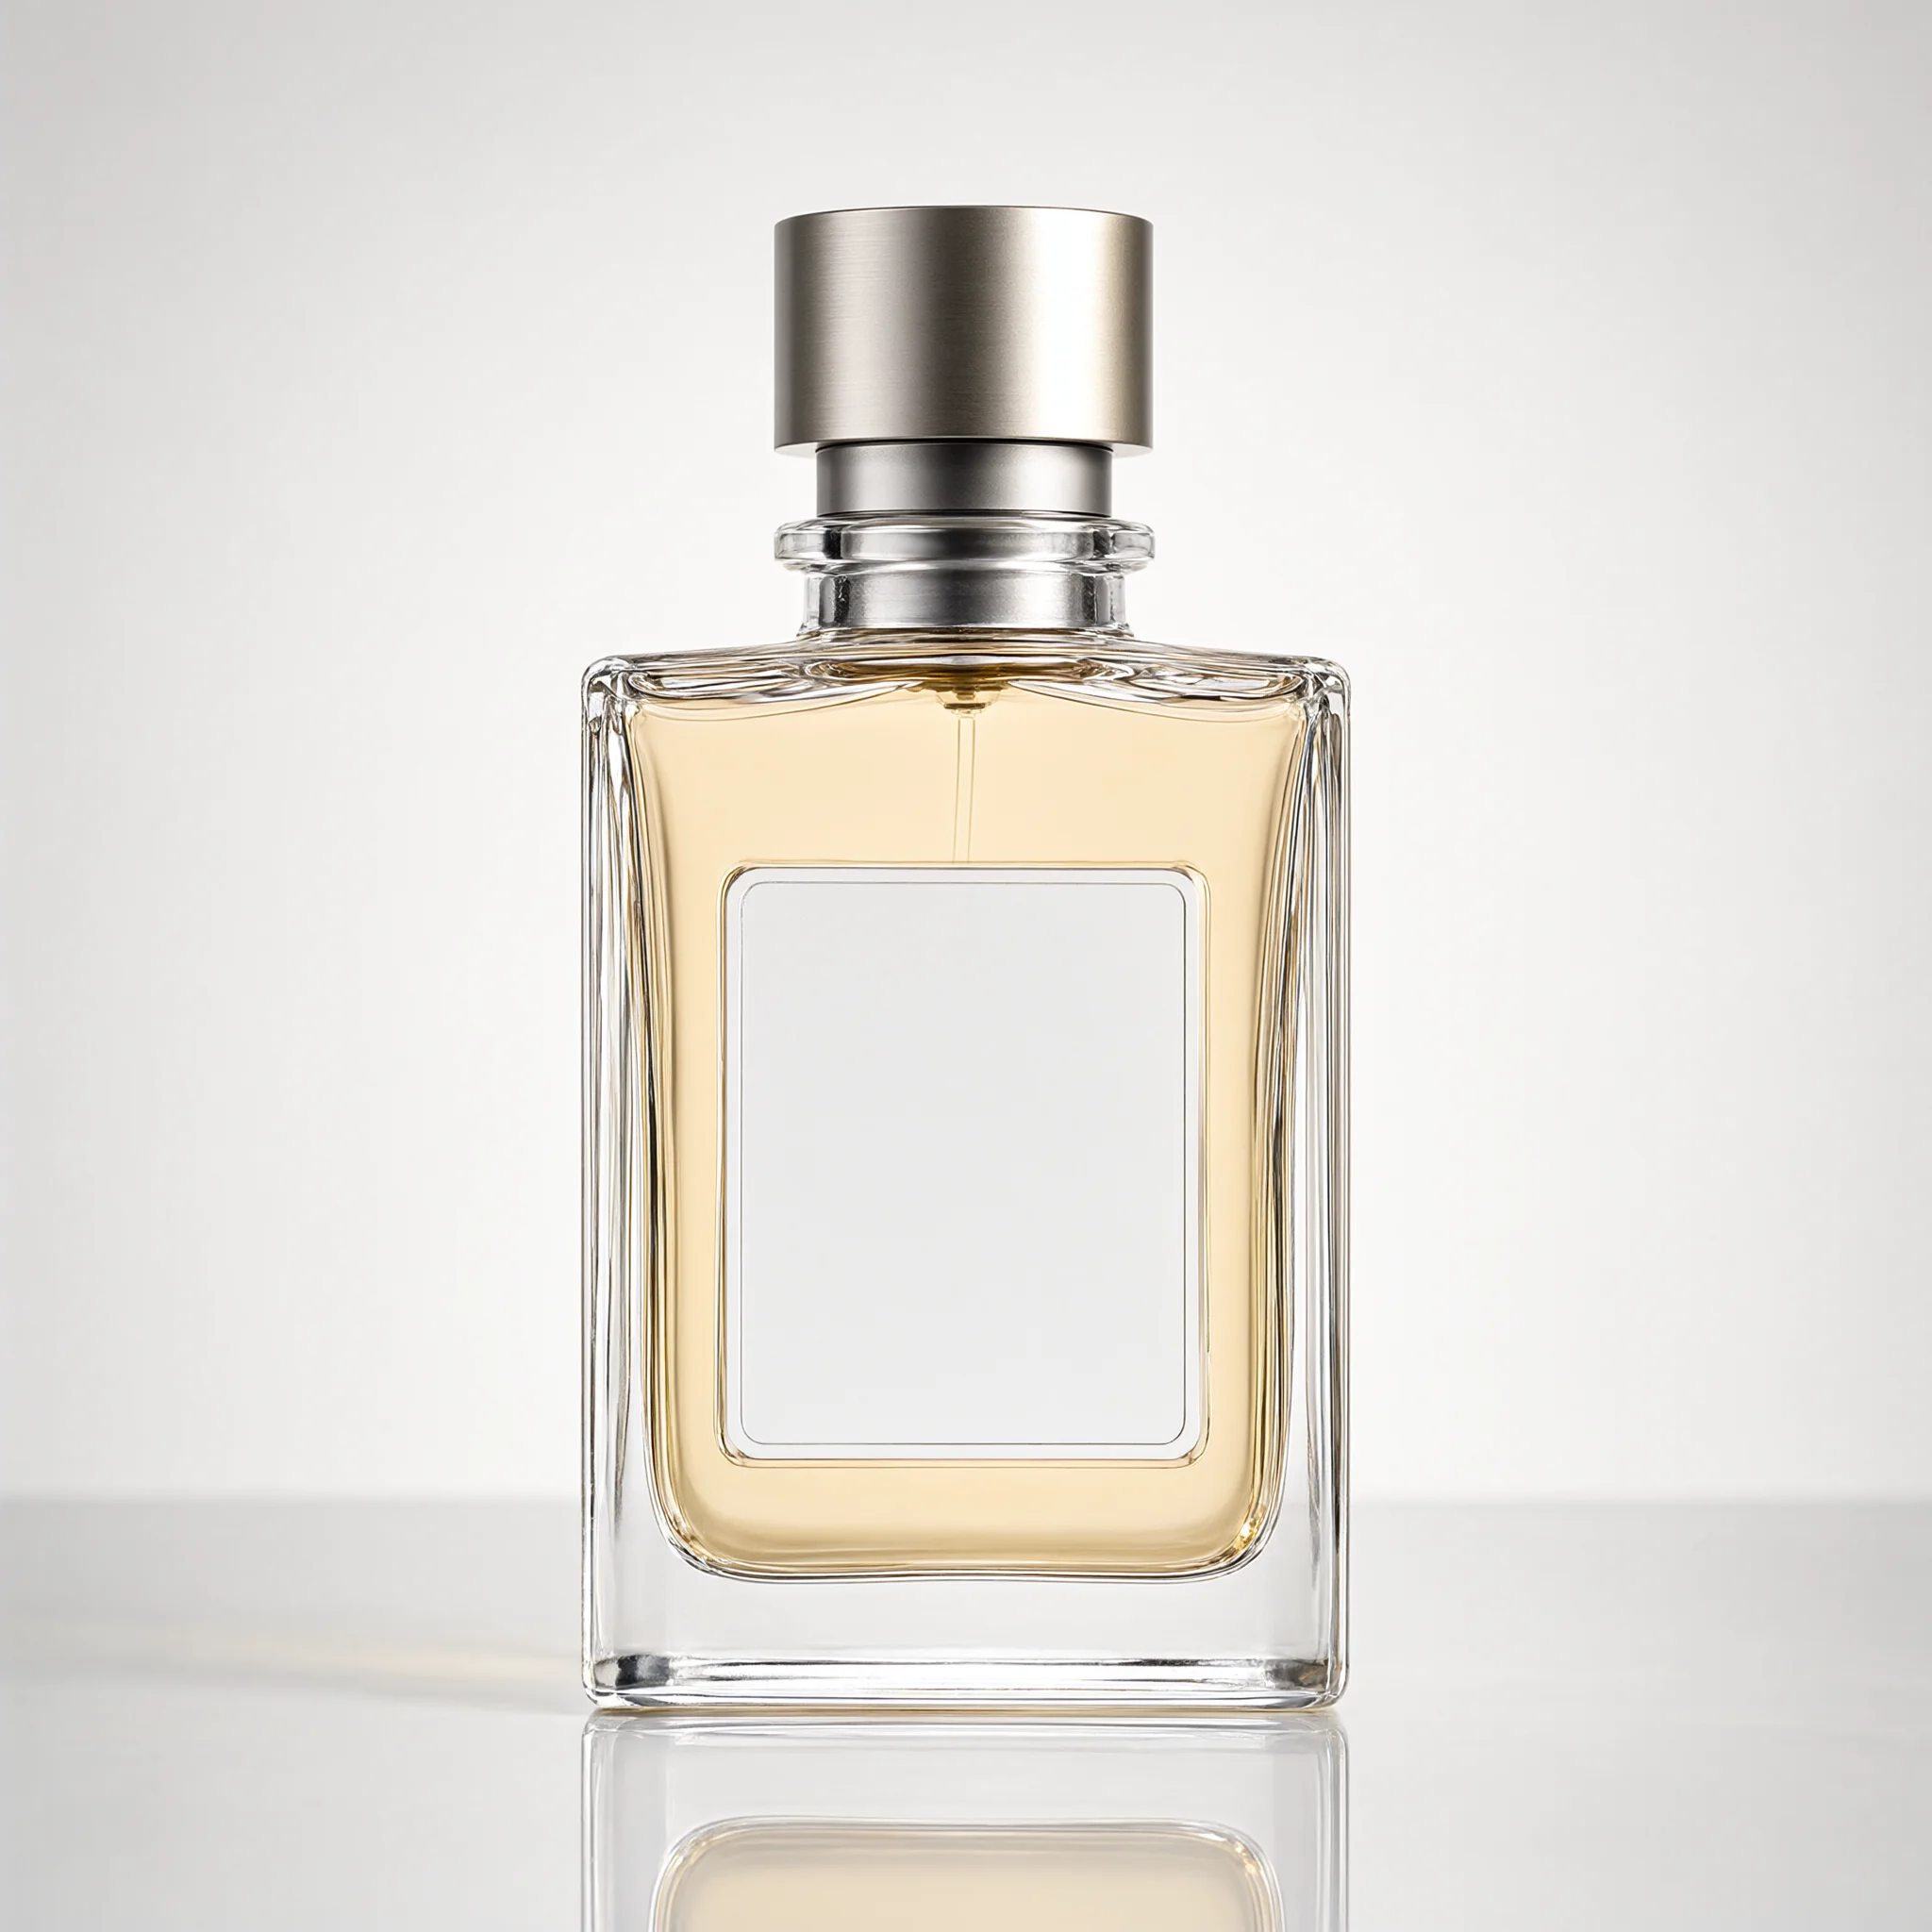
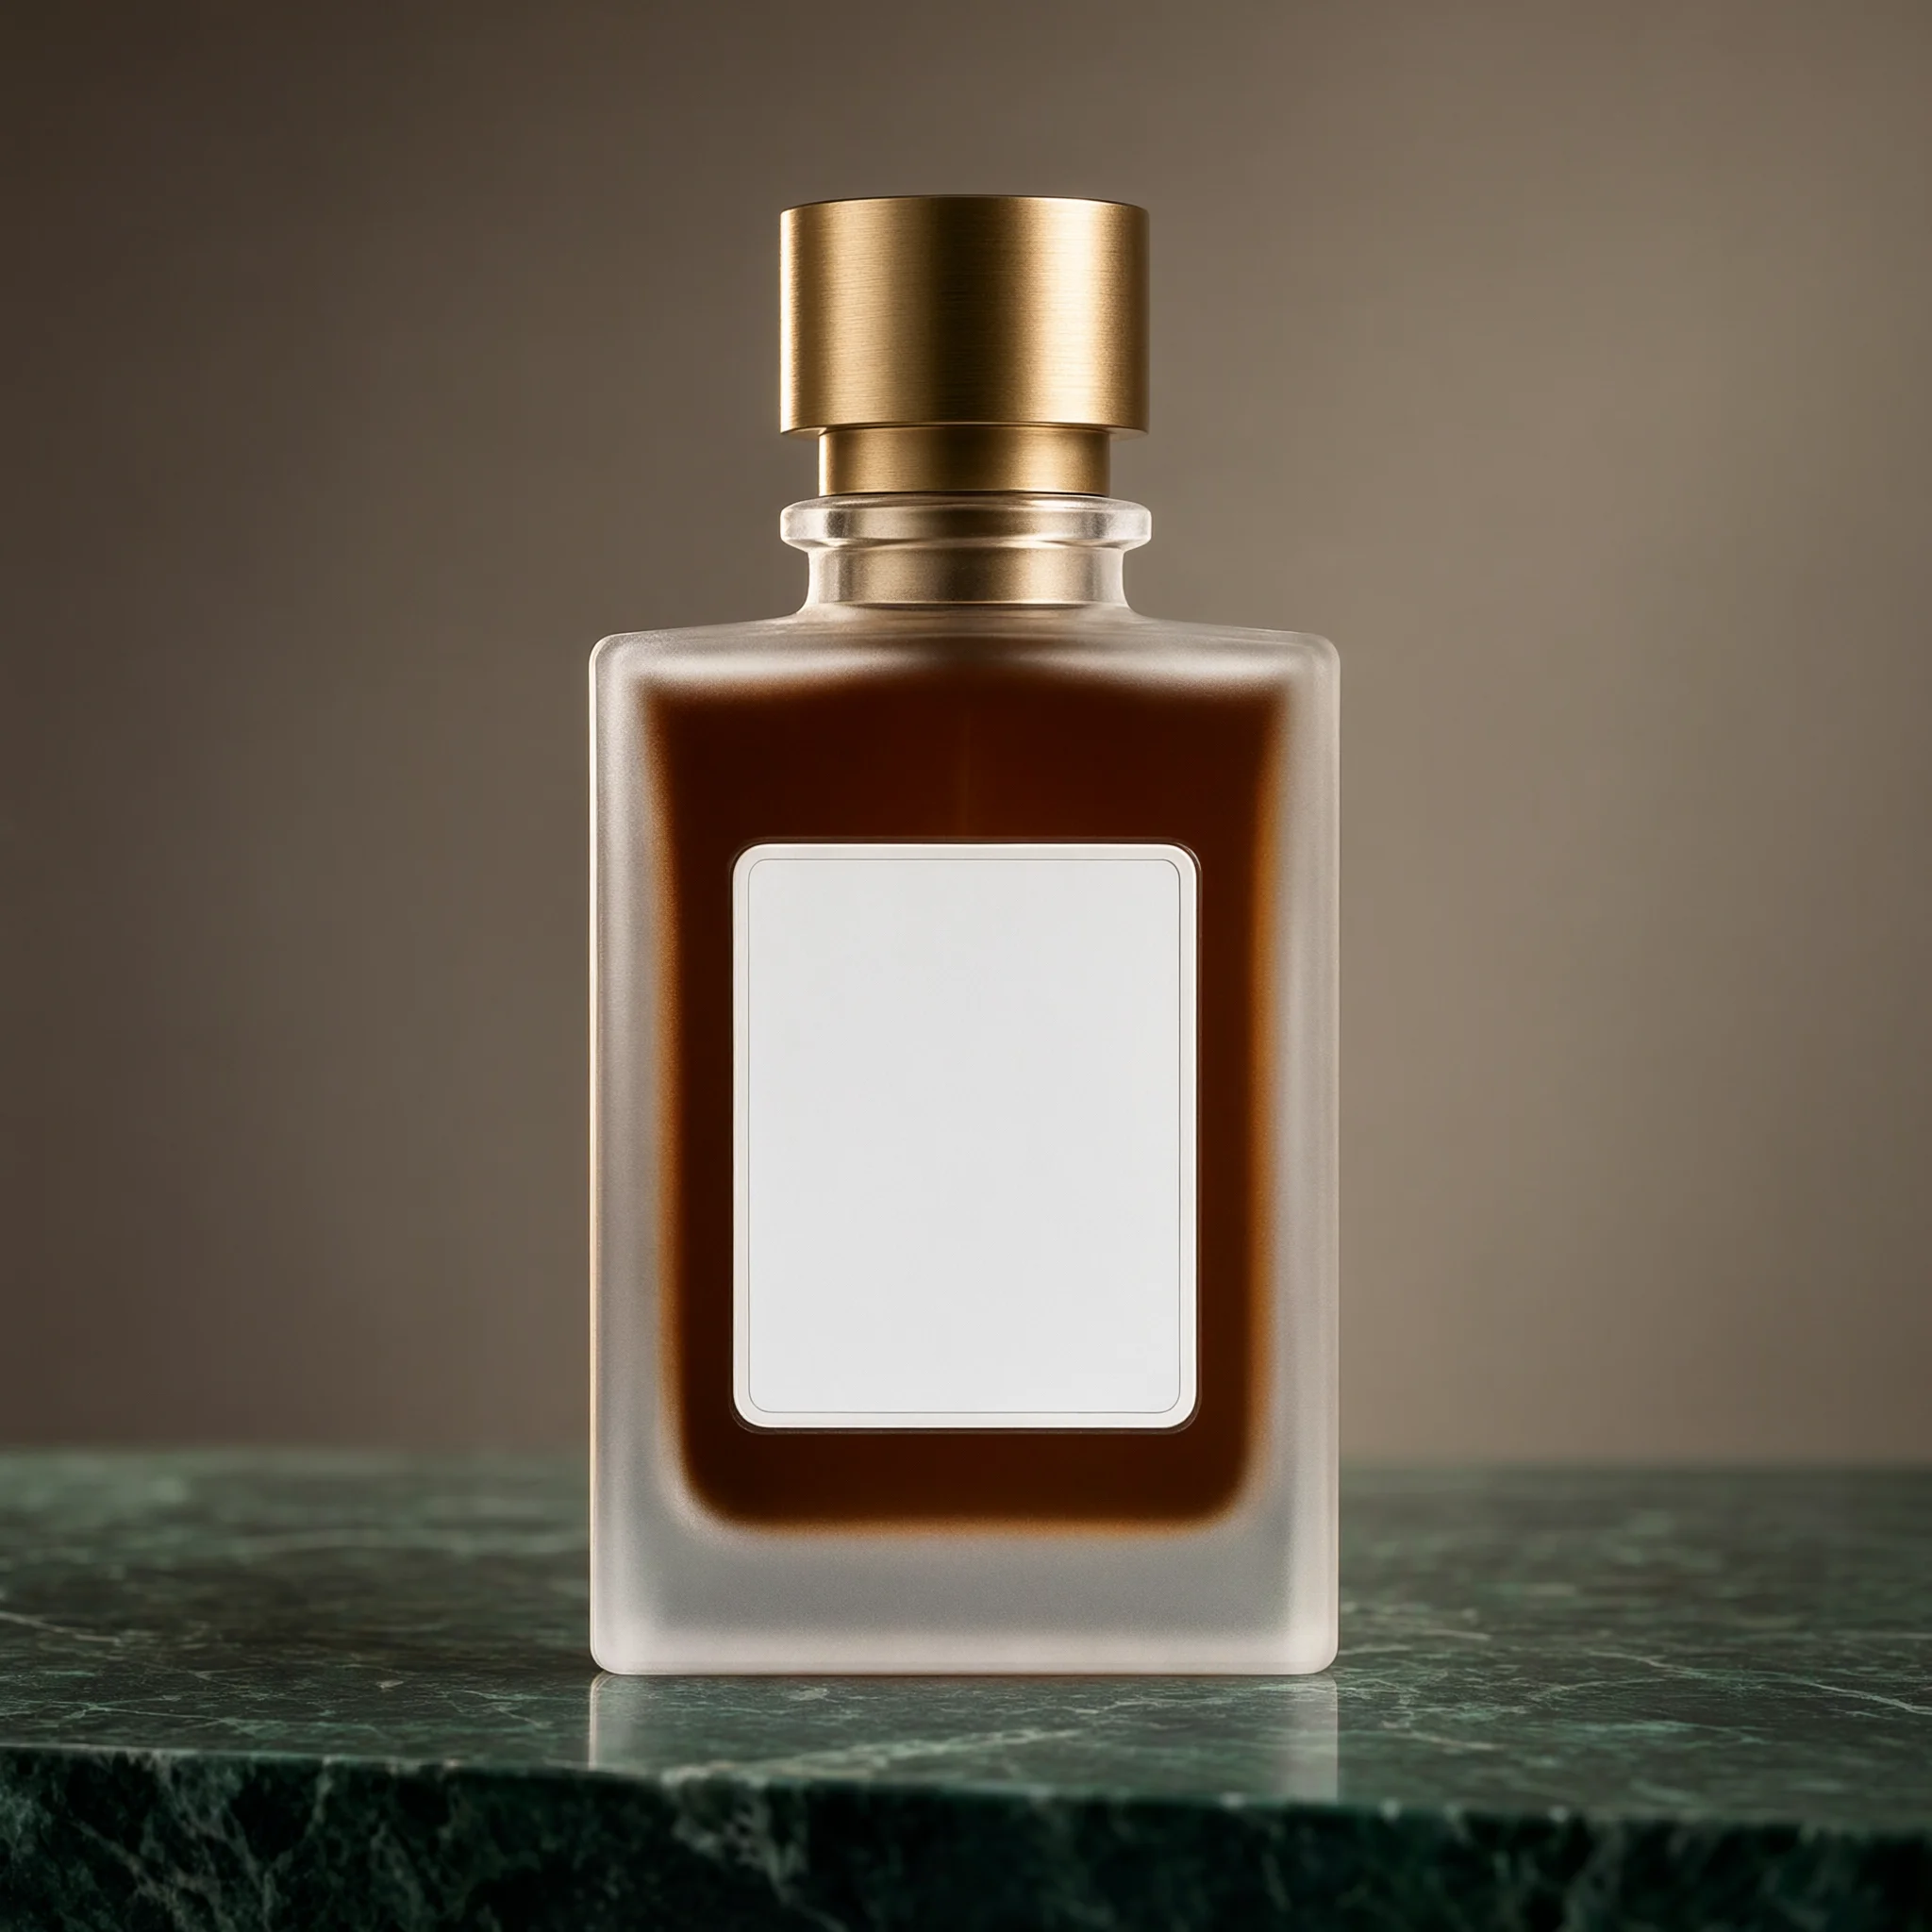
Com base no frasco de perfume da imagem 1, faça uma transformação para imagem de produto de e-commerce: troque o vidro do corpo por uma textura fosca semitransparente, troque a tampa de metal cinza-prateado por latão escovado, mude o líquido interno para âmbar-escuro, coloque o frasco sobre uma bancada de mármore verde-escuro, troque o fundo por uma parede cinza-quente, use luz lateral posterior vinda do canto superior esquerdo para delinear a silhueta do frasco, mantendo inalterados a forma do corpo, as proporções, a altura da tampa e a forma da área do rótulo da imagem 1.
Gerar com este prompt → Ao abrir, envie a foto original do perfume e escolha 1:1.
prompt_extend e fundo transparente
prompt_extend vem com true por padrão; o modelo expande descrições curtas em instruções completas de imagem. Para reproduzir diagramações fixas, pôsteres com texto literal ou quando o prompt já é bastante detalhado, defina false; o modelo segue o texto original à risca.
O fundo transparente é obtido por meio do prompt: escreva "fundo totalmente transparente, apenas o elemento principal, sem blocos de cor de fundo"; a saída PNG pode incluir canal alfa. O resultado é sensível à forma de escrita e não garante transparência total; antes da entrega, verifique o alfa com Image.open(path).getchannel("A").getextrema() e, se precisar de fundo transparente estável, complemente com remoção de fundo.
3 pontos de atenção antes de colocar em produção
- Adicione callback com polling como garantia. No nível superior do corpo da requisição adicione
"callback": {"url": "https://yourapp.com/hook", "when": "final"}para notificação de estado final; callbacks podem se repetir, então deduplique portaskIde mantenha consultas periódicas. - Não faça POST de novo em caso de timeout. Cada envio gera uma nova imagem e uma nova cobrança. Guarde o
taskIde consulte o mesmo ID em caso de instabilidade de rede. - Escreva
aspect_ratioexplicitamente. Se omitido, o modelo escolhe; para fixar a proporção, informe um dos cinco formatos. Não existe o camporesolution; se enviado, ocorre erro. A URL do resultado trazexpireAt; transfira o arquivo assim que obtiver.
Perguntas frequentes
Quantas imagens de referência posso enviar no máximo? De 1 a 10, com no máximo 10MB cada; com várias imagens, refira-se como "imagem 1" e "imagem 2".
É possível escolher 4K? Não. Os cinco formatos correspondem a tamanhos fixos de nível 2K; 1:1 tem no máximo 2048×2048.
O fundo transparente é garantido? Não. O fundo transparente é gerado pelo prompt; após gerar, verifique o canal alfa e, se necessário, complemente com remoção de fundo.
Gere sua primeira imagem agora
Copie o prompt do robô em desenho de linha, abra a página do modelo Qwen Image 2.1 Pro, envie o desenho de linha, escolha 1:1 e gere uma imagem 2048×2048 por $0.05. Para composição com várias imagens, envie a cadeira e a sala em ordem em image_urls e execute novamente. Consulte todos os parâmetros na documentação de integração.
Leitura relacionada: Preço do Qwen Image 2.1 · Qwen Image 2.1 vs GPT Image 2.5 · Guia completo de prompts do Qwen Image 2.1
Artigos relacionados
Ver todos os artigos →-

Tutorial
Casos do Recraft Creative Upscale: upscale de paisagens e aquarela
Veja as mudanças de textura na cabana, no lago e na cidade em aquarela, diferencie o resultado completo da prévia e verifique os detalhes redesenhados.
-

Tutorial
Chave de API da OpenAI inválida: diagnóstico de 401, variáveis de ambiente e configuração de projeto
Diferencie 401, 403 e 429 da OpenAI, verifique variáveis de ambiente e configurações de organização e projeto, e valide as credenciais com uma requisição somente leitura.
-

Tutorial
Coleção de prompts do Kling 4.0: 6 cenas para copiar e gerar vídeos diretamente
Produto de e-commerce, comida, paisagem de viagem, cena cotidiana, plano vazio com som e imagem para vídeo: cada cena traz um vídeo real, o prompt completo e um link de preenchimento com um clique.