
Tutoriale
Come usare l'API Qwen Image 2.1 Pro? Genera e modifica immagini in 5 minuti
Prova online in 5 passi, integrazione API in 4 passi, con curl e Python eseguibili, più image_urls, riferimenti multi-immagine, prompt_extend e come scrivere lo sfondo trasparente.
TL;DR
- Cos'è: Qwen Image 2.1 Pro è ora disponibile su HiAPI. Apri la pagina del modello e scrivi un prompt per generare, oppure carica un'immagine di riferimento per modificare; un ID modello accetta fino a 10 immagini di riferimento, cinque formati di livello 2K,
prompt_extendattivo per impostazione predefinita. I nuovi utenti ricevono 200 crediti alla registrazione. - Quanto costa: $0,05 per immagine (100 crediti), addebitati solo per le immagini generate con successo, indipendentemente dal formato, con rimborso in caso di errore e nessun costo extra per le immagini di riferimento; con $10 circa 200 immagini. Turbo con lo stesso contratto a $0,02/immagine.
- Come chiamarla velocemente: scrivi un prompt nella pagina del modello e avvia; per integrare nel prodotto usa
POST https://api.hiapi.ai/v1/tasksconmodelimpostato aqwen-image-2.1-pro.
Cos'è Qwen Image 2.1 Pro? Cosa c'è di nuovo rispetto alla 2.0
Generazione e modifica condividono lo stesso ID modello: senza image_urls genera una nuova immagine, con image_urls modifica in base alle immagini di riferimento, senza cambiare endpoint.
Quattro differenze rispetto alla 2.0 (la 2.0 usava size per specificare liberamente i pixel, la 2.1 è passata a valori per formato):
- Un solo ID per due compiti. Generazione e modifica condividono lo stesso ID; la richiesta differisce solo per
image_urls. - Fino a 10 immagini di riferimento. Immagini di prodotto e di scena possono essere inviate insieme, referenziate come "immagine 1", "immagine 2".
- Cinque formati di livello 2K. 1:1 2048×2048, 16:9 2688×1536, 9:16 1536×2688, 4:3 2368×1728, 3:4 1728×2368; nessun campo
resolution. prompt_extendattivo per impostazione predefinita. Il modello espande automaticamente il prompt; per layout rigorosi o replica esatta del testo impostarefalse.
Dal disegno a linee al giocattolo 3D è una singola richiesta di modifica; forma, proporzioni e posa dell'immagine originale vengono preservate:
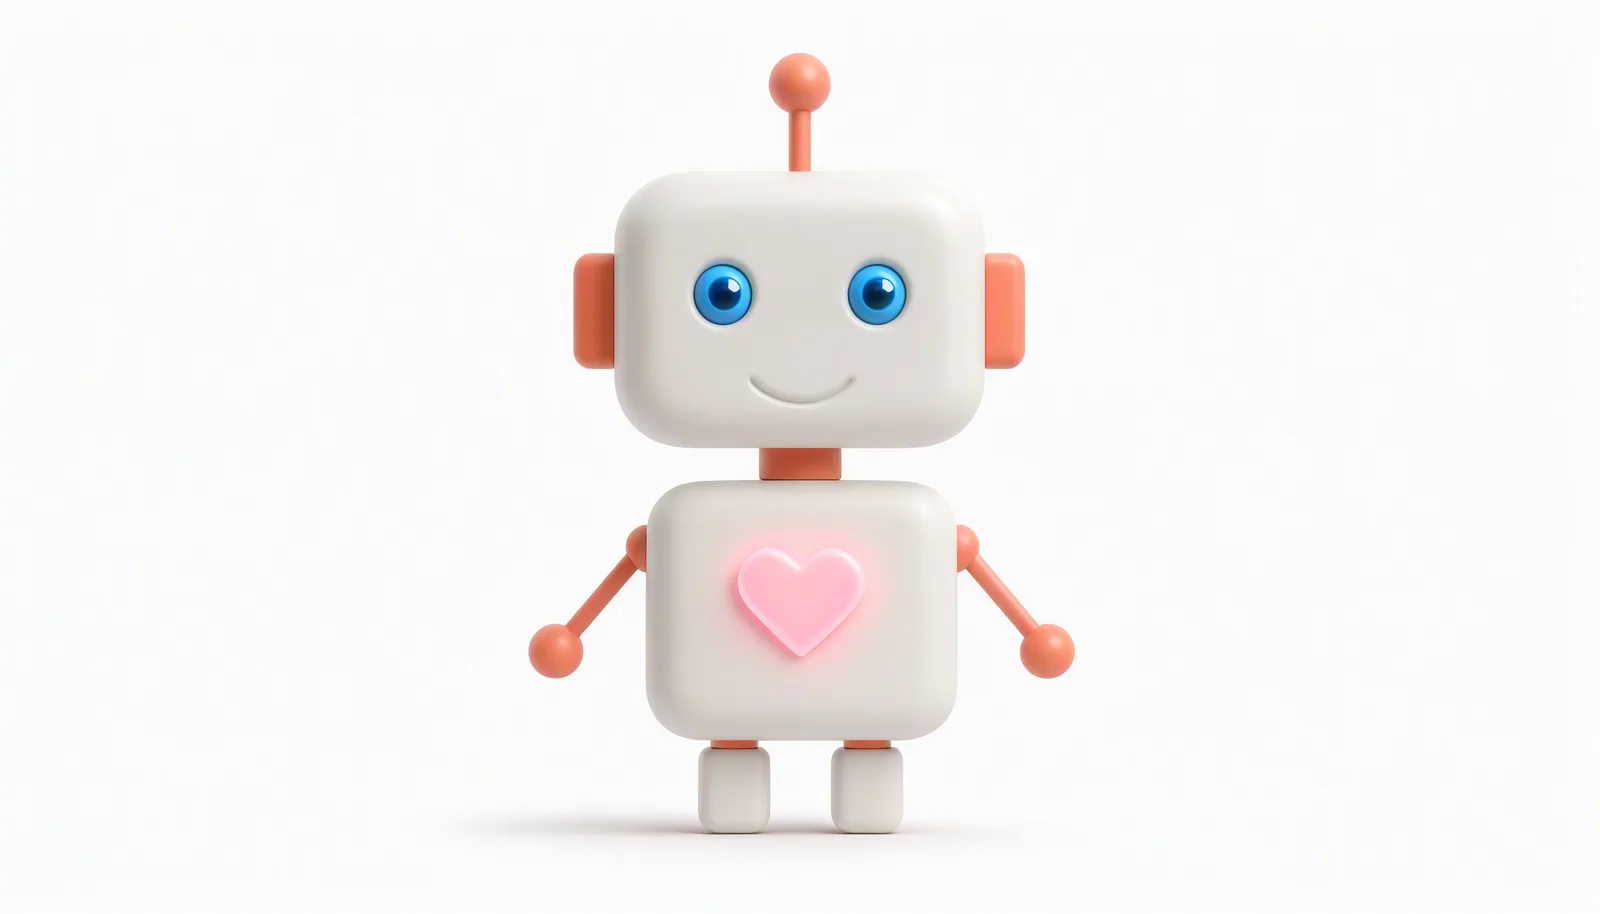
Trasforma il robot a linee dell'immagine di riferimento in un raffinato giocattolo cartoon 3D: guscio bianco opaco con giunture, orecchie e antenna color corallo-arancio, il cuore sul petto emette una morbida luce rosa, gli occhi sono blu brillante, mantieni forma, proporzioni e posa originali, luce morbida da studio, sfondo pulito grigio chiaro biancastro, mantieni solo il soggetto robot.
Genera con questo prompt → il link precompila solo il prompt; dopo l'apertura carica il disegno a linee e scegli 1:1.
Prova online: 5 passi per la prima immagine
- Apri la pagina del modello Qwen Image 2.1 Pro; 200 crediti bastano per 2 immagini Pro.
- Scrivi il prompt; per la modifica carica prima da 1 a 10 immagini di riferimento in
image_urls. - Scegli il formato, oppure lascia vuoto per far scegliere al modello.
prompt_extendè attivo per impostazione predefinita; per poster cinesi con layout rigoroso disattivalo prima.- Invia e scarica l'immagine generata.
Integrazione API: 4 passi
- Crea una API Key nella console.
POST https://api.hiapi.ai/v1/tasksconmodelimpostato aqwen-image-2.1-pro.- Dopo aver ottenuto il
taskId, interroga con pollingGET /v1/tasks/{taskId}oppure configuracallback. - Quando
statusèsuccess, scarica l'immagine daoutput[0].url.
curl eseguibile: generazione
curl -s -X POST https://api.hiapi.ai/v1/tasks \
  -H "Authorization: Bearer YOUR_API_KEY" \
  -H "Content-Type: application/json" \
  -d '{
    "model": "qwen-image-2.1-pro",
    "input": {
      "prompt": "Un poster minimalista per un evento in cinese, sfondo di carta bianco crema, al centro impagina solo le seguenti tre righe di testo cinese tutte centrate orizzontalmente: la prima riga è un grande testo serif nero \"Festa del tè di primavera\", la seconda riga è un testo medio grigio scuro \"28 marzo, ore 14:00\", la terza riga è un piccolo testo grigio \"Casa del tè a sud della città, ingresso gratuito\". Spaziatura uniforme, ampio spazio bianco ai bordi, oltre a queste tre righe nessun altro testo, forma, linea o decorazione nell'immagine, finitura stampata opaca.",
      "aspect_ratio": "3:4",
      "prompt_extend": false,
      "seed": 42
    }
  }'
L'ID del task è in data.taskId:
curl -s https://api.hiapi.ai/v1/tasks/YOUR_TASK_ID \
  -H "Authorization: Bearer YOUR_API_KEY"
data.status passa per queued, handling, archiving, success o fail; archiving significa che è ancora in fase di confezionamento, non è un errore.
Versione Python: creare, fare polling, scaricare
import time
import requests

BASE = "https://api.hiapi.ai/v1/tasks"
HEADERS = {"Authorization": "Bearer YOUR_API_KEY"}

payload = {
    "model": "qwen-image-2.1-pro",
    "input": {
        "prompt": "Uno shiba inu con cappello di paglia su una tavola da surf, stile adesivo piatto, colori corallo-arancio e blu mare, sfondo a tinta unita.",
        "aspect_ratio": "1:1",
        "seed": 42,
    },
}

task_id = requests.post(BASE, headers=HEADERS, json=payload, timeout=30).json()["data"]["taskId"]

while True:
    data = requests.get(f"{BASE}/{task_id}", headers=HEADERS, timeout=30).json()["data"]
    if data["status"] in ("success", "fail"):
        break
    time.sleep(3)

if data["status"] == "success":
    with open("qwen-image.png", "wb") as f:
        f.write(requests.get(data["output"][0]["url"], timeout=60).content)
    print("saved qwen-image.png")
else:
    print(data.get("error"))
Differenza tra generazione e modifica: image_urls
Senza image_urls si genera una nuova immagine; con 1 si fa modifica singola; con 2–10 si fa riferimento multi-immagine. Le immagini di riferimento supportano JPG/JPEG/PNG/BMP/TIFF/WEBP/GIF, singola ≤10MB, larghezza e altezza 1–8000px, rapporto lato lungo/lato corto ≤10:1.
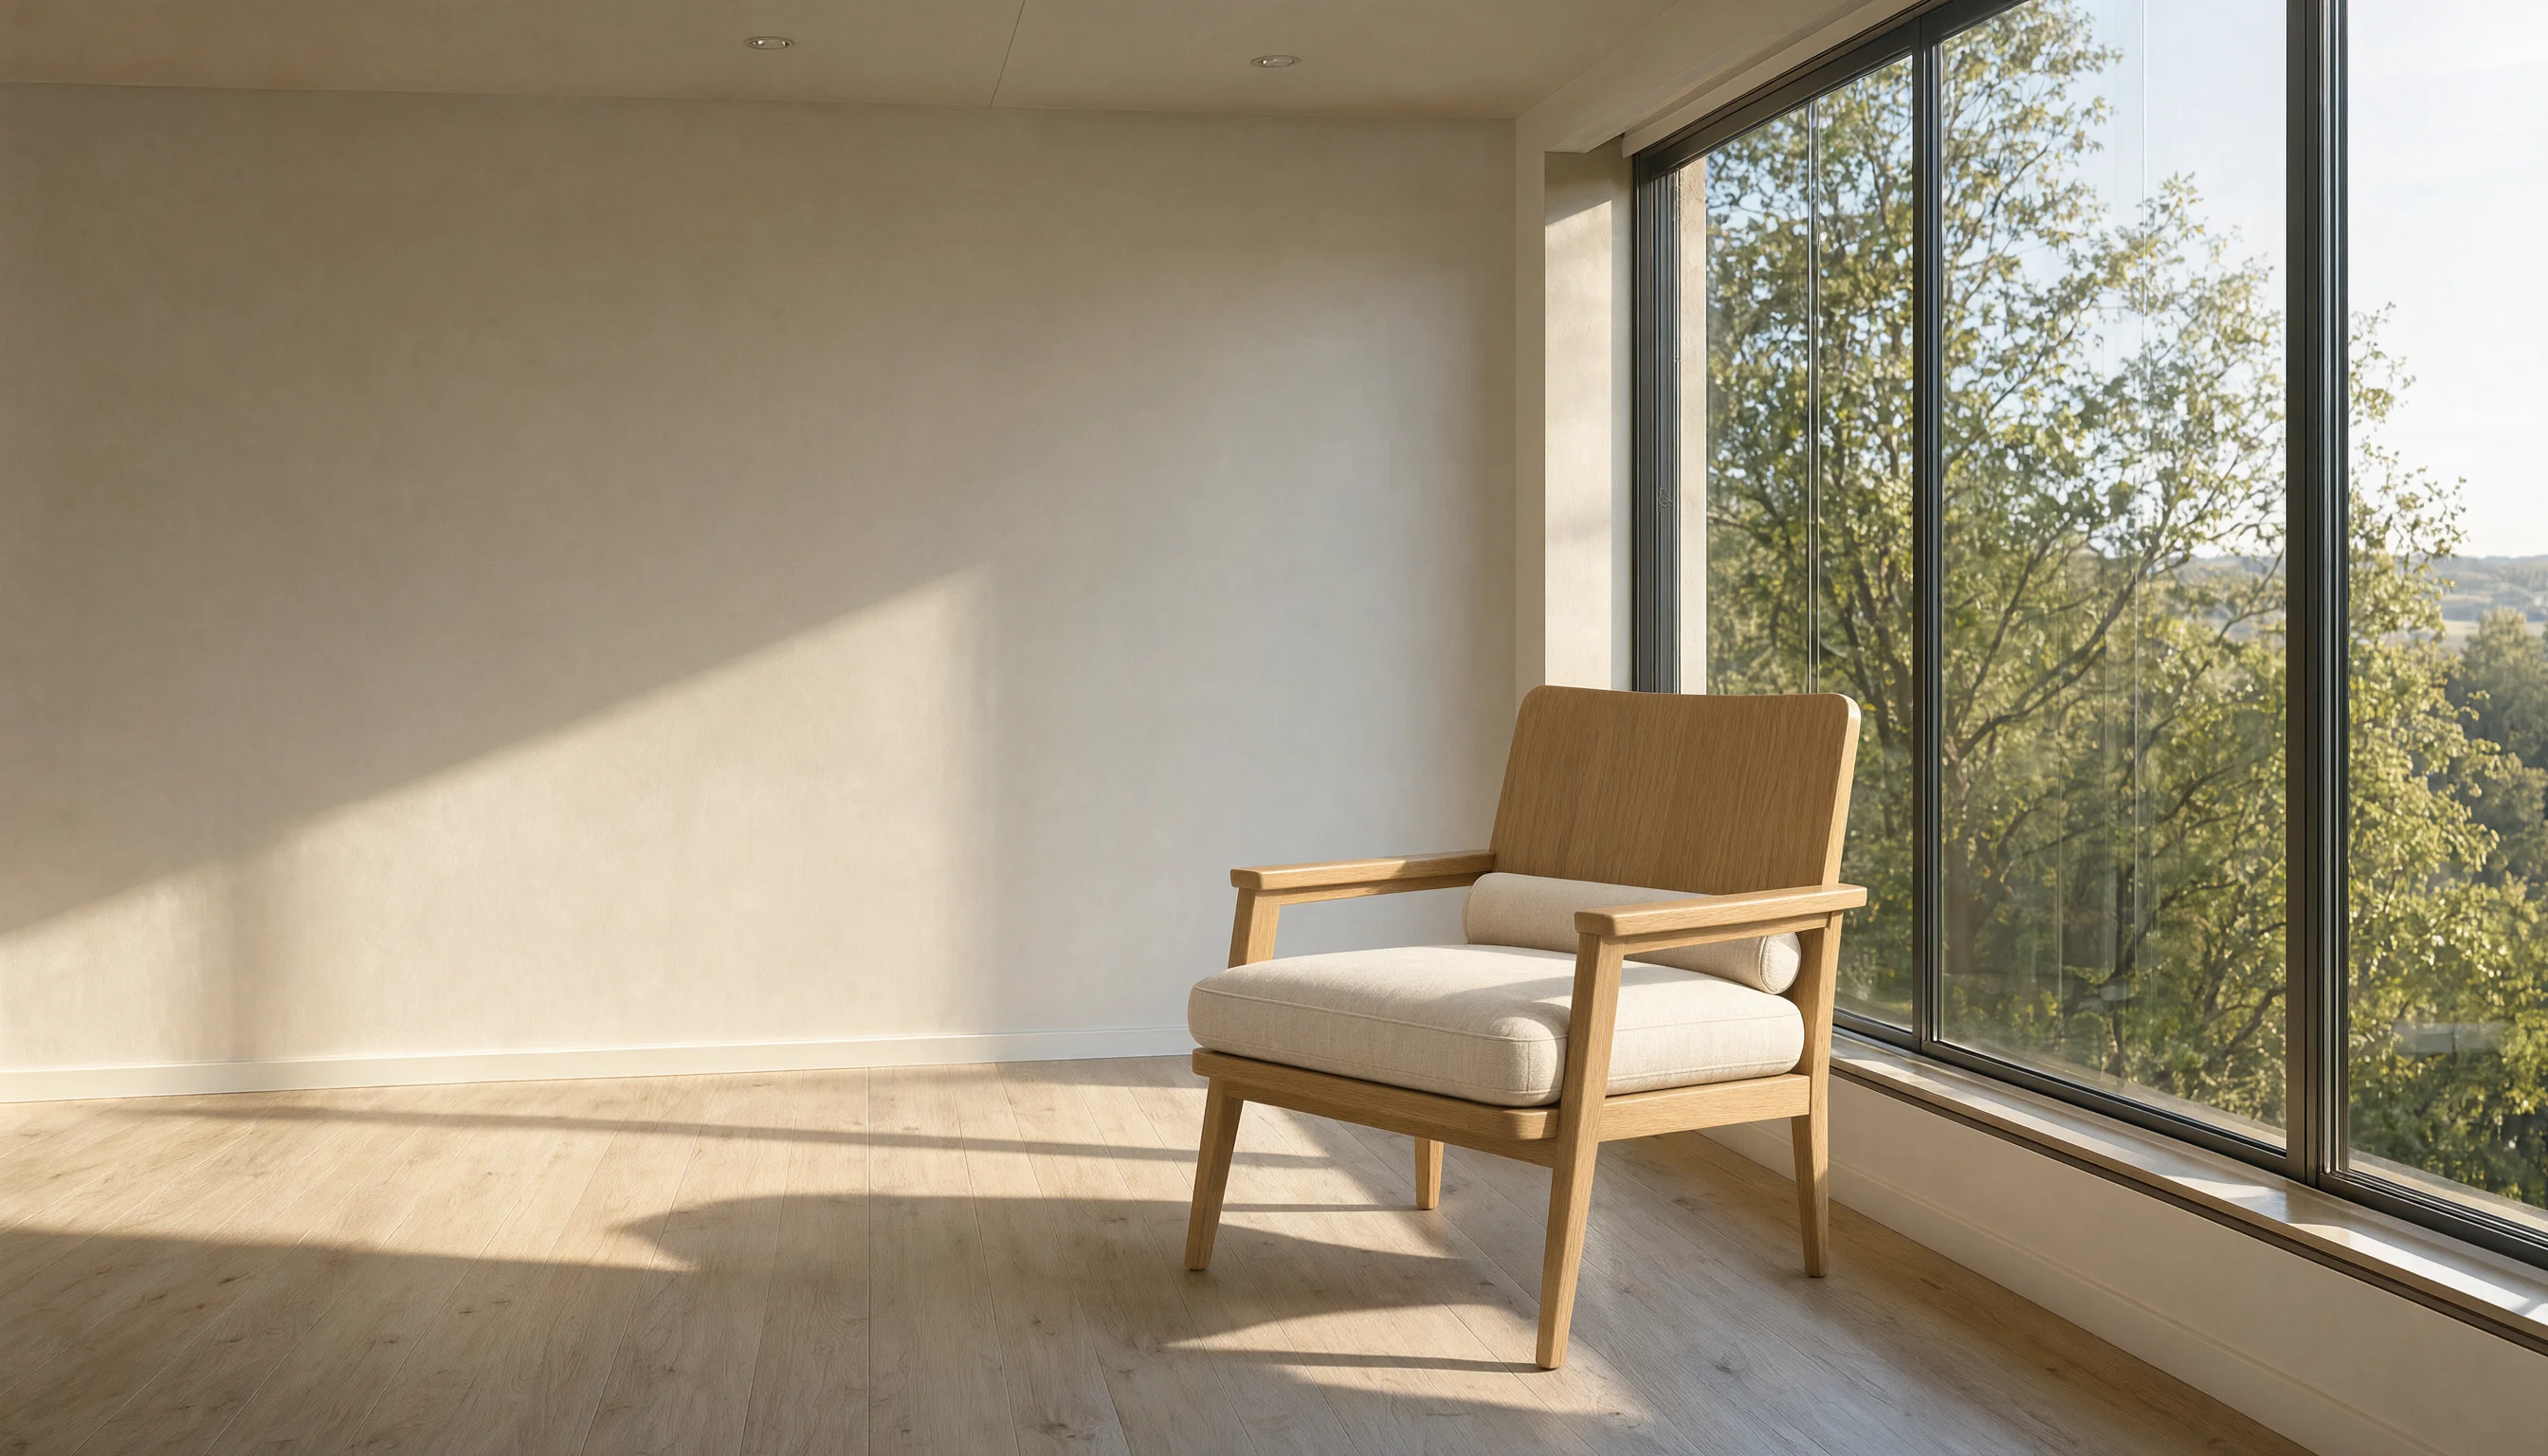
Con più immagini, l'ordine dell'array image_urls corrisponde a "immagine 1", "immagine 2" nel prompt. Questa sedia inserita in un soggiorno usa due immagini di riferimento e un prompt:
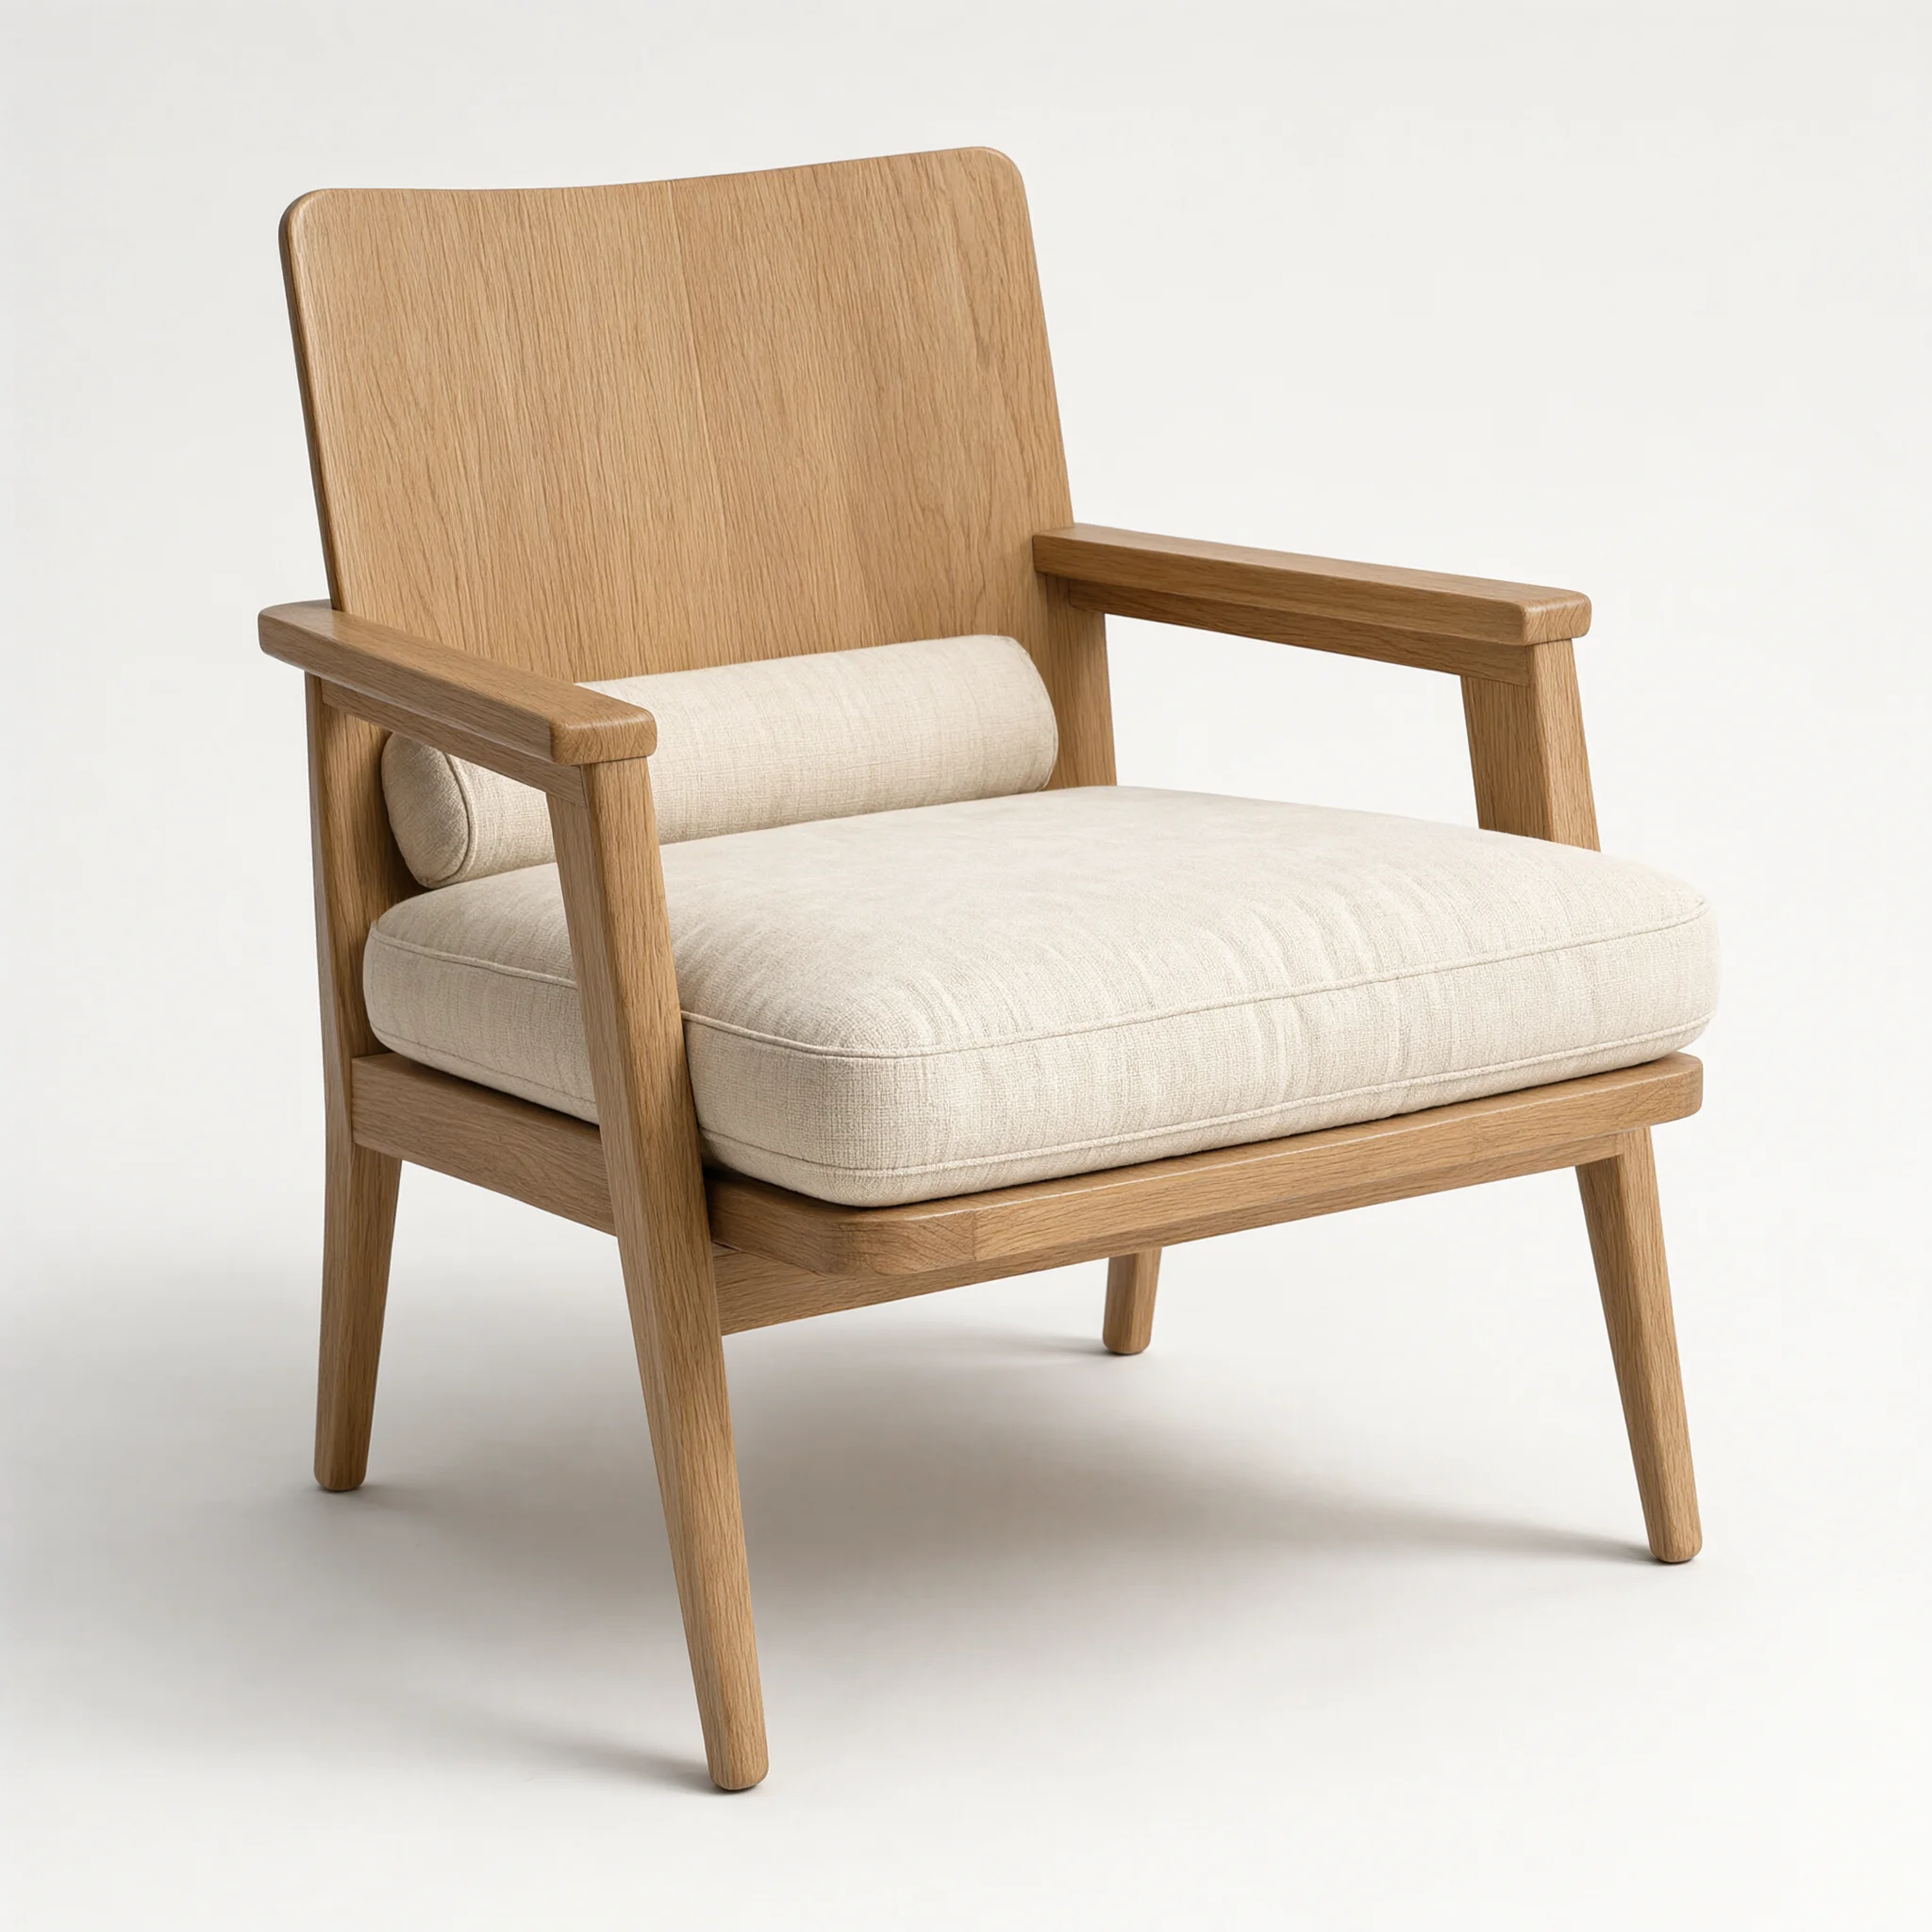
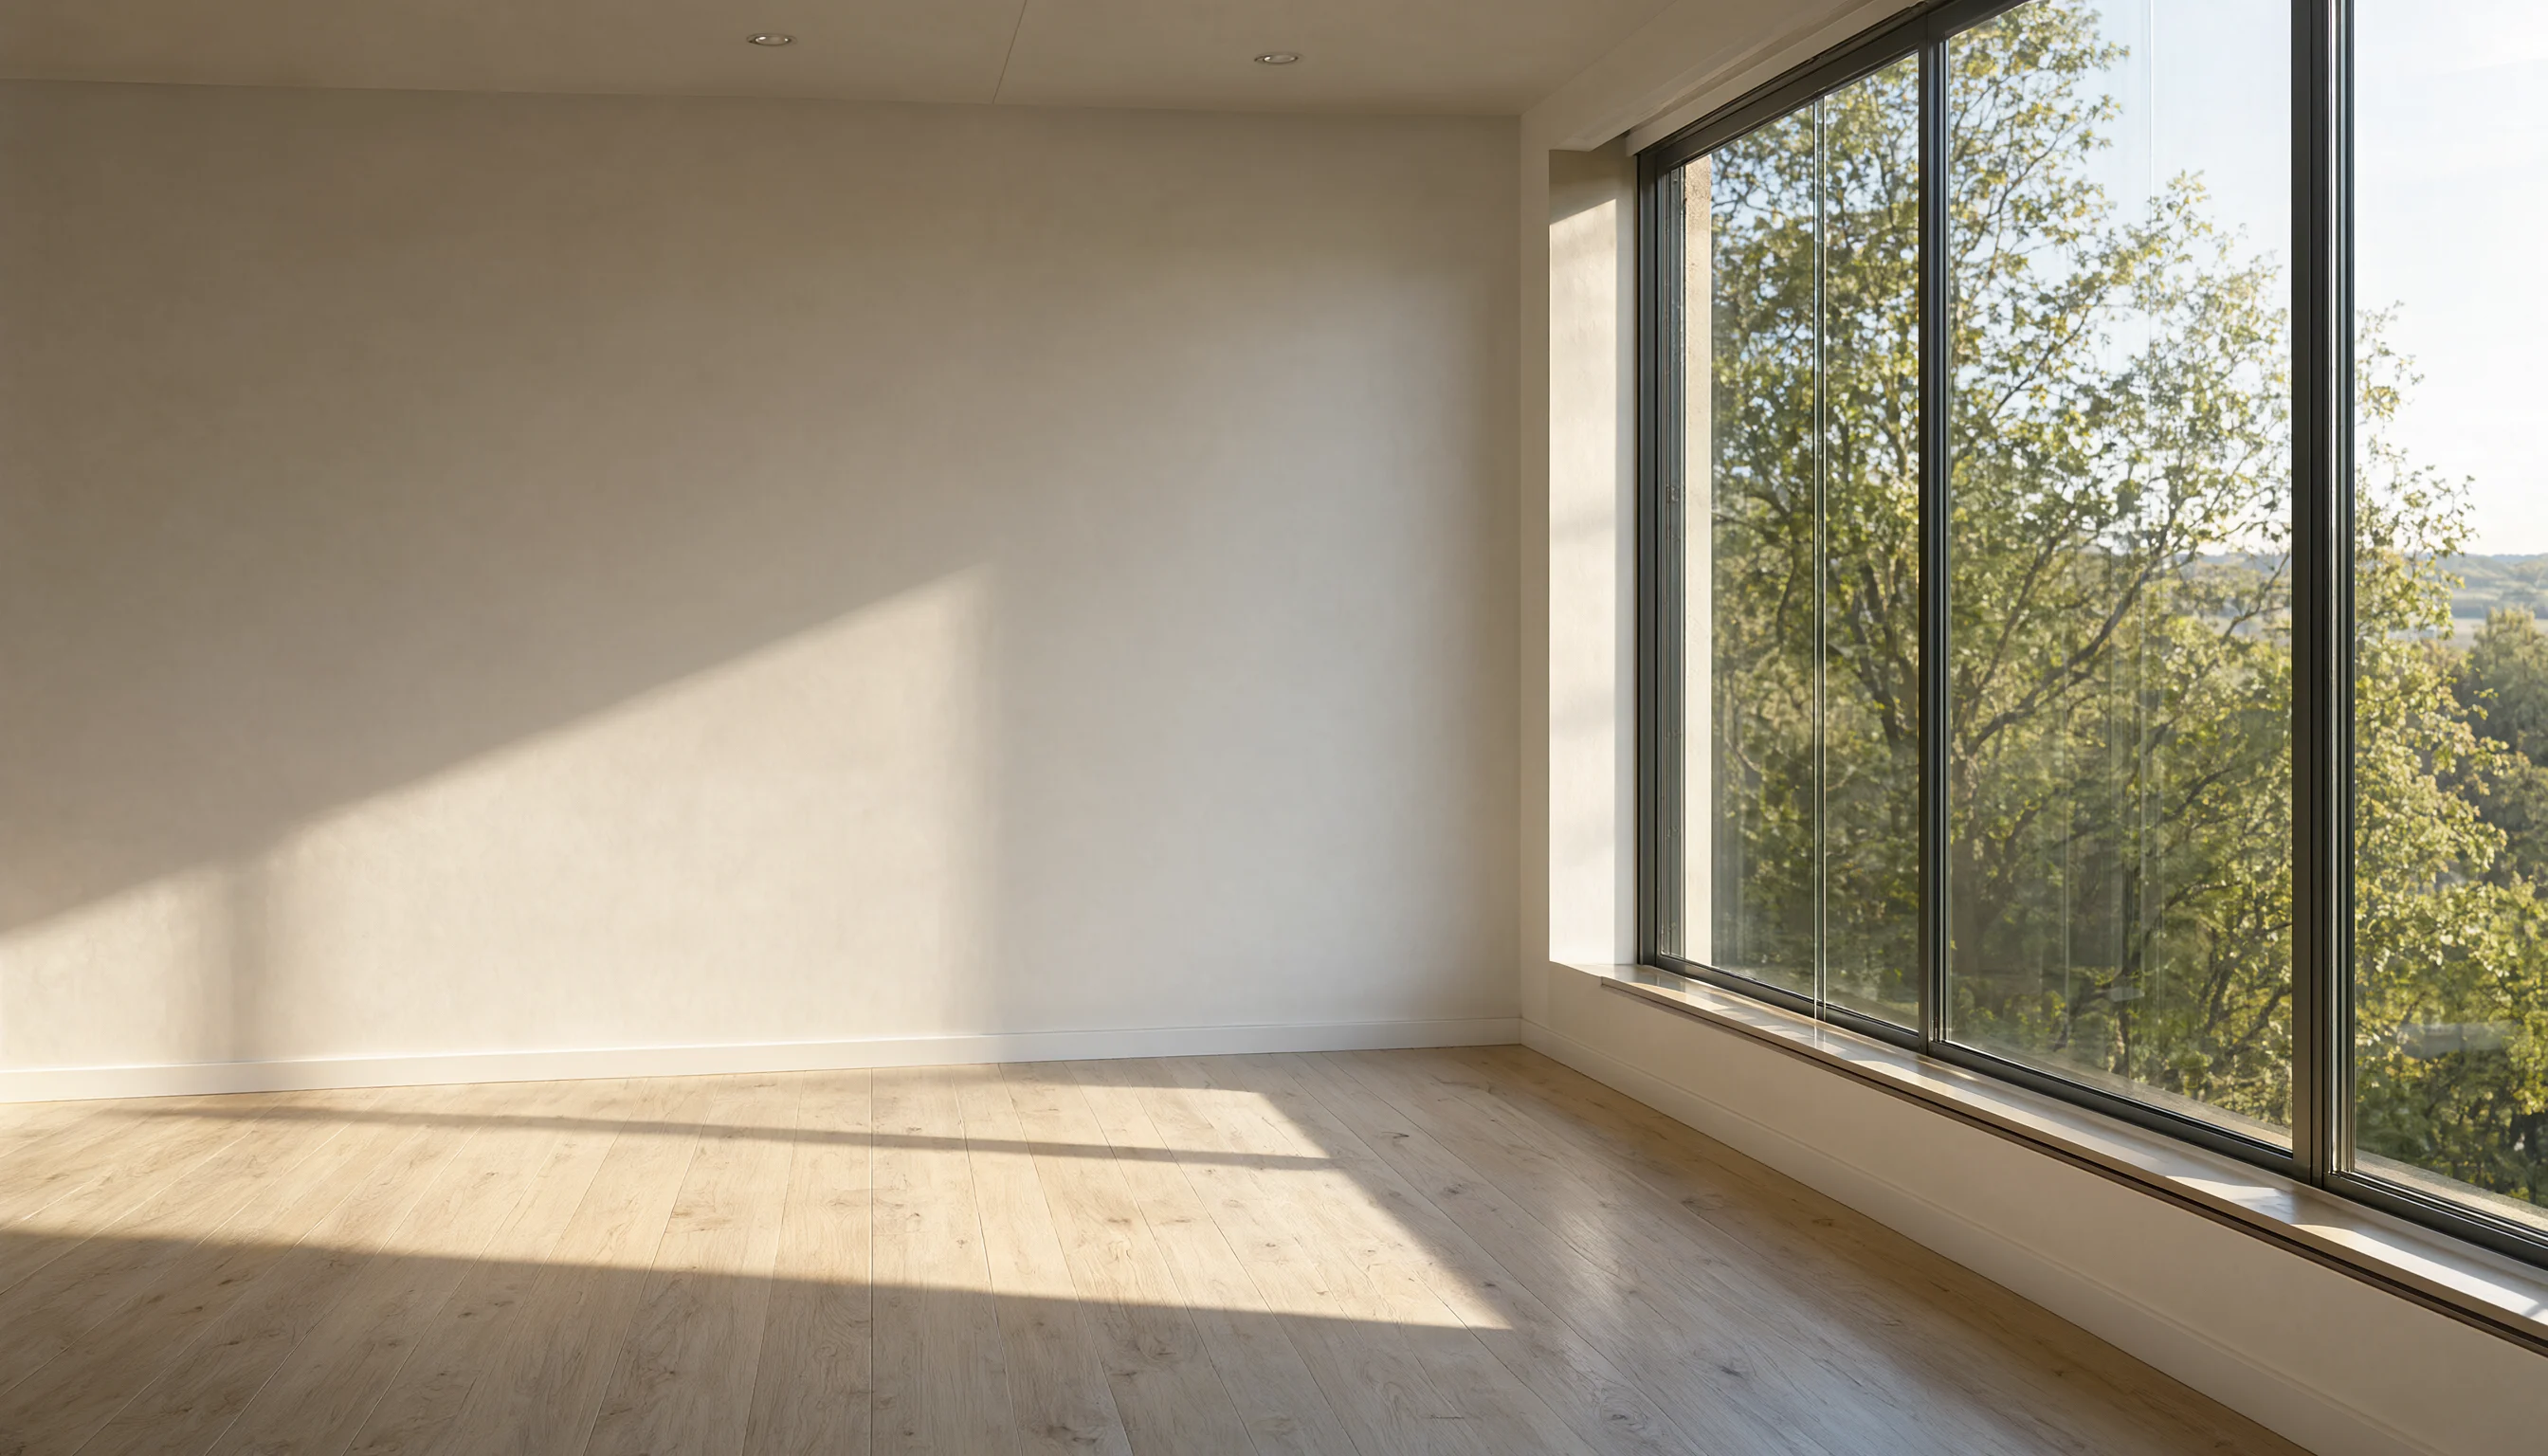
Inserisci la poltrona in quercia dell'immagine 1 nel soggiorno dell'immagine 2, posiziona la poltrona sulla macchia di luce sul pavimento davanti alla porta finestra, mantieni l'orientamento coerente con l'immagine 1, aggiungi per la poltrona ombre a terra e ombre di contatto coerenti con la scena, mantieni completamente invariati pareti, pavimento in legno, battiscopa, infissi e vista esterna della stanza dell'immagine 2, uniforma tutto con una calda luce naturale laterale pomeridiana biancastra.
Genera con questo prompt → dopo l'apertura carica in ordine l'immagine 1 (poltrona) e l'immagine 2 (soggiorno); se inverti l'ordine anche il risultato si inverte.
La modifica a immagine singola usa anch'essa image_urls; questo flacone di profumo cambia solo materiale e scena:
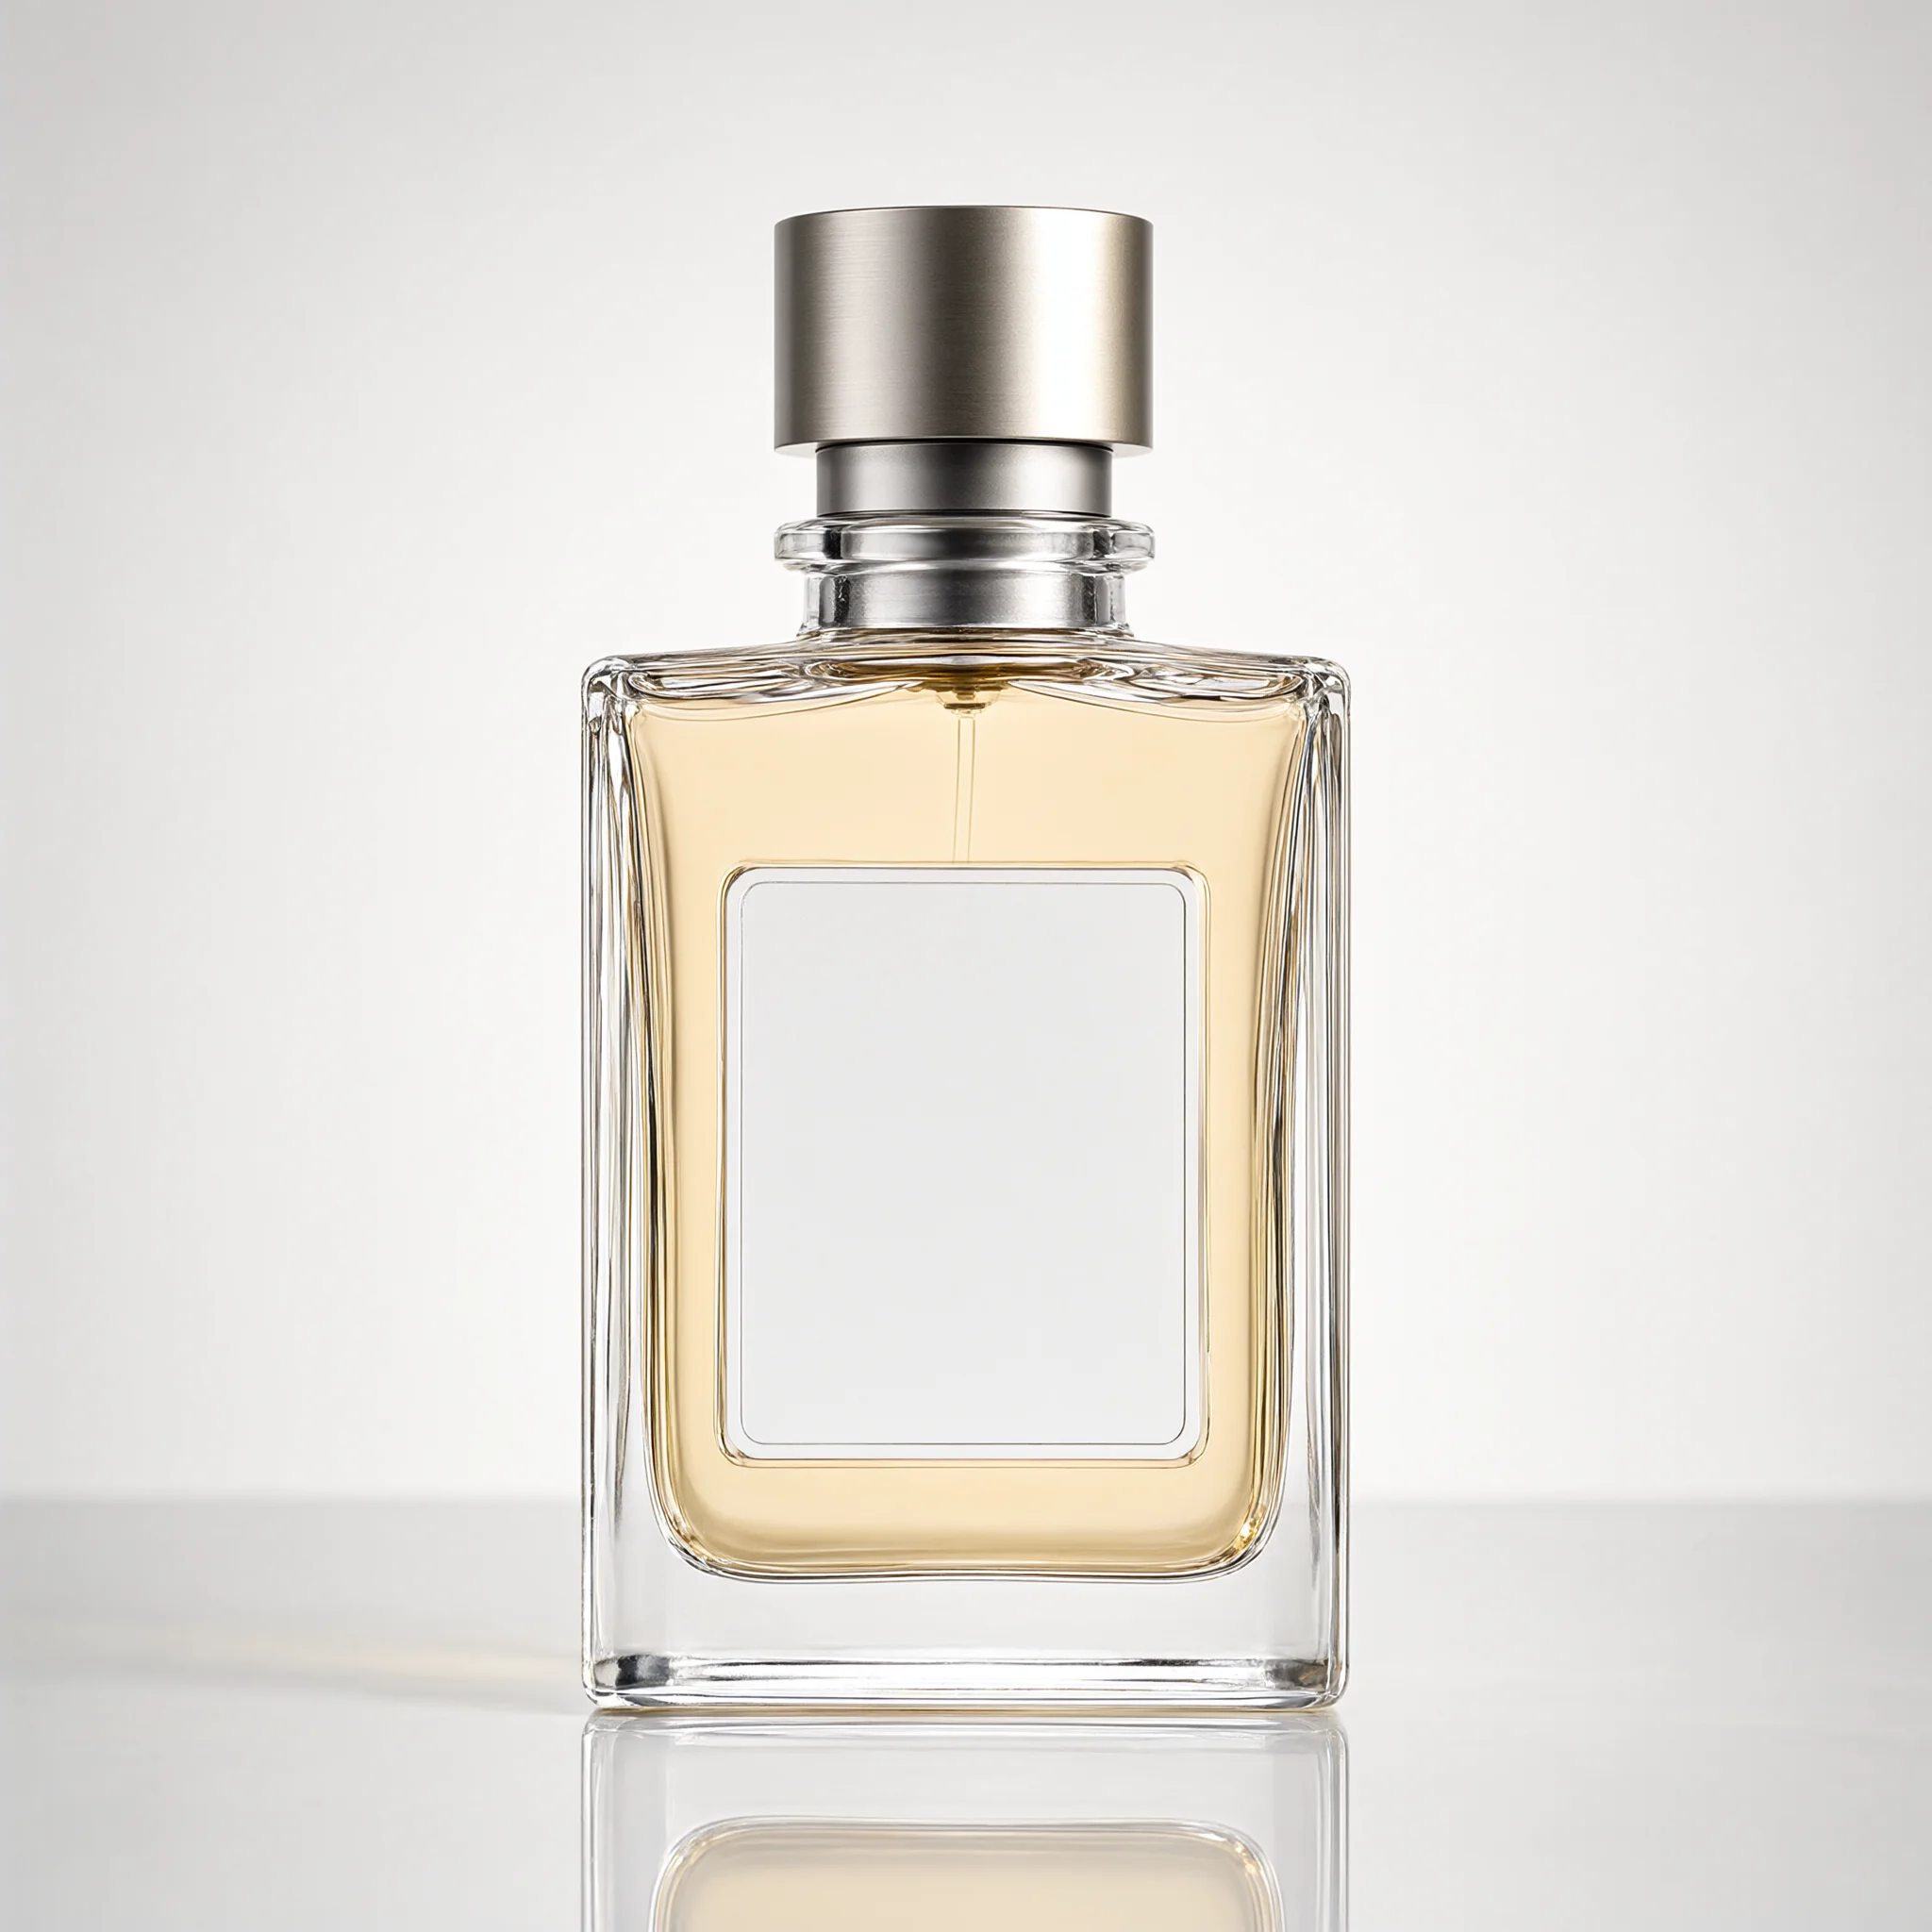
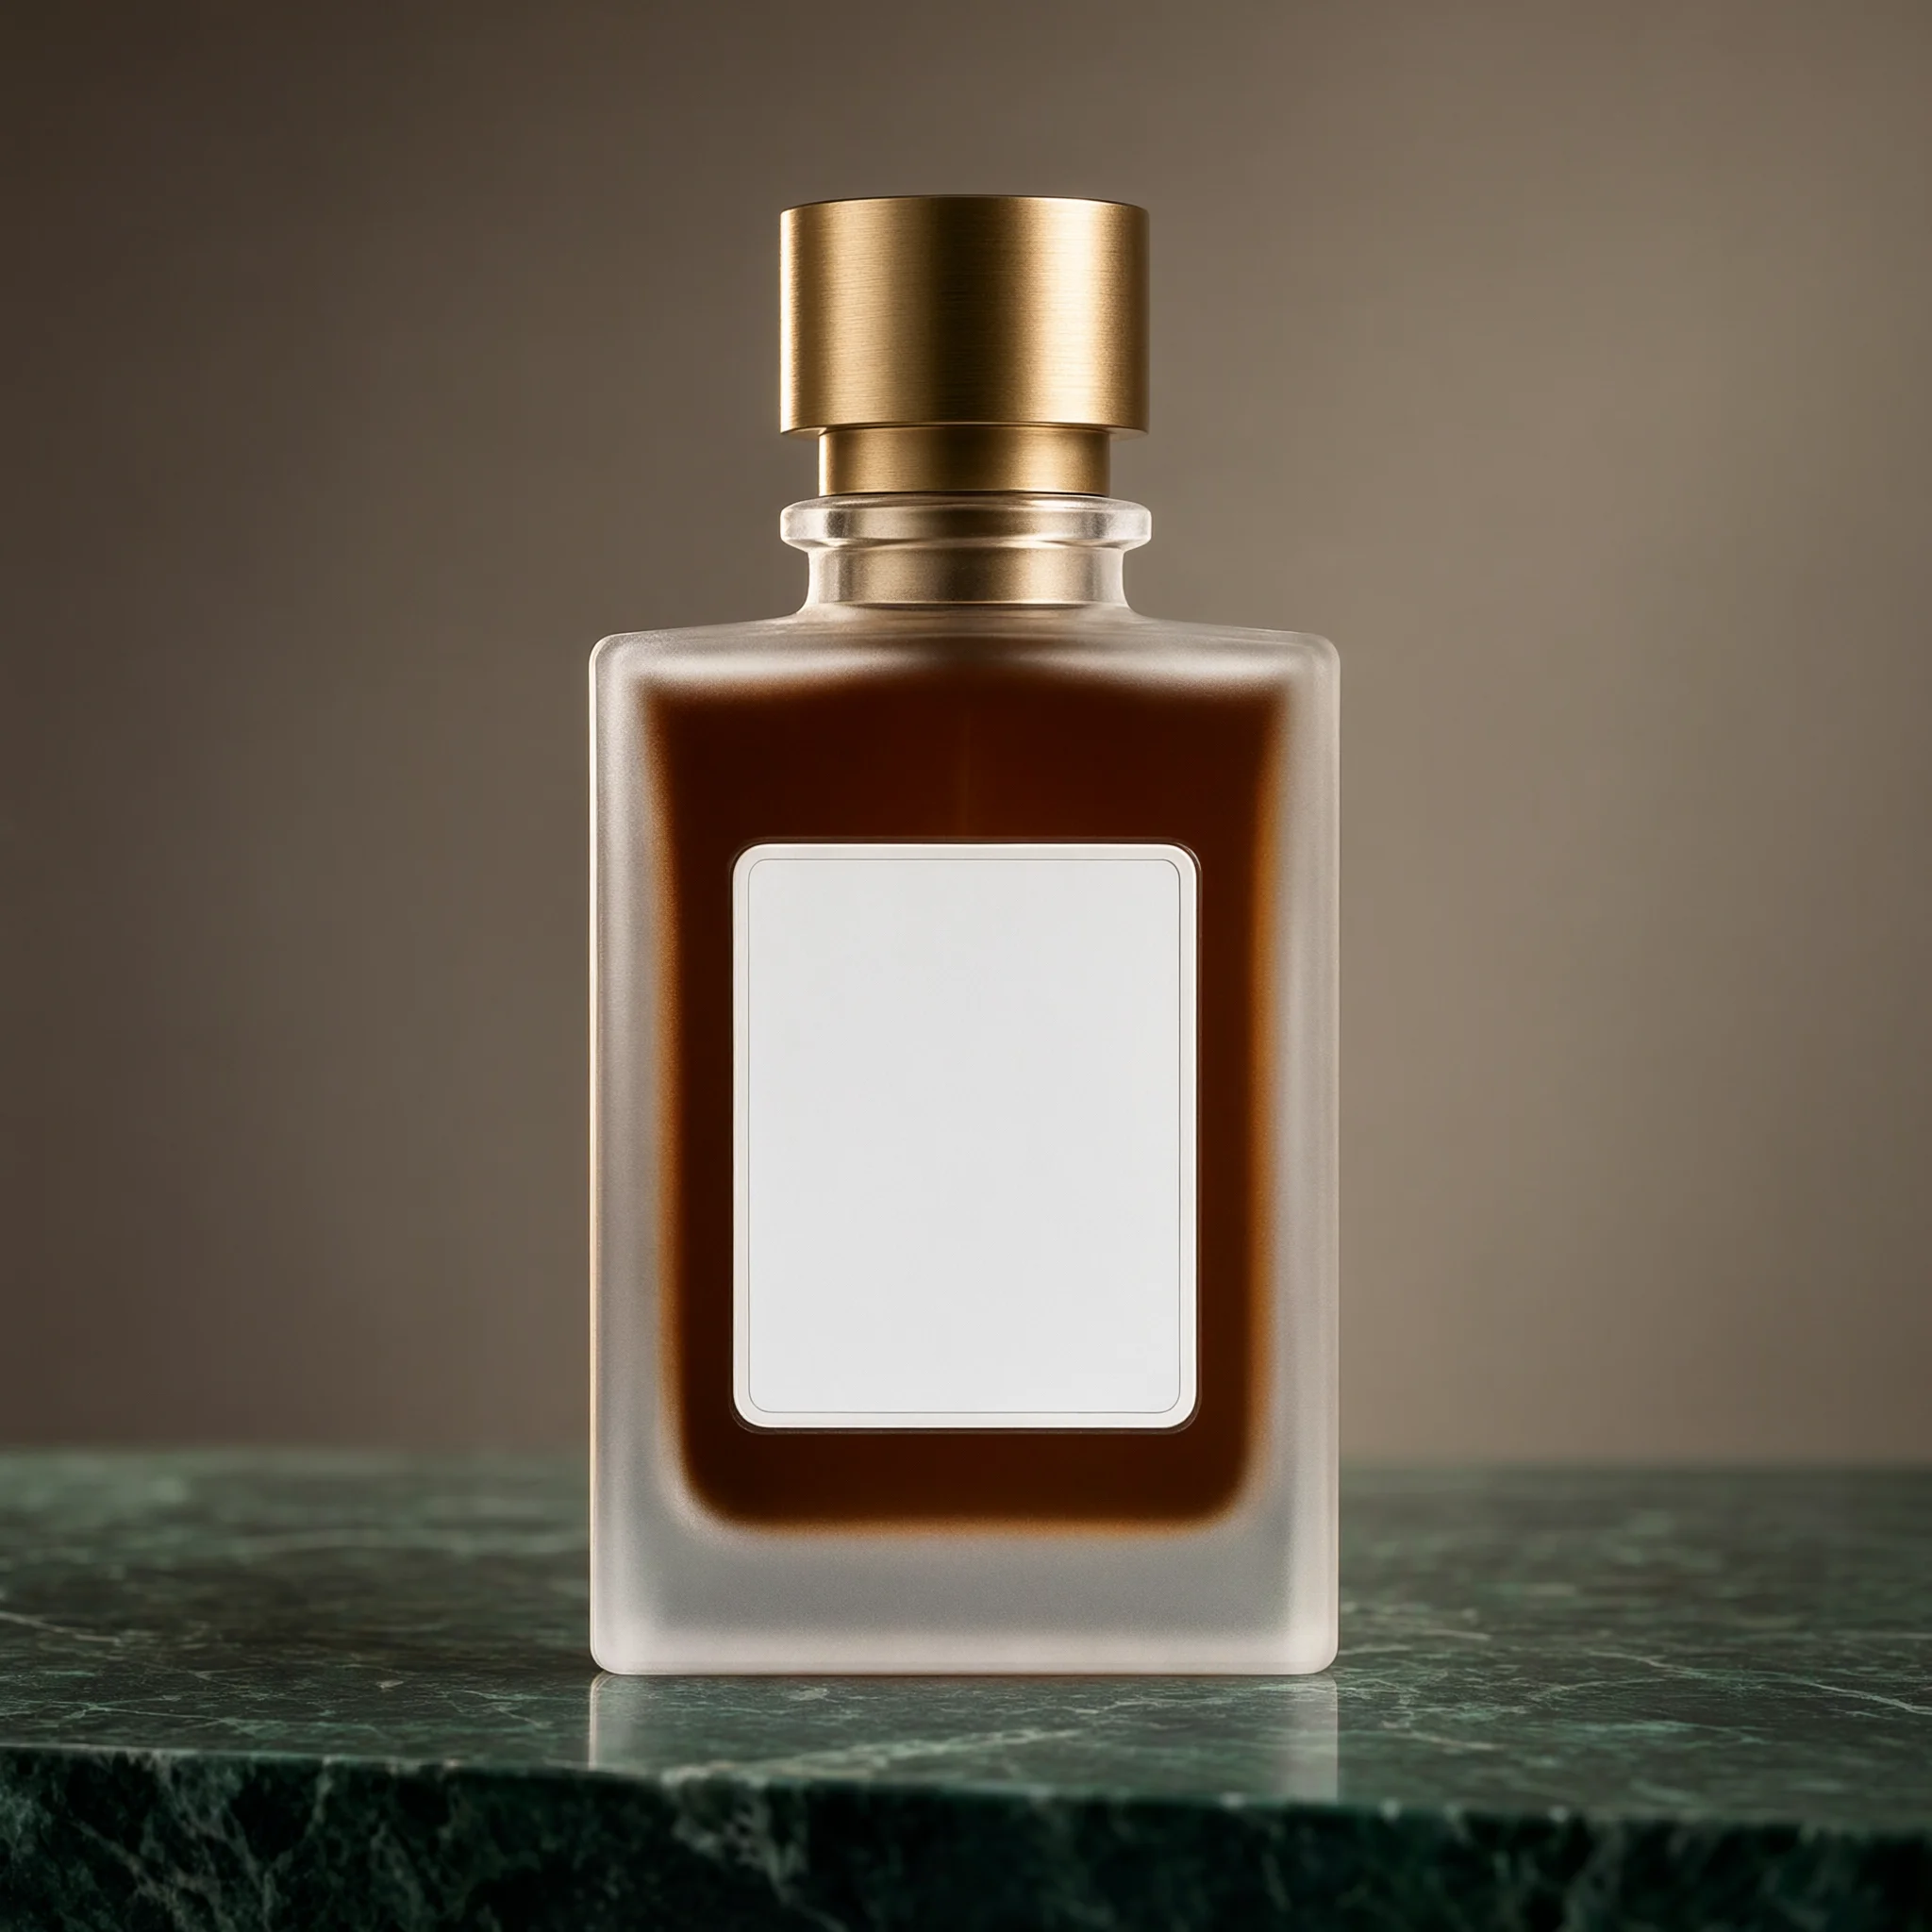
Basandoti sul flacone di profumo dell'immagine 1, realizza una rielaborazione per foto prodotto e-commerce: trasforma il vetro del corpo in una finitura satinata semitrasparente, sostituisci il tappo in metallo grigio argento con ottone spazzolato, cambia il liquido interno in ambra scuro, posiziona il flacone su un piano in marmo verde scuro, cambia lo sfondo in una parete grigio caldo, con luce laterale posteriore dall'alto a sinistra che delinea il profilo del flacone, mantieni invariati forma del corpo, proporzioni, altezza del tappo e forma dell'area etichetta dell'immagine 1.
Genera con questo prompt → dopo l'apertura carica l'immagine originale del profumo e scegli 1:1.
prompt_extend e sfondo trasparente
prompt_extend è true per impostazione predefinita; il modello espande una breve descrizione in istruzioni complete per l'immagine. Per replicare layout fissi, poster con testo letterale, o quando il prompt è già molto dettagliato, imposta false: il modello esegue rigorosamente il testo originale.
Lo sfondo trasparente si ottiene tramite il prompt: scrivi "sfondo completamente trasparente, mantieni solo il soggetto, nessun blocco di colore di sfondo"; il PNG di output può avere un canale alpha. Il risultato è sensibile alla formulazione e non garantisce la piena trasparenza; prima della consegna controlla l'alpha con Image.open(path).getchannel("A").getextrema() e, se serve uno sfondo trasparente stabile, aggiungi una rimozione dello sfondo.
3 cose da fare attenzione prima del rilascio
- Aggiungi il polling come fallback al callback. Aggiungi al livello superiore del corpo della richiesta
"callback": {"url": "https://yourapp.com/hook", "when": "final"}per la notifica dello stato finale; il callback può ripetersi, deduplica pertaskIde mantieni la query periodica. - In caso di timeout non inviare di nuovo POST. Ogni invio è una nuova immagine e un nuovo addebito. Salva il
taskIde, in caso di instabilità di rete, interroga lo stesso ID. - Specifica esplicitamente
aspect_ratio. Se non lo scrivi, lo sceglie il modello; per un rapporto fisso scrivi uno dei cinque valori. Non esiste il camporesolution; se lo passi, restituisce errore. L'URL del risultato haexpireAt: salvalo non appena lo ricevi.
Domande frequenti
Quante immagini di riferimento posso inviare al massimo? Da 1 a 10, singola non superiore a 10MB; con più immagini si fa riferimento con "immagine 1", "immagine 2".
Posso scegliere 4K? No. I cinque formati corrispondono a dimensioni fisse di livello 2K, 1:1 massimo 2048×2048.
Lo sfondo trasparente è garantito? No. Lo sfondo trasparente si ottiene tramite il prompt; dopo la generazione controlla il canale alpha e, se necessario, aggiungi una rimozione dello sfondo.
Genera subito la tua prima immagine
Copia il prompt del robot a linee, apri la pagina del modello Qwen Image 2.1 Pro, carica il disegno a linee, scegli 1:1 e genera un'immagine 2048×2048 a $0,05. Per una composizione multi-immagine, carica in ordine la poltrona e il soggiorno in image_urls e avvia di nuovo. Per tutti i parametri vedi la documentazione di integrazione.
Letture correlate: Prezzi di Qwen Image 2.1 · Qwen Image 2.1 vs GPT Image 2.5 · Raccolta di prompt per Qwen Image 2.1
Articoli correlati
Vedi tutti gli articoli →-

Tutoriale
Casi di Recraft Creative Upscale: paesaggi e acquerelli ingranditi
Osserva le variazioni di texture su baita, lago e cittadina ad acquerello, distingui il risultato completo dall'anteprima e controlla i dettagli ridisegnati.
-

Tutoriale
Chiave API OpenAI non valida: 401, variabili d'ambiente e verifica della configurazione di progetto
Distingui gli errori 401, 403 e 429 di OpenAI, controlla variabili d'ambiente, impostazioni di organizzazione e progetto e verifica le credenziali con una richiesta in sola lettura.
-

Tutoriale
Raccolta completa di prompt per Kling 4.0: 6 scene da cui copiare direttamente per creare video
Prodotti e-commerce, cibo, paesaggi di viaggio, momenti di vita quotidiana, b-roll con audio e image-to-video: ogni scena ha un video reale, il prompt completo e un link con compilazione automatica con un clic.