
Guia de uso
Guia de introdução ao qwen-audio-3.0-tts-plus: capacidades, preços e práticas de integração via API
Dos limites de capacidade à estimativa de custo por caractere, o caminho prático do desenvolvedor para integrar TTS
Nesta página
Por que prestar atenção a este modelo: posicionamento e cenários de aplicação
No desenvolvimento de aplicações, a síntese de fala costuma ser a parte mais solicitada logo de início e, ao mesmo tempo, a mais subestimada. O qwen-audio-3.0-tts-plus é um modelo de conversão de texto em fala lançado pela Alibaba: a entrada é texto, a saída é áudio, e seu posicionamento de capacidade concentra-se em text-to-speech. Ele é adequado para resolver um problema bastante específico: converter de forma estável um trecho de texto já definido em fala reproduzível.
Os cenários típicos de aplicação incluem: aplicações de locução de conteúdo que convertem artigos, comunicados e resumos em áudio; sons de aviso, instruções de orientação e feedback de status dentro de produtos; leitura acessível, que lê em voz alta para o usuário o texto na tela; geração de materiais de leitura de cursos e de acompanhamento de palavras em cenários de educação e treinamento; e pipelines offline de produção em lote de materiais de áudio. Esses cenários têm um ponto em comum: o texto existe antes da fala, e a fala é apenas uma forma de apresentação do mesmo conteúdo.
Por outro lado, se a sua necessidade é "extrair texto de uma gravação" ou "identificar a emoção no áudio", esse não é o trabalho deste modelo. Ao escolher, pergunte-se primeiro: minha entrada é texto e minha saída é áudio? Se sim, entra no escopo de TTS; se não, deve-se buscar outro tipo de modelo. Esse critério mais simples evita a maioria dos usos incorretos.
Seu valor também se manifesta na determinabilidade do lado da engenharia: o texto é enumerável, pré-processável e armazenável em cache, o que significa que custo e resultado são relativamente controláveis. Para equipes que precisam gerar fala em escala, essa previsibilidade costuma ser mais crucial do que o próprio timbre.
Limites de capacidade: o que ele faz e o que não faz
O que ele faz
Em torno da capacidade text-to-speech, sua função é receber texto e produzir áudio. Todas as tarefas de "dado um texto, precisa-se de fala audível" estão dentro do escopo: leitura de uma única frase, locução de parágrafos, geração em lote de falas fixas, complemento de versões em áudio para conteúdos existentes.
Como o tipo de saída é áudio, o processamento a jusante também é relativamente claro: após obter o áudio, pode-se reproduzi-lo, armazená-lo, distribuí-lo diretamente ou entregá-lo a cadeias convencionais de áudio, como players e CDN.
O que ele não faz
É preciso deixar claro que ele é um modelo TTS, não um modelo genérico de compreensão de áudio. Não conte com ele para as seguintes tarefas:
- Reconhecimento de fala (converter áudio em texto) — a direção de entrada e saída é exatamente a oposta;
- Compreensão, classificação e resumo de conteúdo de áudio;
- Recuperação e alinhamento entre áudio e texto;
- Tarefas especializadas de biometria vocal, como clonagem de voz e separação de falantes.
Além disso, TTS não é um modelo de "reescrita de texto". Se o original tiver erros de digitação, formatação confusa ou símbolos fora do padrão, ele não corrigirá o conteúdo por você; apenas lerá a confusão em voz alta. A qualidade do texto determina diretamente a qualidade do áudio, e isso será detalhado na seção de pré-processamento mais adiante.
Delimitar as fronteiras tem o seguinte sentido: ao perceber que a necessidade ultrapassa "texto entra, áudio sai", deve-se parar e reescolher o modelo, em vez de tentar repetidamente em prompts ou parâmetros. A maioria dos feedbacks de "resultado errado" tem como raiz, na verdade, o tipo de tarefa posicionado no lugar errado.
Estrutura de preços e estimativa de custo
O modelo é cobrado por volume de caracteres, com base de cobrança por mil caracteres. Antes da integração, fazer uma estimativa com o volume de texto é mais proativo do que olhar a fatura depois.
Como entender a base de cobrança
O objeto de cobrança é o texto enviado para síntese, com unidade em mil caracteres. No aspecto de engenharia, é preciso primeiro esclarecer como os "caracteres" são contados: por pontos de código Unicode ou por algum comprimento após normalização — isso afeta a contagem real de chinês, emojis, pontuação e espaços. Esse ponto deve seguir a documentação oficial; não presuma por intuição. Consulte o painel de preços do site para o valor unitário real; este artigo não lista números específicos.
Método de estimativa
A estimativa pode ser feita em três etapas:
- Calcular o comprimento médio de texto por requisição (número de caracteres);
- Multiplicar pela quantidade média diária ou mensal de requisições para obter o volume total de caracteres;
- Converter em faixa de custo com base na unidade por mil caracteres.
Exemplo para ilustrar o raciocínio (valores apenas ilustrativos, não representam o preço unitário real): se uma locução tiver em média 300 caracteres e forem geradas 1.000 por dia, o volume diário de caracteres será de 300 mil, ou seja, 300 unidades de mil caracteres; multiplicando pelo preço por mil caracteres, obtém-se a ordem de grandeza do custo diário. Multiplicando a média diária por 30, obtém-se a faixa mensal.
Itens de custo facilmente ignorados
- Repetições e requisições com falha: se requisições com falha também forem cobradas, é preciso incluir a taxa de repetição na estimativa;
- Síntese repetida: gerar repetidamente o mesmo trecho de texto é um desperdício oculto comum, e o cache elimina diretamente essa parte;
- Reexecução total de textos longos: após a fragmentação de um texto longo, se um fragmento falhar, basta reexecutar esse fragmento, não o texto inteiro;
- Tráfego de desenvolvimento e depuração: o volume de testes na fase de integração costuma ser considerável; recomenda-se medir e contabilizar separadamente.
O núcleo da otimização de custo não é reduzir o preço unitário, mas reduzir caracteres inválidos — limpar o conteúdo que não deve ser lido e armazenar em cache os resultados que não precisam ser gerados repetidamente.
Lista de verificação antes da integração
Antes de escrever a primeira linha de código, recomenda-se confirmar os pontos abaixo com base na documentação oficial. Quando faltar informação, não adivinhe; siga a documentação.
Interface e parâmetros
- Método de autenticação: em qual cabeçalho de requisição a chave é colocada e se há isolamento por projeto/espaço;
- Parâmetros obrigatórios: nome do campo de texto e nome do campo de identificação do modelo;
- Parâmetros opcionais: se existem velocidade de fala, timbre, formato de áudio, taxa de amostragem etc., e quais são os limites de valor;
- Limite de texto: número máximo de caracteres por requisição e o formato do erro ao ultrapassar.
Formato de retorno
- O áudio é retornado diretamente como fluxo binário ou como um endereço de download com validade;
- Contêiner e formato de codificação do áudio (como algum formato compactado comum ou formato sem perdas), o que determina como o lado de reprodução deve decodificar;
- Se a resposta inclui campos de uso, para facilitar a conciliação de custos.
Limites e cotas
- Limite de concorrência e limitação de taxa;
- Política de cota por conta ou por projeto;
- Códigos de erro ao ultrapassar e formas recomendadas de recuo.
Comportamento em falhas
- Idempotência: reenviar a mesma requisição gera cobrança duplicada;
- Limite de timeout e número recomendado de tentativas;
- Se há semântica clara de sucesso parcial em caso de falha parcial.
Marcar cada item desta lista reduz significativamente o tempo de "travar já na primeira chamada". Muitos problemas de integração não são problemas do modelo, mas nomes de parâmetros, formatos ou cotas que não estão alinhados com a documentação.
Usos típicos e práticas de pré-processamento de texto
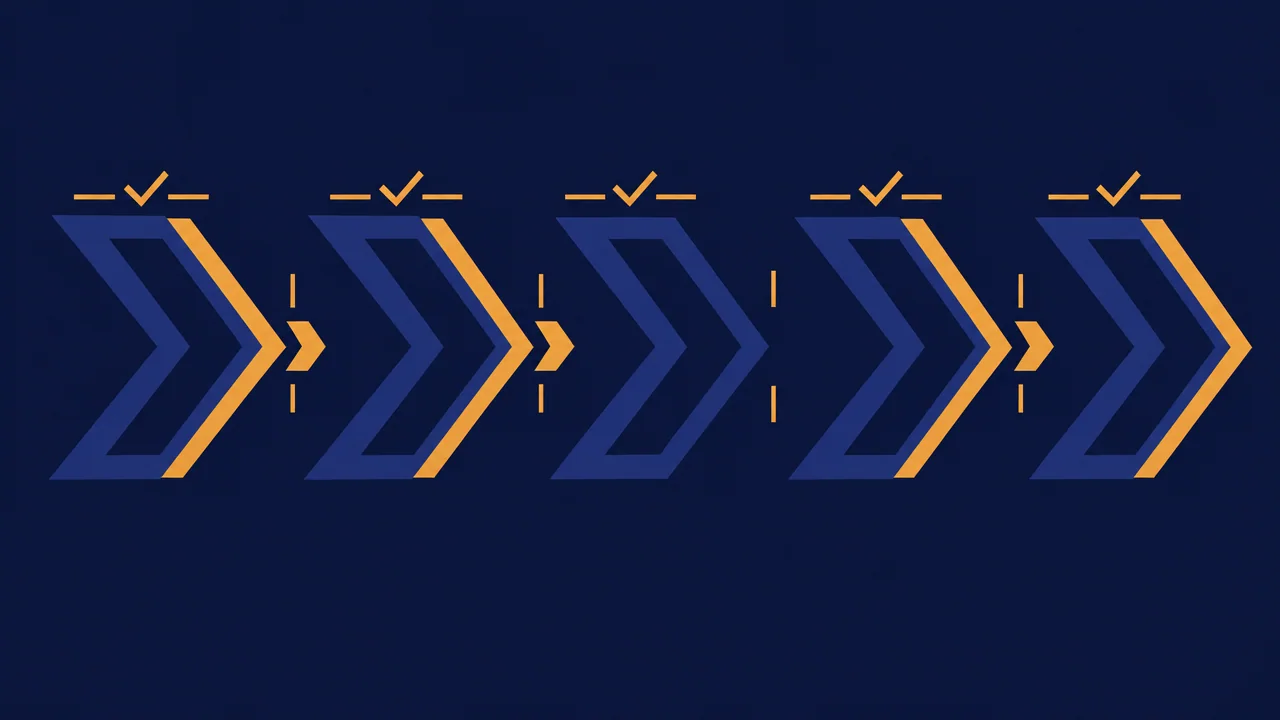
Oitenta por cento da qualidade da implementação de TTS depende do processamento do texto antes de enviá-lo ao modelo. Recomenda-se transformar o fluxo em um pipeline fixo: limpeza, fragmentação, síntese e cache.
Limpeza de texto
- Remover conteúdo que não deve ser lido: marcações Markdown, tags HTML, blocos de código, URLs, linhas de copyright de rodapé;
- Unificar pontuação: uso misto de largura total e meia largura, pontos de exclamação consecutivos e símbolos sem semântica afetam a segmentação de frases;
- Tratar números e unidades: ler "2024" como "dois zero dois quatro" ou "dois mil e vinte e quatro" depende do contexto de negócio; quando necessário, faça uma reescrita explícita antes de enviar para síntese;
- Tratar abreviações e nomes próprios: siglas em inglês, nomes de marcas e nomes de pessoas devem ser pré-processados conforme a leitura esperada;
- Controlar espaços em branco: quebras de linha extras e espaços consecutivos podem causar pausas não naturais.
Fragmentação de textos longos
Há um limite de comprimento por requisição, e textos longos devem ser fragmentados. O princípio da fragmentação é cortar em limites semânticos, não em um número fixo de caracteres: priorize quebras em parágrafos, pontos finais e pontos e vírgulas, evitando cortar uma palavra ou uma frase ao meio.
Após a fragmentação, atenção à experiência de concatenação: deve-se manter pausas naturais entre fragmentos e não inserir silêncio no meio da frase ao concatenar o áudio; além disso, registre a correspondência entre cada fragmento e o texto original, para facilitar regenerações parciais posteriores.
Síntese e concorrência
Após a fragmentação, pode-se fazer requisições concorrentes para reduzir o tempo total, mas é preciso respeitar a limitação de taxa e usar repetições com recuo exponencial. Em caso de falha, reexecute apenas o fragmento que falhou, não o texto inteiro.
Cache
Armazenar o resultado de áudio em cache usando como chave "conteúdo do texto + parâmetros principais (timbre, velocidade, formato)" é a forma mais direta de reduzir custos. Para o mesmo trecho de fala fixa ou o mesmo conteúdo já publicado, a segunda requisição deve acertar diretamente o cache. O cache também pode ser combinado com número de versão: quando o texto ou os parâmetros mudarem, deixe o cache antigo expirar naturalmente.
Antes do lançamento, recomenda-se usar um pseudocódigo para encadear o pipeline e confirmar que a entrada e a saída de cada etapa estão claras:
raw_text -> clean() -> chunk() -> synthesize(each chunk, retry) -> concat() -> cache_put()
Depois que essa cadeia estiver estável, considere então a escolha de timbre, o ajuste de velocidade de fala e outros aspectos da "camada de experiência".
Solução de problemas e armadilhas comuns
Diante de um problema, investigar por camadas é muito mais eficiente do que alterar parâmetros aleatoriamente.
Primeira camada: autenticação e cota
- A chave é válida e está no cabeçalho de requisição correto;
- Se a limitação de taxa ou o limite de cota foi atingido; os códigos de erro geralmente indicam isso claramente;
- Se ambientes diferentes (desenvolvimento/produção) usam a mesma chave e acabam disputando recursos.
Segunda camada: parâmetros da requisição
- Se os campos obrigatórios estão completos e se o uso de maiúsculas e minúsculas dos nomes de campo é consistente com a documentação;
- Se o texto ultrapassa o limite de comprimento por requisição;
- Se parâmetros opcionais receberam valores não suportados, causando rejeição da requisição.
Terceira camada: anomalias no texto
- Texto vazio ou contendo apenas pontuação;
- Presença de caracteres de controle, caracteres invisíveis ou codificação anormal;
- Grande quantidade de símbolos ou cadeias longas sem espaços, causando segmentação anormal e som de travamento.
Quarta camada: lado de reprodução do áudio
Esta é a camada mais facilmente confundida com "problema no modelo":
- Se o retorno é fluxo binário ou link de download, e se o cliente o trata da forma correspondente;
- Se o formato de áudio corresponde ao player e se o cabeçalho do contêiner foi truncado incorretamente;
- Se o link de download tem validade; após expirar, a reprodução naturalmente falha;
- Se há silêncio ou estalo nas junções de fragmentos; isso geralmente é problema da lógica de concatenação, não da síntese em si.
Armadilhas comuns
- Tratar "reconhecimento impreciso" como defeito do modelo — primeiro confirme se o tipo de tarefa está posicionado errado;
- Executar repetidamente o mesmo texto longo sem cache, o que é lento e desperdiça recursos;
- Fragmentar com corte rígido em comprimento fixo, cortando o meio das frases;
- Ignorar o intervalo de recuo das repetições, o que agrava a limitação de taxa.
Excluir camada por camada e manter os logs de cada requisição (comprimento do texto, parâmetros, código de erro, tempo gasto) acelera significativamente a localização.
Recomendação de escolha: quando escolhê-lo
Voltando à decisão em si. Pode-se avaliar a adequação a partir de quatro dimensões.
Idioma e formato do conteúdo
Se o conteúdo de negócio for principalmente em chinês, ou se forem necessárias locuções com leitura mista de chinês e inglês, vale a pena avaliar prioritariamente. Cenários puramente em inglês também podem entrar como candidatos, mas recomenda-se primeiro fazer uma audição com pequena amostra para confirmar se a pronúncia e a segmentação de frases atendem às expectativas.
Estrutura de custo
A cobrança por caractere significa que o custo é linearmente relacionado ao volume de texto, adequado a cenários em que o volume de conteúdo é previsível e o texto pode ser armazenado em cache. Por outro lado, se o texto de cada requisição for altamente aleatório e não reutilizável, o custo ficará mais próximo do próprio volume de requisições, sendo necessário estimar com antecedência.
Formato de saída e integração
Ele gera apenas áudio, sem resultados derivados como legendas ou timestamps. Se o negócio exigir legendas alinhadas palavra por palavra, isso precisa ser resolvido em outra parte da própria cadeia, não se pode esperar que o modelo forneça diretamente. Integrar o áudio ao player, CDN e sistema de distribuição de conteúdo existentes é trabalho convencional.
Ecossistema e maturidade de engenharia
A integração de aplicações, o gerenciamento de permissões e cotas dentro do ecossistema Alibaba costuma ser mais fluido; se a equipe já usa serviços de nuvem relacionados, o custo de integração será menor. Parâmetros específicos, limites e regras de cobrança devem seguir sempre a documentação oficial e o painel de preços do site; as descrições neste artigo servem apenas como referência para escolha.
Em resumo, desde que a necessidade seja "transformar texto já definido em fala audível" e que se aceite o modelo de custo por caractere, ele merece entrar na lista de candidatos. Antes da integração, recomenda-se primeiro executar a cadeia de limpeza, fragmentação e cache com um texto longo real, para então decidir se haverá escala.
Artigos relacionados
Ver todos os artigos →-

Guia de uso
Guia de introdução ao gpt-6.2-sol: limites de capacidade, integração via API e noções de precificação por token
Decisões de integração e pontos práticos para equipes de engenharia
-

Guia de uso
Guia de introdução ao gpt-6.2-astra: limites de capacidade do modelo de texto, pontos de integração e controle de custos
-

Guia de uso
Guia de introdução ao Tripo H3.1: três modos de entrada, parâmetros e como escolher o preço
Decisão de integração e controle de custos na geração 3D para desenvolvedores