
Сравнительный обзор
Opus 5.5 vs GPT-6.1 Sol: разница в баллах 3, разница в стоимости 8 раз
В новом рейтинге AA Intelligence Index v5 стоимость за задачу у первого места $10.04, у третьего — $1.27. Баллы близки, счета различаются в 8 раз — выбор зависит от задач
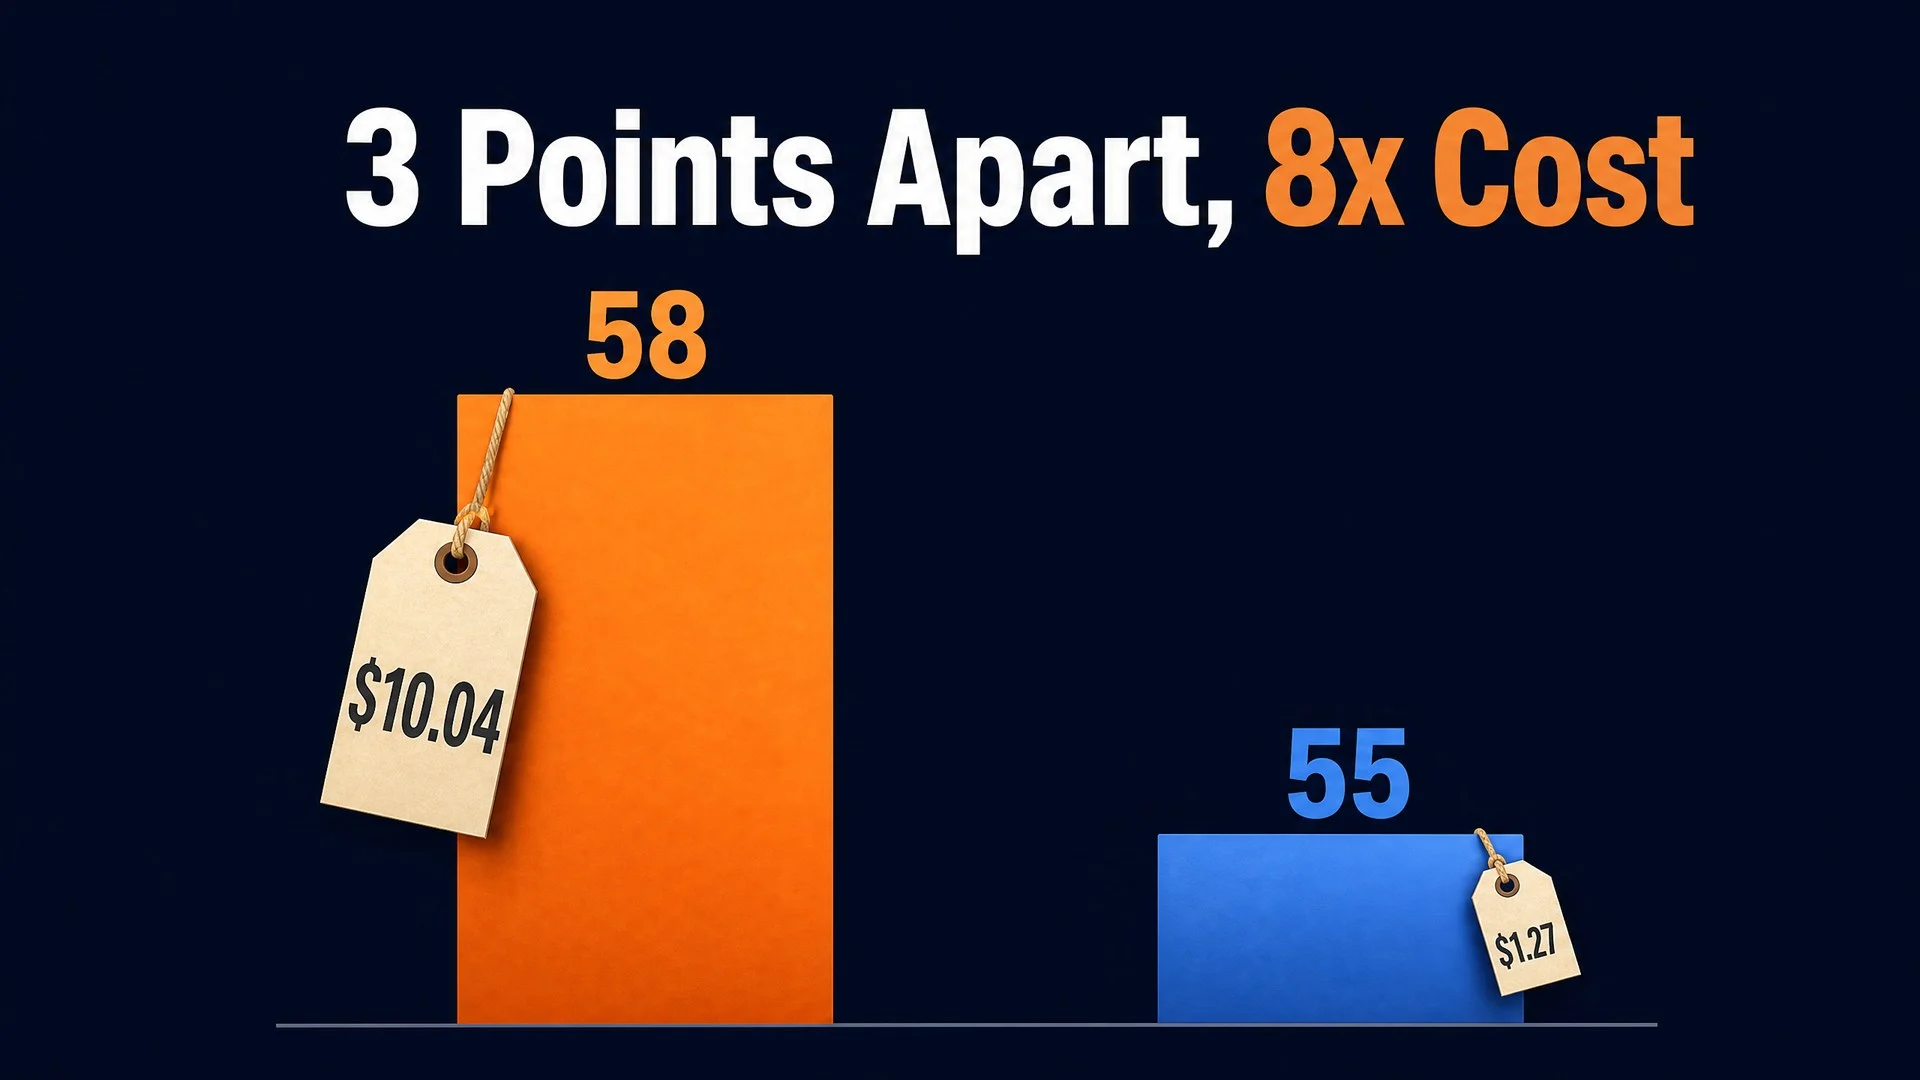
27 октября Artificial Analysis (далее AA) выпустила Intelligence Index v5 — крупнейшую переработку методологии с момента запуска v4 в январе 2026 года. Топ-3 обновлённого рейтинга: Claude Opus 5.5 (58 баллов), GPT-6 Astra (57 баллов), GPT-6.1 Sol (55 баллов).
Помимо баллов, AA одновременно опубликовала измеренную стоимость одной задачи (per-task cost) для каждой модели: Opus 5.5 в режиме рассуждения max стоит $10.04 за задачу, а Sol — всего $1.27. Официальная формулировка AA: разрыв Sol с лидером составляет менее 4 баллов, а стоимость за задачу — примерно одна восьмая.
Сначала выводы:
- По баллам: Opus 5.5 лидирует с 58 баллами, Sol занимает третье место с 55 — разница всего 3 балла, они в одном эшелоне
- По стоимости: в режиме max $10.04 против $1.27 за задачу — разница около 8 раз, это уже другой порядок величин
- Секрет дешевизны: дело не в низкой цене за токен, а в том, что Opus выдаёт примерно в 3 раза больше выходных токенов на задачу, что вместе с примерно 2-кратной разницей в цене за токен раздувает счёт до 8 раз
- Как выбирать: для повседневных агентных задач используйте Sol / Terra для объёма, для самых сложных задач — Opus в режиме max
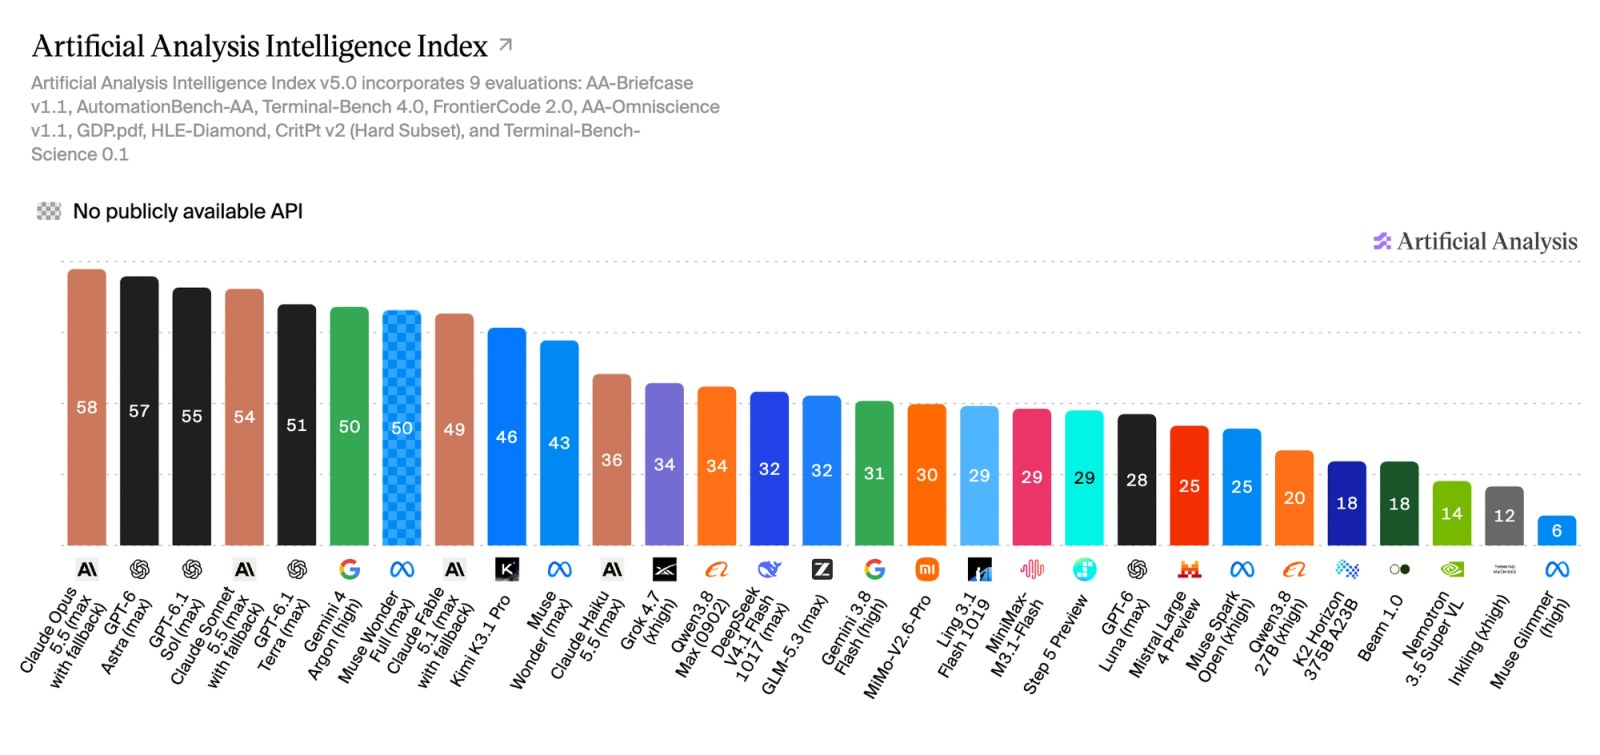
Источник изображения: официальный анонс Artificial Analysis Intelligence Index v5 (27.10.2026)
Контекст: почему v5 считается «крупной переработкой»
Из изменений v5 для читателей наиболее важны два. Во-первых, задачи стали тяжелее: медианный вывод по всем оценкам вырос с 35K токенов в v4 до 59K токенов, причём около 90% приходится на агентные многошаговые задачи, что ближе к реальной рабочей нагрузке. Во-вторых, защита от загрязнения: 60% оценок заменены на приватные тестовые наборы, что закрывает возможность накрутки рейтинга.
В рейтинге есть ещё два примечательных момента: GPT-6 Astra застряла на втором месте с 57 баллами; Kimi K3.1 Pro с 46 баллами заняла первое место среди открытых моделей, но разрыв между открытыми и закрытыми моделями в топ-5 вырос с 3 до 12 баллов.
Нужно прояснить одно распространённое заблуждение: Opus 5.5 в сентябре уже занимала первое место в рейтинге AA с 58 баллами, но тогда использовался старый набор задач v4.3. После переработки v5 она по-прежнему первая — «осталась первой после переработки» гораздо ценнее, чем «когда-то была первой», не стоит путать эти две вещи.
Баллы и счёт: всё видно в одной таблице
Все стоимости за задачу ниже — измеренные цифры из официального анонса AA v5 (режим рассуждения max):
| Модель | Баллы v5 (режим max) | Стоимость за задачу (измерено AA) |
|---|---|---|
| Claude Opus 5.5 | 58 | $10.04 |
| GPT-6 Astra | 57 | $6.24 |
| GPT-6.1 Sol | 55 | $1.27 |
| GPT-6.1 Terra | Не вошла в топ-5 | $0.96 (самая дешёвая) |
| Claude Fable 5.1 | Не вошла в топ-5 | $13.04 (самая дорогая) |
$10.04 ÷ $1.27 ≈ 7,9 раза, что согласуется с официальной формулировкой AA «примерно одна восьмая». AA также отмечает, что разрыв в стоимости за задачу между ведущими моделями превышает 13 раз. Иными словами, в узкой полосе «флагманских возможностей» разброс счетов гораздо сильнее, чем разброс баллов.
Предупреждение: если вы встретите в интернете цифры Sol $0.72 и Opus $5.98, это остатки от старого набора задач v4 (медианный вывод 35K токенов); после утяжеления задач v5 официальные цифры обновлены до $1.27 и $10.04, при цитировании ориентируйтесь на анонс от 27.10.2026.
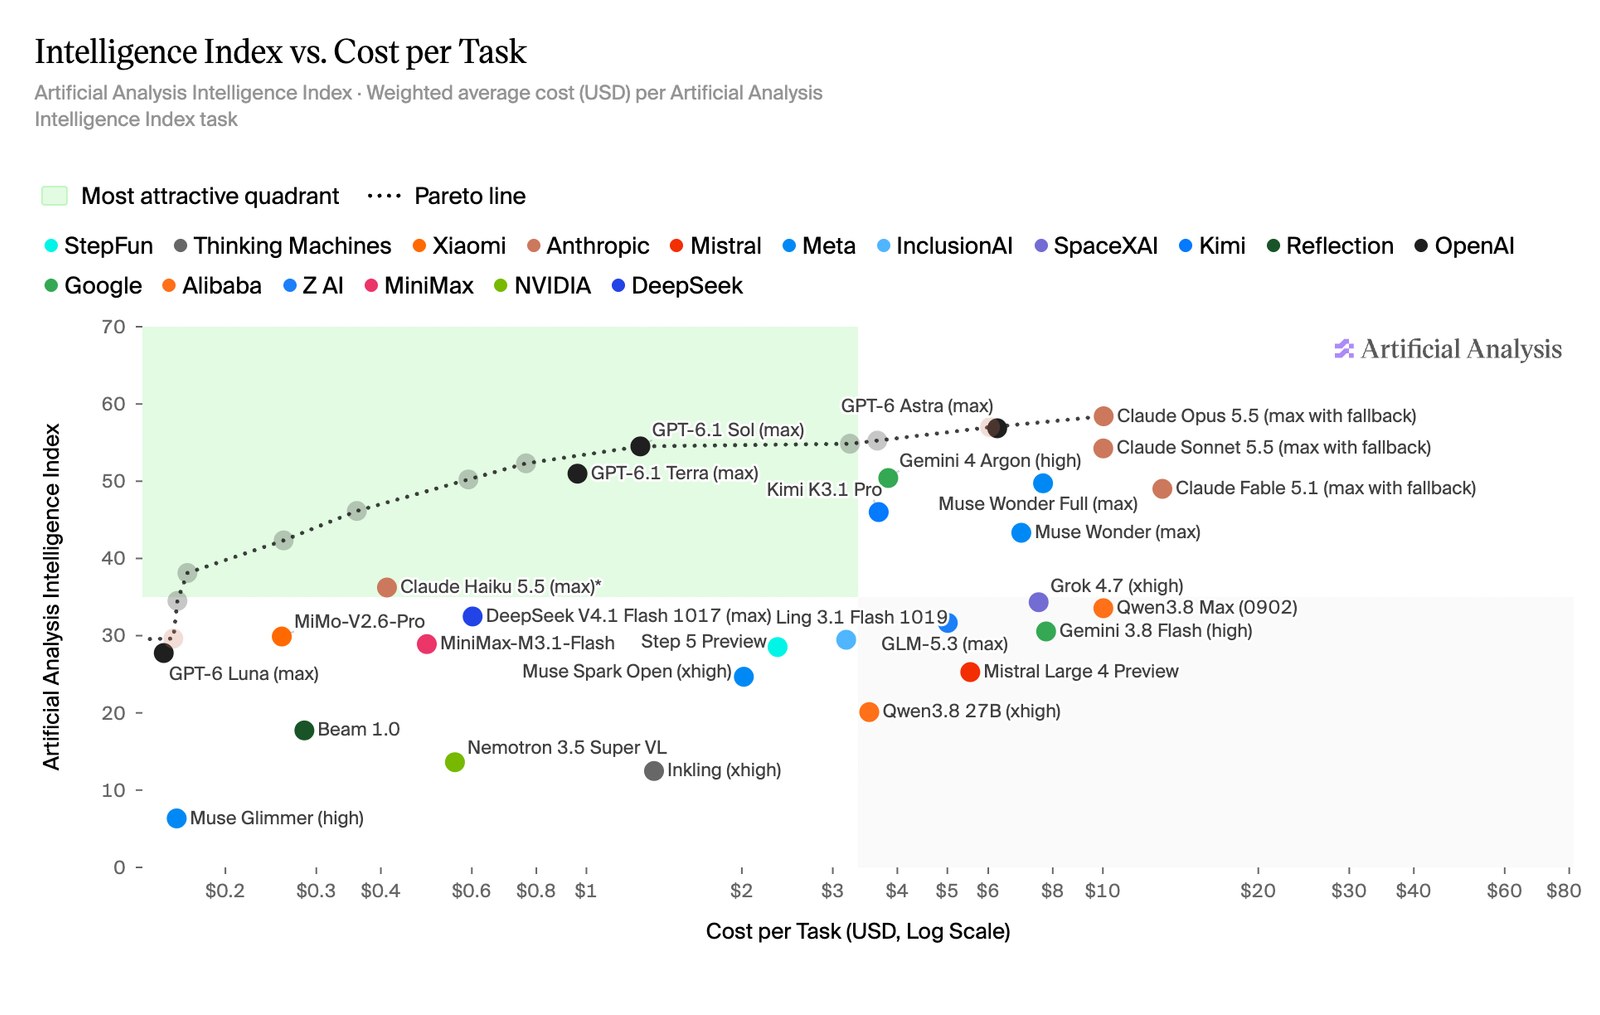
Источник изображения: официальный анонс Artificial Analysis Intelligence Index v5 (27.10.2026)
Почему по цене за токен нельзя предсказать стоимость за задачу
Это самый обсуждаемый в сообществе момент после выпуска v5. По официальным ценам за токен, использованным в анонсе AA для пересчёта, Opus 5.5 стоит примерно в 2 раза дороже Sol за токен (цены платформы HiAPI считаются иначе, см. ниже), но стоимость за задачу различается в 8 раз. Дополнительная кратность возникает из-за длины вывода: в измерениях Opus генерирует примерно в 3 раза больше выходных токенов на задачу. 2-кратная цена за токен умножается на 3-кратный объём — получается 8-кратный счёт.
В v5 это ещё больше усилилось, потому что утяжеление задач означает более длинный вывод, а модели, «любящие писать длинно», становятся дороже. Это также объясняет, почему взгляд только на прайс-лист систематически искажает картину: прайс-лист говорит вам «сколько стоит каждый токен», а счёт говорит «сколько стоит выполнить эту задачу». Оба важны, но только один можно занести в бюджет.
Из чего состоит индекс и почему уровень effort стал важнее
Индекс v5 состоит из 9 оценок, разделённых на 4 равные крупные категории по 25%: интеллектуальная работа (25%), программирование (25%), наука (25%), общее (25%). Ни одна модель не заняла первое место во всех 9 пунктах: Opus 5.5 лидирует в 3 из них (программирование и две сложные оценки в категории «общее»), GPT-6 Astra — в 2. Это означает, что «кто первый» в некоторой степени зависит от того, в какую крупную категорию попадает ваша задача: для написания кода и решения сложных интеллектуальных задач баллы Opus показательнее; в сценариях, смещённых к интеллектуальной работе и автоматизации, разрыв будет меньше, чем показывает общий балл.
Ещё одно изменение v5 — заметно выросло влияние уровня рассуждения effort на баллы: Opus 5.5 на уровне low имеет всего 35 баллов, а на уровне max — 58; диапазон уровней Sol также растянулся до 20 баллов. Иными словами, 58 и 55 баллов в рейтинге получены при «полной мощности».
Резюме одной фразой: баллы получены в режиме max, и счёт тоже сожжён в режиме max. При составлении бюджета по рейтингу обе цифры нужно смотреть вместе с уровнем. Если в повседневных задачах вы используете только уровни low / medium, фактическая разница между двумя моделями будет иной, чем в рейтинге.
Практика: маршрутизация по сложности задач, без универсального подхода
Судя по данным выше, самый экономный подход — не «перевести всё на Sol» или «оставить всё на Opus», а расслоение по сложности задач:
- Повседневные агентные задачи (скрипты, очистка данных, обычное программирование, пакетная обработка): Sol или даже Terra для объёма, стоимость за задачу от $0.96 до $1.27 подходит для масштабирования
- Сложные задачи (сложный рефакторинг, глубокие рассуждения, многошаговый анализ): подключайте Opus в режиме max, платите 8-кратную стоимость за 3 балла разницы только на задачах, где это оправдано
- Хотите снизить стоимость ещё на уровень: начните с уровня effort, не фиксируйте конфигурацию по умолчанию на максимуме
Грубый расчёт для понимания разницы: на 1000 одинаковых повседневных задач полностью на Sol уйдёт около $1,270, полностью на Opus в режиме max — около $10,040; разница в $8,770 с лихвой покроет месячный лимит команды на сложные задачи. С другой стороны, если ради экономии передать все задачи Sol, то 3 балла разницы на самых сложных 5% задач могут означать разницу между «сделано» и «не сделано». В этом и смысл маршрутизации: дорогая модель тратится только на задачи, где она действительно нужна.
Такая структура маршрутизации «один пул задач, две модели» — как раз сильная сторона агрегационной платформы: не нужно регистрировать два аккаунта и вести два счёта, один Key позволяет переключаться по запросу. Мы демонстрировали тот же подход с переключением моделей по задаче в статье о подключении Claude Code и Codex — можете сравнить.
Как подключить обе модели на HiAPI
Сначала цены платформы (по состоянию на октябрь 2026, все — базовый уровень контекста ≤272K):
| Модель | Ввод | Вывод | Чтение кэша |
|---|---|---|---|
| claude-opus-5-5 | $2.02/M | $10.08/M | $0.10/M |
| gpt-6.1-sol | $0.50/M | $2.50/M | $0.025/M |
Обратите внимание на разделение систем учёта: таблица выше — цены за токен HiAPI, а $10.04 / $1.27 выше — измеренная AA стоимость за задачу; эти两组数字 имеют разные источники и не могут смешиваться в расчётах. По ценам платформы ввод и вывод Sol примерно вчетверо дешевле Opus — это система прайс-листа; при пересчёте в счёт за задачу с добавлением упомянутой выше разницы в объёме вывода получается 1/8 по AA.
По подключению: Opus 5.5 поддерживает двойной протокол Anthropic Messages и OpenAI Chat Completions, пять уровней effort настраиваются; Sol поддерживает двойной протокол Responses и Chat Completions, контекст 1.05M. Обе модели можно вызывать одним и тем же API Key, маршрутизируя по запросу.
- Границы возможностей и полные параметры Opus 5.5 — на странице модели, Sol — на странице модели
- Руководства по началу работы: руководство по подключению API GPT-6.1 Sol, анализ цен API Claude Opus 5.5
- Сравнение с предыдущим поколением: Opus 5.5 vs GPT-5.6 Sol
- Статьи из той же серии: новость о снижении цены GPT-6.1 Terra, руководство по переключению моделей в Claude Code / Codex, новость о Genie 4
Частые вопросы
Как получена стоимость Sol $1.27 за задачу?
Это измеренная методика из официального анонса AA v5: прогон партии задач в режиме рассуждения max с пересчётом по фактически потреблённым входным и выходным токенам и официальным ценам. Это не прайс-лист, а счёт, поэтому ближе к тому, что вы реально заплатите, чем взгляд на прайс-лист.
В интернете пишут Sol $0.72 и Opus $5.98 за задачу — что верно?
$0.72 / $5.98 — цифры старого набора задач v4, когда медианный вывод задачи составлял всего 35K токенов. После утяжеления задач v5 (медиана 59K токенов) официальные цифры обновлены до $1.27 / $10.04. Ориентируйтесь на анонс v5 от 27.10.2026.
Во сколько раз на самом деле различаются цены за токен Sol и Opus 5.5?
По ценам платформы HiAPI (по состоянию на октябрь 2026, базовый уровень ≤272K): Sol — ввод $0.50/M, вывод $2.50/M; Opus — ввод $2.02/M, вывод $10.08/M; цены за токен различаются примерно в 4 раза. Но это система прайс-листа; по системе стоимости за задачу AA разница около 8 раз, и разница возникает из-за примерно 3-кратного объёма вывода Opus на задачу. Обе системы верны, не смешивайте их в расчётах.
Что такое уровень effort? Почему разница в баллах такая большая?
Effort — это уровень вложений при рассуждении модели: чем выше, тем глубже размышления и длиннее вывод. В v5 у Opus 5.5 диапазон от 35 баллов на уровне low до 58 баллов на уровне max — размах 23 балла; у Sol диапазон уровней также составляет 20 баллов. Поэтому «может ли Sol заменить Opus» зависит от того, какой уровень вы используете повседневно, и от того, сколько вы готовы платить за сложные задачи.
Какую модель использовать для моих задач — Sol или Opus 5.5?
Повседневные агентные задачи (скрипты, очистка, обычное программирование) — сначала Sol, объём и контролируемая стоимость; для задач, где вы не уверены, прогоните сравнение с Opus в режиме max. На HiAPI одним Key можно вызывать обе модели, переключение маршрута не требует дополнительных затрат на подключение.
Ключевые выводы
Рейтинг v5 выложил на стол две вещи одновременно: по возможностям Opus 5.5, Astra и Sol укладываются в 3 балла — никто никого не подавляет; по стоимости счёт за задачу различается в 8 раз, что гораздо сильнее, чем разброс баллов. Баллы получены в режиме max, и счёт тоже сожжён в режиме max — обе цифры нужно смотреть вместе с уровнем. Для большинства команд правильная позиция — не выбирать сторону, а маршрутизировать по сложности задач: Sol / Terra для объёма, Opus в режиме max для сложных задач. Если хотите реализовать эту маршрутизацию на HiAPI, обе модели уже можно запускать.
Похожие статьи
Все статьи →-

Сравнительный обзор
Wan 2.6 Flash против Wan 2.7: стоит ли обновляться?
720P-бюджет и готовые ролики 1080P с лисой и автомобилем; для каждой группы указаны аудиоусловия и фактический тариф.
-

Сравнительный обзор
Vidu Q4 Preview vs Kling 3.0: как выбрать генерацию видео из изображения?
Для звука по умолчанию, 16 секунд и 5 разрешений выбирайте Vidu Q4 Preview; для фиксации кадра начальным и конечным изображениями — Kling 3.0. В комплекте два сравнения с одинаковым промптом: гидросамолёт и бариста.
-

Сравнительный обзор
Альтернатива Replicate: сравнение hiapi и Replicate для генерации изображений и видео (2026)
Что нужно изменить в вызовах прогнозов, webhook и тарификации при переходе с Replicate на hiapi, плюс чек-лист миграции из 10 шагов.