
Comparativa
Opus 5.5 vs GPT-6.1 Sol: 3 puntos de diferencia en la puntuación, 8 veces de diferencia en el coste
En el nuevo ranking del AA Intelligence Index v5, el primero cuesta $10.04 por tarea y el tercero $1.27. Puntuaciones cercanas, facturas 8 veces distintas: cómo elegir depende de la tarea
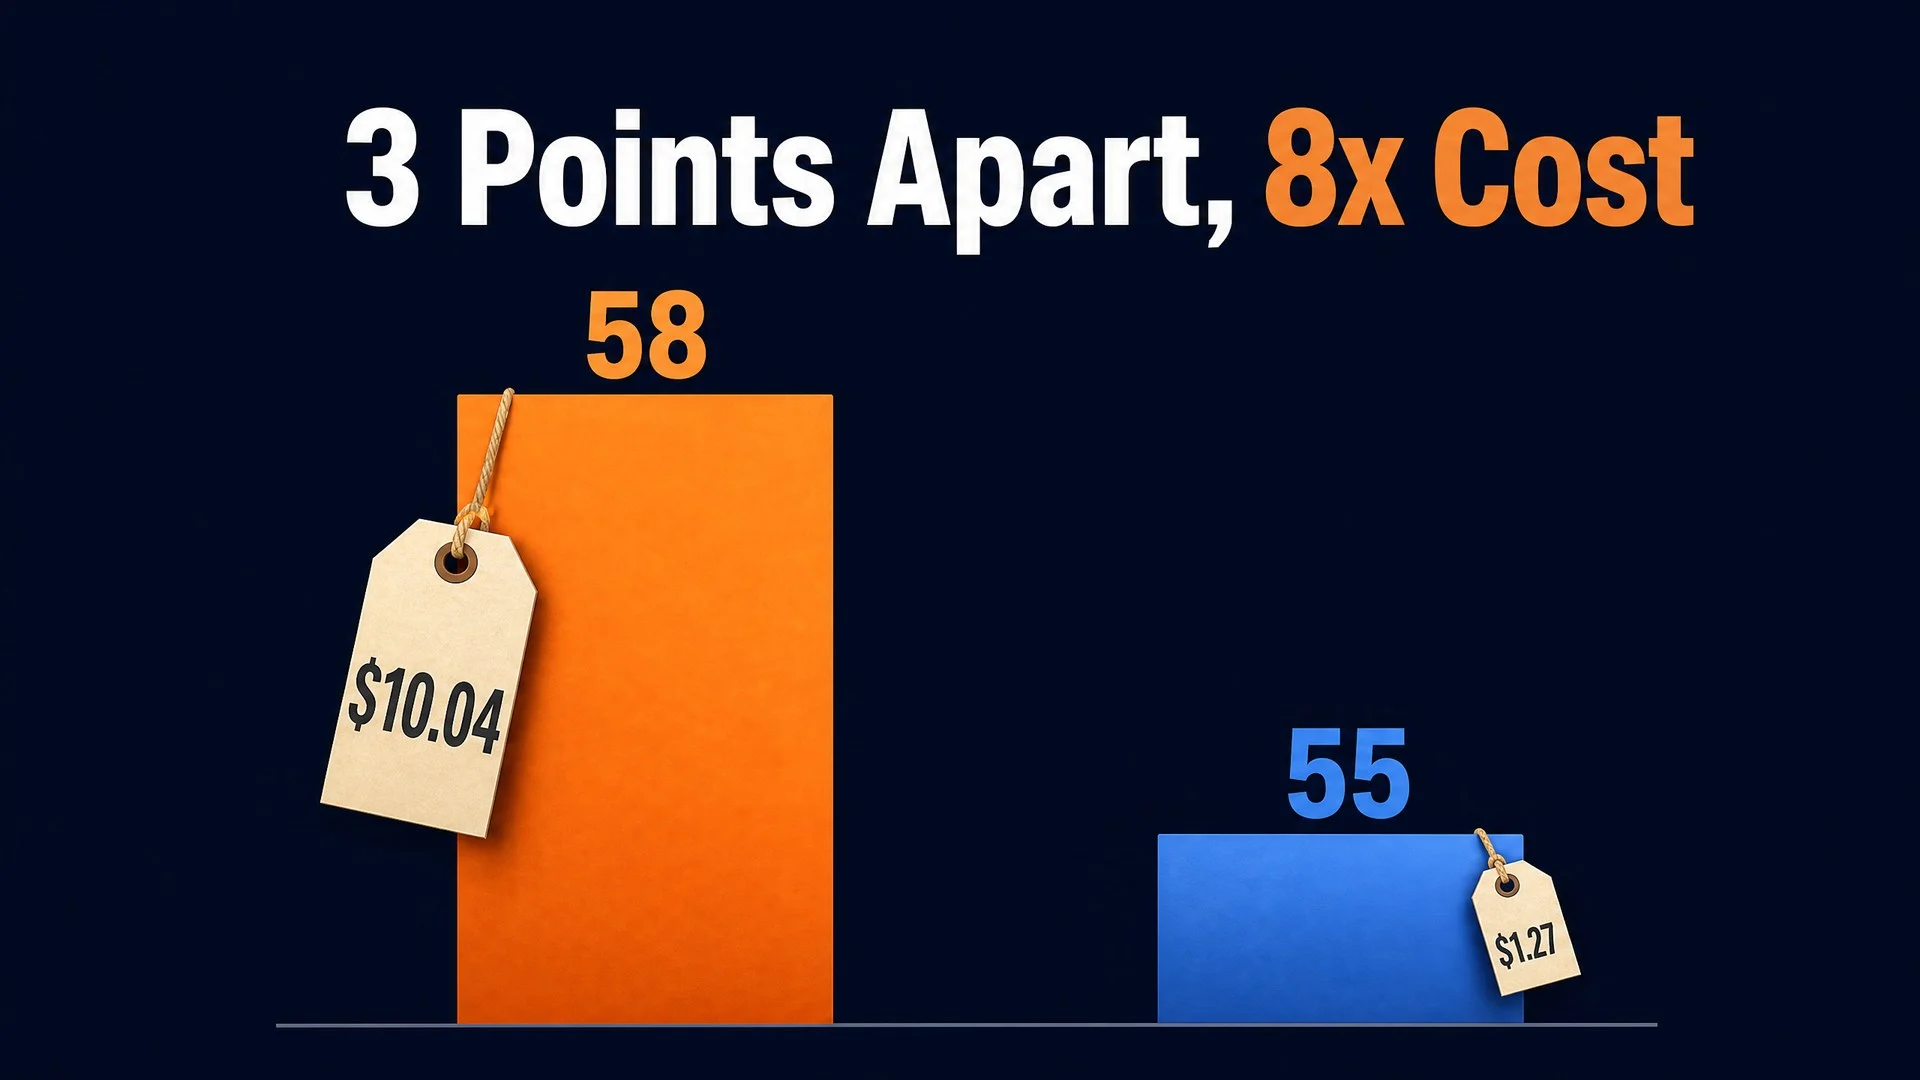
El 27 de octubre, Artificial Analysis (en adelante AA) publicó el Intelligence Index v5, la mayor revisión metodológica desde que la v4 se lanzó en enero de 2026. Los tres primeros puestos del ranking revisado son: Claude Opus 5.5 (58 puntos), GPT-6 Astra (57 puntos) y GPT-6.1 Sol (55 puntos).
Más allá de la puntuación, AA publicó simultáneamente el coste real medido por tarea (per-task cost) de cada modelo: Opus 5.5 en el nivel de razonamiento max cuesta $10.04 por tarea, mientras que Sol solo cuesta $1.27. La formulación oficial de AA es: la diferencia de puntuación entre Sol y el líder es de menos de 4 puntos, y su coste por tarea es aproximadamente solo una octava parte.
Primero las conclusiones:
- En puntuación: Opus 5.5 lidera con 58 puntos y Sol es tercero con 55, solo 3 puntos de diferencia; están en la misma liga
- En coste: en el nivel max, $10.04 frente a $1.27 por tarea, unas 8 veces de diferencia; ya no están en el mismo orden de magnitud
- El secreto de la baratura: no es que el precio por token sea bajo, sino que Opus genera por tarea unos 3 veces más tokens de salida que Sol; sumado a una diferencia de precio unitario de unas 2 veces, la factura se amplifica hasta 8 veces
- Cómo elegir: para tareas de agente cotidianas usar Sol / Terra en volumen, y para las tareas de asalto más difíciles recurrir al nivel max de Opus
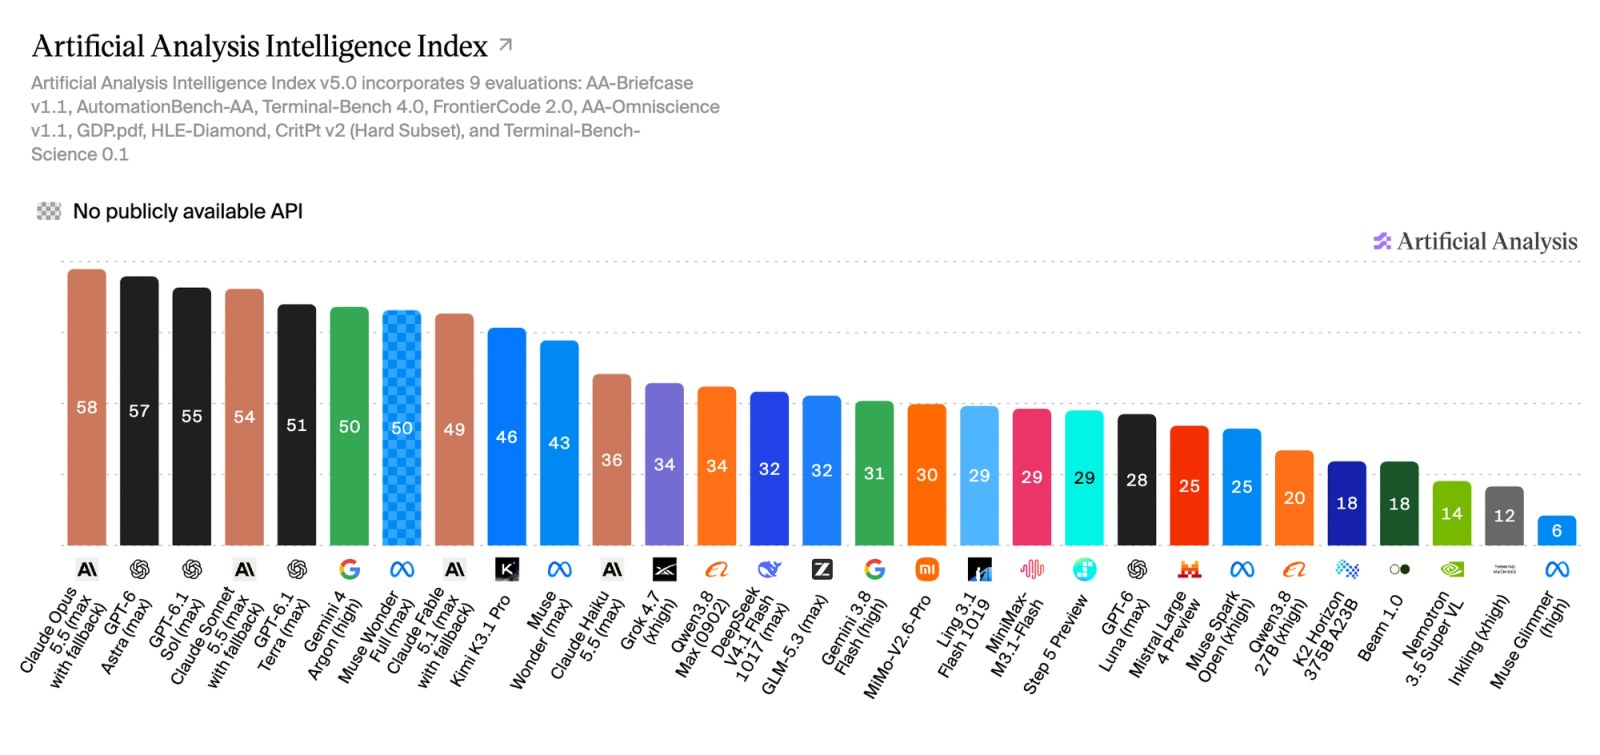
Fuente de la imagen: anuncio oficial de Artificial Analysis Intelligence Index v5 (2026-10-27)
Contexto: por qué la v5 se considera una «gran revisión»
De los cambios de la v5, los dos más relevantes para el lector son estos. Primero, las tareas son más pesadas: la salida mediana de todas las evaluaciones sube de 35K tokens en la v4 a 59K tokens, y cerca del 90% de ese aumento proviene de tareas agénticas de múltiples pasos, más cercanas a cargas de trabajo reales. Segundo, prevención de contaminación: el 60% de las evaluaciones se sustituyeron por conjuntos de prueba privados, cerrando el espacio para manipular el ranking.
Hay otros dos puntos destacables en el ranking: GPT-6 Astra se queda en segundo lugar con 57 puntos; Kimi K3.1 Pro obtiene el primer puesto entre los modelos abiertos con 46 puntos, pero la brecha entre los cinco primeros abiertos y cerrados se amplía de 3 a 12 puntos.
Conviene aclarar una lectura errónea habitual: Opus 5.5 ya había llegado al primer puesto del ranking de AA en septiembre con 58 puntos, pero entonces ejecutaba el antiguo conjunto de tareas v4.3. Tras la revisión v5 sigue siendo primero; «mantener el primer puesto después de la revisión» tiene mucho más valor que «haber sido primero alguna vez», no hay que confundir ambas cosas.
Puntuación y factura: todo claro en una tabla
Los siguientes costes por tarea son las cifras medidas del anuncio oficial v5 de AA (nivel de razonamiento max):
| Modelo | Puntuación v5 (nivel max) | Coste por tarea (medido por AA) |
|---|---|---|
| Claude Opus 5.5 | 58 | $10.04 |
| GPT-6 Astra | 57 | $6.24 |
| GPT-6.1 Sol | 55 | $1.27 |
| GPT-6.1 Terra | No entra en el top cinco | $0.96 (el más barato) |
| Claude Fable 5.1 | No entra en el top cinco | $13.04 (el más caro) |
$10.04 ÷ $1.27 ≈ 7,9 veces, coherente con la formulación oficial de AA de «aproximadamente una octava parte». AA señala además que la diferencia de coste por tarea entre los modelos punteros supera las 13 veces. Es decir, en la estrecha franja de «capacidad insignia», la divergencia de la factura es mucho más intensa que la de la puntuación.
Un aviso: si ves en internet las cifras de Sol $0.72 y Opus $5.98, son un remanente del antiguo conjunto de tareas v4 (salida mediana de 35K tokens); tras el aumento de peso de las tareas en la v5, la cifra oficial se actualizó a $1.27 y $10.04. Al citar, atente al anuncio del 2026-10-27.
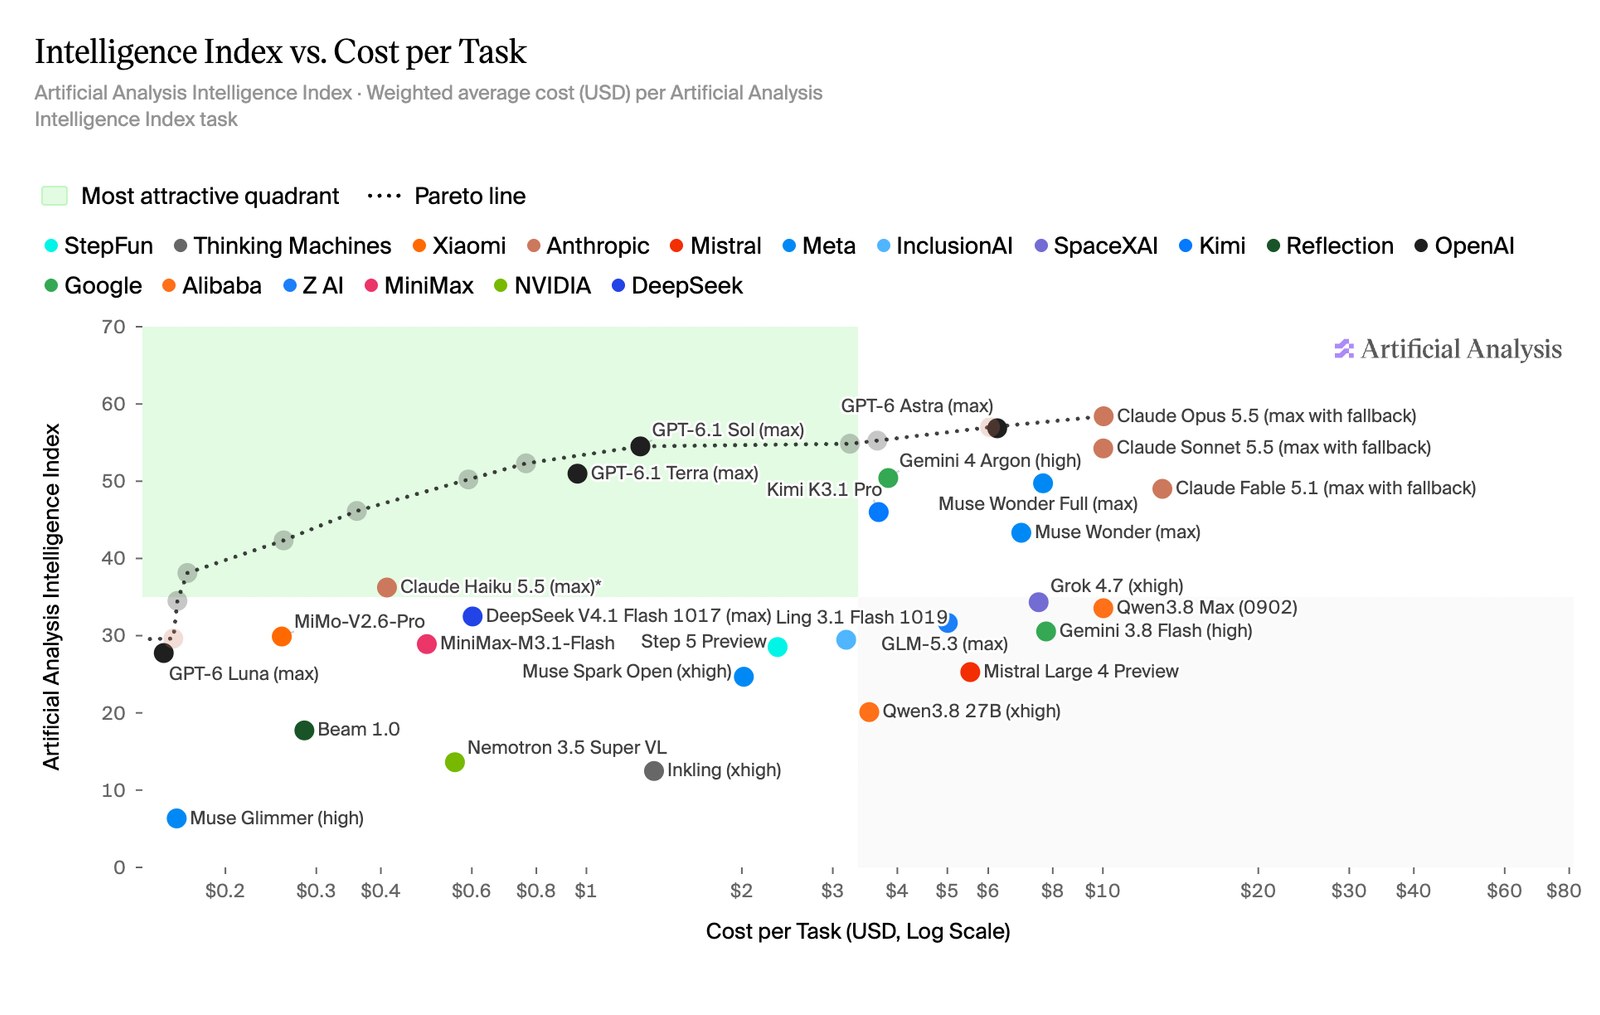
Fuente de la imagen: anuncio oficial de Artificial Analysis Intelligence Index v5 (2026-10-27)
Por qué el precio por token no permite predecir el coste por tarea
Este es uno de los puntos más discutidos por la comunidad tras el lanzamiento de la v5. Según el precio oficial por token usado para la conversión en el anuncio de AA, cada token de Opus 5.5 cuesta unas 2 veces más que el de Sol (el precio de la plataforma HiAPI sigue otro criterio, véase más abajo), pero el coste por tarea difiere 8 veces. El factor adicional proviene de la longitud de salida: en las mediciones, Opus genera por tarea unos 3 veces más tokens de salida que Sol. 2 veces el precio unitario multiplicado por 3 veces el uso da una factura de 8 veces.
Esto se amplifica aún más en la v5, porque tareas más pesadas implican salidas más largas, y los modelos «aficionados a escribir salidas largas» resultan más caros. También explica por qué mirar solo la lista de precios distorsiona sistemáticamente: la lista de precios te dice «cuánto cuesta cada token», la factura te dice «cuánto cuesta terminar este trabajo». Ambas importan, pero solo una entra en el presupuesto.
Cómo se compone el índice y por qué el nivel de effort gana importancia
El índice v5 se compone de 9 evaluaciones, divididas en 4 grandes categorías equivalentes, cada una con un 25%: trabajo del conocimiento (25%), codificación (25%), ciencia (25%) y general (25%). Ningún modelo se lleva el primer puesto en las 9; Opus 5.5 lidera 3 de ellas (codificación y dos evaluaciones duras dentro de general), y GPT-6 Astra lidera 2. Esto significa que «quién es el primero» depende en cierta medida de en qué gran categoría caiga tu tarea: para escribir código y resolver problemas de conocimiento duro, la puntuación de Opus tiene más valor de referencia; en escenarios más orientados al trabajo del conocimiento y la automatización, la brecha se muestra menor que la puntuación total.
Otro cambio de la v5 es que la influencia del nivel de razonamiento effort sobre la puntuación aumenta claramente: Opus 5.5 solo obtiene 35 puntos en el nivel low, y 58 en el nivel max; el rango de niveles de Sol también se amplía hasta 20 puntos. En otras palabras, los 58 y 55 puntos del ranking se obtuvieron «a máxima potencia».
Resumen en una frase: la puntuación se obtiene en el nivel max, y la factura también se quema en el nivel max. Al mirar el ranking para presupuestar, ambas cifras deben leerse junto con el nivel. Si en tareas cotidianas solo usas los niveles low / medium, la diferencia real entre ambos modelos será distinta de la del ranking.
Práctica: enrutar según la dificultad de la tarea, sin soluciones únicas
Según los datos anteriores, el uso más económico no es «cambiar todo a Sol» ni «quedarse todo con Opus», sino estratificar por dificultad de la tarea:
- Tareas de agente cotidianas (scripts, limpieza de datos, codificación habitual, procesamiento por lotes): Sol o incluso Terra en volumen; un coste por tarea de $0.96 a $1.27 es apto para escalar
- Tareas de asalto (refactorizaciones complejas, razonamiento profundo, análisis de múltiples saltos): recurrir entonces al nivel max de Opus; pagar 8 veces el coste por 3 puntos de diferencia solo en las tareas que lo merezcan
- Si quieres recortar un nivel más de coste: actuar sobre el nivel de effort, no dejar la configuración por defecto bloqueada en el nivel más alto
Hagamos un cálculo aproximado para sentir la diferencia: ejecutar 1000 tareas cotidianas cuesta unos $1,270 con Sol y unos $10,040 con Opus en nivel max; los $8,770 de diferencia bastan para cubrir con holgura la cuota mensual de tareas de asalto de todo un equipo. A la inversa, si para ahorrar se asignan todas las tareas a Sol, esos 3 puntos de diferencia en el 5% de tareas más difíciles pueden ser la diferencia entre «hacerlo» y «no hacerlo». El sentido del enrutamiento está aquí: hacer que el modelo caro se gaste solo en las tareas que realmente lo necesitan.
Esta estructura de enrutamiento de «un pool de tareas, dos modelos» es precisamente el terreno de las plataformas agregadoras: sin registrar por separado cuentas en dos proveedores ni gestionar dos facturas; con una sola Key se cambia según la solicitud. En nuestro artículo sobre la integración de Claude Code y Codex ya mostramos esta misma idea de cambiar de modelo según la tarea; si te interesa, puedes consultarlo en paralelo.
Cómo conectar ambos modelos en HiAPI
Primero los precios de la plataforma (a fecha de 2026-10, todos para el nivel básico de ≤272K de contexto):
| Modelo | Entrada | Salida | Lectura de caché |
|---|---|---|---|
| claude-opus-5-5 | $2.02/M | $10.08/M | $0.10/M |
| gpt-6.1-sol | $0.50/M | $2.50/M | $0.025/M |
Atención a la separación de criterios: la tabla anterior son los precios por token de HiAPI; los $10.04 / $1.27 mencionados antes son el coste por tarea medido por AA. Las dos series de cifras tienen distinto origen y no pueden combinarse directamente. En los precios de la plataforma, las tarifas de entrada y salida de Sol son aproximadamente una cuarta parte de las de Opus; ese es el criterio de la lista de precios. Convertido a factura por tarea y sumado a la diferencia de volumen de salida mencionada antes, se llega al 1/8 de AA.
En cuanto a la integración, Opus 5.5 admite doble protocolo Anthropic Messages y OpenAI Chat Completions, con cinco niveles de effort ajustables; Sol admite doble protocolo Responses y Chat Completions, con 1.05M de contexto. Ambos modelos se pueden invocar con la misma API Key y enrutar por solicitud.
- Los límites de capacidad y los parámetros completos de Opus 5.5 están en la página de detalles del modelo; los de Sol, en su página de detalles del modelo
- Tutoriales de inicio: Guía de integración de la API de GPT-6.1 Sol, Análisis de precios de la API de Claude Opus 5.5
- Referencia de comparación con la generación anterior: Opus 5.5 vs GPT-5.6 Sol
- Artículos de la misma tanda: Noticia rápida sobre la rebaja de precio de GPT-6.1 Terra, Guía para cambiar de modelo en Claude Code / Codex, Noticia rápida sobre Genie 4
Preguntas frecuentes
¿Cómo se calcula el $1.27 por tarea de Sol?
Es el criterio medido del anuncio oficial v5 de AA: ejecutar un lote de tareas en el nivel de razonamiento max y convertir según los tokens de entrada y salida realmente consumidos y el precio oficial. No es un precio de tarifa, es una factura, así que se acerca más a lo que realmente pagarás que mirar la lista de precios.
En internet se lee Sol $0.72 y Opus $5.98 por tarea, ¿cuál es correcto?
$0.72 / $5.98 son cifras del antiguo conjunto de tareas v4, cuando la salida mediana de las tareas era de solo 35K tokens. Tras el aumento de peso de las tareas en la v5 (mediana de 59K tokens), lo oficial se actualizó a $1.27 / $10.04. Atente al anuncio v5 del 2026-10-27.
¿Cuántas veces difiere exactamente el precio por token de Sol y Opus 5.5?
Según el precio de la plataforma HiAPI (a fecha de 2026-10, nivel básico ≤272K), Sol cuesta $0.50/M de entrada y $2.50/M de salida; Opus, $2.02/M de entrada y $10.08/M de salida; el precio unitario es unas 4 veces. Pero ese es el criterio de la lista de precios; el criterio de coste por tarea de AA es de unas 8 veces, y la diferencia proviene del volumen de salida de Opus, unas 3 veces mayor por tarea. Ambos criterios son válidos; no los mezcles en el cálculo.
¿Qué es el nivel de effort? ¿Por qué la puntuación difiere tanto?
effort es el nivel de inversión del modelo al razonar: cuanto más alto, más profundo piensa y más larga es la salida. En la v5, Opus 5.5 pasa de 35 puntos en el nivel low a 58 en el nivel max, un rango de 23 puntos; el rango de niveles de Sol también llega a 20 puntos. Por eso, «si Sol puede sustituir a Opus» depende de qué nivel uses a diario y de cuánto estés dispuesto a pagar por las tareas de alta dificultad.
¿Debo usar Sol u Opus 5.5 para mi tarea?
Para tareas de agente cotidianas (scripts, limpieza, codificación habitual), empieza con Sol: el volumen es grande y el coste controlable. Para tareas de asalto en las que no estés seguro, prueba una ronda comparativa con el nivel max de Opus. En HiAPI, una sola Key permite invocar ambos modelos y el enrutamiento no tiene coste adicional de integración.
Conclusiones clave
El ranking v5 pone dos cosas sobre la mesa al mismo tiempo: en capacidad, Opus 5.5, Astra y Sol se apiñan en 3 puntos, sin que ninguno aplaste a los demás; en coste, la factura por tarea difiere 8 veces, una divergencia mucho más intensa que la de la puntuación. La puntuación se obtiene en el nivel max, y la factura también se quema en el nivel max; ambas cifras deben leerse junto con el nivel. Para la mayoría de los equipos, la postura correcta no es tomar partido, sino enrutar según la dificultad de la tarea: Sol / Terra en volumen, Opus en nivel max para los asaltos. Si quieres implementar este enrutamiento en HiAPI, ambos modelos pueden empezar a funcionar ahora mismo.
Artículos relacionados
Ver todos los artículos →-

Comparativa
Wan 2.6 Flash vs Wan 2.7: ¿conviene actualizar?
Presupuesto en 720P y resultados en 1080P del zorro y el coche; condiciones de audio y nivel real indicados grupo por grupo.
-

Comparativa
Vidu Q4 Preview vs Kling 3.0: ¿cómo elegir para imagen a video?
Si quieres sonido por defecto, 16 segundos y 5 niveles de resolución, elige Vidu Q4 Preview; si quieres fijar la imagen con fotogramas inicial y final, elige Kling 3.0. Incluye dos comparativas con el mismo prompt: hidroavión y barista.
-

Comparativa
Alternativa a Replicate: comparativa de generación de imagen y vídeo entre hiapi y Replicate (2026)
Qué hay que cambiar en las llamadas de predicción, los webhooks y la facturación al migrar de Replicate a hiapi, con una lista de migración de 10 pasos.