
비교 평가
Opus 5.5 vs GPT-6.1 Sol: 점수 차이 3점, 비용 차이 8배
AA 지능 지수 v5 새 순위에서 1위의 작업당 비용은 $10.04, 3위는 $1.27. 점수는 비슷하지만 청구서는 8배 차이, 선택은 작업에 달려 있다
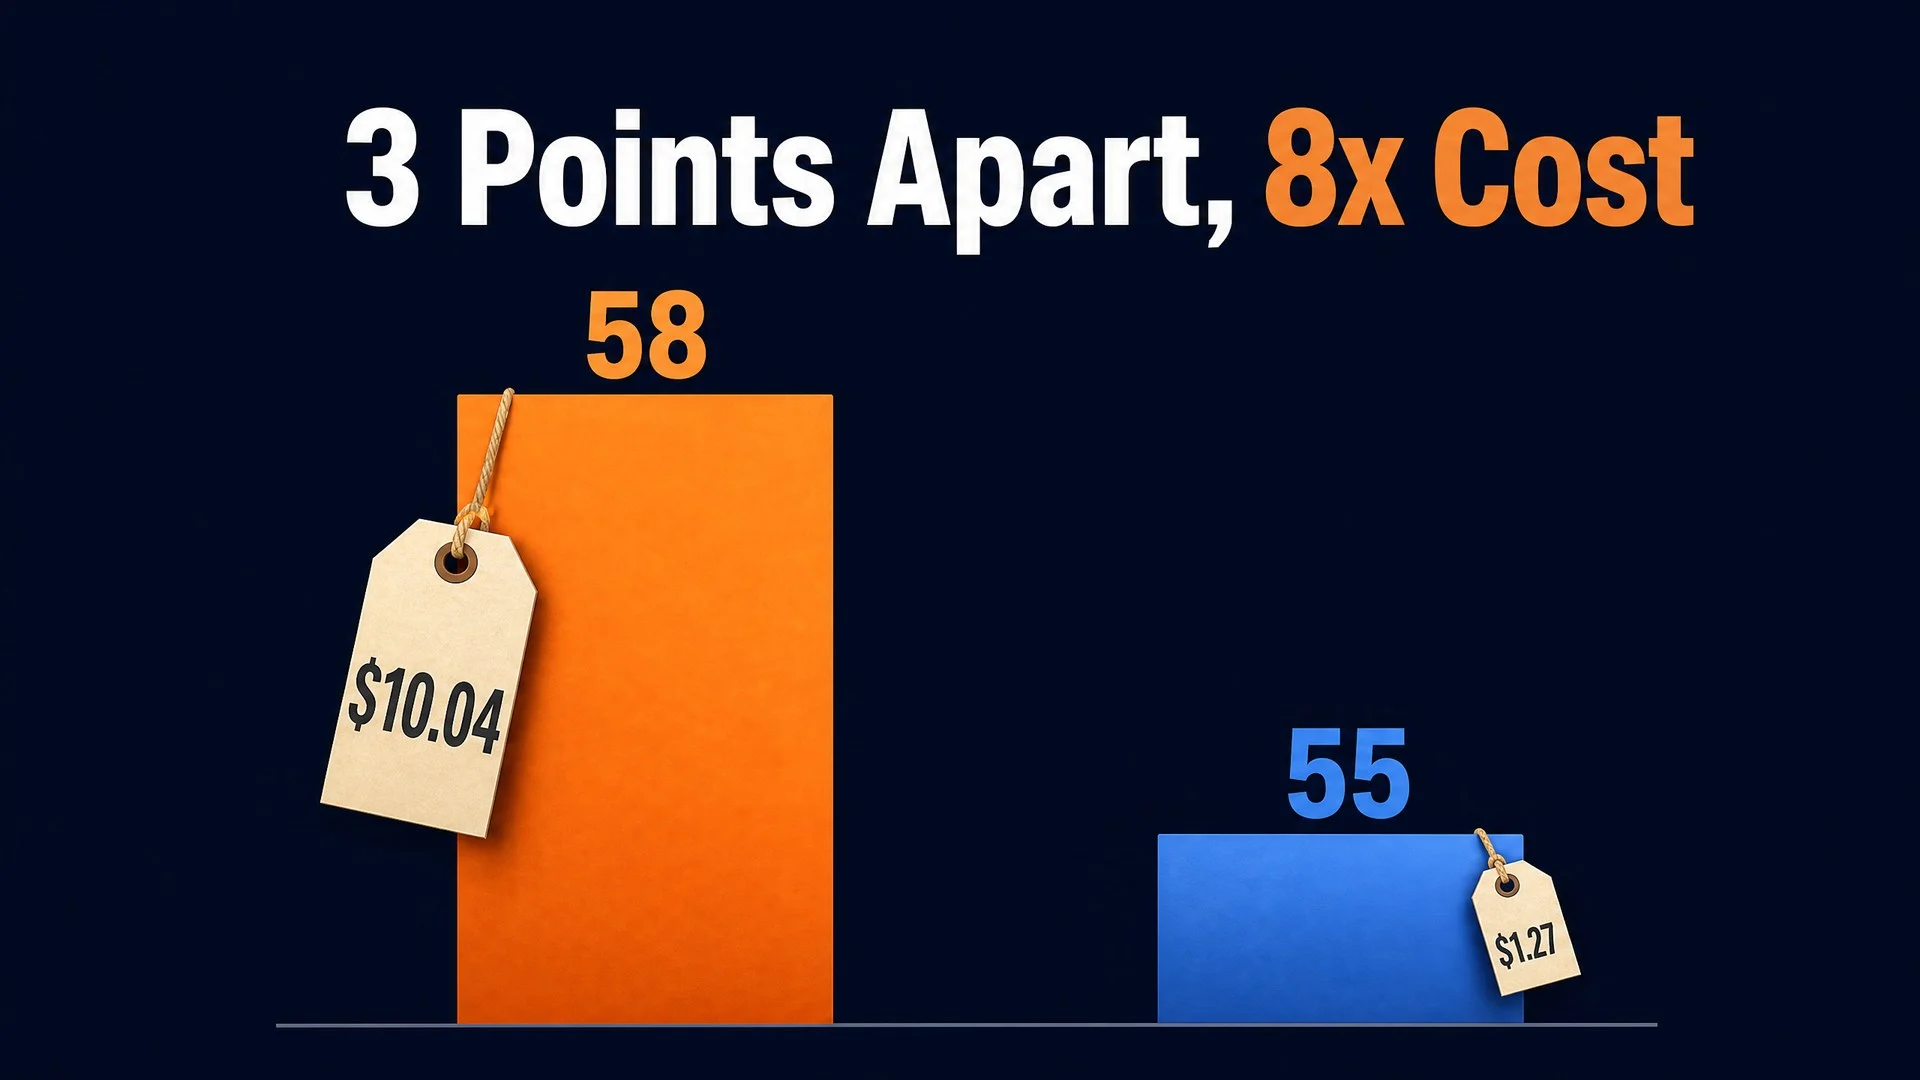
10월 27일, Artificial Analysis(이하 AA)는 Intelligence Index v5를 발표했습니다. 이는 2026년 1월 v4 출시 이후 최대 규모의 방법론 개편입니다. 개편 후 순위 상위 3위는 Claude Opus 5.5(58점), GPT-6 Astra(57점), GPT-6.1 Sol(55점)입니다.
점수 외에도 AA는 각 모델의 실측 작업당 비용(per-task cost)을 함께 공개했습니다. Opus 5.5는 max 추론 등급에서 작업당 $10.04인 반면, Sol은 $1.27에 불과합니다. AA의 공식 표현에 따르면 Sol은 1위와의 점수 차이가 4점 이내이며, 작업당 비용은 약 8분의 1 수준입니다.
먼저 결론부터 말하자면:
- 점수 측면: Opus 5.5가 58점으로 1위, Sol이 55점으로 3위로 불과 3점 차이, 같은 계층에 속함
- 비용 측면: max 등급 작업당 $10.04 대 $1.27, 약 8배 차이로 이미 같은 자릿수가 아님
- 저렴한 비결: 토큰 단가가 낮은 것이 아니라, Opus의 작업당 출력 토큰이 Sol의 약 3배이고 여기에 약 2배의 단가 차이가 겹쳐 청구서가 8배로 확대됨
- 어떻게 선택할까: 일상 에이전트 작업은 Sol / Terra로 대량 처리하고, 가장 어려운 난제 작업에만 Opus max 등급을 투입
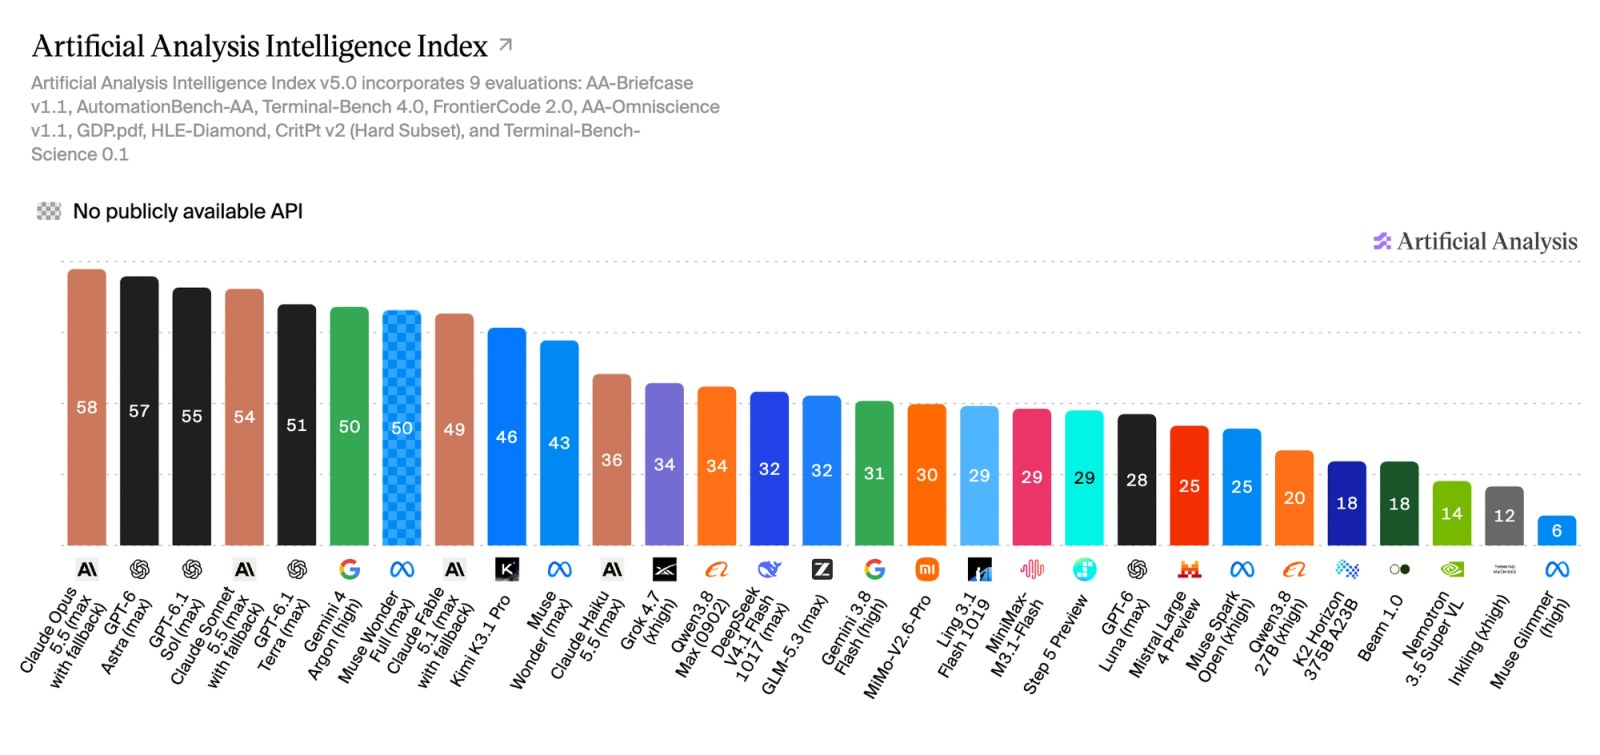
이미지 출처: Artificial Analysis Intelligence Index v5 공식 발표(2026-10-27)
배경: v5가 왜 「대개편」인가
v5의 변경 사항 중 독자와 가장 관련 깊은 두 가지가 있습니다. 첫째, 작업이 무거워졌습니다: 모든 평가의 중위 출력이 v4의 35K tokens에서 59K tokens로 증가했으며, 그중 약 90%가 agentic 다단계 작업에서 비롯되어 실제 워크로드에 더 가깝습니다. 둘째, 오염 방지: 60%의 평가가 비공개 테스트 세트로 교체되어 순위 조작의 여지를 차단했습니다.
순위에서 주목할 점이 두 가지 더 있습니다. GPT-6 Astra가 57점으로 2위에 머물렀고, Kimi K3.1 Pro가 46점으로 오픈 모델 1위를 차지했지만, 오픈 모델과 클로즈드 소스 상위 5위 간 격차가 3점에서 12점으로 벌어졌습니다.
흔한 오독 하나를 바로잡아야 합니다. Opus 5.5는 9월에 58점으로 AA 순위 1위를 차지한 적이 있지만, 당시에는 v4.3 구 작업 세트로 측정한 것이었습니다. 이번 v5 개편 후에도 여전히 1위라는 점, 즉 「개편 후에도 1위를 지켰다」는 것이 「한때 1위였다」보다 훨씬 높은 가치가 있으며, 두 가지를 혼동해서는 안 됩니다.
점수와 청구서: 표 하나로 확인
아래 작업당 비용은 모두 AA 공식 v5 발표의 실측 수치입니다(max 추론 등급):
| 모델 | v5 점수(max 등급) | 작업당 비용(AA 실측) |
|---|---|---|
| Claude Opus 5.5 | 58 | $10.04 |
| GPT-6 Astra | 57 | $6.24 |
| GPT-6.1 Sol | 55 | $1.27 |
| GPT-6.1 Terra | 상위 5위 미진입 | $0.96(가장 저렴) |
| Claude Fable 5.1 | 상위 5위 미진입 | $13.04(가장 비쌈) |
$10.04 ÷ $1.27 ≈ 7.9배로, AA 공식의 「약 8분의 1」이라는 표현과 일치합니다. AA는 동시에 선두 모델 간 작업당 비용 격차가 13배를 넘는다고 지적했습니다. 즉, 「플래그십 역량」이라는 좁은 구간에서 청구서의 분화는 점수보다 훨씬 격렬합니다.
한 가지 주의: 인터넷에서 Sol $0.72, Opus $5.98이라는 숫자를 본다면, 그것은 v4 구 작업 세트(중위 출력 35K tokens)의 잔재이며, v5에서 작업이 무거워진 후 공식 기준은 $1.27과 $10.04로 갱신되었으므로 인용 시 2026-10-27 발표를 기준으로 삼으세요.
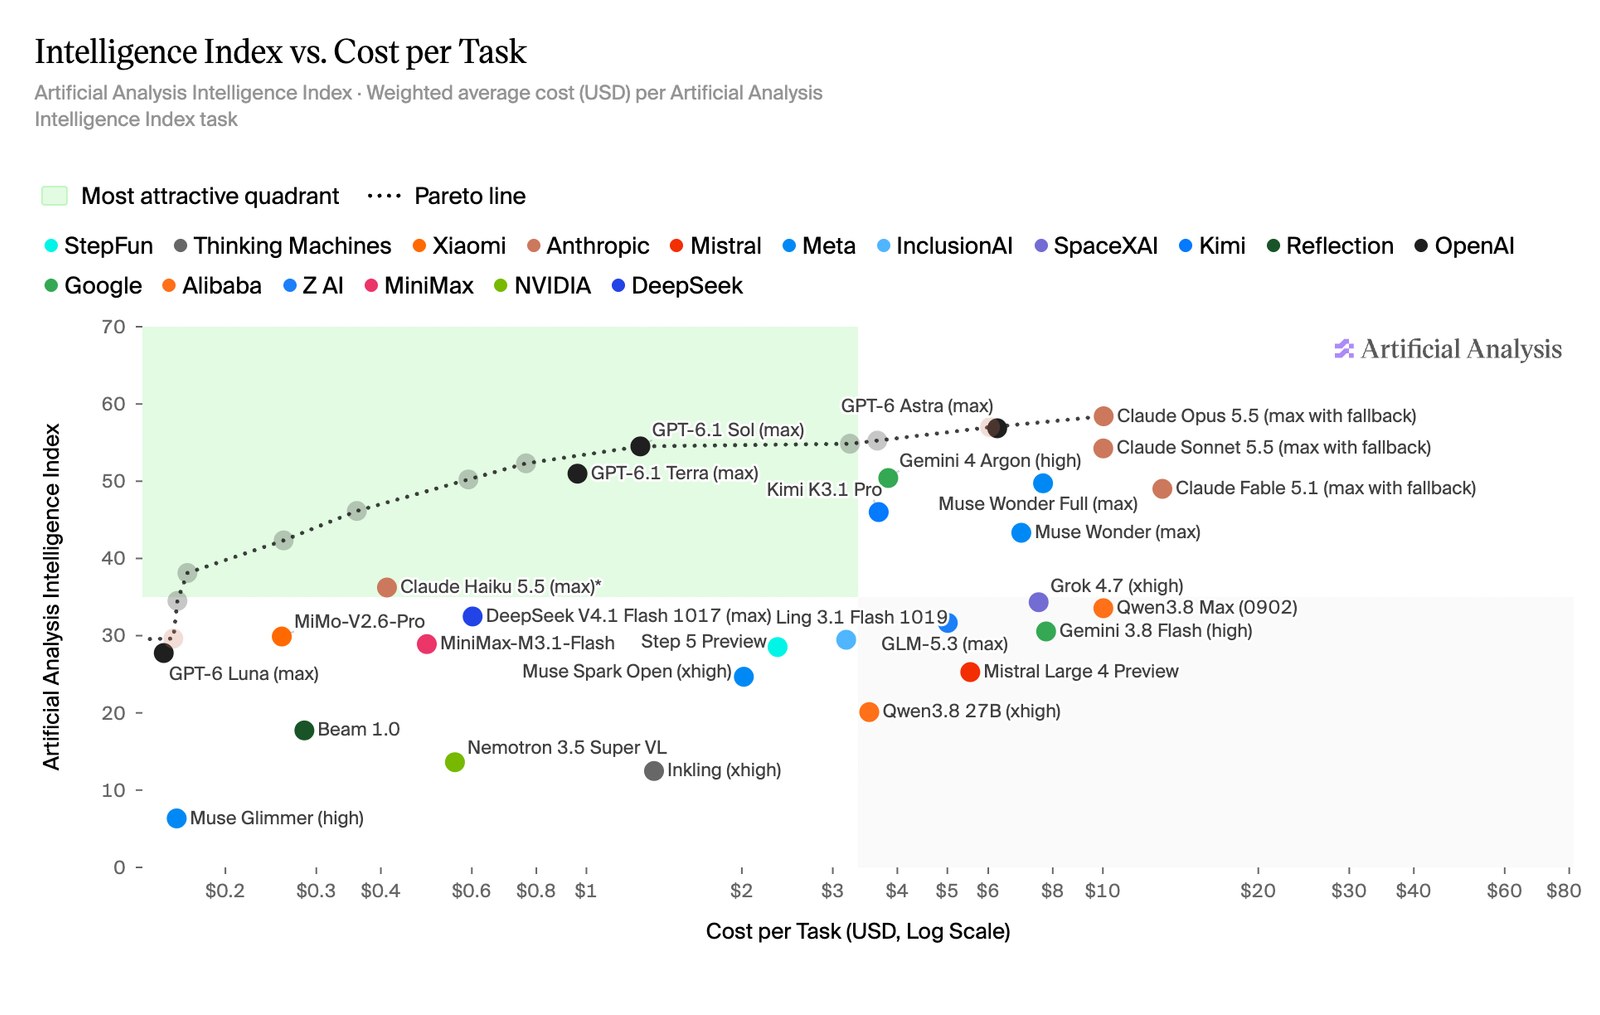
이미지 출처: Artificial Analysis Intelligence Index v5 공식 발표(2026-10-27)
왜 토큰 단가로는 작업당 비용을 예측할 수 없는가
이는 v5 발표 후 커뮤니티에서 가장 많이 논의된 점입니다. AA 발표에서 환산에 사용한 공식 토큰 가격 기준으로, Opus 5.5는 토큰당 약 Sol의 2배입니다(HiAPI 플랫폼 가격 기준은 다르며, 아래 참조). 그러나 작업당 비용은 8배 차이입니다. 추가된 배수는 출력 길이에서 비롯됩니다. 실측에서 Opus의 작업당 생성 출력 토큰은 약 Sol의 3배였습니다. 2배 단가에 3배 사용량을 곱하면 8배 청구서가 됩니다.
이는 v5에서 더욱 확대되었습니다. 작업이 무거워졌다는 것은 출력이 더 길어진다는 뜻이며, 「긴 출력을 좋아하는」 모델은 더 비싸집니다. 이는 가격표만 보면 체계적으로 왜곡되는 이유도 설명합니다. 가격표는 「토큰당 얼마인지」를 알려주고, 청구서는 「이 일을 끝내는 데 얼마인지」를 알려줍니다. 둘 다 중요하지만, 예산표에 들어갈 수 있는 것은 하나뿐입니다.
지수는 어떻게 구성되며, effort 등급이 왜 중요해졌나
v5 지수는 9개 평가로 구성되며, 4개 대분류로 나뉘어 각각 25%를 차지합니다: 지식 작업(25%), 코딩(25%), 과학(25%), 범용(25%). 어떤 모델도 9개 항목 1위를 모두 석권하지 못했으며, Opus 5.5는 그중 3개 항목(코딩, 범용 내 두 가지 하드코어 평가)에서 선두이고, GPT-6 Astra는 2개 항목에서 선두입니다. 이는 「누가 1위인가」가 어느 정도 당신의 작업이 어느 대분류에 속하는지에 달려 있음을 의미합니다. 코드 작성과 난해한 지식 문제 풀이에서는 Opus의 점수가 더 참고 가치가 있고, 지식 작업과 자동화 중심의 시나리오에서는 격차가 총점이 보여주는 것보다 작을 수 있습니다.
v5의 또 다른 변화는 effort 추론 등급이 점수에 미치는 영향이 현저히 커졌다는 점입니다. Opus 5.5는 low 등급에서 35점에 불과하지만 max 등급에서는 58점이며, Sol의 등급 폭도 20점으로 벌어졌습니다. 다시 말해, 순위의 58점과 55점은 모두 「화력 전개」로 나온 결과입니다.
한 줄 요약: 점수는 max 등급에서 나오고, 청구서도 max 등급에서 불태워 나온 것입니다. 순위를 보고 예산을 짤 때는 두 숫자 모두 등급과 함께 봐야 합니다. 일상 작업이 low / medium 등급만 사용한다면, 두 모델의 실제 격차는 순위와 다를 것입니다.
실무: 작업 난이도별 라우팅, 일괄 처리하지 말 것
위 데이터에 따르면, 가장 비용을 아끼는 방법은 「전부 Sol로 교체」나 「전부 Opus 유지」가 아니라 작업 난이도에 따라 계층화하는 것입니다:
- 일상 에이전트 작업(스크립트, 데이터 정제, 일반 코딩, 배치 처리): Sol 또는 Terra로 대량 처리, $0.96~$1.27의 작업당 비용은 대량 처리에 적합
- 난제 작업(복잡한 리팩터링, 심층 추론, 다중 홉 분석): Opus max 등급 투입, 3점 차이에 8배 비용을 지불하되, 가치 있는 작업에만 지불
- 비용을 한 단계 더 낮추려면: effort 등급부터 조정하고, 기본 설정을 최고 등급에 고정하지 말 것
대략적인 계산으로 격차를 체감해 봅시다. 동일하게 1000개의 일상 작업을 실행할 때, 전부 Sol로 처리하면 약 $1,270, 전부 Opus max 등급으로 처리하면 약 $10,040이 들어, 차액 $8,770은 팀의 한 달 난제 작업 할당량을 전부 커버하고도 남습니다. 반대로 비용을 아끼려고 모든 작업을 Sol에 몰아넣는다면, 3점 차이는 가장 어려운 5% 작업에서 「해낼 수 있다」와 「해낼 수 없다」의 차이가 될 수 있습니다. 라우팅의 의미가 바로 여기에 있습니다. 비싼 모델은 정말로 필요한 작업에만 사용하는 것입니다.
이러한 「하나의 작업 풀, 두 개의 모델」 라우팅 구조야말로 집계 플랫폼의 주특기입니다. 두 업체에 각각 계정을 등록하고 두 세트의 청구서를 대조할 필요 없이, 하나의 Key로 요청별로 전환할 수 있습니다. 저희는 Claude Code와 Codex 연동 글에서 동일한 작업별 모델 전환 사고방식을 시연한 적이 있으니, 관심 있으시면 대조해 보세요.
HiAPI에서 두 모델을 어떻게 연동하나
먼저 플랫폼 가격을 제시합니다(2026-10 기준, 모두 ≤272K 컨텍스트 기본 등급):
| 모델 | 입력 | 출력 | 캐시 읽기 |
|---|---|---|---|
| claude-opus-5-5 | $2.02/M | $10.08/M | $0.10/M |
| gpt-6.1-sol | $0.50/M | $2.50/M | $0.025/M |
기준 분리에 유의하세요. 위 표는 HiAPI의 토큰 단가이며, 앞서 언급한 $10.04 / $1.27은 AA 실측 작업당 비용으로, 두 숫자는 출처가 달라 직접 혼합 계산할 수 없습니다. 플랫폼 가격에서 Sol의 입력·출력 단가는 모두 Opus의 약 4분의 1이며, 이는 가격표 기준입니다. 이를 작업당 청구서로 환산하고 앞서 말한 출력량 차이를 겹치면 AA의 1/8이 됩니다.
연동 측면에서 Opus 5.5는 Anthropic Messages와 OpenAI Chat Completions 이중 프로토콜을 지원하며 5단계 effort를 조정할 수 있고, Sol은 Responses와 Chat Completions 이중 프로토콜을 지원하며 컨텍스트는 1.05M입니다. 두 모델 모두 동일한 API Key로 호출할 수 있으며, 요청별로 라우팅하면 됩니다.
- Opus 5.5의 역량 경계와 전체 파라미터는 모델 상세 페이지에서, Sol은 모델 상세 페이지에서 확인하세요
- 시작 가이드: GPT-6.1 Sol API 연동 가이드, Claude Opus 5.5 API 가격 분석
- 이전 세대 비교 참고: Opus 5.5 vs GPT-5.6 Sol
- 같은 배치의 글: GPT-6.1 Terra 가격 인하 속보, Claude Code / Codex 모델 전환 가이드, Genie 4 속보
자주 묻는 질문
Sol의 작업당 $1.27은 어떻게 계산된 것인가?
이는 AA 공식 v5 발표의 실측 기준입니다. max 추론 등급으로 일련의 작업을 실행하고, 실제 소비된 입력·출력 토큰과 공식 가격으로 환산한 것입니다. 정가가 아니라 청구서이므로, 가격표를 보는 것보다 실제로 지불할 금액에 더 가깝습니다.
인터넷에 쓰인 Sol $0.72, Opus $5.98 작업당 비용 중 어느 것이 맞나?
$0.72 / $5.98은 v4 구 작업 세트의 숫자로, 당시 작업 중위 출력은 35K tokens에 불과했습니다. v5에서 작업이 무거워진 후(중위 59K tokens) 공식은 $1.27 / $10.04로 갱신되었습니다. 2026-10-27의 v5 발표를 기준으로 삼으세요.
Sol과 Opus 5.5의 토큰 단가는 몇 배 차이인가?
HiAPI 플랫폼 가격(2026-10 기준, ≤272K 기본 등급)으로 Sol 입력 $0.50/M, 출력 $2.50/M, Opus 입력 $2.02/M, 출력 $10.08/M으로 단가는 약 4배입니다. 그러나 이는 가격표 기준이며, AA의 작업당 비용 기준은 약 8배로, 차액은 Opus의 작업당 약 3배 출력량에서 비롯됩니다. 두 기준 모두 성립하지만 혼합 계산은 하지 마세요.
effort 등급이란? 왜 점수 차이가 이렇게 큰가?
effort는 모델 추론 시 투입 등급으로, 높을수록 사고가 깊고 출력이 길어집니다. v5에서 Opus 5.5는 low 등급 35점에서 max 등급 58점으로 폭이 23점이며, Sol의 등급 폭도 20점입니다. 따라서 「Sol이 Opus를 대체할 수 있는가」는 일상적으로 어떤 등급을 켜는지, 그리고 고난도 작업에 얼마를 지불할 의향이 있는지에 달려 있습니다.
내 작업에는 Sol과 Opus 5.5 중 무엇을 써야 하나?
일상 에이전트 작업(스크립트, 정제, 일반 코딩)은 먼저 Sol로 실행하고, 물량이 많아도 비용이 통제 가능합니다. 판단이 어려운 난제 작업은 Opus max 등급으로 한 차례 비교해 보세요. HiAPI는 하나의 Key로 두 모델을 모두 호출할 수 있어, 라우팅 전환에 추가 연동 비용이 없습니다.
핵심 결론
v5 순위는 두 가지를 동시에 드러냈습니다. 역량 면에서 Opus 5.5, Astra, Sol은 3점 이내에 몰려 있어 누구도 압도하지 못하며, 비용 면에서 작업당 청구서는 8배 차이로 점수 분화보다 훨씬 격렬합니다. 점수는 max 등급에서 나오고 청구서도 max 등급에서 불태워 나온 것이라, 두 숫자 모두 등급과 함께 봐야 합니다. 대부분의 팀에게 올바른 자세는 편을 고르는 것이 아니라 작업 난이도별 라우팅입니다. Sol / Terra로 대량 처리하고, Opus max 등급으로 난제를 공략하는 것입니다. 이 라우팅을 HiAPI에서 구현하고 싶다면, 두 모델은 지금 바로 실행할 수 있습니다.
관련 글
모든 아티클 보기 →-

비교 평가
Wan 2.6 Flash vs Wan 2.7: 업그레이드해야 할까?
720P 예산과 1080P 여우·자동차 완성본; 그룹별 오디오 조건과 실제 등급 표기.
-

비교 평가
Vidu Q4 Preview vs Kling 3.0: 이미지-투-비디오, 어떻게 선택할까?
기본 유음, 16초, 5단계 해상도가 필요하면 Vidu Q4 Preview, 첫/마지막 프레임으로 화면을 고정하려면 Kling 3.0. 수상 비행기와 바리스타 두 그룹의 동일 프롬프트 대조 포함.
-

비교 평가
Replicate 대안: hiapi vs Replicate 이미지 및 영상 생성 비교 (2026)
Replicate에서 hiapi로 마이그레이션할 때 예측 호출, webhook, 과금을 각각 어떻게 바꿔야 하는지, 10단계 마이그레이션 체크리스트 포함.