
Confronto e valutazione
Opus 5.5 vs GPT-6.1 Sol: 3 punti di differenza nel punteggio, 8 volte di differenza nei costi
Nella nuova classifica AA Intelligence Index v5, il primo costa $10.04 per attività, il terzo $1.27. Punteggi vicini, fatture 8 volte diverse: la scelta dipende dal tipo di task
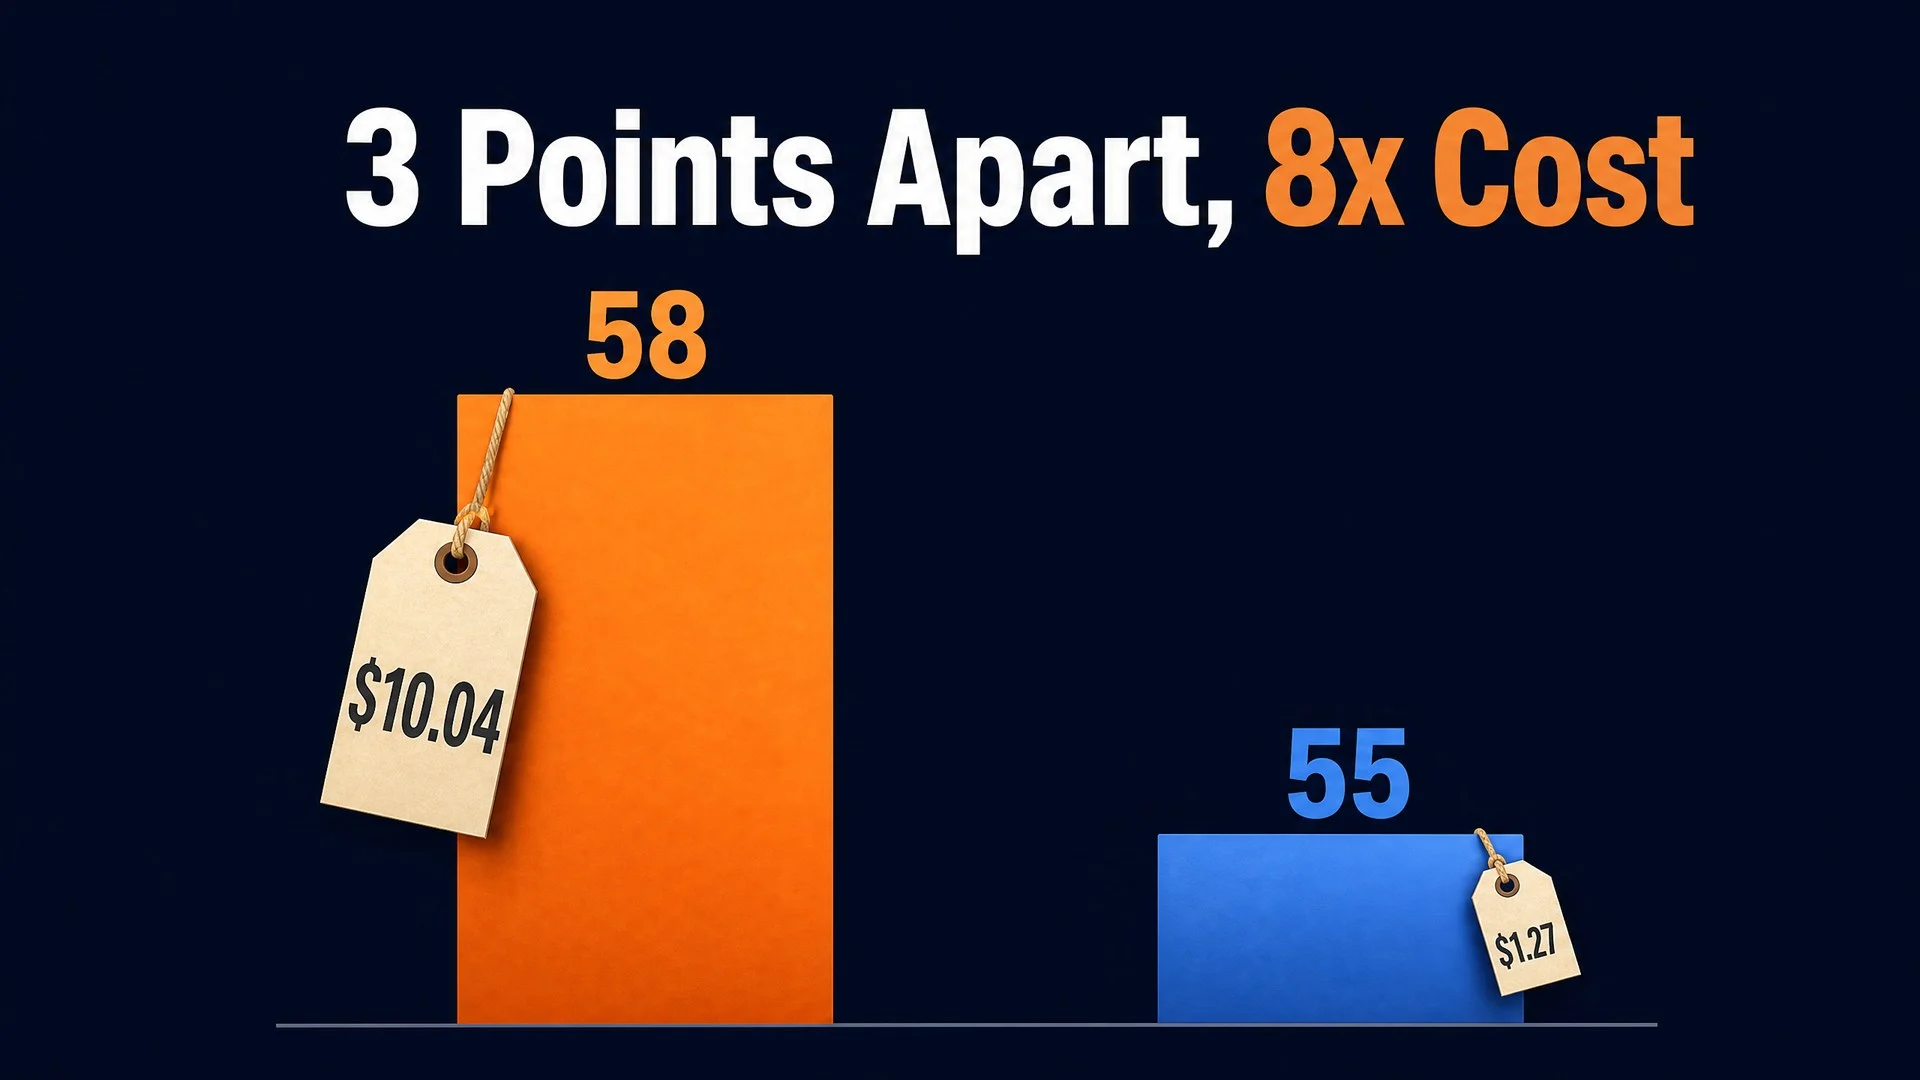
Il 27 ottobre, Artificial Analysis (di seguito AA) ha pubblicato l'Intelligence Index v5, la revisione metodologica più ampia da quando è stata lanciata la v4 a gennaio 2026. I primi tre posti della nuova classifica sono: Claude Opus 5.5 (58 punti), GPT-6 Astra (57 punti), GPT-6.1 Sol (55 punti).
Oltre ai punteggi, AA ha pubblicato anche il costo per attività (per-task cost) misurato di ciascun modello: Opus 5.5 al livello di ragionamento max costa $10.04 per attività, mentre Sol solo $1.27. La formulazione ufficiale di AA è: Sol ha un divario di punteggio entro i 4 punti dal primo posto, con un costo per attività di circa un ottavo.
Prima le conclusioni:
- Sul piano del punteggio: Opus 5.5 è primo con 58 punti, Sol è terzo con 55, solo 3 punti di differenza, stessa fascia
- Sul piano del costo: al livello max $10.04 contro $1.27 per attività, circa 8 volte di differenza, non più lo stesso ordine di grandezza
- Il segreto del costo inferiore: non è il prezzo unitario dei token più basso, ma il fatto che Opus genera circa 3 volte i token di output per attività rispetto a Sol, che sommato a un divario di prezzo unitario di circa 2 volte porta la fattura a 8 volte
- Come scegliere: per le attività agent quotidiane usare Sol / Terra per il volume, per i task più complessi passare al livello max di Opus
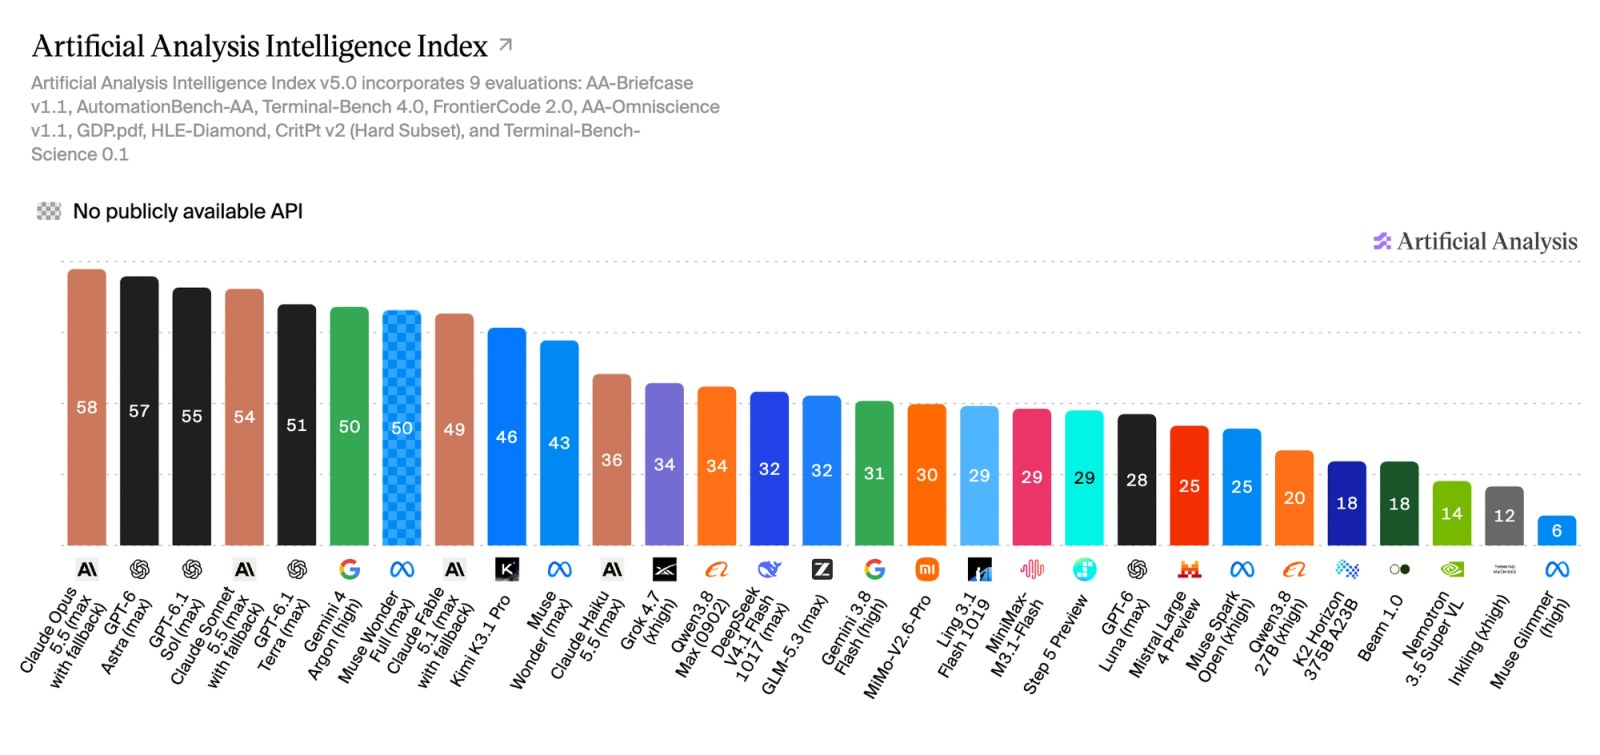
Fonte immagine: annuncio ufficiale Artificial Analysis Intelligence Index v5 (2026-10-27)
Premessa: perché la v5 è considerata una «grande revisione»
Tra le modifiche della v5, due sono le più rilevanti per i lettori. La prima è che i task sono diventati più pesanti: l'output mediano di tutte le valutazioni è passato da 35K token della v4 a 59K token, di cui circa il 90% proviene da task agentici multi-step, più vicini a carichi di lavoro reali. La seconda è l'anti-contaminazione: il 60% delle valutazioni è stato sostituito con set di test privati, chiudendo la possibilità di manipolare la classifica.
Ci sono altri due punti degni di nota nella classifica: GPT-6 Astra si ferma al secondo posto con 57 punti; Kimi K3.1 Pro conquista il primo posto tra i modelli aperti con 46 punti, ma il divario tra i primi cinque aperti e chiusi si è allargato da 3 a 12 punti.
Va chiarita una lettura errata comune: Opus 5.5 era già arrivato primo nella classifica AA a settembre con 58 punti, ma allora girava sul vecchio set di task v4.3. Dopo la revisione v5 è ancora primo: «restare primo dopo la revisione» vale molto più di «essere stato primo», non confondere le due cose.
Punteggio e fattura: tutto in una tabella
I seguenti costi per attività sono tutti dati misurati dall'annuncio ufficiale v5 di AA (livello di ragionamento max):
| Modello | Punteggio v5 (livello max) | Costo per attività (misurato da AA) |
|---|---|---|
| Claude Opus 5.5 | 58 | $10.04 |
| GPT-6 Astra | 57 | $6.24 |
| GPT-6.1 Sol | 55 | $1.27 |
| GPT-6.1 Terra | Non in top five | $0.96 (il più economico) |
| Claude Fable 5.1 | Non in top five | $13.04 (il più costoso) |
$10.04 ÷ $1.27 ≈ 7,9 volte, coerente con la formulazione ufficiale di AA «circa un ottavo». AA sottolinea inoltre che il divario di costo per attività tra i modelli di punta supera le 13 volte. In altre parole, nella stretta fascia delle «capacità di punta», la differenziazione delle fatture è molto più marcata di quella dei punteggi.
Un avvertimento: se vedete online cifre come Sol $0,72, Opus $5,98, sono residui del vecchio set di task v4 (output mediano 35K token); dopo l'inasprimento dei task nella v5 la formulazione ufficiale è stata aggiornata a $1,27 e $10,04, fate riferimento all'annuncio del 2026-10-27.
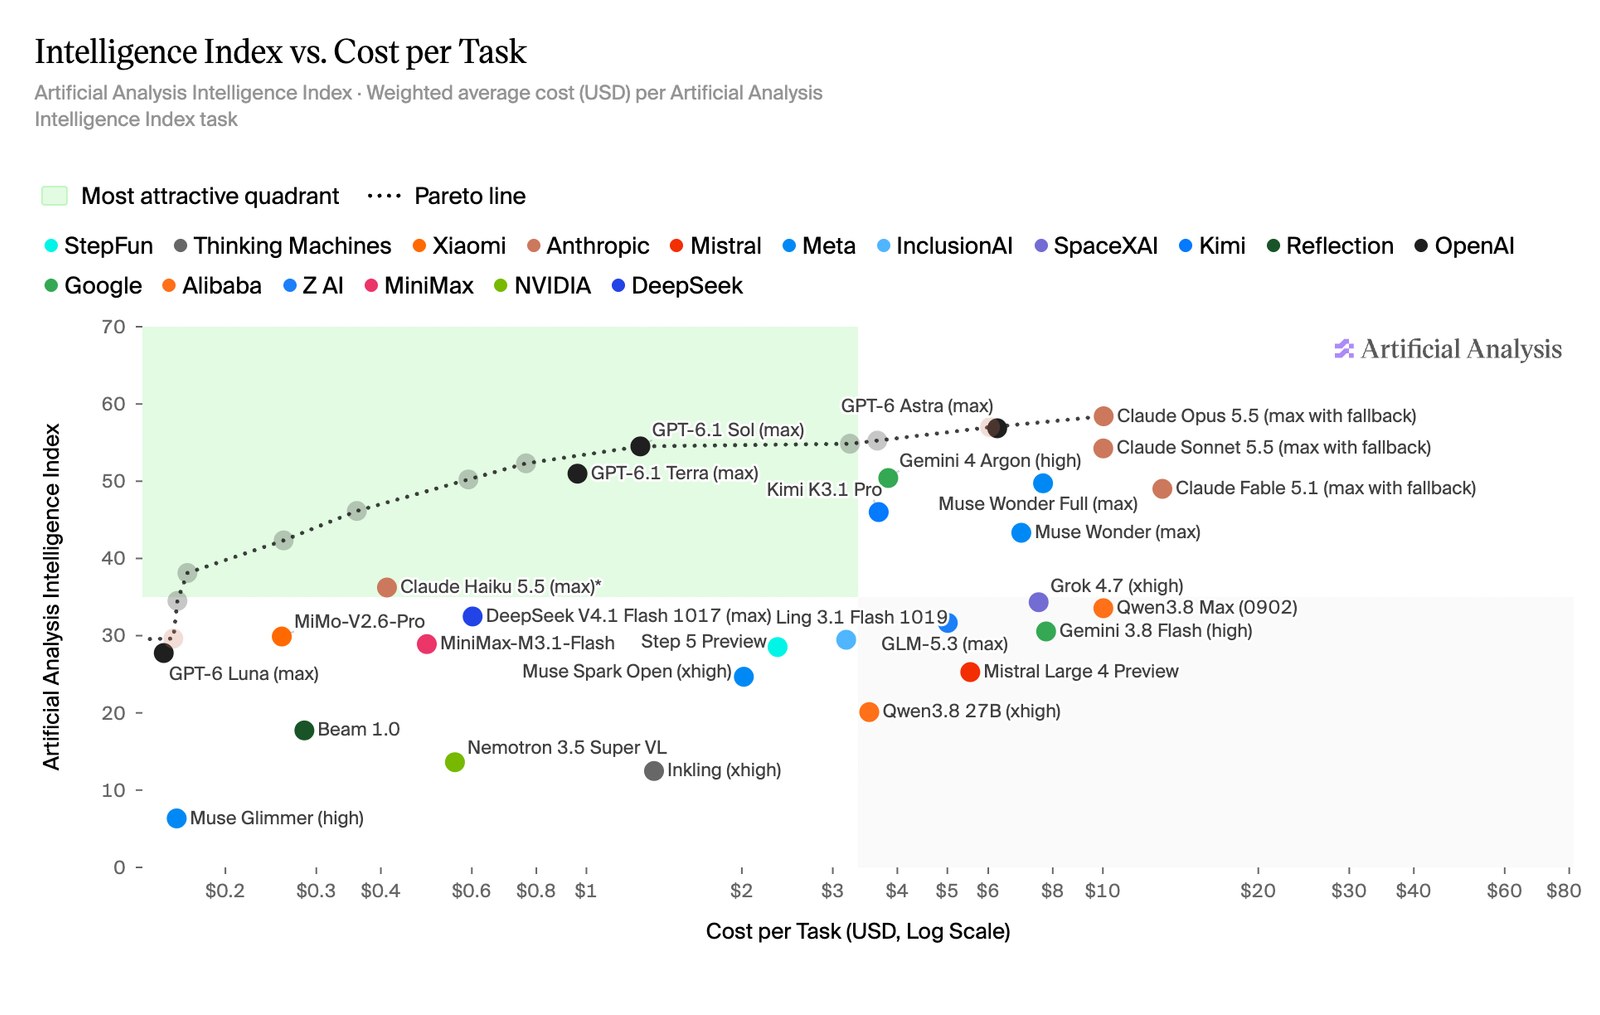
Fonte immagine: annuncio ufficiale Artificial Analysis Intelligence Index v5 (2026-10-27)
Perché il prezzo unitario dei token non predice il costo per attività
Questo è il punto più discusso dalla community dopo l'uscita della v5. Secondo il prezzo ufficiale per token usato da AA per la conversione, Opus 5.5 costa circa il doppio per token rispetto a Sol (i prezzi della piattaforma HiAPI seguono un'altra logica, vedi sotto), ma il costo per attività differisce di 8 volte. Il moltiplicatore in più deriva dalla lunghezza dell'output: nelle misurazioni Opus genera circa 3 volte i token di output per attività rispetto a Sol. 2 volte il prezzo unitario moltiplicato per 3 volte l'utilizzo dà una fattura di 8 volte.
Questo effetto è stato ulteriormente amplificato nella v5, perché task più pesanti significano output più lunghi, e i modelli «prolissi» costano di più. Spiega anche perché guardare solo il listino prezzi porta a distorsioni sistematiche: il listino ti dice «quanto costa ogni token», la fattura ti dice «quanto costa portare a termine questa cosa». Entrambi contano, ma solo uno entra nel budget.
Come è composto l'indice e perché il livello di effort è diventato importante
L'indice v5 è composto da 9 valutazioni, divise in 4 macro-categorie di pari peso, ciascuna al 25%: lavoro intellettuale (25%), coding (25%), scienza (25%), generale (25%). Nessun modello conquista il primo posto in tutte e 9 le valutazioni; Opus 5.5 guida in 3 (coding e due valutazioni hardcore della categoria generale), GPT-6 Astra in 2. Ciò significa che «chi è primo» dipende in una certa misura da quale macro-categoria ricade il vostro task: per scrivere codice e affrontare problemi di conoscenza complessi, il punteggio di Opus è più indicativo; in scenari orientati al lavoro intellettuale e all'automazione, il divario sarà più piccolo di quanto mostri il punteggio totale.
Un altro cambiamento della v5 è che l'impatto del livello di ragionamento effort sul punteggio è aumentato sensibilmente: Opus 5.5 al livello low ha solo 35 punti, al livello max 58; anche l'ampiezza dei livelli di Sol arriva a 20 punti. In altre parole, i 58 e 55 punti della classifica sono ottenuti «a pieno regime».
In sintesi: i punteggi sono ottenuti al livello max, e anche le fatture sono bruciate al livello max. Quando guardate la classifica per fare budget, leggete entrambi i numeri insieme al livello. Se per le attività quotidiane usate solo i livelli low / medium, il divario reale tra i due modelli sarà diverso da quello della classifica.
Pratica: instradare per difficoltà del task, non tagliare con l'accetta
Secondo i dati sopra, l'uso più economico non è «passare tutto a Sol» o «tenere tutto su Opus», ma stratificare in base alla difficoltà del task:
- Attività agent quotidiane (script, pulizia dati, coding ordinario, elaborazione batch): Sol o addirittura Terra per il volume, con un costo per attività da $0,96 a $1,27 adatto alla scalabilità
- Task complessi (refactoring complesso, ragionamento profondo, analisi multi-hop): passare al livello max di Opus, pagare 8 volte il costo per 3 punti di differenza solo sui task che lo meritano
- Per comprimere ulteriormente i costi: agire sul livello di effort, non bloccare la configurazione predefinita al livello massimo
Un calcolo rapido per percepire il divario: per 1000 attività quotidiane, con Sol si spendono circa $1.270, con Opus al livello max circa $10.040; i $8.770 di differenza bastano a coprire per un mese l'intero budget dei task complessi del team, con margine. Viceversa, se per risparmiare si affidano tutti i task a Sol, quei 3 punti di differenza sul 5% dei task più difficili possono significare la differenza tra «riuscirci» e «non riuscirci». Il senso del routing è proprio questo: far spendere il modello costoso solo sui task che ne hanno davvero bisogno.
Questa struttura di routing «un pool di task, due modelli» è il terreno d'elezione delle piattaforme di aggregazione: nessun bisogno di registrare due account separati e gestire due fatture, una sola Key permette di cambiare modello per richiesta. Abbiamo illustrato la stessa logica di selezione del modello per task nell'articolo sull'integrazione di Claude Code e Codex, se vi interessa potete confrontarlo.
Come integrare i due modelli su HiAPI
Prima i prezzi della piattaforma (aggiornati a ottobre 2026, tutti per il livello base con contesto ≤272K):
| Modello | Input | Output | Lettura cache |
|---|---|---|---|
| claude-opus-5-5 | $2,02/M | $10,08/M | $0,10/M |
| gpt-6.1-sol | $0,50/M | $2,50/M | $0,025/M |
Attenzione a non mescolare le unità di misura: la tabella sopra riporta i prezzi per token di HiAPI, mentre i $10,04 / $1,27 citati prima sono i costi per attività misurati da AA; le due serie di numeri hanno fonti diverse e non vanno sommate direttamente. Nei prezzi della piattaforma, le tariffe di input e output di Sol sono circa un quarto di quelle di Opus: questa è la logica del listino; convertita in fattura per attività, sommando la differenza di volume di output di cui sopra, si arriva all'1/8 di AA.
Sul fronte dell'integrazione, Opus 5.5 supporta il doppio protocollo Anthropic Messages e OpenAI Chat Completions, con cinque livelli di effort regolabili; Sol supporta il doppio protocollo Responses e Chat Completions, con contesto da 1,05M. Entrambi i modelli sono richiamabili con la stessa API Key, basta instradare per richiesta.
- Per i limiti di capacità e i parametri completi di Opus 5.5 vedi la pagina di dettaglio del modello, per Sol vedi la pagina di dettaglio del modello
- Tutorial per iniziare: Guida all'integrazione dell'API GPT-6.1 Sol, Analisi dei prezzi dell'API Claude Opus 5.5
- Confronto con la generazione precedente: Opus 5.5 vs GPT-5.6 Sol
- Articoli dello stesso periodo: Notizia del taglio di prezzo di GPT-6.1 Terra, Guida al cambio di modello in Claude Code / Codex, Notizia su Genie 4
Domande frequenti
Come si calcola il $1,27 per attività di Sol?
È la misurazione ufficiale dell'annuncio v5 di AA: eseguendo una serie di task al livello di ragionamento max, convertendo in base ai token di input e output realmente consumati e ai prezzi ufficiali. Non è un prezzo di listino, è una fattura, quindi è più vicino a quanto pagherete effettivamente rispetto a guardare il listino.
Online si leggono Sol $0,72 e Opus $5,98 per attività: quale è corretto?
$0,72 / $5,98 sono cifre del vecchio set di task v4, quando l'output mediano era di soli 35K token. Dopo l'inasprimento dei task nella v5 (mediana 59K token), i valori ufficiali sono stati aggiornati a $1,27 / $10,04. Fate riferimento all'annuncio v5 del 2026-10-27.
Di quante volte differisce esattamente il prezzo per token tra Sol e Opus 5.5?
Secondo i prezzi della piattaforma HiAPI (aggiornati a ottobre 2026, livello base ≤272K), Sol costa $0,50/M in input e $2,50/M in output, Opus $2,02/M in input e $10,08/M in output, circa 4 volte il prezzo unitario. Ma questa è la logica del listino; il costo per attività di AA è circa 8 volte, la differenza deriva dal volume di output di Opus circa 3 volte superiore per attività. Entrambe le metriche sono valide, non mescolatele nei calcoli.
Cos'è il livello di effort? Perché il punteggio varia così tanto?
L'effort è il livello di impegno del modello nel ragionamento: più è alto, più profondo è il pensiero e più lungo l'output. Con la v5, Opus 5.5 passa da 35 punti al livello low a 58 al livello max, un'ampiezza di 23 punti; anche l'ampiezza dei livelli di Sol è di 20 punti. Quindi «se Sol può sostituire Opus» dipende da quale livello usate quotidianamente e da quanto siete disposti a pagare per i task più difficili.
Per i miei task devo usare Sol o Opus 5.5?
Per le attività agent quotidiane (script, pulizia, coding ordinario) partite con Sol, il volume è gestibile e i costi controllabili; per i task complessi di cui non siete sicuri, fate un confronto con Opus al livello max. Con una sola Key di HiAPI potete richiamare entrambi i modelli, il cambio di routing non comporta costi di integrazione aggiuntivi.
Conclusioni chiave
La classifica v5 mette sul tavolo due cose contemporaneamente: sul piano delle capacità, Opus 5.5, Astra e Sol sono racchiusi entro 3 punti, nessuno domina nettamente gli altri; sul piano dei costi, la fattura per attività differisce di 8 volte, una differenziazione molto più marcata dei punteggi. I punteggi sono ottenuti al livello max, e anche le fatture sono bruciate al livello max: entrambi i numeri vanno letti insieme al livello. Per la maggior parte dei team, la scelta corretta non è schierarsi, ma instradare per difficoltà del task: Sol / Terra per il volume, Opus al livello max per i task complessi. Per implementare questo routing su HiAPI, entrambi i modelli sono già pronti all'uso.
Articoli correlati
Vedi tutti gli articoli →-

Confronto e valutazione
Wan 2.6 Flash vs Wan 2.7: conviene aggiornare?
Budget 720P e risultati 1080P di volpe e auto; condizioni audio e livello effettivo indicati per ogni gruppo.
-

Confronto e valutazione
Vidu Q4 Preview vs Kling 3.0: come scegliere per il video da immagine?
Con audio di default, 16 secondi e 5 livelli di risoluzione scegli Vidu Q4 Preview; con primo e ultimo frame per bloccare l'immagine scegli Kling 3.0. In allegato due confronti con lo stesso prompt: idrovolante e barista.
-

Confronto e valutazione
Alternativa a Replicate: confronto hiapi vs Replicate per la generazione di immagini e video (2026)
Cosa cambia nelle chiamate di prediction, nei webhook e nella fatturazione quando si migra da Replicate a hiapi, con una checklist di migrazione in 10 passaggi.