
Vergleichstest
Opus 5.5 vs. GPT-6.1 Sol: 3 Punkte Punktedifferenz, 8-facher Kostenunterschied
Im neuen Ranking des AA Intelligence Index v5 kostet der Erste $10.04 pro Aufgabe, der Dritte $1.27. Die Punkte liegen nah beieinander, die Rechnungen unterscheiden sich um das 8-Fache – die Wahl hängt von der Aufgabe ab
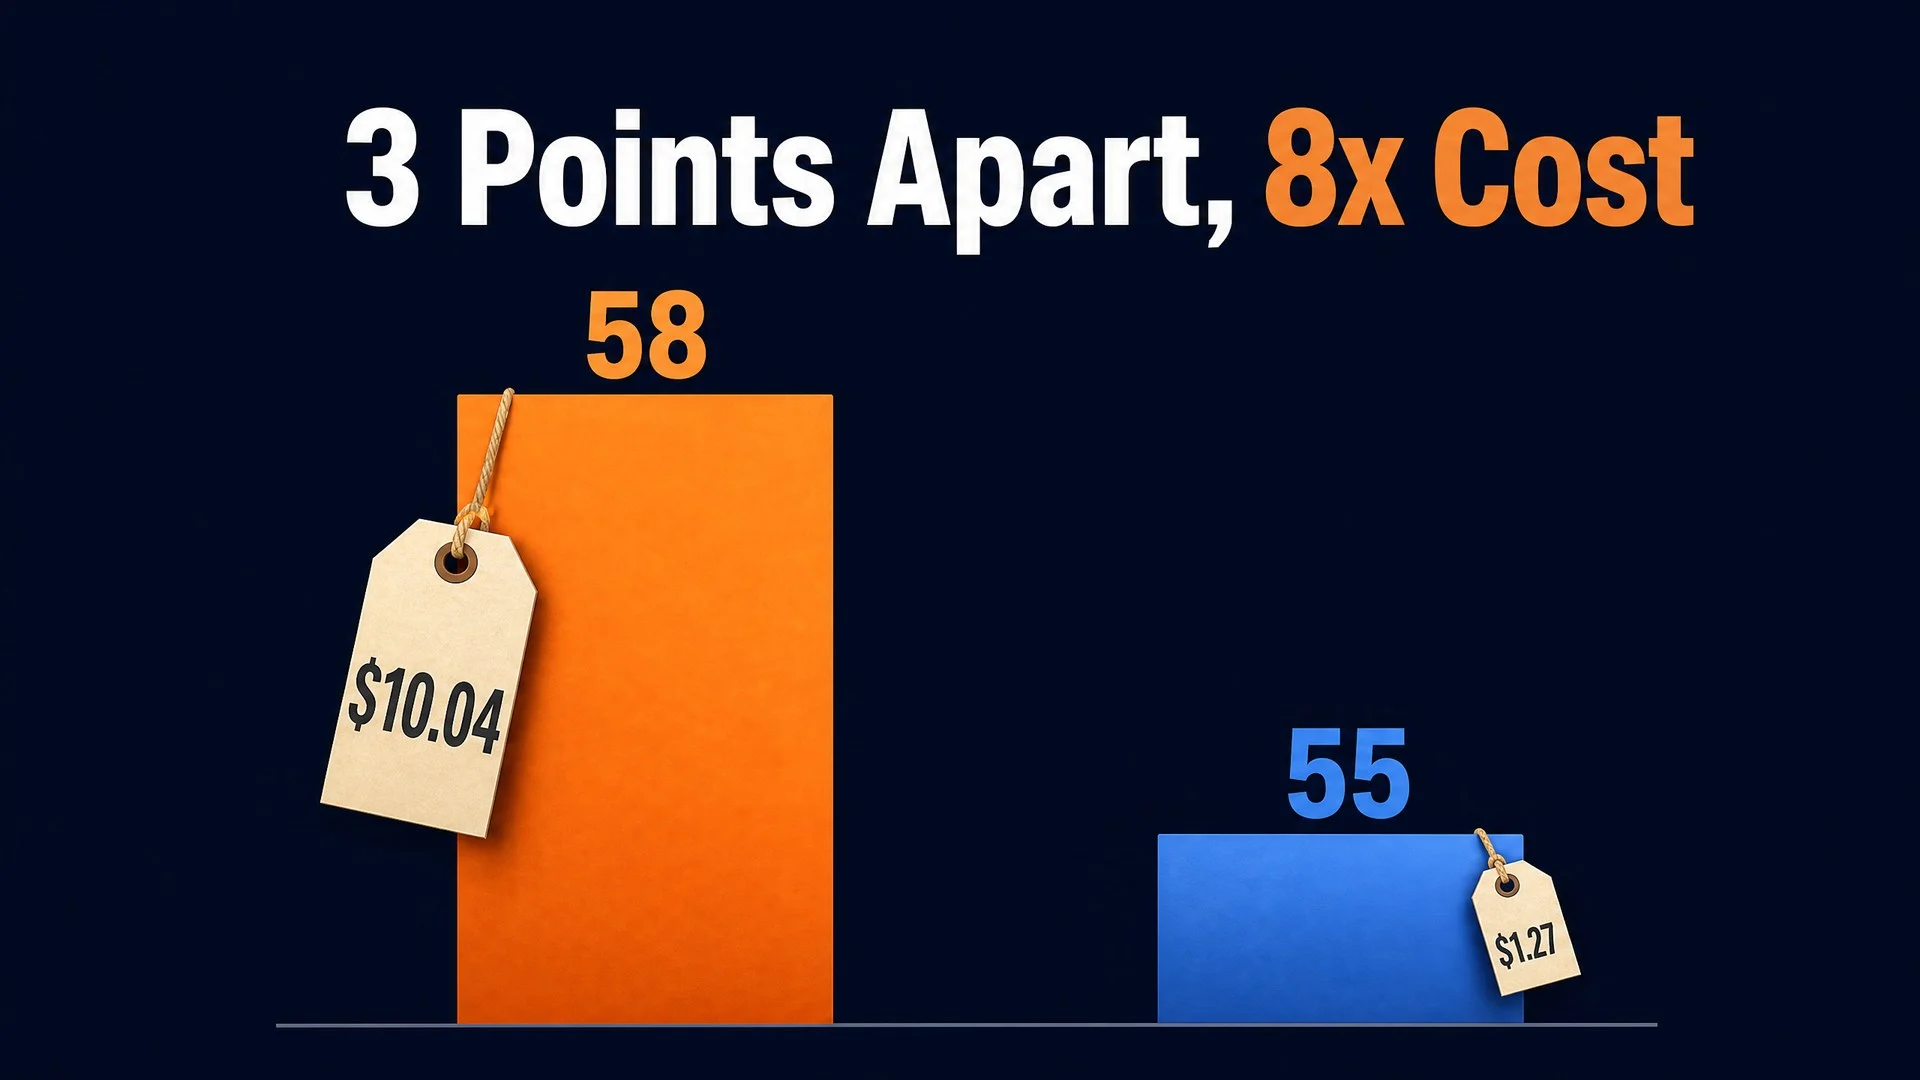
Am 27. Oktober veröffentlichte Artificial Analysis (im Folgenden AA) den Intelligence Index v5 – die größte methodische Überarbeitung seit dem Start von v4 im Januar 2026. Die Top 3 des überarbeiteten Rankings sind: Claude Opus 5.5 (58 Punkte), GPT-6 Astra (57 Punkte), GPT-6.1 Sol (55 Punkte).
Neben den Punkten veröffentlichte AA auch die gemessenen Kosten pro Aufgabe (per-task cost) der einzelnen Modelle: Opus 5.5 kostet in der max-Reasoning-Stufe $10.04 pro Aufgabe, während Sol nur $1.27 kostet. AA formuliert es offiziell so: Sol liegt bei den Punkten innerhalb von 4 Punkten zum Spitzenreiter und kostet pro Aufgabe etwa nur ein Achtel.
Zunächst die Schlussfolgerungen:
- Punkteebene: Opus 5.5 führt mit 58 Punkten, Sol liegt mit 55 Punkten auf Platz drei – nur 3 Punkte Unterschied, also dieselbe Liga
- Kostenebene: In der max-Stufe $10.04 gegenüber $1.27 pro Aufgabe, etwa 8-facher Unterschied, nicht mehr in derselben Größenordnung
- Das Geheimnis der günstigen Kosten: Nicht der Token-Stückpreis ist niedrig, sondern Opus gibt pro Aufgabe etwa dreimal so viele Output-Tokens aus wie Sol; zusammen mit dem etwa 2-fachen Stückpreisunterschied wächst die Rechnung auf das 8-Fache
- Wie wählen: Alltägliche Agent-Aufgaben mit Sol / Terra im Volumen laufen lassen, die schwierigsten Knackaufgaben dann mit Opus in der max-Stufe
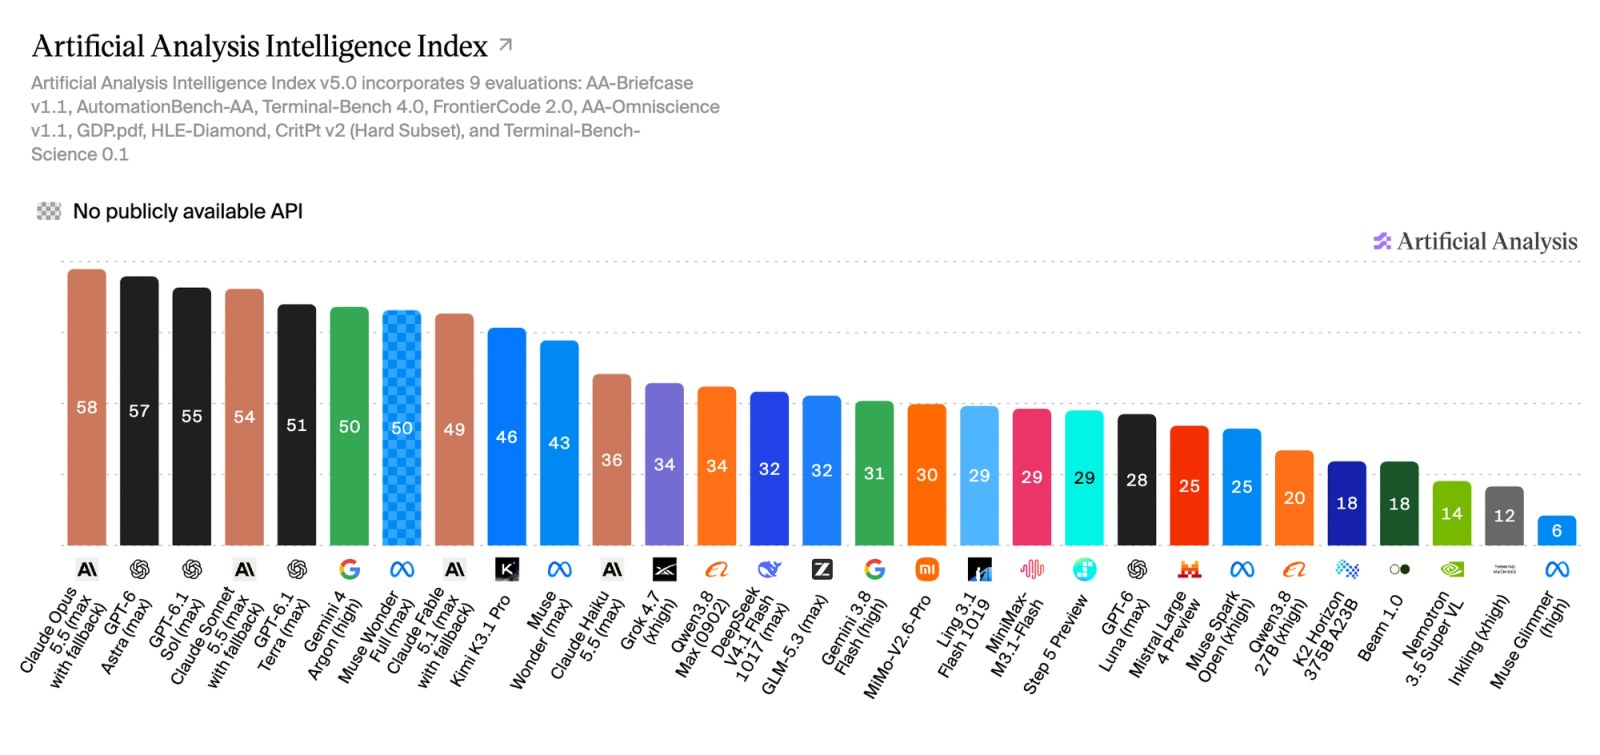
Bildquelle: Offizielle Ankündigung des Artificial Analysis Intelligence Index v5 (2026-10-27)
Hintergrund: Warum v5 als „große Überarbeitung“ gilt
Von den Änderungen in v5 sind zwei für Leser am relevantesten. Erstens sind die Aufgaben schwerer geworden: Der Median-Output aller Evaluationen stieg von 35K Tokens in v4 auf 59K Tokens, davon etwa 90 % aus agentischen mehrstufigen Aufgaben, was realen Arbeitslasten näher kommt. Zweitens Anti-Kontamination: 60 % der Evaluationen wurden durch private Testsets ersetzt, um Ranking-Manipulation zu unterbinden.
Zwei weitere bemerkenswerte Punkte im Ranking: GPT-6 Astra liegt mit 57 Punkten auf Platz zwei; Kimi K3.1 Pro erreicht mit 46 Punkten den ersten Platz unter den offenen Modellen, aber der Abstand zwischen den Top 5 der offenen und geschlossenen Modelle ist von 3 auf 12 Punkte gewachsen.
Ein häufiges Missverständnis gilt es klarzustellen: Opus 5.5 stand im September bereits mit 58 Punkten an der Spitze des AA-Rankings, lief damals aber auf dem alten v4.3-Aufgabenset. Nach der v5-Überarbeitung ist es weiterhin Erster – „nach der Überarbeitung weiterhin Erster“ hat deutlich mehr Aussagekraft als „war einmal Erster“; diese beiden Dinge sollte man nicht vermischen.
Punkte und Rechnung: Alles auf einen Blick in einer Tabelle
Die folgenden Kosten pro Aufgabe sind die gemessenen Zahlen aus der offiziellen v5-Ankündigung von AA (max-Reasoning-Stufe):
| Modell | v5-Punkte (max-Stufe) | Kosten pro Aufgabe (AA-Messung) |
|---|---|---|
| Claude Opus 5.5 | 58 | $10.04 |
| GPT-6 Astra | 57 | $6.24 |
| GPT-6.1 Sol | 55 | $1.27 |
| GPT-6.1 Terra | Nicht in den Top 5 | $0.96 (am günstigsten) |
| Claude Fable 5.1 | Nicht in den Top 5 | $13.04 (am teuersten) |
$10.04 ÷ $1.27 ≈ 7,9-fach, was mit der offiziellen AA-Formulierung „etwa ein Achtel“ übereinstimmt. AA weist zugleich darauf hin, dass der Kostenunterschied pro Aufgabe zwischen den Spitzenmodellen über dem 13-Fachen liegt. Das heißt: Im schmalen Band der „Flaggschiff-Fähigkeiten“ ist die Rechnungsdifferenzierung deutlich heftiger als die Punktedifferenzierung.
Ein Hinweis: Wenn Sie im Internet die Zahlen Sol $0.72, Opus $5.98 sehen, stammen diese aus dem alten v4-Aufgabenset (Median-Output 35K Tokens). Nachdem die v5-Aufgaben schwerer geworden sind, wurde die offizielle Angabe auf $1.27 und $10.04 aktualisiert; beim Zitieren sollte man sich auf die Ankündigung vom 2026-10-27 beziehen.
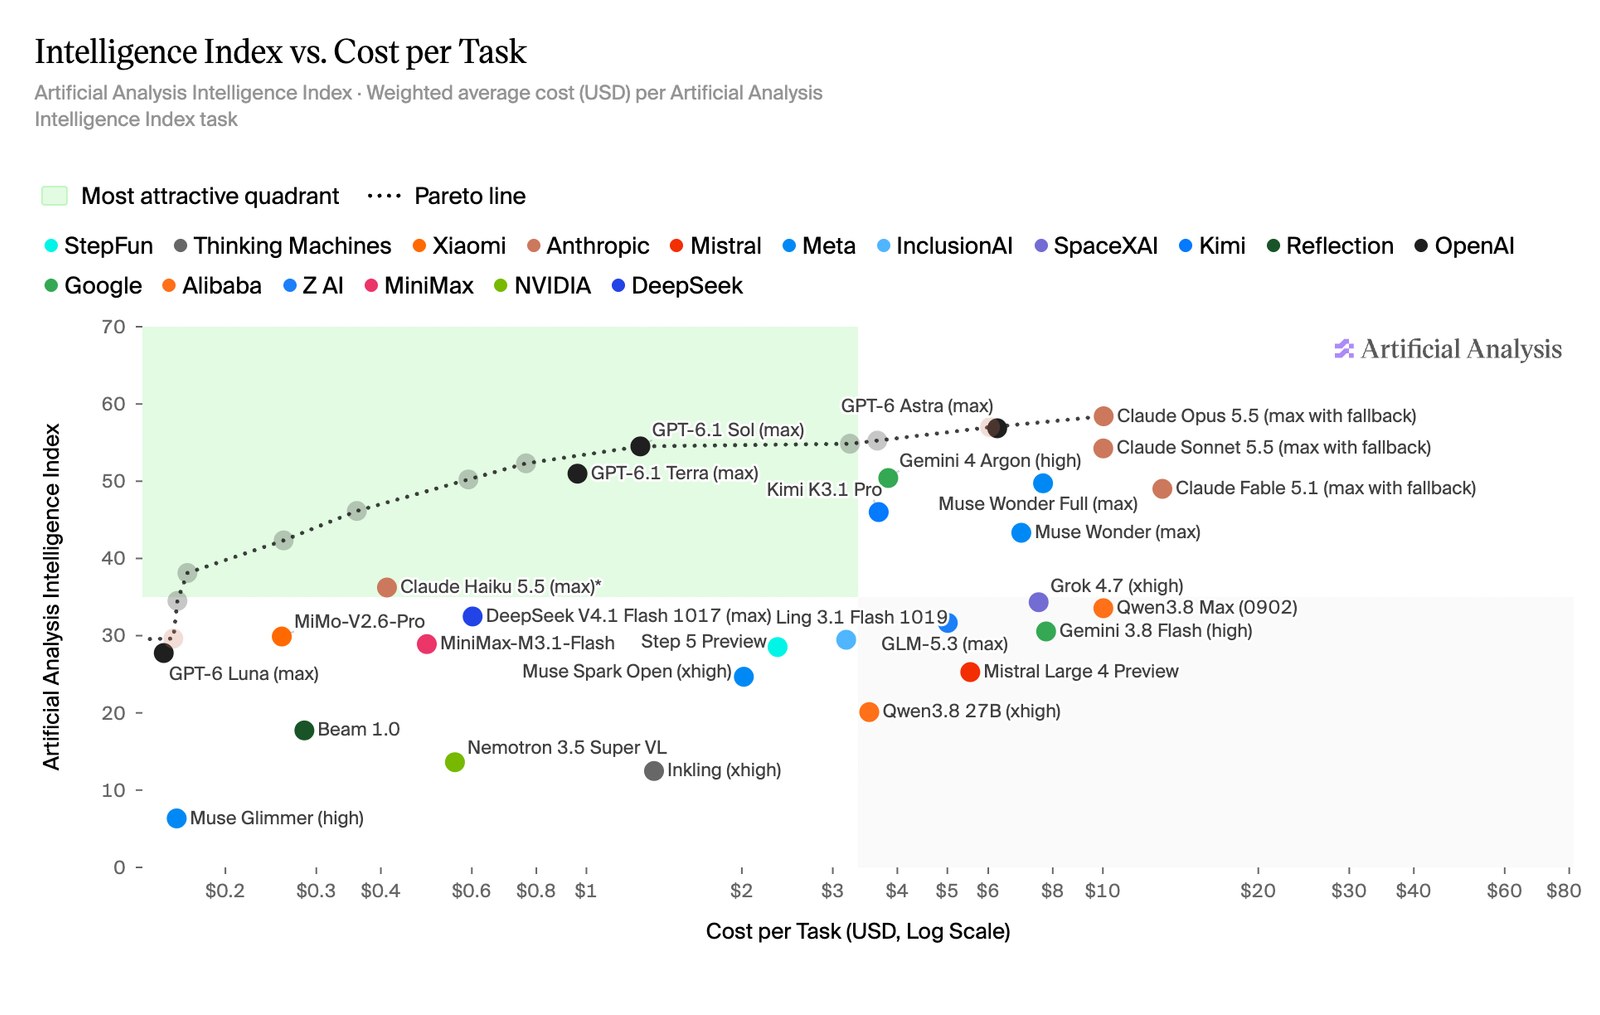
Bildquelle: Offizielle Ankündigung des Artificial Analysis Intelligence Index v5 (2026-10-27)
Warum der Token-Stückpreis die Kosten pro Aufgabe nicht vorhersagen kann
Dies ist der am meisten diskutierte Punkt in der Community nach der Veröffentlichung von v5. Nach den offiziellen Token-Preisen, die AA in der Ankündigung zur Umrechnung verwendet, kostet Opus 5.5 pro Token etwa das 2-Fache von Sol (die Preise auf der HiAPI-Plattform folgen einer anderen Berechnungsgrundlage, siehe unten), aber die Kosten pro Aufgabe unterscheiden sich um das 8-Fache. Die zusätzlichen Vielfachen kommen von der Output-Länge: In Messungen erzeugt Opus pro Aufgabe etwa dreimal so viele Output-Tokens wie Sol. 2-facher Stückpreis mal 3-fache Nutzungsmenge ergibt die 8-fache Rechnung.
Dieser Effekt wird in v5 weiter verstärkt, denn schwerere Aufgaben bedeuten längere Outputs, und Modelle, die „gerne lange Outputs schreiben“, werden teurer. Das erklärt auch, warum die reine Preistabelle systematisch verzerrt: Die Preistabelle sagt Ihnen, „wie viel ein Token kostet“, die Rechnung sagt Ihnen, „wie viel es kostet, diese Sache zu erledigen“. Beides ist wichtig, aber nur eines davon gehört ins Budget.
Wie sich der Index zusammensetzt und warum die effort-Stufen wichtiger werden
Der v5-Index besteht aus 9 Evaluationen, unterteilt in 4 gleich große Kategorien mit je 25 %: Wissensarbeit (25 %), Coding (25 %), Wissenschaft (25 %), Allgemein (25 %). Kein Modell belegt in allen 9 Kategorien den ersten Platz; Opus 5.5 führt in 3 davon (Coding und zwei harte Evaluationen im Allgemein-Bereich), GPT-6 Astra führt in 2. Das bedeutet: „Wer der Erste ist“ hängt bis zu einem gewissen Grad davon ab, in welche Kategorie Ihre Aufgabe fällt: Beim Programmieren und bei harten Wissensfragen sind die Punkte von Opus aussagekräftiger; in Szenarien mit Schwerpunkt Wissensarbeit und Automatisierung wird der Unterschied kleiner sein, als es die Gesamtpunktzahl zeigt.
Eine weitere Änderung in v5 ist, dass der Einfluss der effort-Reasoning-Stufen auf die Punkte deutlich größer geworden ist: Opus 5.5 erreicht in der low-Stufe nur 35 Punkte, in der max-Stufe 58 Punkte; auch bei Sol spannt sich die Stufenspanne auf 20 Punkte. Mit anderen Worten: Die 58 und 55 Punkte im Ranking wurden alle mit „voller Feuerkraft“ erreicht.
Zusammengefasst in einem Satz: Die Punkte werden in der max-Stufe erzielt, die Rechnung wird ebenfalls in der max-Stufe verbrannt. Wenn man das Ranking für die Budgetplanung nutzt, müssen beide Zahlen zusammen mit der Stufe betrachtet werden. Wenn im Alltag nur die low-/medium-Stufen verwendet werden, unterscheidet sich der tatsächliche Abstand zwischen den beiden Modellen vom Ranking.
Praxis: Nach Aufgabenschwierigkeit routen, nicht pauschal entscheiden
Nach den obigen Daten ist die kostensparendste Nutzung nicht „alles auf Sol umstellen“ oder „alles bei Opus belassen“, sondern eine Schichtung nach Aufgabenschwierigkeit:
- Alltägliche Agent-Aufgaben (Skripte, Datenbereinigung, reguläres Coding, Batch-Verarbeitung): Sol oder sogar Terra im Volumen laufen lassen; die Kosten von $0.96 bis $1.27 pro Aufgabe eignen sich für hohe Stückzahlen
- Knackaufgaben (komplexe Refactorings, tiefes Reasoning, Multi-Hop-Analysen): dann Opus in der max-Stufe einsetzen – für 3 Punkte Unterschied 8-fache Kosten zahlen, nur bei Aufgaben, die es wert sind
- Wenn man die Kosten noch eine Stufe drücken will: bei den effort-Stufen ansetzen, die Standardkonfiguration nicht auf der höchsten Stufe festzurren
Eine grobe Rechnung, um den Unterschied zu spüren: Für dieselben 1000 alltäglichen Aufgaben kostet der reine Sol-Lauf etwa $1.270, der reine Opus-max-Lauf etwa $10.040. Die Differenz von $8.770 reicht mehr als aus, um das Monatsbudget eines Teams für Knackaufgaben vollständig abzudecken. Umgekehrt: Wenn man aus Kostengründen alle Aufgaben an Sol drückt, kann der 3-Punkte-Unterschied bei den schwierigsten 5 % der Aufgaben den Unterschied zwischen „geschafft“ und „nicht geschafft“ bedeuten. Genau darin liegt der Sinn des Routings: das teure Modell nur für Aufgaben einzusetzen, die es wirklich brauchen.
Diese Routing-Struktur „ein Aufgabenpool, zwei Modelle“ ist die Domäne von Aggregationsplattformen: Man muss nicht bei zwei Anbietern separate Konten anlegen und zwei Rechnungen verwalten – mit einem Key kann man pro Anfrage wechseln. Wir haben dieselbe Idee des modellbasierten Routings pro Aufgabe bereits im Artikel zur Anbindung von Claude Code und Codex demonstriert; bei Interesse können Sie das vergleichend nachlesen.
Wie man die beiden Modelle auf HiAPI anbindet
Zunächst die Plattformpreise (Stand 2026-10, alle in der Basisstufe ≤272K Kontext):
| Modell | Input | Output | Cache-Lesen |
|---|---|---|---|
| claude-opus-5-5 | $2.02/M | $10.08/M | $0.10/M |
| gpt-6.1-sol | $0.50/M | $2.50/M | $0.025/M |
Achtung auf die Trennung der Berechnungsgrundlagen: Die obige Tabelle zeigt die Token-Stückpreise von HiAPI; die zuvor genannten $10.04 / $1.27 sind die von AA gemessenen Kosten pro Aufgabe. Die beiden Zahlengruppen haben unterschiedliche Quellen und dürfen nicht direkt vermischt werden. Bei den Plattformpreisen liegen Input- und Output-Stückpreis von Sol jeweils bei etwa einem Viertel von Opus – das ist die Preistabellen-Grundlage; umgerechnet auf die Rechnung pro Aufgabe und kombiniert mit dem oben erwähnten Unterschied der Output-Menge ergibt sich erst das 1/8 von AA.
Bei der Anbindung unterstützt Opus 5.5 sowohl das Anthropic Messages- als auch das OpenAI Chat Completions-Protokoll, mit fünf einstellbaren effort-Stufen; Sol unterstützt sowohl das Responses- als auch das Chat Completions-Protokoll, mit 1,05M Kontext. Beide Modelle lassen sich mit demselben API-Key aufrufen; Routing erfolgt pro Anfrage.
- Fähigkeitsgrenzen und vollständige Parameter von Opus 5.5 finden Sie auf der Modell-Detailseite, die von Sol auf der Modell-Detailseite
- Einstiegs-Tutorials: GPT-6.1 Sol API-Anbindungsleitfaden, Claude Opus 5.5 API-Preisanalyse
- Vergleich mit Vorgängergeneration: Opus 5.5 vs. GPT-5.6 Sol
- Artikel aus derselben Reihe: GPT-6.1 Terra Preissenkungs-Kurzmitteilung, Claude Code / Codex Modellwechsel-Leitfaden, Genie 4 Kurzmitteilung
Häufig gestellte Fragen
Wie werden die $1.27 pro Aufgabe für Sol berechnet?
Dies ist die gemessene Grundlage aus der offiziellen v5-Ankündigung von AA: Eine Reihe von Aufgaben wird in der max-Reasoning-Stufe ausgeführt und anhand der tatsächlich verbrauchten Input-/Output-Tokens und der offiziellen Preise umgerechnet. Es ist kein Listenpreis, sondern eine Rechnung – daher näher an dem, was Sie tatsächlich zahlen würden, als die Preistabelle.
Im Internet stehen Sol $0.72, Opus $5.98 pro Aufgabe – welche Zahlen stimmen?
$0.72 / $5.98 sind die Zahlen aus dem alten v4-Aufgabenset, als der Median-Output der Aufgaben nur 35K Tokens betrug. Nachdem die v5-Aufgaben schwerer geworden sind (Median 59K Tokens), wurden sie offiziell auf $1.27 / $10.04 aktualisiert. Maßgeblich ist die v5-Ankündigung vom 2026-10-27.
Um wie viel unterscheiden sich die Token-Stückpreise von Sol und Opus 5.5 wirklich?
Nach den HiAPI-Plattformpreisen (Stand 2026-10, Basisstufe ≤272K): Sol Input $0.50/M, Output $2.50/M; Opus Input $2.02/M, Output $10.08/M – der Stückpreis ist etwa 4-fach. Das ist jedoch die Preistabellen-Grundlage; die Kosten-pro-Aufgabe-Grundlage von AA liegt bei etwa 8-fach, wobei die Differenz aus der etwa 3-fachen Output-Menge von Opus pro Aufgabe stammt. Beide Grundlagen gelten, aber nicht vermischt rechnen.
Was sind effort-Stufen? Warum unterscheiden sich die Punkte so stark?
effort ist die Einsatzstufe beim Reasoning des Modells; je höher, desto tiefer das Nachdenken und desto länger der Output. Unter v5 reicht Opus 5.5 von 35 Punkten in der low-Stufe bis 58 Punkten in der max-Stufe, eine Spanne von 23 Punkten; auch bei Sol beträgt die Stufenspanne 20 Punkte. Ob „Sol Opus ersetzen kann“, hängt also davon ab, welche Stufe Sie im Alltag verwenden, und davon, wie viel Sie für schwierige Aufgaben zahlen wollen.
Soll ich für meine Aufgaben Sol oder Opus 5.5 verwenden?
Alltägliche Agent-Aufgaben (Skripte, Bereinigung, reguläres Coding) zunächst mit Sol laufen lassen – hohes Volumen bei kontrollierbaren Kosten; bei unsicheren Knackaufgaben eine Runde mit Opus in der max-Stufe vergleichen. Bei HiAPI lassen sich beide Modelle mit einem Key aufrufen; das Routing-Wechseln verursacht keine zusätzlichen Anbindungskosten.
Wichtigste Erkenntnisse
Das v5-Ranking legt zwei Dinge gleichzeitig auf den Tisch: Bei den Fähigkeiten liegen Opus 5.5, Astra und Sol innerhalb von 3 Punkten – keiner übertrumpft den anderen; bei den Kosten unterscheiden sich die Rechnungen pro Aufgabe um das 8-Fache, viel heftiger als die Punktedifferenzierung. Die Punkte werden in der max-Stufe erzielt, die Rechnung wird ebenfalls in der max-Stufe verbrannt; beide Zahlen müssen zusammen mit der Stufe betrachtet werden. Für die meisten Teams ist die richtige Haltung nicht, Partei zu ergreifen, sondern nach Aufgabenschwierigkeit zu routen: Sol / Terra im Volumen, Opus in der max-Stufe für Knackaufgaben. Wer dieses Routing auf HiAPI umsetzen will, kann beide Modelle jetzt starten.
Ähnliche Artikel
Alle Artikel ansehen →-

Vergleichstest
Wan 2.6 Flash vs. Wan 2.7: Lohnt sich das Upgrade?
720P-Budget und 1080P-Ergebnisse mit Fuchs und Auto; Audio-Bedingungen und tatsächliche Stufen pro Gruppe angegeben.
-

Vergleichstest
Vidu Q4 Preview vs. Kling 3.0: Welches Modell für Bild-zu-Video?
Für standardmäßig mit Ton, 16 Sekunden und 5 Auflösungsstufen wähle Vidu Q4 Preview; für Anfangs- und Endframe-Fixierung wähle Kling 3.0. Inklusive zweier Vergleichspaare mit gleichem Prompt: Wasserflugzeug und Barista.
-

Vergleichstest
Replicate-Alternative: hiapi vs. Replicate im Vergleich für Bild- und Videogenerierung (2026)
Was sich beim Wechsel von Replicate zu hiapi bei Prediction-Aufrufen, Webhooks und Abrechnung ändert, mit einer 10-Schritte-Migrationscheckliste.