
Avaliação comparativa
Opus 5.5 vs GPT-6.1 Sol: diferença de 3 pontos na pontuação, custo 8 vezes maior
No novo ranking do AA Intelligence Index v5, o primeiro colocado custa US$ 10,04 por tarefa e o terceiro, US$ 1,27. Pontuações próximas, contas 8 vezes maiores: como escolher depende da tarefa
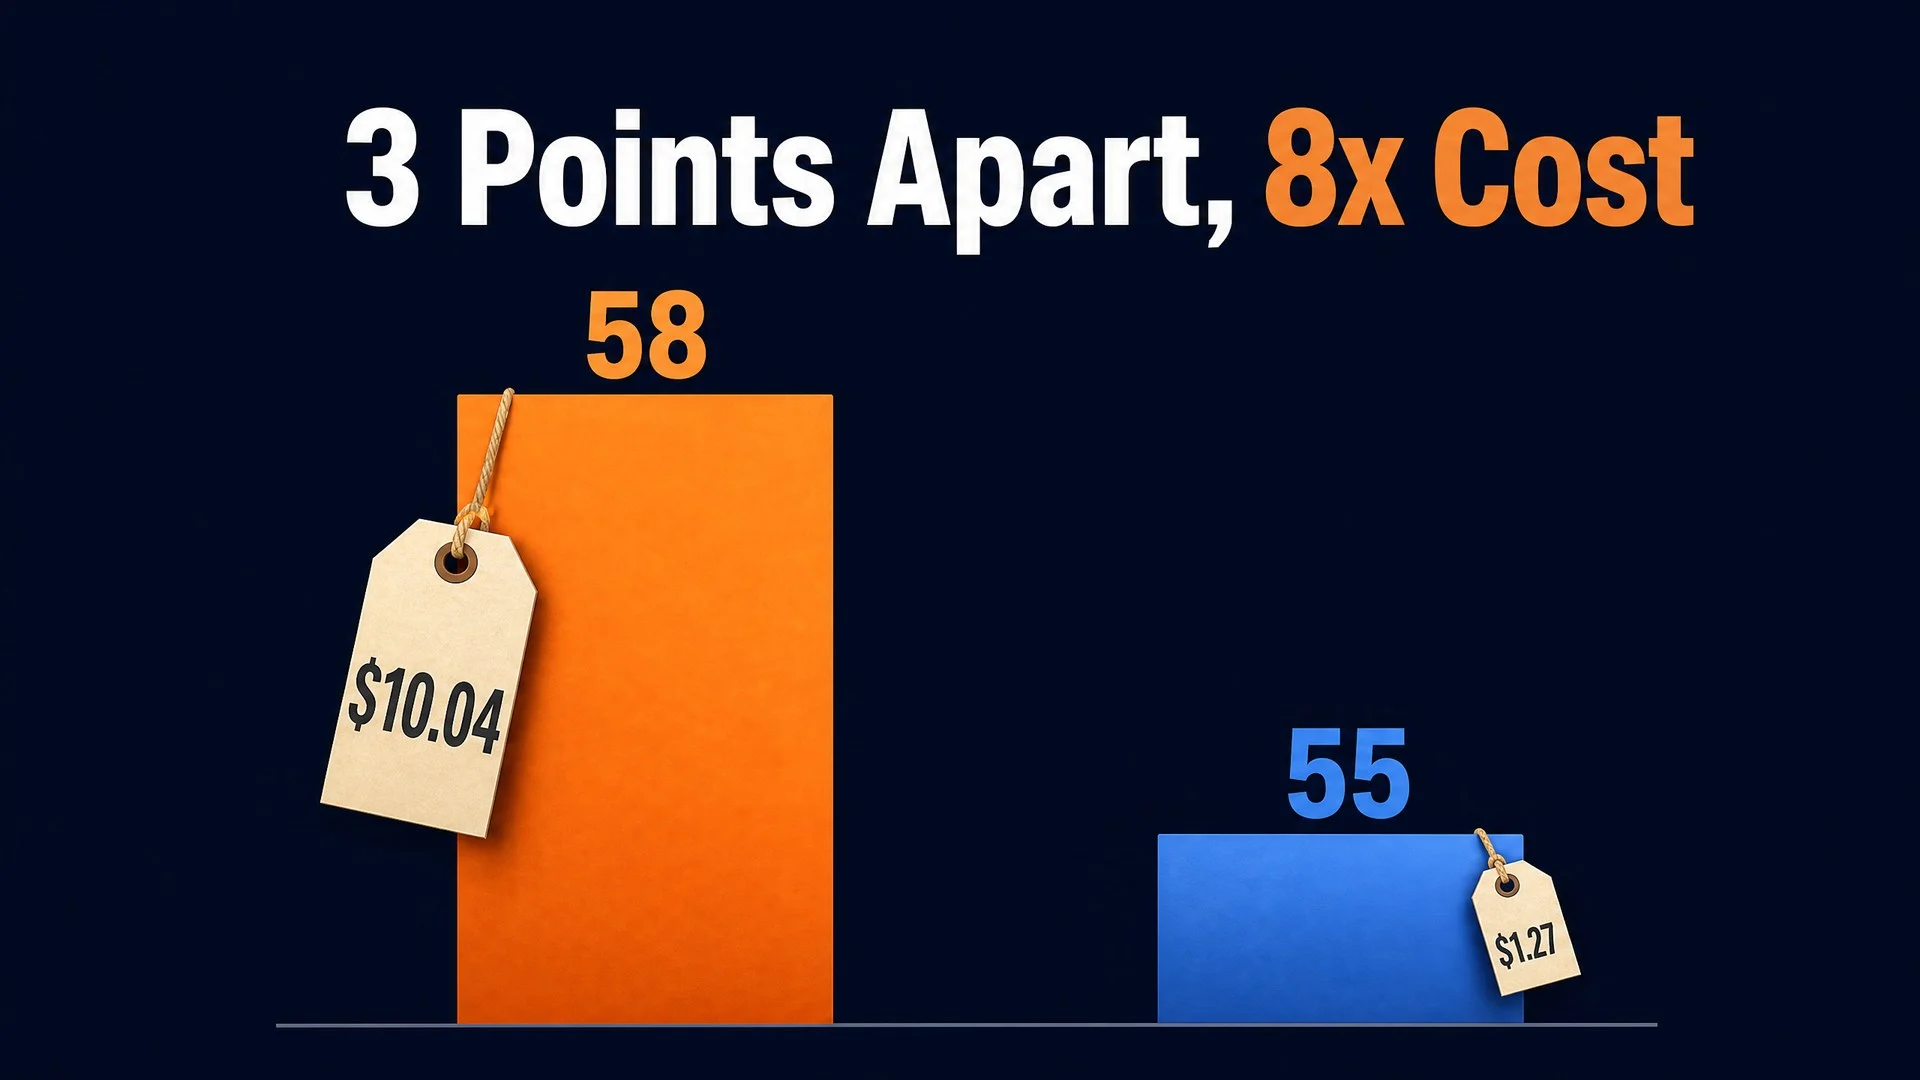
Em 27 de outubro, a Artificial Analysis (doravante AA) publicou o Intelligence Index v5, a maior revisão metodológica desde o lançamento do v4 em janeiro de 2026. Os três primeiros colocados do ranking revisado são: Claude Opus 5.5 (58 pontos), GPT-6 Astra (57 pontos) e GPT-6.1 Sol (55 pontos).
Além da pontuação, a AA também divulgou o custo por tarefa (per-task cost) medido de cada modelo: o Opus 5.5, no nível de raciocínio max, custa US$ 10,04 por tarefa, enquanto o Sol custa apenas US$ 1,27. A formulação oficial da AA é: a diferença de pontuação entre o Sol e o líder é de menos de 4 pontos, e o custo por tarefa é de aproximadamente um oitavo.
Primeiro, as conclusões:
- No nível de pontuação: o Opus 5.5 lidera com 58 pontos, o Sol fica em terceiro com 55 pontos, apenas 3 pontos de diferença, ambos na mesma faixa
- No nível de custo: no nível max, US$ 10,04 contra US$ 1,27 por tarefa, uma diferença de cerca de 8 vezes, já não estão na mesma ordem de grandeza
- O segredo do barato: não é o preço unitário por token baixo, mas o fato de o Opus gerar cerca de 3 vezes mais tokens de saída por tarefa que o Sol; somado a uma diferença de preço unitário de cerca de 2 vezes, a conta é ampliada para 8 vezes
- Como escolher: use Sol / Terra para volume em tarefas cotidianas de agente e reserve o nível max do Opus para as tarefas mais desafiadoras
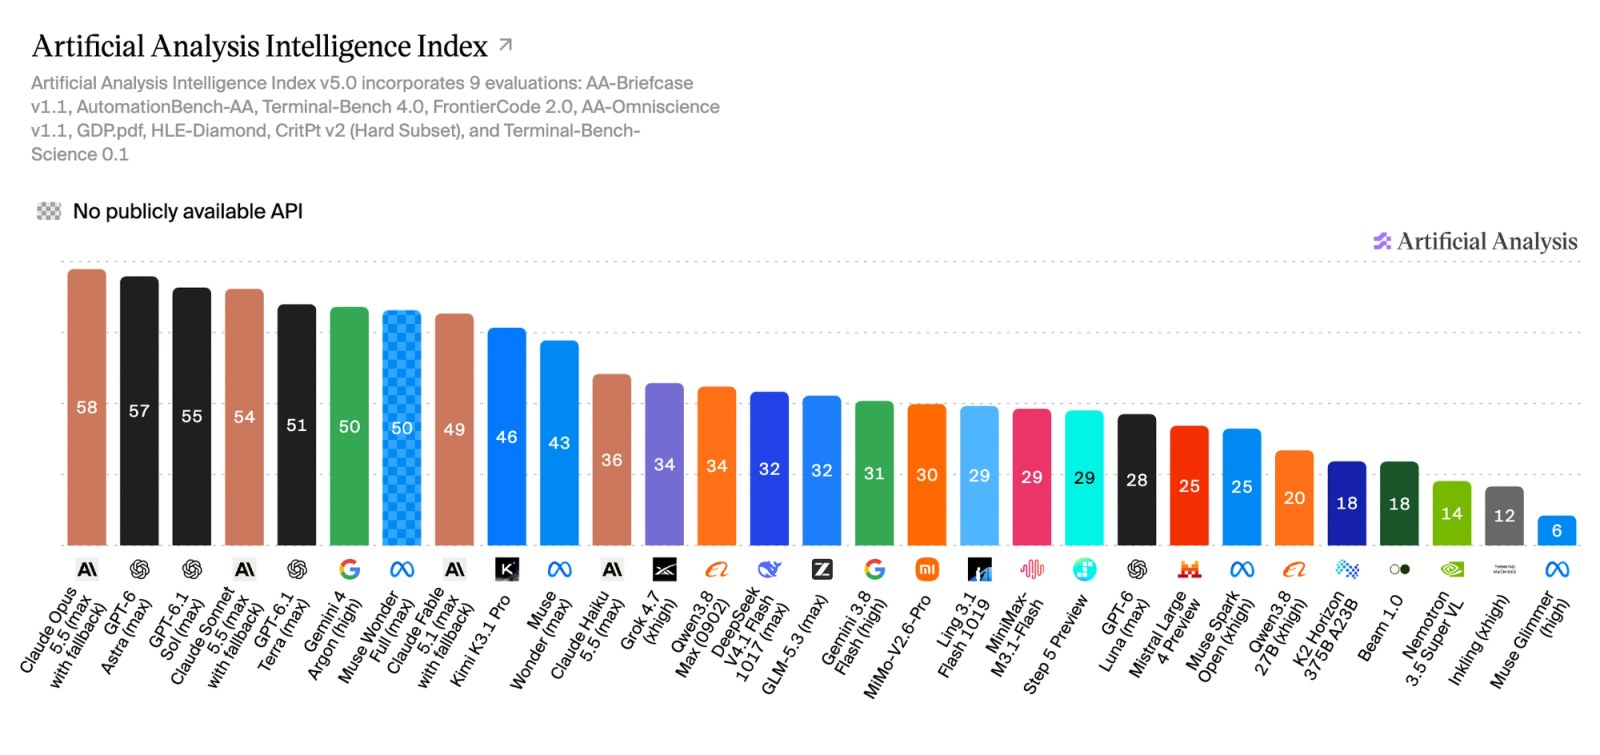
Fonte da imagem: anúncio oficial do Artificial Analysis Intelligence Index v5 (2026-10-27)
Contexto: por que o v5 é considerado uma "grande revisão"
Das mudanças do v5, duas são as mais relevantes para os leitores. A primeira é que as tarefas ficaram mais pesadas: a saída mediana de todas as avaliações subiu de 35K tokens no v4 para 59K tokens, sendo cerca de 90% proveniente de tarefas agênticas de múltiplas etapas, mais próximas de cargas de trabalho reais. A segunda é a prevenção de contaminação: 60% das avaliações foram trocadas por conjuntos de teste privados, fechando o espaço para manipulação de rankings.
Há ainda dois pontos dignos de nota no ranking: o GPT-6 Astra fica em segundo com 57 pontos; o Kimi K3.1 Pro alcança o primeiro lugar entre modelos abertos com 46 pontos, mas a diferença entre os cinco primeiros abertos e fechados aumentou de 3 para 12 pontos.
É preciso esclarecer uma interpretação equivocada comum: o Opus 5.5 já havia alcançado o topo do ranking da AA em setembro com 58 pontos, mas na época rodava o conjunto de tarefas antigo v4.3. Após a revisão do v5, ele continua em primeiro lugar; "manter o primeiro lugar após a revisão" tem muito mais valor do que "já foi primeiro", e as duas coisas não devem ser confundidas.
Pontuação e conta: tudo em uma tabela
Os custos por tarefa abaixo são os números medidos do anúncio oficial v5 da AA (nível de raciocínio max):
| Modelo | Pontuação v5 (nível max) | Custo por tarefa (medido pela AA) |
|---|---|---|
| Claude Opus 5.5 | 58 | US$ 10,04 |
| GPT-6 Astra | 57 | US$ 6,24 |
| GPT-6.1 Sol | 55 | US$ 1,27 |
| GPT-6.1 Terra | Fora do top 5 | US$ 0,96 (mais barato) |
| Claude Fable 5.1 | Fora do top 5 | US$ 13,04 (mais caro) |
US$ 10,04 ÷ US$ 1,27 ≈ 7,9 vezes, consistente com a formulação oficial da AA de "aproximadamente um oitavo". A AA também observa que a diferença de custo por tarefa entre os modelos de ponta ultrapassa 13 vezes. Ou seja, na faixa estreita de "capacidade de ponta", a variação das contas é muito mais acentuada que a das pontuações.
Um alerta: se você encontrar na internet os números de Sol US$ 0,72 e Opus US$ 5,98, esses são resquícios do conjunto de tarefas antigo v4 (saída mediana de 35K tokens); após o v5 tornar as tarefas mais pesadas, os números oficiais foram atualizados para US$ 1,27 e US$ 10,04. Ao citar, use o anúncio de 2026-10-27.
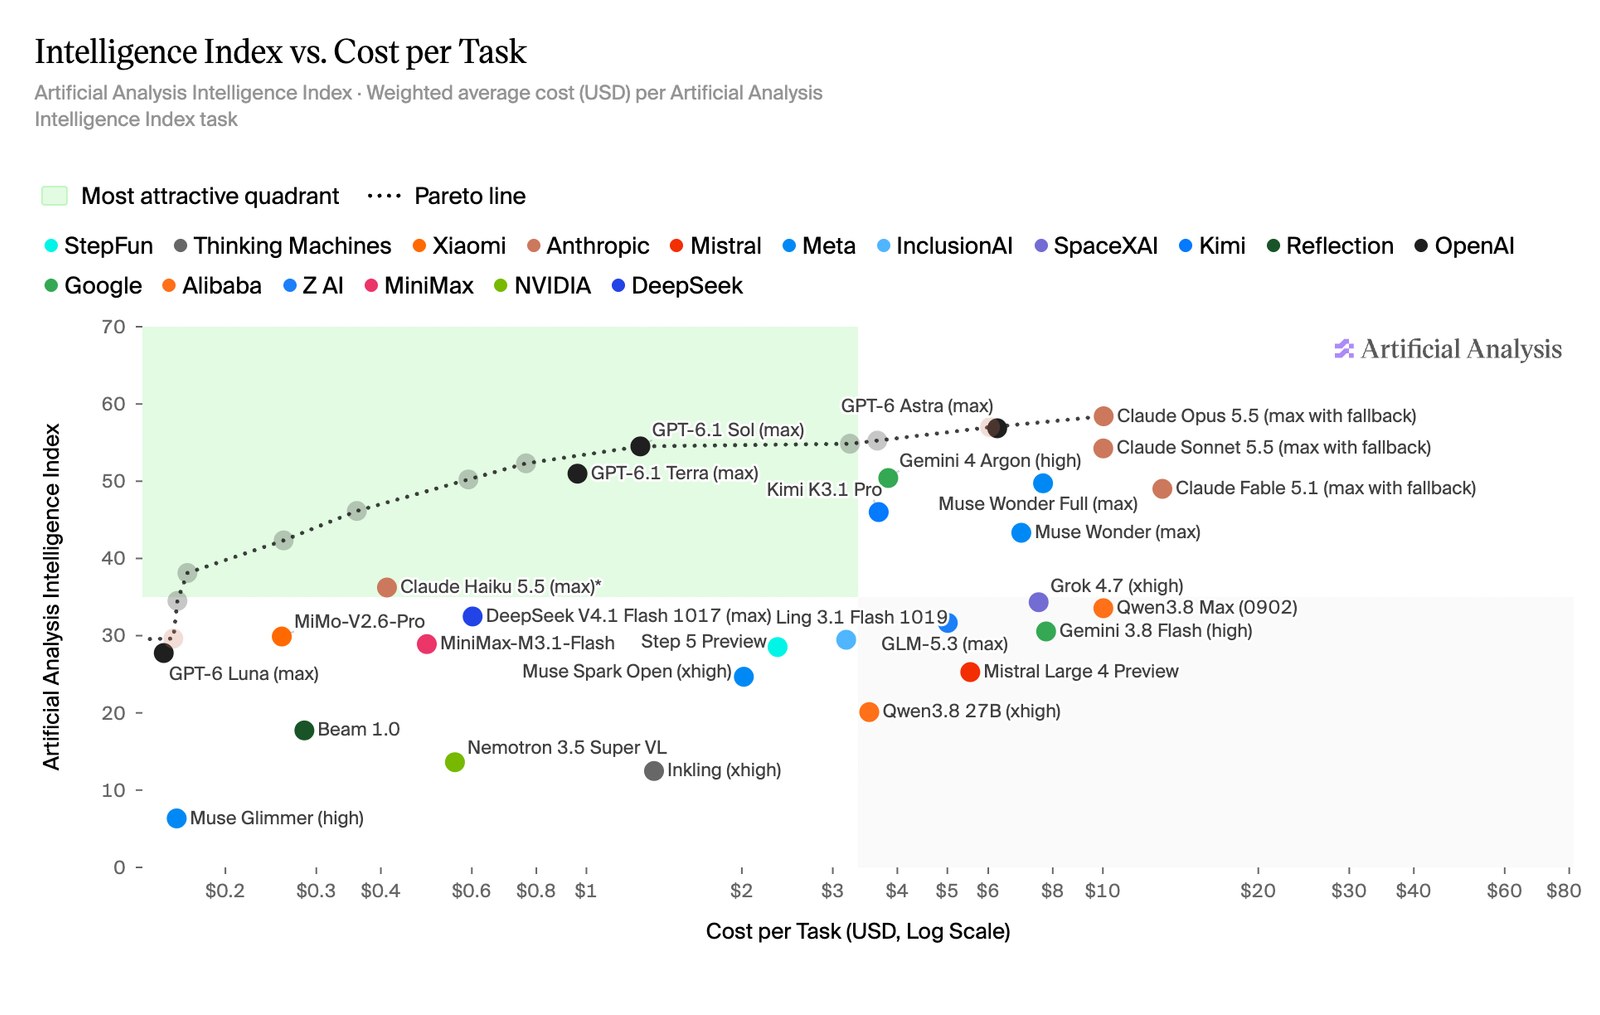
Fonte da imagem: anúncio oficial do Artificial Analysis Intelligence Index v5 (2026-10-27)
Por que o preço unitário por token não prevê o custo por tarefa
Este é o ponto mais discutido pela comunidade após o lançamento do v5. Segundo o preço oficial por token usado pela AA para conversão, o Opus 5.5 custa cerca de 2 vezes mais por token que o Sol (o preço na plataforma HiAPI tem outra base, veja abaixo), mas o custo por tarefa é 8 vezes maior. O fator extra vem do comprimento da saída: nas medições, o Opus gera cerca de 3 vezes mais tokens de saída por tarefa que o Sol. Preço unitário 2 vezes maior multiplicado por 3 vezes mais uso resulta em uma conta 8 vezes maior.
Isso foi amplificado ainda mais no v5, porque tarefas mais pesadas significam saídas mais longas, e modelos que "gostam de escrever muito" ficam mais caros. Isso também explica por que olhar apenas a tabela de preços distorce sistematicamente: a tabela de preços diz "quanto custa cada token", enquanto a conta diz "quanto custa concluir esta tarefa". Ambos importam, mas apenas um entra no orçamento.
Como o índice é composto e por que os níveis de effort ficaram mais importantes
O índice v5 é composto por 9 avaliações, divididas em 4 grandes categorias iguais, cada uma com 25%: trabalho de conhecimento (25%), codificação (25%), ciência (25%) e geral (25%). Nenhum modelo lidera todas as 9, o Opus 5.5 lidera 3 delas (codificação e duas avaliações exigentes na categoria geral), e o GPT-6 Astra lidera 2. Isso significa que "quem é o primeiro" depende, em certa medida, de em qual grande categoria sua tarefa se enquadra: para escrever código e resolver problemas difíceis de conhecimento, a pontuação do Opus tem mais valor de referência; em cenários mais voltados a trabalho de conhecimento e automação, a diferença será menor do que a pontuação total indica.
Outra mudança do v5 é que o impacto dos níveis de raciocínio effort na pontuação aumentou claramente: o Opus 5.5 tem apenas 35 pontos no nível low e chega a 58 no nível max; a amplitude de níveis do Sol também chegou a 20 pontos. Em outras palavras, os 58 e 55 pontos do ranking foram obtidos com "potência máxima".
Em resumo: a pontuação é obtida no nível max, e a conta também é queimada no nível max. Ao olhar o ranking para fazer orçamento, os dois números devem ser vistos junto com o nível. Se as tarefas cotidianas usarem apenas os níveis low / medium, a diferença real entre os dois modelos será diferente da do ranking.
Prática: roteie por dificuldade da tarefa, sem usar uma regra única
Com base nos dados acima, a forma mais econômica de usar não é "trocar tudo por Sol" nem "manter tudo com Opus", mas estratificar por dificuldade da tarefa:
- Tarefas cotidianas de agente (scripts, limpeza de dados, codificação de rotina, processamento em lote): use Sol ou até Terra para volume; o custo por tarefa de US$ 0,96 a US$ 1,27 é adequado para escala
- Tarefas desafiadoras (refatorações complexas, raciocínio profundo, análises de múltiplos saltos): use o nível max do Opus; pagar 8 vezes o custo por 3 pontos de diferença só vale em tarefas que justifiquem
- Para reduzir mais um nível de custo: mexa nos níveis de effort, não deixe a configuração padrão travada no nível mais alto
Uma conta rápida para sentir a diferença: para executar 1000 tarefas cotidianas, usar apenas Sol custa cerca de US$ 1.270, enquanto usar apenas o Opus no nível max custa cerca de US$ 10.040; a diferença de US$ 8.770 é suficiente para cobrir com folga toda a cota mensal de tarefas desafiadoras da equipe. Por outro lado, se para economizar você empurrar todas as tarefas para o Sol, a diferença de 3 pontos nas 5% tarefas mais difíceis pode ser a diferença entre "conseguir fazer" e "não conseguir fazer". O sentido do roteamento está aí: gastar o modelo caro apenas nas tarefas que realmente precisam dele.
Essa estrutura de roteamento de "um pool de tarefas, dois modelos" é exatamente o ponto forte das plataformas agregadoras: sem precisar registrar contas separadas em duas empresas nem lidar com duas faturas, uma única Key permite alternar por requisição. Demonstramos essa mesma ideia de alternar modelos por tarefa no artigo de integração do Claude Code e do Codex; se tiver interesse, vale comparar.
Como integrar os dois modelos na HiAPI
Primeiro, os preços da plataforma (até 2026-10, todos no nível básico de contexto ≤272K):
| Modelo | Entrada | Saída | Leitura de cache |
|---|---|---|---|
| claude-opus-5-5 | US$ 2,02/M | US$ 10,08/M | US$ 0,10/M |
| gpt-6.1-sol | US$ 0,50/M | US$ 2,50/M | US$ 0,025/M |
Atenção à separação de bases: a tabela acima é o preço unitário por token da HiAPI; os US$ 10,04 / US$ 1,27 citados antes são o custo por tarefa medido pela AA; os dois conjuntos de números têm origens diferentes e não podem ser misturados diretamente. No preço da plataforma, a entrada e a saída do Sol custam cerca de um quarto das do Opus, essa é a base da tabela de preços; convertido para a conta por tarefa, somado à diferença de volume de saída mencionada acima, chega-se ao 1/8 da AA.
Na integração, o Opus 5.5 suporta os protocolos Anthropic Messages e OpenAI Chat Completions, com cinco níveis de effort ajustáveis; o Sol suporta os protocolos Responses e Chat Completions, com contexto de 1,05M. Ambos os modelos podem ser chamados com a mesma API Key, bastando rotear por requisição.
- Os limites de capacidade e os parâmetros completos do Opus 5.5 estão na página de detalhes do modelo, e os do Sol na página de detalhes do modelo
- Tutoriais: Guia de integração da API do GPT-6.1 Sol, Análise de preços da API do Claude Opus 5.5
- Referência de comparação com a geração anterior: Opus 5.5 vs GPT-5.6 Sol
- Artigos da mesma leva: Notícia rápida sobre o corte de preço do GPT-6.1 Terra, Guia para alternar modelos no Claude Code / Codex, Notícia rápida do Genie 4
Perguntas frequentes
Como é calculado o US$ 1,27 por tarefa do Sol?
É a base de medição do anúncio oficial v5 da AA: executar um lote de tarefas no nível de raciocínio max e converter com base nos tokens de entrada e saída realmente consumidos e nos preços oficiais. Não é preço de tabela, é conta; por isso está mais próximo do que você realmente pagará do que olhar a tabela de preços.
Na internet aparecem Sol US$ 0,72 e Opus US$ 5,98 por tarefa; qual está correto?
US$ 0,72 / US$ 5,98 são números do conjunto de tarefas antigo v4, quando a saída mediana das tarefas era de apenas 35K tokens. Após o v5 tornar as tarefas mais pesadas (mediana de 59K tokens), os números oficiais foram atualizados para US$ 1,27 / US$ 10,04. Use o anúncio v5 de 2026-10-27.
Qual é exatamente a diferença de preço unitário por token entre Sol e Opus 5.5?
Segundo o preço da plataforma HiAPI (até 2026-10, nível básico ≤272K), o Sol custa US$ 0,50/M na entrada e US$ 2,50/M na saída, e o Opus US$ 2,02/M na entrada e US$ 10,08/M na saída, uma diferença de preço unitário de cerca de 4 vezes. Mas essa é a base da tabela de preços; a base de custo por tarefa da AA é de cerca de 8 vezes, e a diferença vem do volume de saída cerca de 3 vezes maior do Opus por tarefa. As duas bases são válidas, não as misture nos cálculos.
O que é o nível de effort? Por que a diferença de pontuação é tão grande?
Effort é o nível de esforço investido no raciocínio do modelo; quanto maior, mais profundo o pensamento e mais longa a saída. No v5, o Opus 5.5 vai de 35 pontos no nível low a 58 no nível max, uma amplitude de 23 pontos; a amplitude de níveis do Sol também é de 20 pontos. Portanto, "se o Sol pode substituir o Opus" depende do nível que você usa no dia a dia e de quanto você está disposto a pagar por tarefas de alta dificuldade.
Devo usar Sol ou Opus 5.5 na minha tarefa?
Para tarefas cotidianas de agente (scripts, limpeza, codificação de rotina), comece com o Sol; o volume é grande e o custo é controlável. Para tarefas desafiadoras em que você não tem certeza, faça uma rodada comparativa com o Opus no nível max. Na HiAPI, uma única Key permite chamar os dois modelos, sem custo extra de integração para alternar o roteamento.
Conclusões principais
O ranking v5 coloca duas coisas sobre a mesa ao mesmo tempo: em capacidade, Opus 5.5, Astra e Sol estão dentro de 3 pontos, sem que ninguém domine completamente; em custo, a conta por tarefa difere 8 vezes, uma variação muito mais acentuada que a das pontuações. A pontuação é obtida no nível max, e a conta também é queimada no nível max; os dois números devem ser vistos junto com o nível. Para a maioria das equipes, a postura correta não é escolher um lado, mas rotear por dificuldade da tarefa: Sol / Terra para volume, Opus no nível max para desafios. Para implementar esse roteamento na HiAPI, os dois modelos já podem ser executados agora.
Artigos relacionados
Ver todos os artigos →-

Avaliação comparativa
Wan 2.6 Flash vs Wan 2.7: vale a pena atualizar?
Orçamento em 720P e resultados em 1080P da raposa e do carro; condições de áudio e faixas reais indicadas conjunto por conjunto.
-

Avaliação comparativa
Vidu Q4 Preview vs Kling 3.0: como escolher para vídeo a partir de imagem?
Com som padrão, 16 segundos e 5 níveis de resolução, escolha o Vidu Q4 Preview; para travar a imagem com primeiro e último frame, escolha o Kling 3.0. Inclui duas comparações com o mesmo prompt: hidroavião e barista.
-

Avaliação comparativa
Alternativa ao Replicate: comparação entre hiapi e Replicate para geração de imagem e vídeo (2026)
O que precisa mudar nas chamadas de previsão, nos webhooks e na cobrança ao migrar do Replicate para o hiapi, com uma lista de migração em 10 passos.