
Comparatif et évaluation
Opus 5.5 vs GPT-6.1 Sol : 3 points d'écart au score, un coût 8 fois supérieur
Sur le nouveau classement AA Intelligence Index v5, la première place coûte 10,04 $ par tâche, la troisième 1,27 $. Des scores proches, une facture 8 fois supérieure : le choix dépend de vos tâches
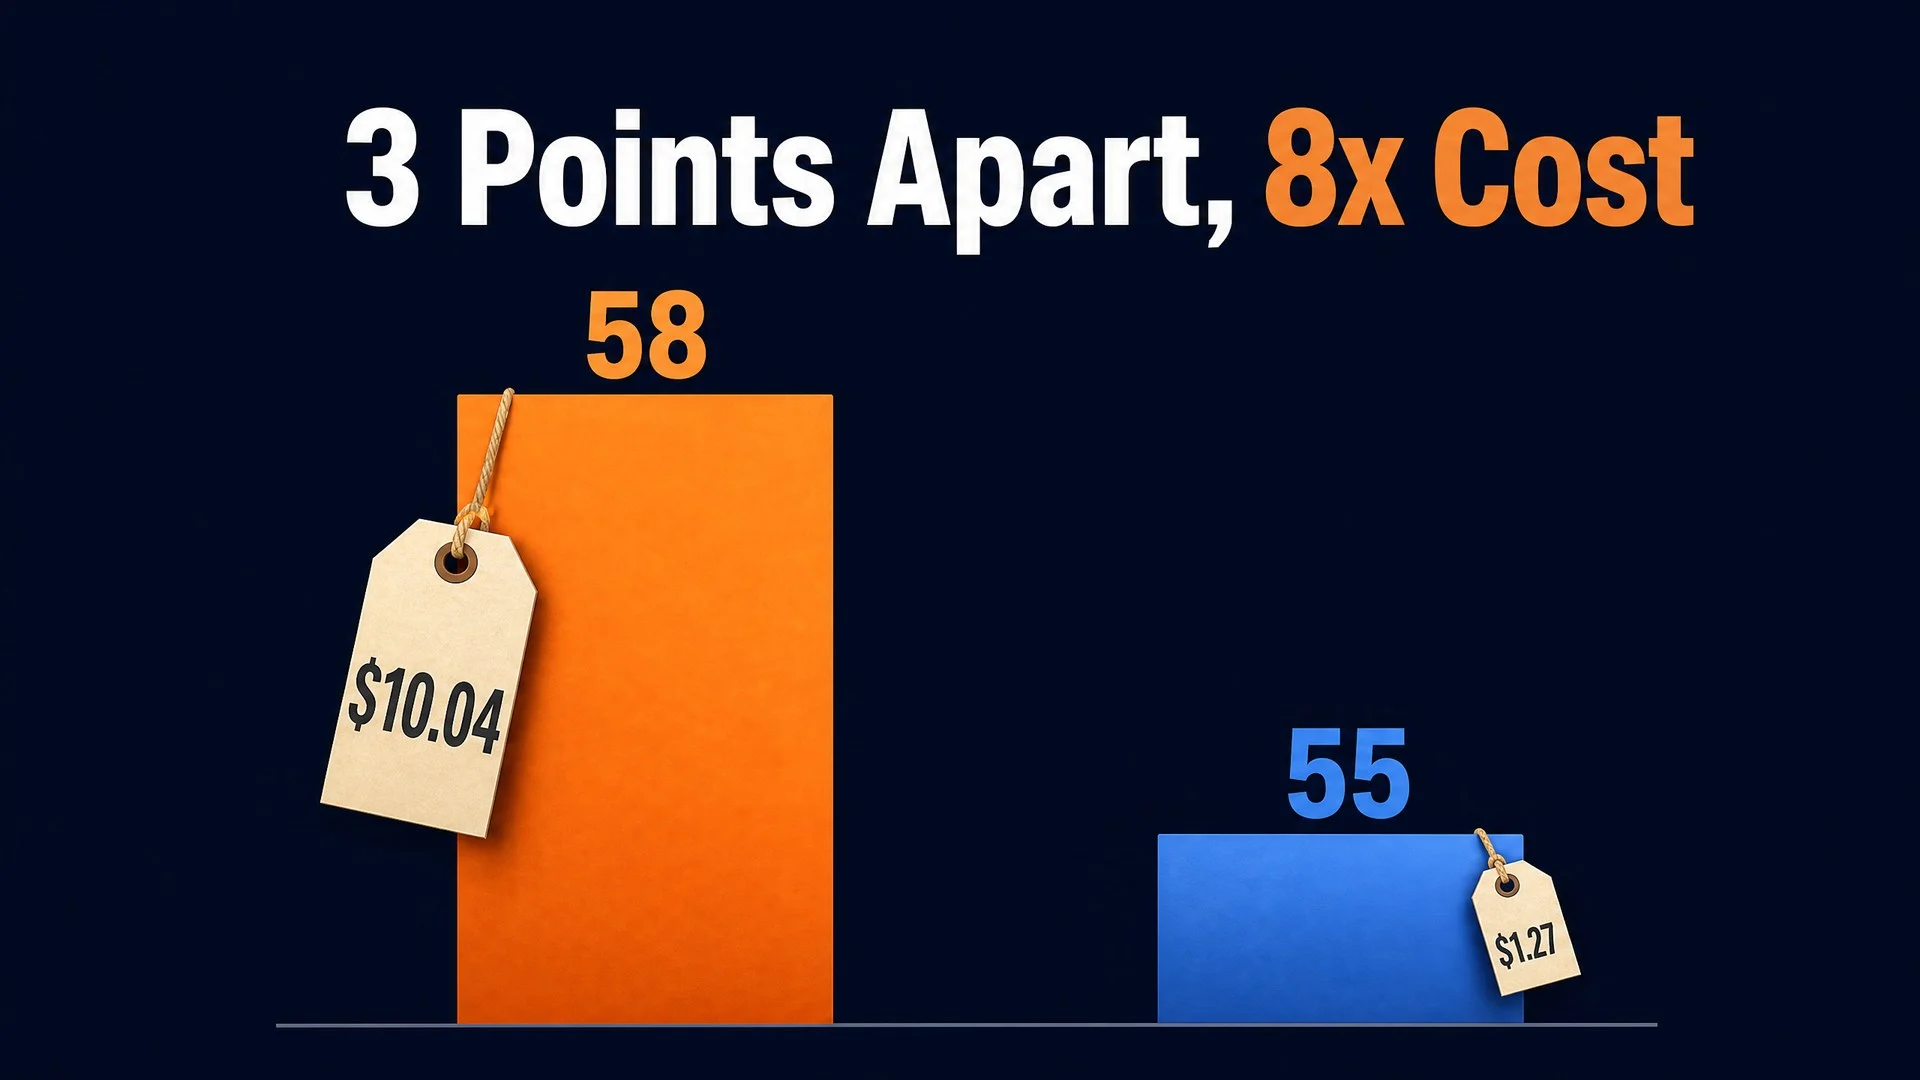
Le 27 octobre, Artificial Analysis (ci-après AA) a publié l'Intelligence Index v5, la plus grande refonte méthodologique depuis le lancement de la v4 en janvier 2026. Le nouveau top 3 du classement est le suivant : Claude Opus 5.5 (58 points), GPT-6 Astra (57 points), GPT-6.1 Sol (55 points).
Au-delà des scores, AA a également publié le coût par tâche mesuré de chaque modèle (per-task cost) : Opus 5.5 coûte 10,04 $ par tâche en niveau de raisonnement max, contre seulement 1,27 $ pour Sol. La formulation officielle d'AA est la suivante : Sol se situe à moins de 4 points du sommet du classement, pour un coût par tâche d'environ un huitième.
Commençons par les conclusions :
- Sur le plan du score : Opus 5.5 est en tête avec 58 points, Sol troisième avec 55 points, soit seulement 3 points d'écart, ils sont dans la même catégorie
- Sur le plan du coût : en mode max, 10,04 $ contre 1,27 $ par tâche, un écart d'environ 8 fois, ils ne sont plus dans le même ordre de grandeur
- Le secret du prix bas : ce n'est pas le tarif unitaire des tokens qui est bas, mais Opus génère environ 3 fois plus de tokens de sortie par tâche que Sol, ce qui, combiné à un écart de prix unitaire d'environ 2x, amplifie la facture jusqu'à 8x
- Comment choisir : utiliser Sol / Terra en volume pour les tâches d'agent quotidiennes, et réserver le niveau max d'Opus aux tâches les plus exigeantes
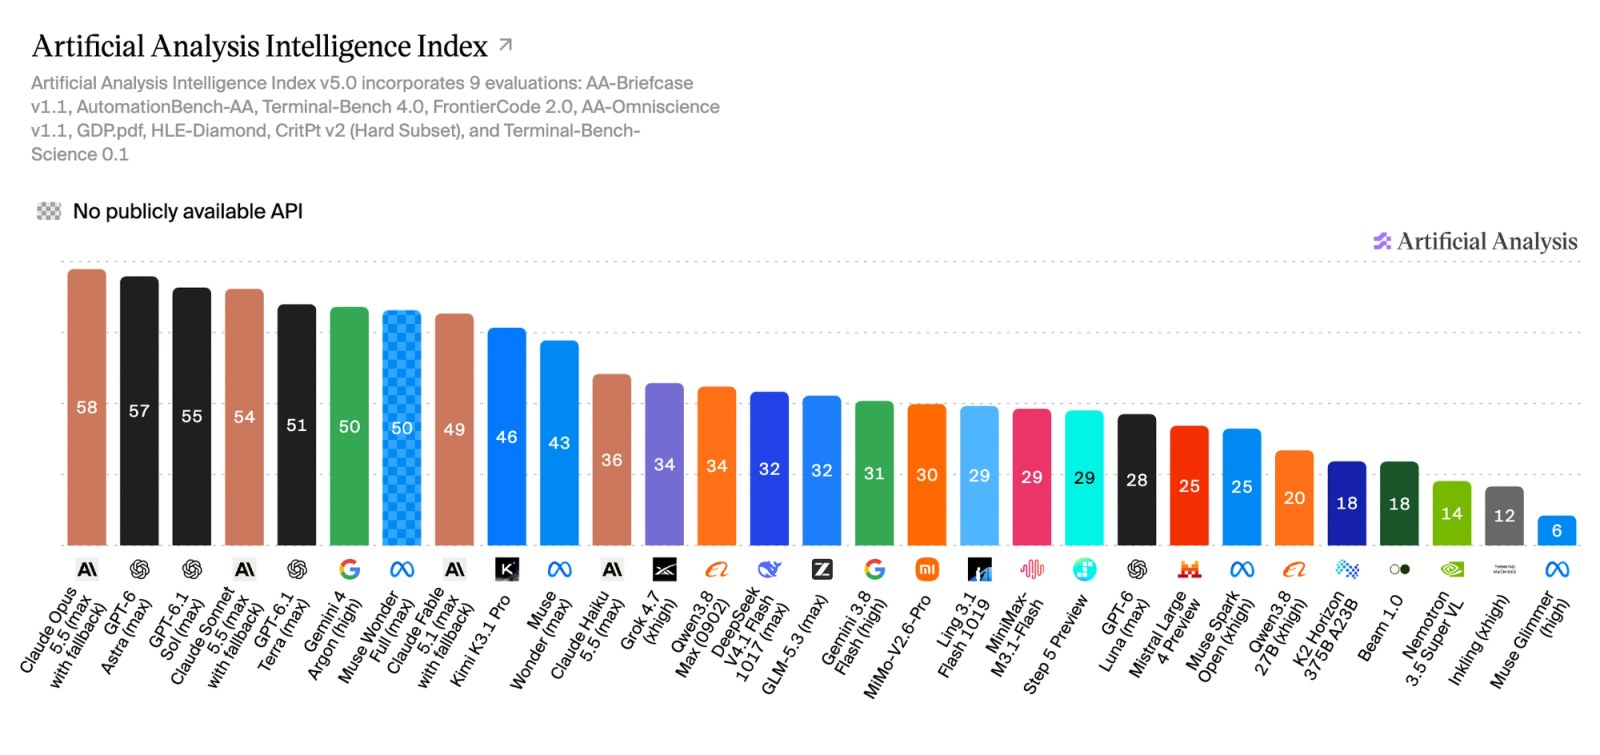
Source de l'image : annonce officielle Artificial Analysis Intelligence Index v5 (2026-10-27)
Contexte : pourquoi la v5 est considérée comme une « grande refonte »
Parmi les changements de la v5, deux sont les plus pertinents pour les lecteurs. Premièrement, les tâches sont plus lourdes : la sortie médiane de toutes les évaluations passe de 35K tokens en v4 à 59K tokens, dont environ 90 % proviennent de tâches agentiques multi-étapes, plus proches des charges de travail réelles. Deuxièmement, la lutte contre la contamination : 60 % des évaluations ont été remplacées par des jeux de tests privés, fermant l'espace aux manipulations de classement.
Deux autres points méritent l'attention dans le classement : GPT-6 Astra se cale à la deuxième place avec 57 points ; Kimi K3.1 Pro obtient la première place des modèles ouverts avec 46 points, mais l'écart entre le top 5 ouvert et le top 5 fermé passe de 3 à 12 points.
Il faut clarifier une mauvaise interprétation courante : Opus 5.5 avait déjà atteint la première place du classement AA avec 58 points en septembre, mais il tournait alors sur l'ancien jeu de tâches v4.3. Après la refonte v5, il reste premier ; « reste premier après la refonte » a bien plus de valeur que « a été premier », il ne faut pas confondre les deux.
Score et facture : tout voir en un tableau
Les coûts par tâche ci-dessous sont les chiffres mesurés de l'annonce officielle v5 d'AA (niveau de raisonnement max) :
| Modèle | Score v5 (mode max) | Coût par tâche (mesuré par AA) |
|---|---|---|
| Claude Opus 5.5 | 58 | 10,04 $ |
| GPT-6 Astra | 57 | 6,24 $ |
| GPT-6.1 Sol | 55 | 1,27 $ |
| GPT-6.1 Terra | Pas dans le top 5 | 0,96 $ (le moins cher) |
| Claude Fable 5.1 | Pas dans le top 5 | 13,04 $ (le plus cher) |
10,04 $ ÷ 1,27 $ ≈ 7,9 fois, ce qui correspond à la formulation officielle d'AA « environ un huitième ». AA souligne également que l'écart de coût par tâche entre les modèles de tête dépasse 13 fois. Autrement dit, dans cette bande étroite de « capacités phares », la divergence des factures est bien plus violente que celle des scores.
Un avertissement : si vous voyez sur internet les chiffres Sol 0,72 $ et Opus 5,98 $, ce sont des restes de l'ancien jeu de tâches v4 (sortie médiane 35K tokens) ; après l'alourdissement des tâches de la v5, la référence officielle a été mise à jour à 1,27 $ et 10,04 $, référez-vous à l'annonce du 2026-10-27.
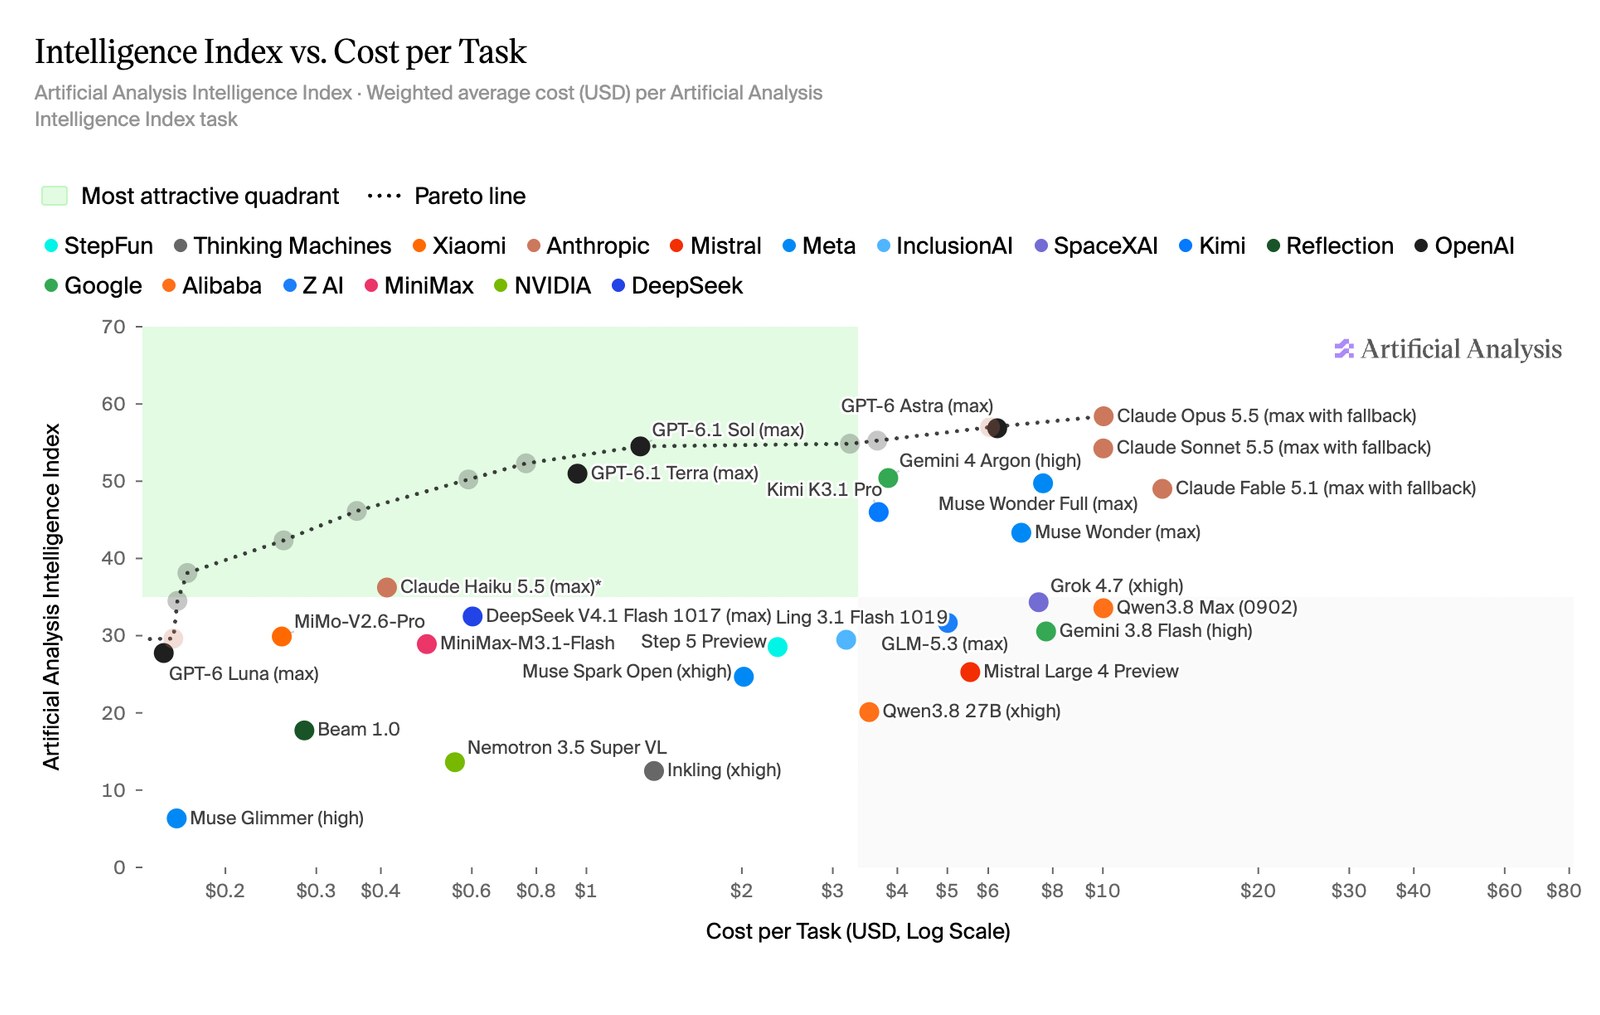
Source de l'image : annonce officielle Artificial Analysis Intelligence Index v5 (2026-10-27)
Pourquoi le tarif unitaire des tokens ne permet pas de prédire le coût par tâche
C'est le point le plus discuté par la communauté après la publication de la v5. Selon les tarifs officiels des tokens utilisés pour la conversion dans l'annonce d'AA, Opus 5.5 coûte environ 2 fois plus cher par token que Sol (les tarifs de la plateforme HiAPI sont différents, voir ci-dessous), mais le coût par tâche diffère de 8 fois. Le facteur supplémentaire vient de la longueur de sortie : dans les mesures, Opus génère environ 3 fois plus de tokens de sortie par tâche que Sol. 2x le prix unitaire multiplié par 3x le volume d'usage, cela donne une facture de 8x.
Ce phénomène est encore amplifié dans la v5, car des tâches plus lourdes signifient des sorties plus longues, et les modèles « bavards » coûtent plus cher. Cela explique aussi pourquoi se fier uniquement à la grille tarifaire fausse systématiquement la perception : la grille tarifaire vous dit « combien coûte chaque token », la facture vous dit « combien coûte la réalisation de cette tâche ». Les deux sont importants, mais un seul entre dans le budget.
Comment l'indice est composé, et pourquoi le niveau d'effort devient important
L'indice v5 est composé de 9 évaluations, réparties en 4 grandes catégories égales, chacune à 25 % : travail de connaissance (25 %), codage (25 %), science (25 %), général (25 %). Aucun modèle ne rafle les 9 premières places, Opus 5.5 en tête sur 3 d'entre elles (codage et deux évaluations exigeantes de la catégorie général), GPT-6 Astra en tête sur 2. Cela signifie que « qui est premier » dépend dans une certaine mesure de la catégorie dans laquelle tombe votre tâche : pour écrire du code et résoudre des problèmes de connaissance difficiles, le score d'Opus est plus pertinent ; dans les scénarios orientés travail de connaissance et automatisation, l'écart sera plus faible que ne le montre le score total.
Un autre changement de la v5 est que l'impact du niveau de raisonnement effort sur le score augmente nettement : Opus 5.5 n'obtient que 35 points en niveau low, contre 58 en max ; l'amplitude des niveaux de Sol atteint également 20 points. Autrement dit, les 58 et 55 points du classement sont obtenus « à pleine puissance ».
En une phrase : les scores sont obtenus en mode max, et les factures sont aussi brûlées en mode max. Pour établir un budget à partir du classement, il faut lire les deux chiffres avec le niveau d'effort. Si les tâches quotidiennes n'utilisent que les niveaux low / medium, l'écart réel entre les deux modèles différera du classement.
En pratique : router selon la difficulté des tâches, sans tout uniformiser
D'après les données ci-dessus, l'usage le plus économique n'est pas de « tout passer à Sol » ou de « tout garder sur Opus », mais de stratifier selon la difficulté des tâches :
- Tâches d'agent quotidiennes (scripts, nettoyage de données, codage courant, traitement par lots) : Sol voire Terra en volume, un coût par tâche de 0,96 $ à 1,27 $ adapté à la montée en charge
- Tâches exigeantes (refactorisation complexe, raisonnement profond, analyse multi-sauts) : passer au niveau max d'Opus, payer 8x le coût pour 3 points d'écart, uniquement sur les tâches qui le méritent
- Pour réduire encore d'un cran le coût : jouer sur le niveau d'effort, ne pas verrouiller la configuration par défaut au niveau le plus élevé
Un calcul rapide pour ressentir l'écart : pour 1000 tâches quotidiennes identiques, tout en Sol coûte environ 1 270 $, tout en Opus max coûte environ 10 040 $ ; les 8 770 $ d'écart suffisent à couvrir tout le quota mensuel de tâches exigeantes d'une équipe, avec du rab. À l'inverse, si pour économiser on presse toutes les tâches sur Sol, les 3 points d'écart sur les 5 % de tâches les plus difficiles peuvent faire la différence entre « réalisé » et « non réalisé ». C'est tout le sens du routage : faire en sorte que le modèle cher ne soit utilisé que sur les tâches qui en ont vraiment besoin.
Cette structure de routage « un pool de tâches, deux modèles » est justement le terrain de jeu des plateformes d'agrégation : pas besoin de créer séparément deux comptes chez deux fournisseurs ni de gérer deux factures, une seule clé permet de basculer à la requête. Nous avons démontré cette même logique de commutation de modèle par tâche dans l'article sur l'intégration de Claude Code et Codex, à consulter en parallèle si cela vous intéresse.
Comment brancher les deux modèles sur HiAPI
D'abord les tarifs de la plateforme (à jour d'octobre 2026, tous en palier de base ≤272K de contexte) :
| Modèle | Entrée | Sortie | Lecture de cache |
|---|---|---|---|
| claude-opus-5-5 | 2,02 $/M | 10,08 $/M | 0,10 $/M |
| gpt-6.1-sol | 0,50 $/M | 2,50 $/M | 0,025 $/M |
Attention à ne pas mélanger les référentiels : le tableau ci-dessus donne les tarifs unitaires des tokens de HiAPI, tandis que les 10,04 $ / 1,27 $ plus haut sont les coûts par tâche mesurés par AA ; les deux séries de chiffres ont des sources différentes et ne peuvent pas être combinées directement. Aux tarifs de la plateforme, les prix d'entrée et de sortie de Sol sont environ le quart de ceux d'Opus, c'est le référentiel de la grille tarifaire ; converti en facture par tâche, en y ajoutant la différence de volume de sortie évoquée plus haut, on obtient bien le 1/8 d'AA.
Pour l'intégration, Opus 5.5 prend en charge les protocoles doubles Anthropic Messages et OpenAI Chat Completions, avec cinq niveaux d'effort ajustables ; Sol prend en charge les protocoles doubles Responses et Chat Completions, avec un contexte de 1,05M. Les deux modèles peuvent être appelés avec la même clé API, il suffit de router à la requête.
- Pour les limites de capacités et les paramètres complets d'Opus 5.5, voir la page de détails du modèle, pour Sol voir la page de détails du modèle
- Tutoriels de prise en main : Guide d'intégration de l'API GPT-6.1 Sol, Analyse tarifaire de l'API Claude Opus 5.5
- Comparaison avec la génération précédente : Opus 5.5 vs GPT-5.6 Sol
- Articles de la même série : Baisse de prix de GPT-6.1 Terra, Guide de commutation de modèle Claude Code / Codex, Actualité Genie 4
Questions fréquentes
Comment est calculé le 1,27 $ par tâche de Sol ?
C'est le référentiel mesuré de l'annonce officielle v5 d'AA : exécuter un lot de tâches en niveau de raisonnement max, puis convertir selon les tokens d'entrée et de sortie réellement consommés et les prix officiels. Ce n'est pas un prix affiché, c'est une facture, donc plus proche de ce que vous paierez réellement que la grille tarifaire.
On lit sur internet Sol 0,72 $ et Opus 5,98 $ par tâche, lequel est correct ?
0,72 $ / 5,98 $ sont les chiffres de l'ancien jeu de tâches v4, où la sortie médiane des tâches n'était que de 35K tokens. Après l'alourdissement des tâches de la v5 (médiane 59K tokens), les chiffres officiels ont été mis à jour à 1,27 $ / 10,04 $. Référez-vous à l'annonce v5 du 2026-10-27.
Quel est l'écart de tarif unitaire des tokens entre Sol et Opus 5.5 ?
Aux tarifs de la plateforme HiAPI (à jour d'octobre 2026, palier de base ≤272K), Sol est à 0,50 $/M en entrée et 2,50 $/M en sortie, Opus à 2,02 $/M en entrée et 10,08 $/M en sortie, soit environ 4 fois le prix unitaire. Mais c'est le référentiel de la grille tarifaire ; le référentiel du coût par tâche d'AA est d'environ 8 fois, la différence venant du volume de sortie environ 3 fois supérieur d'Opus par tâche. Les deux référentiels sont valides, ne les mélangez pas dans un calcul.
Qu'est-ce que le niveau d'effort ? Pourquoi les scores diffèrent-ils autant ?
L'effort est le niveau d'investissement du modèle lors du raisonnement, plus il est élevé, plus la réflexion est profonde et la sortie longue. Dans la v5, Opus 5.5 passe de 35 points en niveau low à 58 points en max, soit une amplitude de 23 points ; l'amplitude des niveaux de Sol atteint aussi 20 points. Donc « Sol peut-il remplacer Opus » dépend du niveau que vous utilisez au quotidien, et de combien vous êtes prêt à payer pour les tâches difficiles.
Dois-je utiliser Sol ou Opus 5.5 pour mes tâches ?
Pour les tâches d'agent quotidiennes (scripts, nettoyage, codage courant), commencez par Sol, le volume et le coût sont maîtrisés ; pour les tâches exigeantes où vous hésitez, faites un tour de comparaison en niveau max d'Opus. Avec une clé HiAPI, les deux modèles sont appelables, la commutation de routage n'entraîne aucun coût d'intégration supplémentaire.
Conclusions clés
Le classement v5 met deux choses sur la table en même temps : sur le plan des capacités, Opus 5.5, Astra et Sol se tiennent à moins de 3 points, aucun n'écrase l'autre ; sur le plan du coût, la facture par tâche diffère de 8 fois, bien plus violente que la divergence des scores. Les scores sont obtenus en mode max, et les factures sont aussi brûlées en mode max, il faut lire les deux chiffres avec le niveau d'effort. Pour la plupart des équipes, la bonne posture n'est pas de choisir son camp, mais de router selon la difficulté des tâches : Sol / Terra en volume, Opus max pour les tâches exigeantes. Pour mettre en place ce routage sur HiAPI, les deux modèles peuvent être lancés dès maintenant.
Articles similaires
Voir tous les articles →-

Comparatif et évaluation
Wan 2.6 Flash vs Wan 2.7 : faut-il passer à la version supérieure ?
Budget 720P et rendus 1080P du renard et de la voiture ; conditions audio et palier réel indiqués groupe par groupe.
-

Comparatif et évaluation
Vidu Q4 Preview vs Kling 3.0 : quel modèle image-vers-vidéo choisir ?
Audio par défaut, 16 secondes et 5 paliers de résolution : choisissez Vidu Q4 Preview ; verrouillage des images par frames de début et de fin : choisissez Kling 3.0. Avec deux comparaisons à prompt identique, sur un hydravion et une barista.
-

Comparatif et évaluation
Alternative à Replicate : comparatif hiapi vs Replicate pour la génération d'images et de vidéos (2026)
Ce qui doit changer dans les appels de prédiction, les webhooks et la facturation lors d'une migration de Replicate vers hiapi, avec une liste de migration en 10 étapes.