
比較レビュー
Opus 5.5 vs GPT-6.1 Sol:スコア差 3 点、コスト差 8 倍
AA インテリジェンス指数 v5 の新ランキングで、1 位のタスクあたりコストは $10.04、3 位は $1.27。スコアは近いが請求額は 8 倍差、どう選ぶかはタスク次第
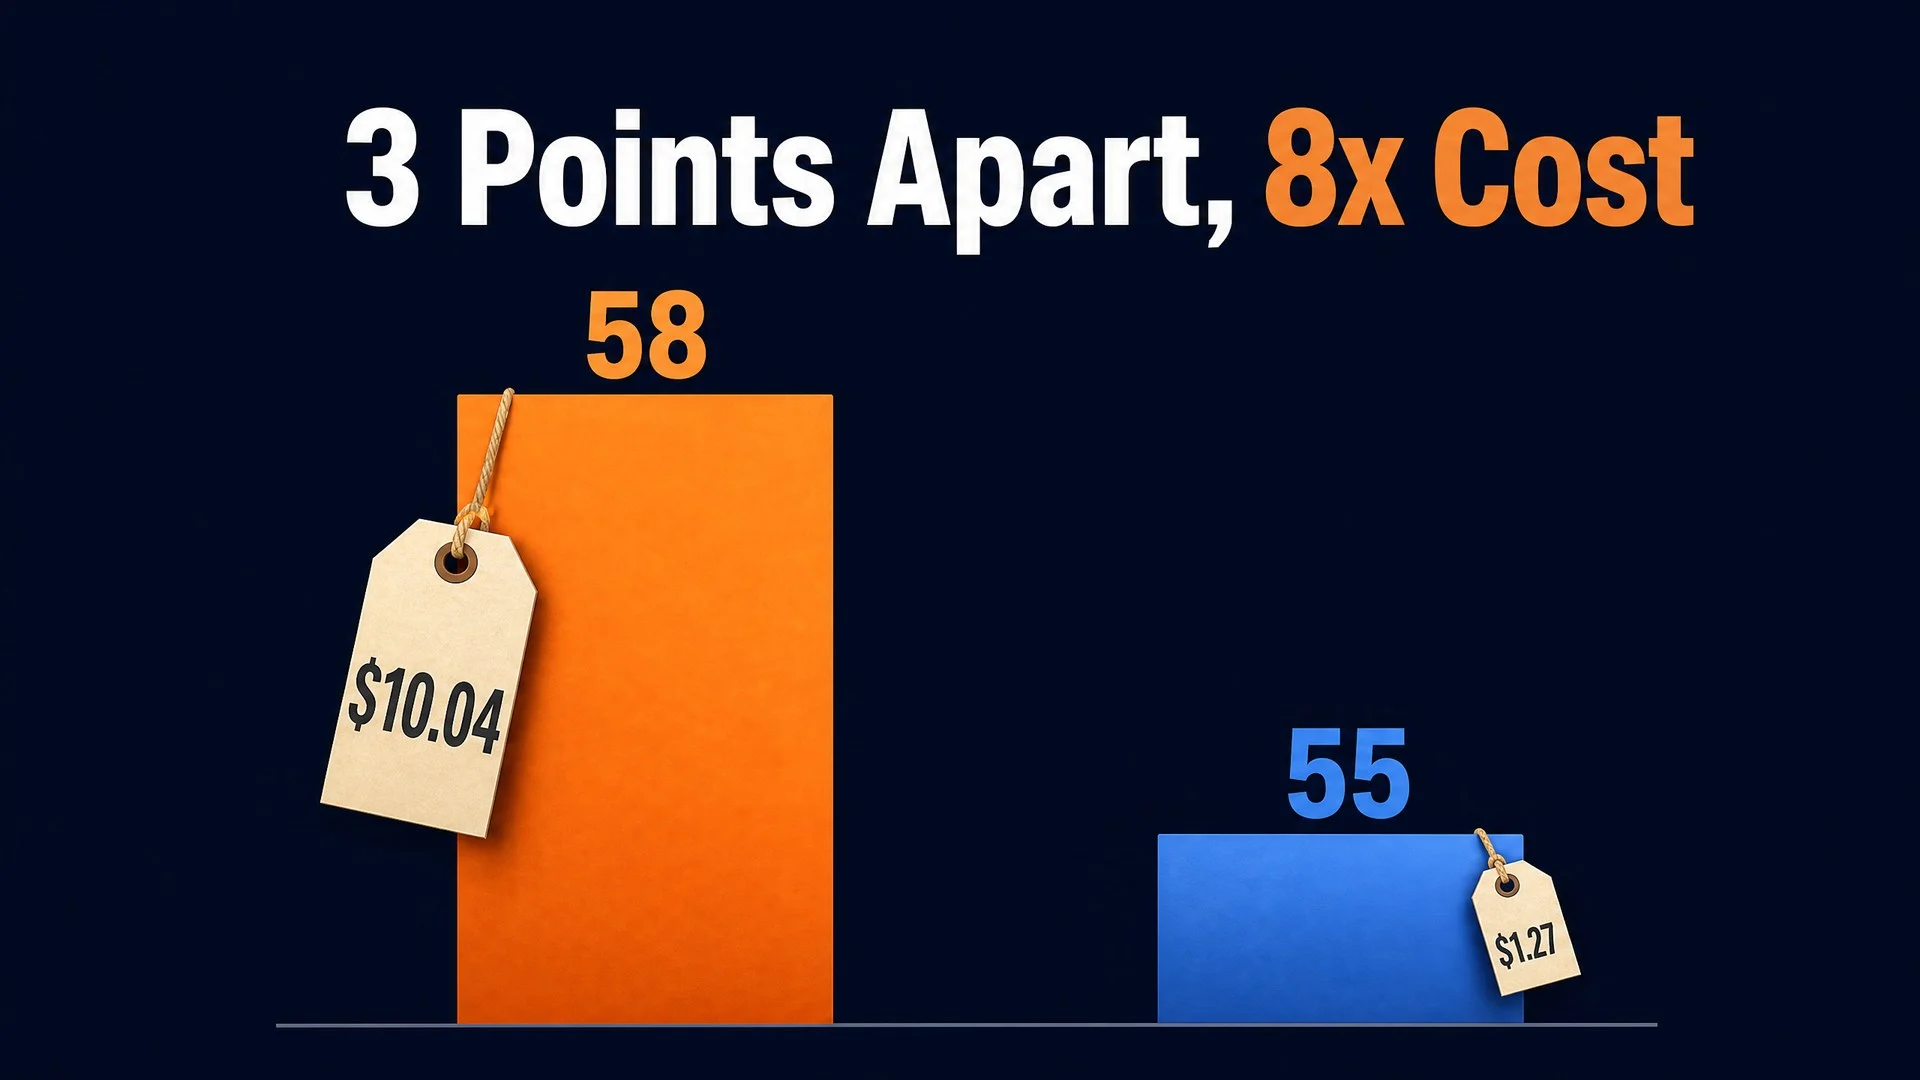
10 月 27 日、Artificial Analysis(以下 AA)は Intelligence Index v5 を公開した。これは 2026 年 1 月に v4 が登場して以来、最大の方法論改版である。改版後のランキング上位 3 位は、Claude Opus 5.5(58 点)、GPT-6 Astra(57 点)、GPT-6.1 Sol(55 点)だった。
スコアとは別に、AA は各モデルの実測タスクあたりコスト(per-task cost)も同時に公表している。Opus 5.5 は max 推論档でタスクあたり $10.04、一方 Sol はわずか $1.27 だ。AA 公式の表現では、Sol は首位とのスコア差が 4 点以内で、タスクあたりコストはおよそ 8 分の 1 で済むという。
まず結論から:
- スコア面:Opus 5.5 が 58 点で首位、Sol は 55 点で 3 位、差はわずか 3 点で同じ梯隊に属する
- コスト面:max 档のタスクあたり $10.04 対 $1.27 で約 8 倍の差、もはや同じ桁ではない
- 安さの秘密:トークン単価が低いのではなく、Opus のタスクあたり出力トークンが Sol の約 3 倍で、さらに約 2 倍の単価差が重なり、請求額が 8 倍に膨らんでいる
- どう選ぶか:日常の agent タスクは Sol / Terra で量をこなし、最も難しい難関タスクだけ Opus max 档を使う
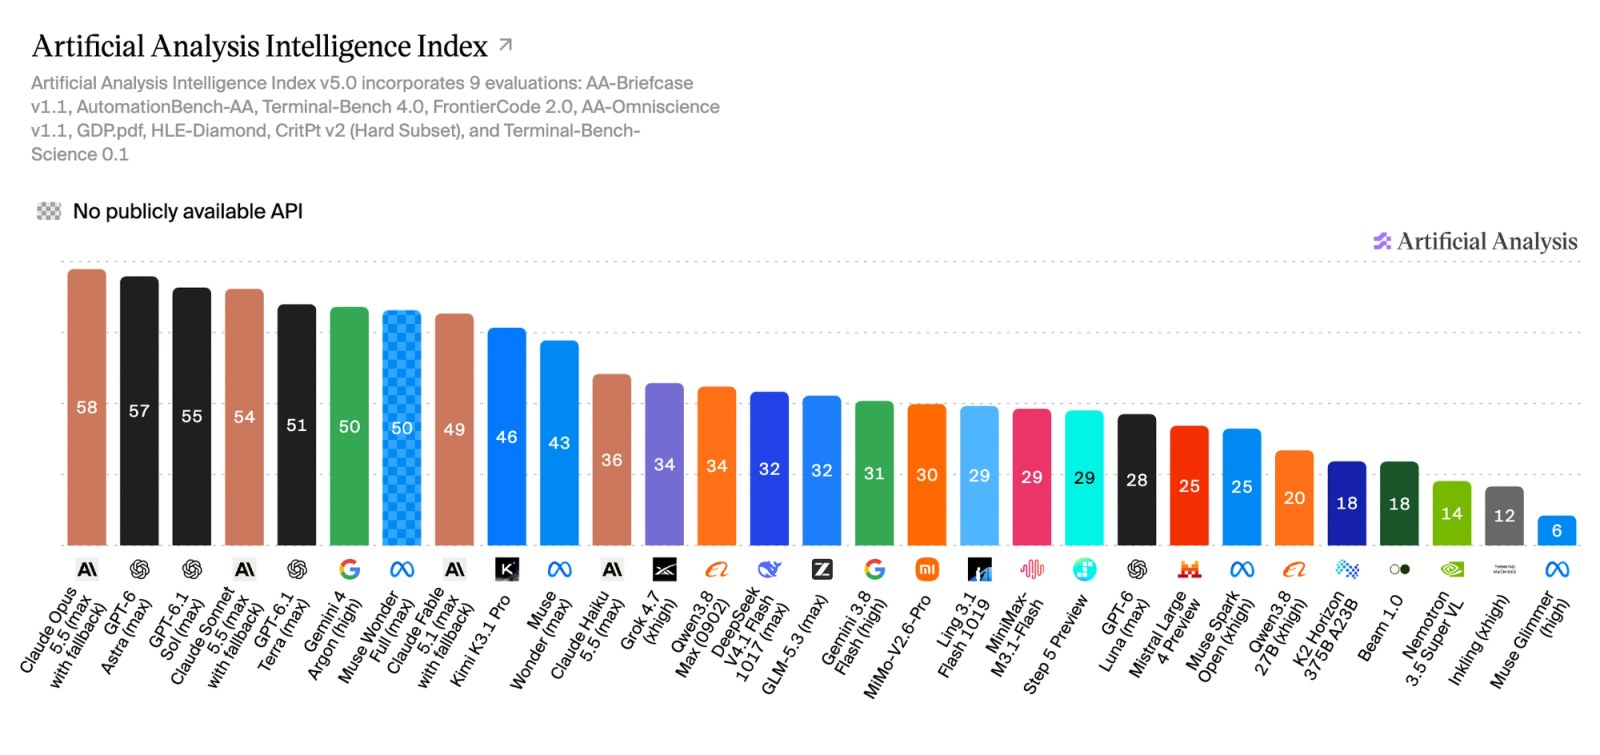
画像出典:Artificial Analysis Intelligence Index v5 公式発表(2026-10-27)
発端:v5 がなぜ「大改版」なのか
v5 の変更のうち、読者に最も関係するのは 2 点だ。1 つはタスクが重くなったこと:すべての評価の中央値出力が v4 の 35K tokens から 59K tokens に増え、その約 90% は agentic な多段タスクに由来し、より実際のワークロードに近づいている。もう 1 つは汚染防止:60% の評価が非公開テストセットに置き換えられ、ベンチマーク狙いのスコア稼ぎを封じている。
ランキングで他に注目すべき点は 2 つある。GPT-6 Astra が 57 点で 2 位に食い込んでいること。そして Kimi K3.1 Pro が 46 点でオープンモデル 1 位となったが、オープンとクローズドのトップ 5 の差は 3 点から 12 点に広がったことだ。
よくある誤読を 1 つ明確にしておきたい。Opus 5.5 は 9 月に 58 点で AA ランキング首位に立ったことがあるが、当時は v4.3 の旧タスクセットで走らせていた。今回 v5 改版後も依然として 1 位であり、「改版後も首位を守った」ことは「かつて 1 位だった」よりはるかに価値が高い。この 2 つを混同してはいけない。
スコアと請求額:1 枚の表で一目瞭然
以下のタスクあたりコストはすべて AA 公式 v5 発表の実測値(max 推論档)である:
| モデル | v5 スコア(max 档) | タスクあたりコスト(AA 実測) |
|---|---|---|
| Claude Opus 5.5 | 58 | $10.04 |
| GPT-6 Astra | 57 | $6.24 |
| GPT-6.1 Sol | 55 | $1.27 |
| GPT-6.1 Terra | トップ5圏外 | $0.96(最安) |
| Claude Fable 5.1 | トップ5圏外 | $13.04(最高) |
$10.04 ÷ $1.27 ≈ 7.9 倍で、AA 公式の「およそ 8 分の 1」という表現と一致する。AA は同時に、トップモデル間のタスクあたりコスト差が 13 倍を超えるとも指摘している。つまり「フラッグシップ能力」という狭い帯の中で、請求額の分化はスコアよりもはるかに激しい。
1 つ注意:ネット上で Sol $0.72、Opus $5.98 という数字を見かけたら、それは v4 旧タスクセット(中央値出力 35K tokens)の名残であり、v5 でタスクが重くなった後、公式の数値は $1.27 と $10.04 に更新されている。引用する際は 2026-10-27 の発表を参照してほしい。
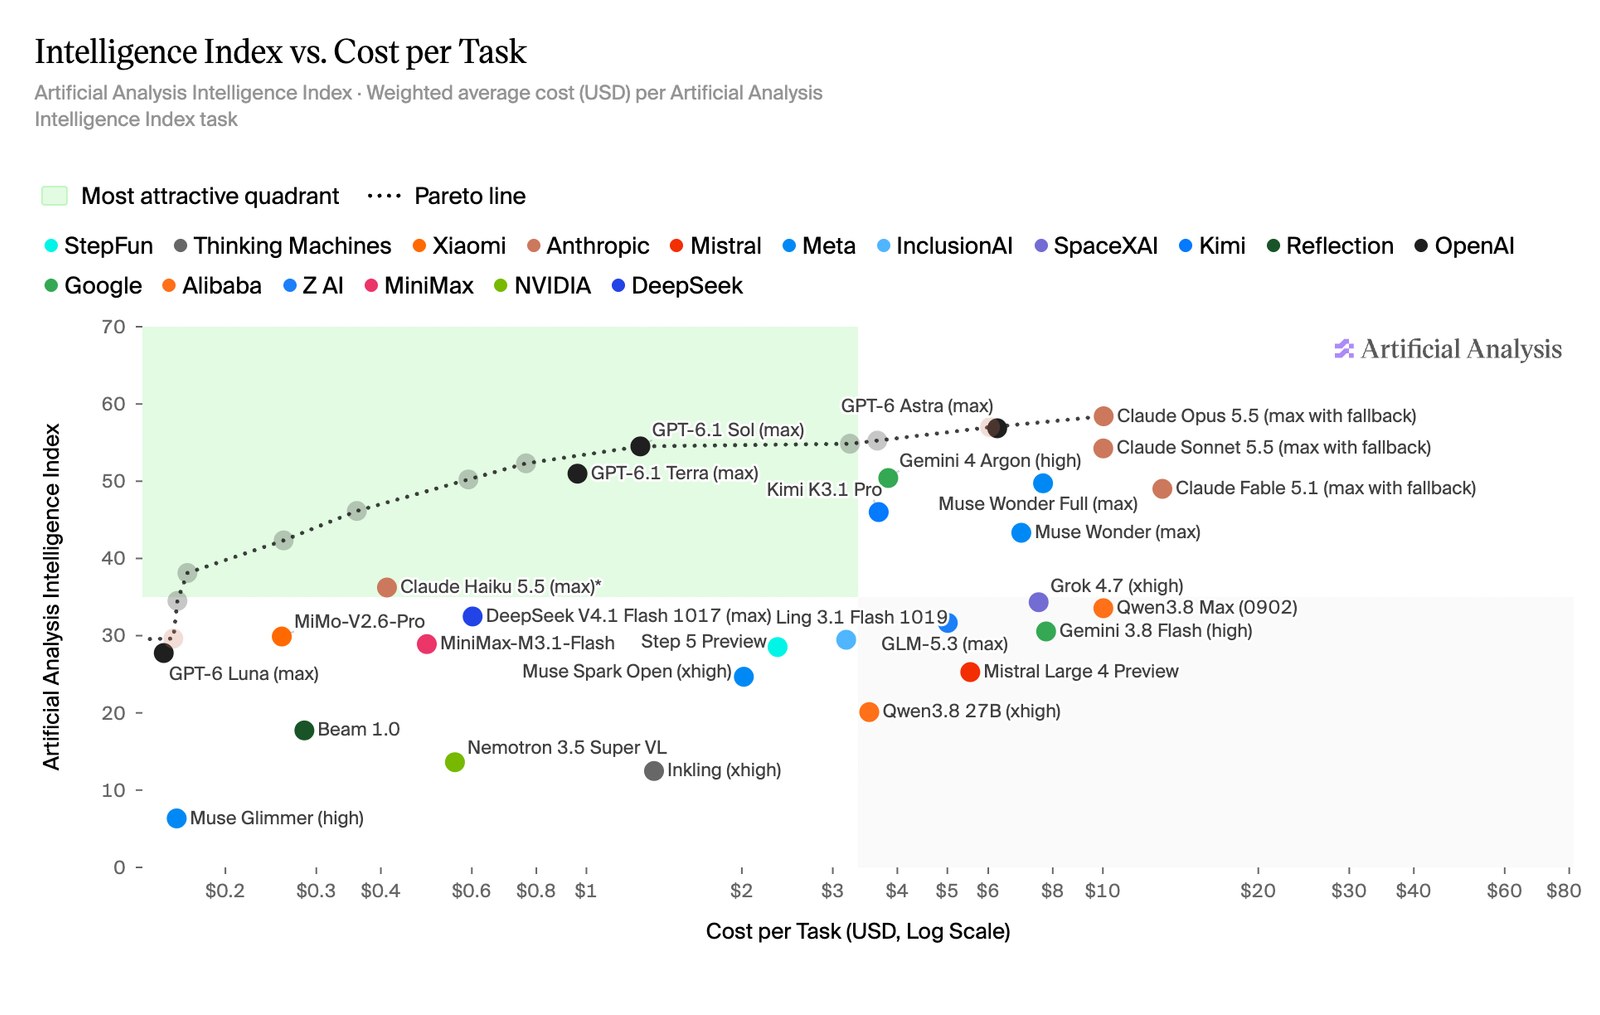
画像出典:Artificial Analysis Intelligence Index v5 公式発表(2026-10-27)
なぜトークン単価ではタスクあたりコストを予測できないのか
これは v5 公開後にコミュニティで最も議論された点だ。AA 発表の換算に用いられた公式トークン価格では、Opus 5.5 はトークンあたり Sol の約 2 倍(HiAPI プラットフォーム価格は基準が異なる。後述)だが、タスクあたりコストは 8 倍差がついた。余分な倍数は出力長に由来する:実測では Opus のタスクあたり生成出力トークンは Sol の約 3 倍だった。2 倍の単価に 3 倍の使用量を掛けると、8 倍の請求額になる。
このことは v5 でさらに増幅されている。タスクが重くなるということは出力が長くなるということであり、「長い出力を書きがちな」モデルはより高くつく。これは価格表だけを見ると体系的に歪む理由も説明している:価格表が教えてくれるのは「トークンあたりいくらか」であり、請求額が教えてくれるのは「この仕事を終えるのにいくらか」だ。どちらも重要だが、予算表に入れられるのは片方だけである。
指数の構成と、effort 档がなぜ重要になったか
v5 指数は 9 項目の評価から成り、4 つの等しい大分類に分かれ、それぞれ 25% を占める:知識作業(25%)、コーディング(25%)、科学(25%)、汎用(25%)。すべての 9 項目で 1 位を独占したモデルはなく、Opus 5.5 が 3 項目(コーディング、汎用のうち 2 つの難関評価)で首位、GPT-6 Astra が 2 項目で首位だ。つまり「誰が 1 位か」は、ある程度あなたのタスクがどの大分類に属するかで決まる。コードを書く、硬い知識問題を解くなら Opus のスコアがより参考になる。知識作業や自動化寄りの場面では、差は総合スコアが示すより小さくなる。
v5 のもう 1 つの変化は、effort 推論档がスコアに与える影響が明らかに大きくなったことだ:Opus 5.5 は low 档でわずか 35 点、max 档にすると 58 点。Sol の档の幅も 20 点に広がっている。言い換えれば、ランキングの 58 点も 55 点も「全力投球」で走らせた結果である。
一言でまとめると:スコアは max 档で走らせて出たもので、請求額も max 档で燃やして出たものだ。 ランキングを見て予算を立てるときは、両方の数字を档位とセットで見る必要がある。日常タスクで low / medium 档しか使わないなら、両モデルの実際の差はランキングとは異なってくる。
実践:タスク難度でルーティングし、一律にしない
上記のデータに基づくと、最もコストを抑える使い方は「全部 Sol に替える」でも「全部 Opus を残す」でもなく、タスク難度で階層化することだ:
- 日常の agent タスク(スクリプト、データクリーニング、通常のコーディング、バッチ処理):Sol あるいは Terra で量をこなす。$0.96 から $1.27 のタスクあたりコストは大量処理に向く
- 難関タスク(複雑なリファクタリング、深い推論、マルチホップ分析):そこで初めて Opus max 档を使う。3 点差のために 8 倍のコストを払うのは、価値あるタスクに限る
- もう一段コストを抑えたい:effort 档から手を付ける。デフォルト設定を最高档に固定しない
ざっくり計算して差を実感してみよう:同じ 1000 個の日常タスクを走らせる場合、全部 Sol なら約 $1,270、全部 Opus max 档なら約 $10,040。その差 $8,770 はチームの 1 か月分の難関タスク枠をすべて賄ってもなお余る。逆に、コスト削減のために全タスクを Sol に押し付けると、その 3 点差が最も難しい 5% のタスクで「できる」と「できない」の違いになりかねない。ルーティングの意義はここにある:高いモデルを本当に必要なタスクにだけ使わせることだ。
この「1 つのタスクプール、2 つのモデル」というルーティング構造こそ、アグリゲーションプラットフォームの得意分野だ:2 社のアカウントを別々に登録し、2 つの請求を突き合わせる必要はなく、1 つの Key でリクエストごとに切り替えられる。我々は Claude Code と Codex の接続に関する記事で、同じタスク別モデル切り替えの考え方を実演している。興味があれば照らし合わせて読んでほしい。
HiAPI で 2 つのモデルをどう接続するか
まずプラットフォーム価格を示す(2026-10 時点、いずれも ≤272K コンテキストの基本档):
| モデル | 入力 | 出力 | キャッシュ読み取り |
|---|---|---|---|
| claude-opus-5-5 | $2.02/M | $10.08/M | $0.10/M |
| gpt-6.1-sol | $0.50/M | $2.50/M | $0.025/M |
基準の分離に注意:上表は HiAPI のトークン単価であり、前文の $10.04 / $1.27 は AA 実測のタスクあたりコストだ。2 組の数字は出所が異なるため、直接混ぜて計算してはならない。プラットフォーム価格では Sol の入力・出力単価はいずれも Opus の約 4 分の 1 で、これは価格表の基準だ。タスクあたりの請求額に換算し、さらに前述の出力量の差を重ねて初めて、AA の 1/8 になる。
接続面では、Opus 5.5 は Anthropic Messages と OpenAI Chat Completions のデュアルプロトコルに対応し、5 段階の effort が調整可能。Sol は Responses と Chat Completions のデュアルプロトコルに対応し、コンテキストは 1.05M。両モデルとも同じ API Key で呼び出せ、リクエストごとにルーティングすればよい。
- Opus 5.5 の能力範囲と完全なパラメータはモデル詳細ページ、Sol はモデル詳細ページを参照
- 導入チュートリアル:GPT-6.1 Sol API 接続ガイド、Claude Opus 5.5 API 価格分析
- 前世代の比較参考:Opus 5.5 vs GPT-5.6 Sol
- 同時期の記事:GPT-6.1 Terra 値下げ速報、Claude Code / Codex モデル切り替えガイド、Genie 4 速報
よくある質問
Sol のタスクあたり $1.27 はどう算出されたのか?
これは AA 公式 v5 発表の実測基準だ:max 推論档で一連のタスクを走らせ、実際に消費した入出力トークンと公式価格で換算している。表示価格ではなく請求額なので、価格表を見るより実際に支払う金額に近い。
ネットに書かれている Sol $0.72、Opus $5.98 のタスクあたりコストはどちらが正しいのか?
$0.72 / $5.98 は v4 旧タスクセットの数字で、当時のタスク中央値出力はわずか 35K tokens だった。v5 でタスクが重くなった後(中央値 59K tokens)、公式は $1.27 / $10.04 に更新している。2026-10-27 の v5 発表を参照してほしい。
Sol と Opus 5.5 のトークン単価は結局何倍違うのか?
HiAPI プラットフォーム価格(2026-10 時点、≤272K 基本档)では、Sol は入力 $0.50/M、出力 $2.50/M、Opus は入力 $2.02/M、出力 $10.08/M で、単価は約 4 倍。だがこれは価格表の基準だ。AA のタスクあたりコスト基準では約 8 倍で、その差は Opus のタスクあたり約 3 倍の出力量に由来する。どちらの基準も成立するが、混ぜて計算してはいけない。
effort 档とは何か?なぜスコア差がこんなに大きいのか?
effort はモデル推論時の投入档位で、高いほど思考が深く、出力が長くなる。v5 では Opus 5.5 は low 档の 35 点から max 档の 58 点まで、幅は 23 点。Sol の档の幅も 20 点ある。つまり「Sol が Opus を代替できるか」は、日常でどの档を使うか、また高難度タスクにいくら払うかによって決まる。
自分のタスクには Sol と Opus 5.5 のどちらを使うべきか?
日常の agent タスク(スクリプト、クリーニング、通常のコーディング)はまず Sol で走らせ、量が多くてもコストは抑えられる。判断に迷う難関タスクは Opus max 档で 1 ラウンド比較する。HiAPI は 1 つの Key で両モデルを呼び出せるため、ルーティング切り替えに追加の接続コストはかからない。
重要な結論
v5 ランキングは 2 つのことを同時に突きつけている:能力面では、Opus 5.5、Astra、Sol が 3 点以内にひしめき、誰も他を圧倒していない。コスト面では、タスクあたりの請求額が 8 倍差で、スコアの分化よりはるかに激しい。スコアは max 档で走らせて出たもので、請求額も max 档で燃やして出たものだ。両方の数字を档位とセットで見る必要がある。ほとんどのチームにとって、正しい姿勢はどちらかに肩入れすることではなく、タスク難度でルーティングすることだ:Sol / Terra で量をこなし、Opus max 档で難関に挑む。このルーティングを HiAPI で実現するなら、両モデルは今すぐ走らせられる。
関連記事
すべての記事を見る →-

比較レビュー
Wan 2.6 Flash vs Wan 2.7:アップグレードすべきか?
720Pの予算と1080Pのキツネ・自動車完成品。組ごとに音声条件と実際のグレードを明記。
-

比較レビュー
Vidu Q4 Preview vs Kling 3.0:image-to-videoはどう選ぶ?
デフォルトで音声あり、16秒、5段階の解像度ならVidu Q4 Preview。開始・終了フレームで画面を固定するならKling 3.0。水上飛行機とバリスタの2組、同一プロンプトでの比較付き。
-

比較レビュー
Replicate の代替案:hiapi と Replicate の画像・動画生成比較(2026年)
Replicate から hiapi へ移行する際、予測呼び出し、webhook、課金をそれぞれどう変更するか、10 ステップの移行チェックリスト付き。