
Руководство
Практические сценарии применения gpt-6-luna: 5 ценных способов использования и ключевые моменты интеграции
Руководство для разработчиков по внедрению текстовой модели: от выбора сценария до вызова и контроля затрат
Почему gpt-6-luna подходит для проверки сценариев
Прежде чем выбирать модель, выберите тип задачи. gpt-6-luna — это модель текстового вывода от OpenAI, тарифицируемая по токенам; и вход, и выход учитываются в потреблении. Это означает, что она изначально подходит для задач «текст на входе — текст на выходе»: понимание, обобщение, перефразирование, генерация, различение, — и не берёт на себя мультимодальные обязанности вроде изображений и аудио. Попытка втиснуть неподходящую задачу в текстовую модель обычно говорит не о недостаточной мощности модели, а о том, что саму задачу не стоит решать ею.
Как отправная точка для проверки сценариев, у неё есть три практических преимущества. Во-первых, единая форма интерфейса: один запрос состоит из списка сообщений, и инженерной стороне нужно думать только об организации входа и разборе выхода, не вводя разные SDK для каждого сценария. Во-вторых, предсказуемая тарификация: оплата по токенам напрямую связывает стоимость с длиной текста, и уже на этапе проверки можно грубо оценить бюджет по количеству вызовов и средней длине, не дожидаясь счёта, чтобы обнаружить перерасход. В-третьих, чёткие границы задачи: чисто текстовая возможность позволяет легко определить метрики оценки — точность, доля соблюдения формата, доля ручных правок — всё это измеримо.
Правильный порядок на этапе проверки таков: сначала прогнать одну цепочку на небольшом количестве реальных образцов, убедиться в качестве вывода и стабильности формата; затем постепенно наращивать объём, наблюдая кривую потребления токенов; и только потом обсуждать расширение на большее число бизнес-линий. Обратный порядок — сначала массовая интеграция, затем возврат к оценке качества — обычно обходится дороже из-за переделок.
Также нужно ясно понимать, для чего она не подходит. Для задач, требующих детерминированных вычислений в реальном времени, строгой проверки правил согласованности, посимвольного сравнения сверхдлинных документов целиком, выгоднее использовать движок правил или традиционные решения поиска; ценность модели — в обработке нечётких, открытых входных данных, требующих семантического понимания. Критерий прост: если дать один и тот же вход двум разным людям, будут ли их разумные ответы различаться? Если да — задача требует семантических способностей; если нет — дешевле написать правила.
Сценарий первый: генерация контента и пакетные тексты
Пакетные тексты — самый прямой и самый подверженный ошибкам сценарий. Его суть не в том, чтобы «модель писала хорошо», а в том, чтобы «сто выводов соответствовали одному и тому же набору правил».
Вход фиксируется шаблоном
Организуйте каждый вызов в фиксированную структуру: описание задачи, целевая аудитория, ограничения по тону и длине, обязательные элементы, запрещённые формулировки и один эталонный пример. Преимущество шаблонизации — воспроизводимость поведения: при повторном запуске на той же партии данных стиль вывода не дрейфует. Полевой вход также облегчает последующее A/B-сравнение, например, изменить только описание тона и посмотреть на разницу в выводе.
Выход проверяется программно
Не предполагайте, что модель обязательно соблюдает формат. Сразу после генерации проверяйте: длина в диапазоне, нет ли запрещённых слов, все ли обязательные элементы на месте, разбираются ли структурированные поля. Провалившие проверку элементы отправляются на повтор или понижаются до шаблонного запасного варианта, а не идут напрямую в хранилище. Включение результатов проверки в метрики качества надёжнее выборочной ручной проверки.
Суммаризация и перефразирование проектируются отдельно
Для задач суммаризации нужно чётко указать «для кого, какой длины, какую информацию сохранить». В инструкции ясно прописать сохранение исходного смысла, недобавление фактов, отсутствующих в оригинале, и на этапе проверки сделать простое сопоставление фактов. Для задач перефразирования нужно определить границы допустимых изменений: термины, названия брендов, числа обычно менять нельзя, их следует давать во входе списком и проверять по пунктам после выхода.
Пакетный процесс должен быть управляемым
Пакетную запись рекомендуется обрабатывать фрагментами, фиксируя по каждому фрагменту число успехов и неудач. Неудачные элементы сохраняются отдельно вместе с оригиналом и причиной ошибки для集中ного повтора. После завершения всей партии рассчитайте среднее потребление токенов и долю ручных правок — эти два числа определяют, стоит ли сохранять эту цепочку надолго.
Сценарий второй: служба поддержки и ассистент вопросов-ответов
Сложность сценария поддержки никогда не была в возможностях модели, а в управлении границами. Ассистент, отвечающий красиво, но выходящий за полномочия, рискованнее ассистента, отвечающего консервативно.
Организация контекста
Включайте в вход историю диалога, релевантный фон о пользователе и фрагменты бизнес-знаний, но с отбором. Чем длиннее история, тем выше расход токенов, и раннее нерелевантное содержимое размывает фокус текущего вопроса. На практике можно сохранять последние несколько раундов диалога, сжимая более раннее в одно предложение-резюме; фрагменты знаний вставлять только в малом объёме после поиска, а не загружать всю базу.
Границы ответов
В системной инструкции чётко определите три типа поведения: на что можно отвечать, что обязательно передавать человеку, что категорически нельзя обещать. Высокочувствительные темы вроде возвратов, компенсаций, юридических и медицинских советов сразу настраивайте на передачу человеку, не отдавая модели на свободное усмотрение. Также требуйте от модели явно говорить «не знаю» при недостатке информации, а не дополнять правдоподобно звучащий ответ.
Резерв человеку и прослеживаемость
Каждый сгенерированный моделью ответ должен фиксировать сводку входа, версию выхода и попавшие фрагменты знаний для последующего разбора. Задайте чёткие условия срабатывания резерва: низкая уверенность модели, наличие чувствительных ключевых слов, повторные нерешённые уточнения пользователя. Резерв — не провал, а часть дизайна.
Оценка эффективности
На начальном этапе после запуска оценивайте точность ответов и долю передач человеку ручной выборочной проверкой, после стабилизации вводите автоматические метрики. Реально нужно следить за двумя типами ошибок: выдумывание несуществующей информации и отсутствие передачи человеку, когда она была нужна. Первое подрывает доверие, второе увеличивает риск.
Сценарий третий: извлечение структурированной информации
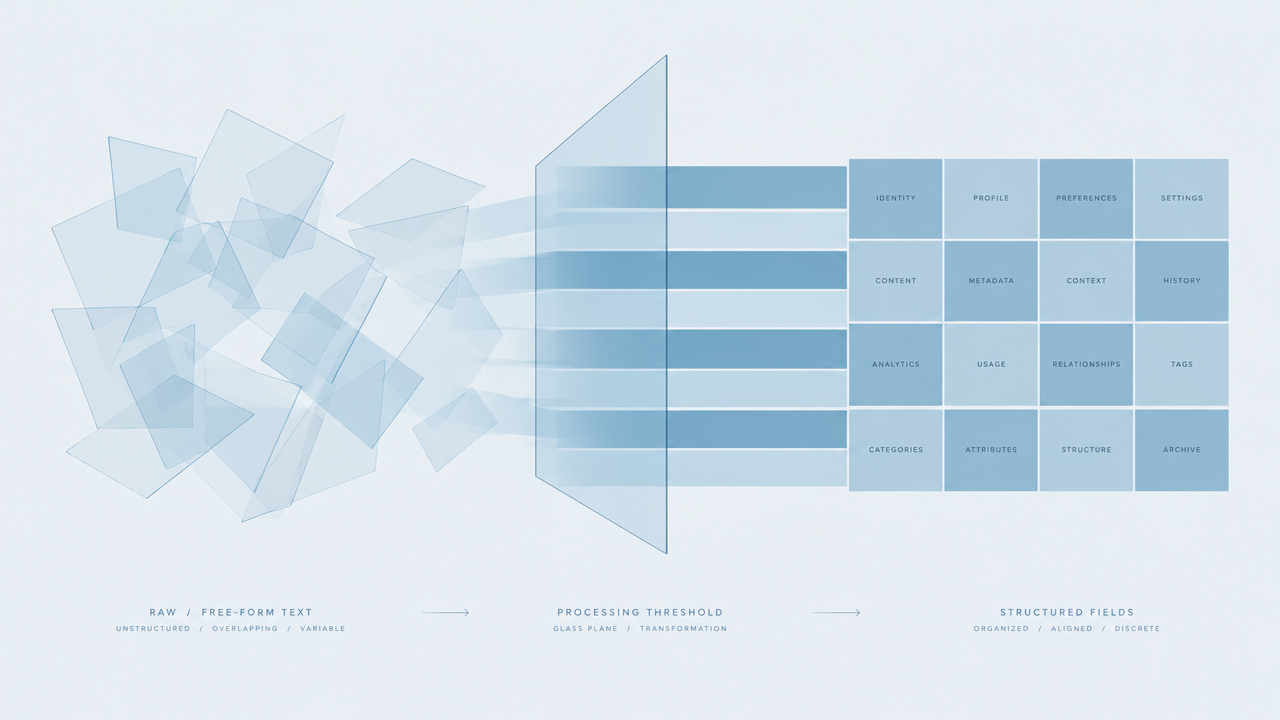
Преобразование свободного текста в структурированные поля — очень выгодный по соотношению затрат и результата способ: на входе неструктурированный естественный язык, на выходе пары ключ-значение, готовые к загрузке в хранилище.
Сначала определите целевой schema
Прежде чем писать инструкцию, зафиксируйте целевую структуру: имена полей, типы, обязательность, диапазоны значений, элементы перечислений. Чем яснее schema, тем стабильнее выход. При проектировании полей лучше дробить, чем втискивать несколько смыслов в одно свободнотекстовое поле, иначе последующая проверка не сможет зацепиться.
Ограничение формата выхода
Требуйте от модели выводить только структурированный результат без пояснительного текста. Также дайте полный пример выхода — пример эффективнее описания правил. Для полей-перечислений перечислите в инструкции все допустимые значения и укажите, какой заполнитель ставить при невозможности определить.
Проверка и устойчивость к ошибкам
Сразу после получения выхода выполняйте программную проверку: разбирается ли, нет ли пропущенных обязательных полей, легальны ли значения перечислений, в разумных ли диапазонах числа. Не отбрасывайте молча образцы с ошибкой разбора, а фиксируйте исходный вход и выход модели для итерации инструкции. Для ключевых полей можно предусмотреть повторную проверку: передать результат извлечения вместе с фрагментом оригинала модели для подтверждения согласованности.
Обработка длинных текстов
Документы, превышающие длину однократной обработки, разбивайте по семантическим границам, затем извлекайте и объединяйте результаты. При разбиении следите, чтобы информация одного поля не оказалась в двух фрагментах. На этапе объединения помечайте конфликтующие поля для решения человеком.
Сценарий четвёртый: помощь с кодом и документацией
Помощь разработке — естественный сценарий для текстовой модели, но применять её нужно в правильном месте.
Объяснение кода и вводное чтение
Столкнувшись с незнакомым репозиторием, передайте модели контекст одного файла или функции и попросите объяснить назначение, входы-выходы и потенциальные побочные эффекты. Это применение дёшево и даёт прямой результат, подходит новичкам для старта и разбора унаследованных систем. Ключевой момент — контролировать объём контекста: давать за раз один самостоятельно понимаемый блок, а не весь репозиторий.
Генерация документации
Сгенерируйте документацию интерфейса по сигнатурам функций, комментариям и примерам вызовов, затем вычитайте вручную. В инструкции чётко укажите целевую аудиторию и формат документации, подчеркните недопустимость выдумывания поведения параметров. Сгенерированная документация должна проходить ревью вместе с кодом, а не публиковаться сразу.
Замечания ревью и черновики тестов
Попросить модель составить список потенциальных проблем по изменённому фрагменту — хорошее дополнение, но оно не заменяет ручное ревью. На практике позиционируйте это как «первый проход», а человек решает, какие замечания стоит учитывать. То же с тест-кейсами: сгенерированные моделью кейсы обычно покрывают распространённые пути, граничные условия всё ещё требуют инженерного суждения.
Меры предосторожности
Не вставляйте в подсказку реальные ключи, внутренние адреса или персональные данные пользователей. По поводу предложенных моделью способов использования API, номеров версий и элементов конфигурации всегда сверяйтесь с официальной документацией — именно в таких деталях чаще всего появляется правдоподобный, но несуществующий вымысел.
Сценарий пятый: помощь в анализе и принятии решений
Лёгкие аналитические задачи подходят для передачи текстовой модели: превратить массу разрозненных текстов в читаемые выводы, экономя время на чтение, а не заменяя суждение человека.
Классификация комментариев и выявление сути
Отзывы пользователей, записи интервью, содержимое тикетов — типичный вход. Подход таков: сначала определите систему категорий, попросите модель отнести каждый текст к уже существующей категории с одним предложением обоснования; затем по каждой категории выделите ключевые пункты. Систему категорий нужно определить заранее, открытое «классифицируй как угодно» даст результаты, которые невозможно агрегировать.
Сравнительный анализ
Дайте описания нескольких решений или продуктов параллельно, попросите модель сравнить их по единым измерениям пункт за пунктом и указать источники информации. Выход должен быть размерным сопоставлением, а не общим заявлением о преимуществах и недостатках. Для суждений, по которым модель не нашла оснований во входе, требуйте явно помечать их как предположения.
Ограничения, которые нужно признать
Текстовые модели плохо справляются с точной статистикой и числовыми рассуждениями, а также не знают фактов за пределами входа. Всё, что касается количества, пропорций, тенденций, следует вычислять отдельно на основе структурированных данных, модель отвечает только за объяснение и формулировку. Для решений с высоким риском выход может служить лишь справочным материалом, а не выводом.
Способ оценки
Оценка аналитических задач в основном ручная: возьмите часть вывода, проверьте разумность классификации, не упущены ли ключевые сведения, нет ли чрезмерных умозаключений. Запись найденных проблем обратно в инструкцию — самый эффективный способ оптимизации.
Стратегии контроля затрат при тарификации по токенам
Оплата по токенам означает прямую связь стоимости с длиной текста; контроль затрат по сути есть контроль объёма входа и выхода.
Сначала оцените количество вызовов
Оценка затрат начинается с трёх чисел: среднесуточное количество вызовов, средний входной токен, средний выходной токен. Прогоните один круг на реальных образцах, получите фактическое распределение, а не заполняйте по ощущениям. Распределение часто значимее среднего — если少数 сверхдлинные запросы занимают большую часть потребления, оптимизацию следует направить именно на них.
Сжатие входа
Вход обычно составляет основную часть затрат. Возможные меры: удалить избыточные пояснения в шаблоне, сократить примеры до необходимого, заменить длинную историю резюме, вставлять после поиска только релевантные фрагменты. Каждую меру оценивайте по критерию «снижается ли качество выхода после удаления», а не просто сокращайте ради сокращения.
Ограничение выхода
Длина выхода также управляема. В инструкции укажите верхние пределы по числу слов или пунктов, требуйте сначала вывод, без повторения входного содержимого, без вежливых формул. Для структурированных задач требование выводить только значения полей может заметно сократить бесполезные токены.
Кэширование и деградация
Кэшируйте результаты для высокоповторяющихся запросов, например одинаковых запросов на перефразирование описания товара, при попадании в кэш возвращайте сразу. Для некритических цепочек проектируйте пути деградации: при недоступности модели откат к шаблону или правилам, чтобы основной процесс не прерывался. Также установите лимиты на один запрос и на суточное количество вызовов, чтобы аномальный трафик не раздувал потребление.
Постоянное наблюдение
После запуска отслеживайте среднее потребление токенов, долю повторных попыток при сбоях и долю ручных правок. Повтор сам по себе является затратой, нестабильный выход часто означает, что инструкцию нужно исправить, а не пробовать ещё несколько раз. Актуальные цены в реальном времени и детали тарификации см. на панели цен сайта.
Чек-лист интеграции и внедрения
Подтвердите по пунктам следующее перед запуском — это позволит избежать большинства типичных проблем.
Границы входа и выхода
- Определены ли в инструкции задача, целевая аудитория, ограничения формата и длины
- Предоставлены ли пример выхода и список запрещённых действий
- Заданы ли чёткие правила передачи человеку или отказа в ответе для чувствительных тем и запросов за пределами полномочий
- Избегается ли включение в вход ключей, внутренних адресов и персональных данных пользователей
Обработка ошибок и повторные попытки
- Различаются ли повторяемые ошибки (тайм-аут, ограничение частоты) и неповторяемые (недопустимый вход, нарушение правил содержимого)
- Установлены ли для повторов верхний предел числа и стратегия отсрочки, чтобы не раздувать затраты
- Есть ли запасной путь для запросов, которые всё равно не удались после повторов, чтобы основной процесс не прерывался
Журналы и наблюдаемость
- Фиксируются ли сводка входа, результат выхода, время выполнения и потребление токенов каждого вызова
- Сохраняются ли неудачные образцы отдельно для воспроизведения и итерации инструкции
- Считаются ли ключевые метрики: среднее потребление токенов, доля сбоев, доля ручных правок
Оценка эффективности и итерации
- Проведена ли перед запуском мелкомасштабная проверка на реальных образцах
- Есть ли чёткие метрики качества и ритм ручной выборочной проверки
- Ведутся ли версии изменений инструкции для отката и сравнения
Согласование с бизнес-процессом
- Ясно ли место выхода модели в бизнес-процессе: рекомендация, черновик или результат, который можно использовать напрямую
- Какие этапы требуют подтверждения человеком и закреплено ли это в процессе
- Подтверждено ли, что для данного сценария правила или традиционные решения выгоднее
Рассматривайте этот чек-лист как порог запуска, а не как одноразовый документ. При каждом расширении нового сценария и каждой корректировке инструкции стоит заново проходить соответствующие пункты.
Похожие статьи
Все статьи →-

Руководство
Как вызвать hailuo-2.3-fast/image-to-video через HiAPI API: практика с curl и Python
Первый рабочий запрос к быстрому и недорогому уровню генерации видео по изображению — от ID модели до загрузки MP4
-

Руководство
Как вызывать hailuo-2.3/text-to-video через API HiAPI: curl, Python и рабочие примеры запросов
-

Руководство
Использование Kandinsky 6.0 Pro для преобразования текста в видео на HiAPI: руководство по curl и Python
Практическая демонстрация с упором на запросы: построение вызова от промпта до видеоклипа, отправка запроса, опрос статуса завершения и скачивание результата