
Tutorial
Casos prácticos de gpt-6-luna: 5 usos de alto valor y puntos clave de integración
Guía para desarrolladores sobre la implementación de modelos de texto: desde la selección de casos de uso hasta la invocación y el control de costes
Por qué usar gpt-6-luna para validar casos de uso
Antes de elegir un modelo, elige el tipo de problema. gpt-6-luna es un modelo de salida de texto ofrecido por OpenAI, con precios por token: tanto la entrada como la salida cuentan en el consumo. Esto significa que está diseñado por naturaleza para tareas de «texto entra, texto sale»: comprender, resumir, reescribir, generar y discriminar, sin asumir responsabilidades multimodales como imágenes o audio. Forzar tareas inadecuadas en un modelo de texto normalmente no indica que el modelo sea débil, sino que el problema no debería resolverse con él.
Como punto de partida para validar casos de uso, ofrece tres ventajas prácticas. Primera, una interfaz uniforme: una petición se compone de una lista de mensajes; el equipo de ingeniería solo debe preocuparse por organizar la entrada y analizar la salida, sin introducir SDK distintos para cada caso. Segunda, un criterio de facturación predecible: el precio por token vincula directamente el coste con la longitud del texto, de modo que en la fase de validación se puede estimar el presupuesto a partir del volumen de llamadas y la longitud media, sin esperar a la factura para descubrir un sobregasto. Tercera, límites de tarea claros: la capacidad puramente textual facilita definir métricas de evaluación —tasa de acierto, tasa de cumplimiento de formato, tasa de modificaciones manuales—, todas cuantificables.
El orden correcto en la fase de validación es: primero ejecutar de extremo a extremo un flujo con una pequeña muestra real para confirmar la calidad de la salida y la estabilidad del formato; después aumentar el volumen gradualmente y observar la curva de consumo de tokens; solo al final discutir si conviene extenderse a más líneas de negocio. Hacerlo al revés —integrar a gran escala primero y volver después a definir la evaluación de calidad— suele implicar un coste mayor en retrabajos.
También hay que tener claro para qué no sirve. Para tareas que requieren cálculo determinista en tiempo real, validación de reglas con consistencia estricta o comparación literal de documentos muy largos, resulta más rentable usar un motor de reglas o una solución de recuperación tradicional; el valor del modelo está en procesar entradas ambiguas, abiertas y que requieren comprensión semántica. El criterio es simple: si entregas la misma entrada a dos personas distintas, ¿sus salidas razonables diferirían? Si difieren, la tarea requiere capacidad semántica; si no difieren, escribir reglas es más económico.
Caso uno: generación de contenido y textos masivos
Los textos masivos son el caso más directo y también el más propenso a errores. Lo esencial no es «que el modelo escriba bien», sino «que cien salidas cumplan el mismo conjunto de normas».
Entrada fijada con plantillas
Organiza cada llamada en una estructura fija: descripción de la tarea, público objetivo, restricciones de tono y longitud, elementos obligatorios, expresiones prohibidas y un ejemplo de referencia. La plantilla aporta reproducibilidad: al ejecutar de nuevo el mismo lote de datos, el estilo de salida no se desvía. Una entrada con campos también facilita comparaciones A/B posteriores, por ejemplo, cambiar solo la descripción del tono y observar las diferencias en la salida.
Validación programática de la salida
No asumas que el modelo cumplirá siempre el formato. Valida inmediatamente tras la generación: si la longitud está dentro del rango, si contiene palabras prohibidas, si están todos los elementos obligatorios y si los campos estructurados se pueden analizar. Los elementos que fallen la validación deben reintentarse o degradarse a un respaldo basado en plantilla, en lugar de almacenarse directamente. Incorporar los resultados de la validación a las métricas de calidad es más fiable que el muestreo manual.
Diseñar por separado resúmenes y reescrituras
En las tareas de resumen hay que definir con claridad «para quién es, qué longitud y qué información conservar». En las instrucciones, indica que se mantenga el sentido original y que no se añadan hechos ausentes del texto original, y realiza una comparación factual sencilla en la fase de validación. En las tareas de reescritura, define los límites de lo modificable: términos, nombres de marca y cifras normalmente no deben cambiarse; indícalos en la entrada como lista y verifícalos uno a uno tras la salida.
Flujo masivo controlable
Para el procesamiento masivo, se recomienda procesar por fragmentos y registrar en cada uno el número de éxitos y fallos. Conserva por separado el texto original y el motivo del error de los elementos fallidos para poder reintentarlos de forma concentrada. Al terminar todo el lote, calcula una vez el consumo medio de tokens y la tasa de modificaciones manuales; estas dos cifras determinan si merece la pena mantener ese flujo a largo plazo.
Caso dos: atención al cliente y asistentes de preguntas y respuestas
La dificultad de la atención al cliente nunca ha estado en la capacidad del modelo, sino en la gestión de límites. Un asistente que responde con elegancia pero se extralimita supone un riesgo mayor que uno que responde de forma conservadora.
Organización del contexto
Incluye en la entrada el historial de conversación, el contexto relevante de la identidad del usuario y fragmentos de conocimiento del negocio, pero con criterio. Cuanto más largo es el historial, mayor es el consumo de tokens, y el contenido irrelevante inicial diluye el foco del problema actual. En la práctica, conserva las últimas rondas de conversación y comprime lo anterior en una frase de resumen; inyecta solo unos pocos fragmentos de conocimiento tras la recuperación, en lugar de volcar toda la base.
Límites de respuesta
En las instrucciones del sistema, define claramente tres tipos de comportamiento: qué se puede responder, qué debe derivarse a una persona y qué no se puede prometer en ningún caso. Temas muy sensibles como reembolsos, indemnizaciones, asesoramiento legal o médico deben derivarse directamente a una persona, sin dejar que el modelo improvise. Además, exige al modelo que diga claramente que no sabe cuando la información es insuficiente, en lugar de completar una respuesta que suene razonable.
Respaldo humano y trazabilidad
Cada respuesta generada por el modelo debe registrar el resumen de la entrada, la versión de la salida y los fragmentos de conocimiento coincidentes, para facilitar la revisión posterior. Define condiciones claras para activar el respaldo: baja confianza del modelo, palabras clave sensibles o consultas repetidas del usuario sin resolver. El respaldo no es un fallo, sino parte del diseño.
Evaluación de resultados
En la fase inicial, evalúa con muestreo manual la tasa de acierto de las respuestas y la tasa de derivación a personas; cuando se estabilice, introduce métricas automáticas. Lo que realmente hay que vigilar son dos tipos de error: inventar información inexistente y no derivar a una persona cuando era necesario. El primero daña la confianza; el segundo amplifica el riesgo.
Caso tres: extracción de información estructurada
Convertir texto libre en campos estructurados es un uso con una relación coste-beneficio muy alta: la entrada es lenguaje natural desordenado y la salida son pares clave-valor que pueden almacenarse directamente.
Definir primero el esquema de destino
Antes de escribir las instrucciones, fija la estructura de destino: nombres de campos, tipos, obligatoriedad, rangos de valores y elementos de enumeración. Cuanto más claro sea el esquema, más estable será la salida. En el diseño de campos, es preferible dividir en campos más finos antes que meter varias semánticas en un único campo de texto libre, pues de lo contrario la validación posterior no tendrá por dónde empezar.
Restricciones de formato de salida
Pide al modelo que solo genere el resultado estructurado, sin texto explicativo adicional. Proporciona además un ejemplo completo de salida; un ejemplo es más eficaz que una descripción de reglas. Para los campos de enumeración, enumera en la instrucción todos los valores válidos e indica qué marcador de posición usar cuando no se pueda determinar.
Validación y tolerancia a errores
Tras recibir la salida, valida programáticamente de inmediato: si se puede analizar, si faltan campos obligatorios, si los valores de enumeración son válidos y si los valores numéricos están en un rango razonable. No descartes silenciosamente las muestras que fallen el análisis; registra la entrada original y la salida del modelo para iterar las instrucciones. Para los campos críticos, puedes diseñar una segunda validación: entregar el resultado de la extracción junto con el fragmento original al modelo para que confirme la consistencia.
Tratamiento de textos largos
Para documentos que superan la longitud de procesamiento de una sola vez, divídelos por límites semánticos, extrae después y fusiona los resultados al final. Al dividir, evita que la información de un campo quede repartida entre dos fragmentos. En la fase de fusión, marca los campos en conflicto para que los resuelva una persona.
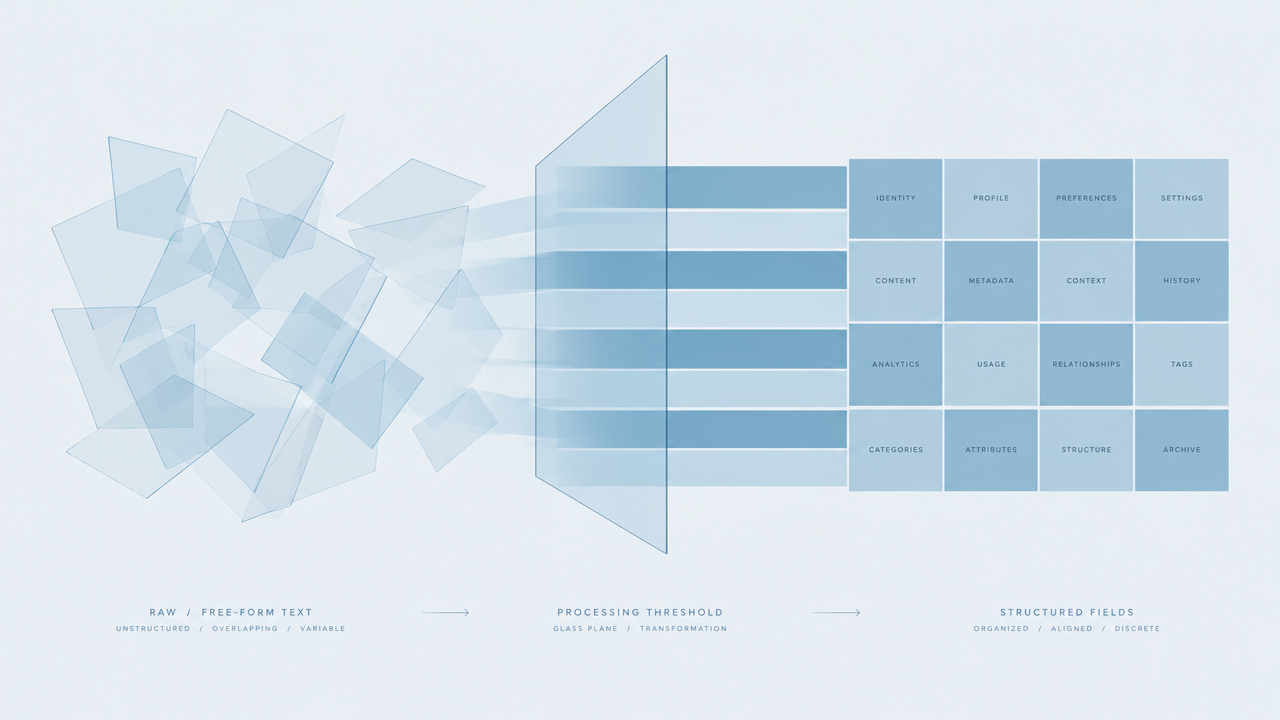
Caso cuatro: asistencia para código y documentación
La asistencia al desarrollo es un caso natural para los modelos de texto, pero debe usarse en el lugar correcto.
Explicación de código y lectura inicial
Ante una base de código desconocida, entrega al modelo el contexto de un único archivo o función y pídele que explique su responsabilidad, entradas y salidas, y posibles efectos secundarios. Este uso tiene bajo coste y beneficio directo, y resulta adecuado para la incorporación de nuevos miembros y la revisión de sistemas heredados. La clave es controlar el alcance del contexto: proporciona cada vez una unidad que pueda entenderse de forma independiente, sin volcar todo el repositorio.
Generación de documentación
Genera documentación de interfaz a partir de firmas de funciones, comentarios y ejemplos de llamada, y después revisa manualmente. En la instrucción, especifica el público objetivo y el formato de la documentación, y enfatiza que no se debe inventar el comportamiento de los parámetros. La documentación generada debe revisarse junto con el código, no publicarse directamente.
Comentarios de revisión y borradores de pruebas
Pedir al modelo una lista de problemas potenciales sobre un fragmento de cambio es un buen complemento, pero no sustituye la revisión humana. En la práctica, úsalo como «una primera pasada» y deja que la persona decida qué comentarios merecen seguimiento. Lo mismo ocurre con los casos de prueba: los que genera el modelo suelen cubrir recorridos habituales, pero las condiciones límite siguen requiriendo criterio de ingeniería.
Advertencias
No pegues claves reales, direcciones internas ni datos privados de usuarios en los prompts. Para el uso de API, los números de versión y los elementos de configuración que indique el modelo, verifícalos siempre en la documentación oficial: estos detalles son los más propensos a contener invenciones que parecen razonables pero no existen.
Caso cinco: análisis y apoyo a la decisión
Las tareas de análisis ligero son adecuadas para un modelo de texto: organizar una gran cantidad de texto disperso en conclusiones legibles ahorra tiempo de lectura, sin sustituir el criterio humano.
Clasificación de comentarios y extracción de puntos clave
Los comentarios de usuarios, las actas de entrevistas y el contenido de tickets son entradas típicas. El método consiste en definir primero un sistema de clasificación, pedir al modelo que asigne cada texto a una categoría existente y dé una razón en una frase, y después extraer los puntos clave de cada categoría. El sistema de clasificación debe definirse de antemano; una «clasificación libre» abierta producirá resultados que no se pueden agregar.
Análisis comparativo
Presenta en paralelo las descripciones de varias soluciones o productos y pide al modelo que los compare punto por punto según dimensiones uniformes, indicando la fuente de la información. La salida debe ser una comparación por dimensiones, no una valoración genérica de mejor o peor. Para los juicios en los que el modelo no encuentre base en la entrada, exige que los marque claramente como conjeturas.
Limitaciones que hay que reconocer
Los modelos de texto no son buenos para estadísticas precisas ni razonamiento numérico, y tampoco conocen hechos fuera de la entrada. Cualquier juicio sobre cantidades, proporciones o tendencias debe basarse en datos estructurados y calcularse aparte; el modelo solo se encarga de explicar y expresar. Para decisiones de alto riesgo, la salida solo puede servir como material de referencia, nunca como conclusión.
Método de evaluación
La evaluación de las tareas de análisis es principalmente manual: toma una parte de las salidas, comprueba si la clasificación es razonable, si los puntos clave omiten información relevante y si hay inferencias excesivas. Incorporar los problemas detectados a las instrucciones es la forma más eficaz de optimización.
Estrategias de control de costes con precios por token
El precio por token implica que el coste está directamente relacionado con la longitud del texto; controlar el coste es, en esencia, controlar la escala de entrada y salida.
Estimar primero el volumen de llamadas
La estimación de costes parte de tres cifras: número de llamadas diarias, tokens de entrada medios y tokens de salida medios. Ejecuta una ronda con muestras reales para obtener la distribución real, en lugar de rellenar con intuiciones. La distribución suele ser más significativa que la media: si unas pocas peticiones muy largas concentran la mayor parte del consumo, la optimización debe centrarse en ellas.
Comprimir la entrada
La entrada suele ser la mayor parte del coste. Las medidas viables incluyen: eliminar descripciones redundantes de la plantilla, reducir los ejemplos a lo necesario, sustituir historiales largos por resúmenes e inyectar solo los fragmentos relevantes tras la recuperación. Cada medida debe juzgarse con el criterio de «si al eliminarla baja la calidad de la salida», y no por simplificar sin más.
Restringir la salida
La longitud de la salida también es controlable. En las instrucciones, fija límites de palabras o de número de elementos, exige conclusiones primero, que no se repita el contenido de la entrada y que no se incluyan fórmulas de cortesía. Para tareas estructuradas, pedir solo los valores de los campos puede reducir significativamente los tokens inútiles.
Caché y degradación
Almacena en caché los resultados de peticiones muy repetitivas, por ejemplo, una misma necesidad de reescritura de descripción de producto: si hay coincidencia en caché, devuélvela directamente. Diseña rutas de degradación para los flujos no críticos: cuando el modelo no esté disponible, vuelve a plantillas o soluciones basadas en reglas para garantizar la continuidad del flujo principal. Establece además límites de peticiones individuales y de llamadas diarias para evitar que un tráfico anómalo amplifique el consumo.
Observación continua
Tras el lanzamiento, haz seguimiento del consumo medio de tokens, la tasa de reintentos fallidos y la tasa de modificaciones manuales. Los reintentos son en sí mismos un coste; una salida inestable suele indicar que hay que corregir las instrucciones, no probar más veces. El precio en tiempo real y las condiciones de facturación vigentes deben consultarse en el panel de precios del sitio.
Lista de verificación para la integración
Confirmar punto por punto lo siguiente antes del lanzamiento permite evitar la mayoría de los problemas habituales.
Límites de entrada y salida
- ¿Se especifican en las instrucciones la tarea, el público objetivo, el formato y las restricciones de longitud?
- ¿Se proporcionan ejemplos de salida y una lista de comportamientos prohibidos?
- ¿Se han definido reglas claras de derivación a personas o de rechazo para temas sensibles y peticiones que se extralimitan?
- ¿Se evita incluir claves, direcciones internas y datos privados de usuarios en la entrada?
Gestión de errores y reintentos
- ¿Se distingue entre errores reintentables (tiempo de espera agotado, limitación de tasa) y no reintentables (entrada inválida, contenido prohibido)?
- ¿Los reintentos tienen un límite máximo y una estrategia de retroceso para no amplificar el coste?
- ¿Las peticiones que fallan tras los reintentos tienen una ruta de respaldo, en lugar de interrumpir el flujo principal?
Registros y observabilidad
- ¿Se registran el resumen de la entrada, el resultado de la salida, el tiempo de respuesta y el consumo de tokens de cada llamada?
- ¿Se conservan por separado las muestras fallidas para poder reproducirlas e iterar las instrucciones?
- ¿Se calculan métricas clave como el consumo medio de tokens, la tasa de fallos y la tasa de modificaciones manuales?
Evaluación de resultados e iteración
- ¿Se ha validado a pequeña escala con muestras reales antes del lanzamiento?
- ¿Existen métricas de calidad claras y una cadencia definida de muestreo manual?
- ¿Los cambios en las instrucciones tienen registro de versiones para poder revertirlos y compararlos?
Alineación con el flujo de negocio
- ¿Está claro el papel de la salida del modelo en el flujo de negocio: es una sugerencia, un borrador o un resultado que puede adoptarse directamente?
- ¿Qué etapas requieren confirmación humana y se han consolidado en el flujo?
- ¿Se ha confirmado si para este caso resulta más rentable usar reglas o una solución tradicional?
Trata esta lista como un umbral de lanzamiento, no como un documento de un solo uso. Cada vez que amplíes un nuevo caso de uso o ajustes las instrucciones, merece la pena revisar de nuevo los puntos correspondientes.
Artículos relacionados
Ver todos los artículos →-

Tutorial
Cómo llamar a hailuo-2.3-fast/image-to-video a través de la API de HiAPI: práctica con curl y Python
La primera solicitud ejecutable del nivel rápido y de bajo coste de imagen a vídeo: del ID del modelo a la descarga del MP4
-

Tutorial
Cómo llamar a hailuo-2.3/text-to-video mediante la API de HiAPI: curl, Python y ejemplos de solicitud ejecutables
-

Tutorial
Uso de Kandinsky 6.0 Pro texto a video en HiAPI: tutorial con curl y Python
Demostración práctica centrada en la solicitud: construir la llamada de prompt a clip de video, enviar la solicitud, sondear el estado de finalización y descargar el resultado