
Tutoriel
Cas d'usage concrets de gpt-6-luna : 5 usages à forte valeur et points d'intégration
Guide de mise en œuvre des modèles textuels pour les développeurs : du choix des scénarios aux appels API et à la maîtrise des coûts
Pourquoi utiliser gpt-6-luna pour valider des scénarios
Avant de choisir un modèle, choisissez le type de problème. gpt-6-luna est un modèle de sortie texte fourni par OpenAI, facturé au token, avec l'entrée et la sortie toutes deux comptabilisées. Cela signifie qu'il est naturellement adapté aux tâches « texte en entrée, texte en sortie » : compréhension, synthèse, réécriture, génération, discrimination, sans assumer de responsabilités multimodales comme l'image ou l'audio. Confier une tâche inadaptée à un modèle textuel n'est généralement pas une question de puissance du modèle, mais plutôt que le problème lui-même ne devrait pas être résolu par lui.
Comme point de départ pour valider des scénarios, il présente trois avantages concrets. Premièrement, l'interface est uniforme : une requête est constituée d'une liste de messages, et côté ingénierie il suffit de se concentrer sur l'organisation de l'entrée et l'analyse de la sortie, sans introduire un SDK différent pour chaque scénario. Deuxièmement, la facturation est prévisible : la tarification au token lie directement le coût à la longueur du texte, ce qui permet dès la phase de validation d'estimer grossièrement le budget à partir du volume d'appels et de la longueur moyenne, sans attendre la facture pour découvrir un dépassement. Troisièmement, les frontières de la tâche sont claires : la capacité purement textuelle rend les indicateurs d'évaluation faciles à définir — taux de précision, taux de conformité au format, taux de modification manuelle, tous quantifiables.
L'ordre correct en phase de validation est le suivant : d'abord faire tourner une chaîne complète avec un petit nombre d'échantillons réels pour confirmer la qualité et la stabilité du format ; puis augmenter progressivement le volume en observant la courbe de consommation de tokens ; enfin seulement discuter de l'extension à davantage de lignes métier. Faire l'inverse — intégrer à grande échelle d'abord, puis revenir compléter l'évaluation de qualité — coûte souvent plus cher en reprises.
Il faut aussi savoir ce pour quoi il n'est pas adapté. Pour les tâches nécessitant des calculs déterministes en temps réel, une validation de règles à cohérence forte, ou une comparaison mot à mot de documents très longs, un moteur de règles ou une solution de recherche traditionnelle est plus rentable ; la valeur du modèle réside dans le traitement d'entrées floues, ouvertes, nécessitant une compréhension sémantique. Le critère de décision est simple : si le même input est confié à deux personnes différentes, leurs sorties raisonnables différeraient-elles ? S'il y a une différence, la tâche nécessite une capacité sémantique ; s'il n'y en a pas, écrire des règles est plus économique.
Scénario un : génération de contenu et rédaction en masse
La rédaction en masse est le scénario le plus direct, et aussi celui où l'on tombe le plus facilement dans le piège. Son cœur n'est pas « faire écrire le modèle correctement », mais « faire en sorte que cent sorties respectent toutes le même ensemble de règles ».
Entrée fixée par un gabarit
Organisez chaque appel en une structure fixe : description de la tâche, lecteur cible, contraintes de ton et de longueur, éléments obligatoires, formulations interdites, et un exemple de référence. L'avantage du gabarit est la reproductibilité du comportement — sur un même lot de données, une nouvelle exécution ne fait pas dériver le style de sortie. Une entrée sous forme de champs facilite aussi les comparaisons A/B ultérieures, par exemple en ne modifiant que la description du ton pour observer les différences de sortie.
Validation programmatique de la sortie
Ne supposez pas que le modèle respectera toujours le format. Validez immédiatement après génération : la longueur est-elle dans l'intervalle, y a-t-il des mots interdits, les éléments obligatoires sont-ils présents, les champs structurés sont-ils analysables. Les éléments en échec passent par une nouvelle tentative ou sont dégradés vers un modèle de secours, plutôt que d'être directement stockés. Intégrer les résultats de validation aux indicateurs de qualité est plus fiable qu'un contrôle manuel par échantillonnage.
Synthèse et réécriture conçues séparément
Pour les tâches de synthèse, précisez « pour qui, quelle longueur, quelles informations conserver ». Indiquez clairement dans l'instruction de préserver le sens d'origine, de ne pas ajouter de faits absents du texte source, et effectuez une comparaison factuelle simple lors de la validation. Pour les tâches de réécriture, précisez les limites de ce qui peut être modifié : les termes, noms de marque et chiffres ne sont généralement pas modifiables, et doivent être fournis sous forme de liste dans l'entrée, puis vérifiés point par point après la sortie.
Processus par lots contrôlable
Pour l'écriture en masse, privilégiez un traitement par fragments, en enregistrant pour chaque fragment le nombre de succès et d'échecs. Conservez séparément le texte original et la cause d'erreur des éléments en échec, pour faciliter une nouvelle tentative groupée. Une fois le lot terminé, calculez une fois la consommation moyenne de tokens et le taux de modification manuelle ; ces deux chiffres déterminent si cette chaîne mérite d'être conservée à long terme.
Scénario deux : service client et assistant de questions-réponses
La difficulté du service client n'a jamais été la capacité du modèle, mais la gestion des limites. Un assistant qui répond brillamment mais outrepasse ses droits est plus risqué qu'un assistant qui répond de manière prudente.
Organisation du contexte
Placez ensemble dans l'entrée l'historique de conversation, le contexte lié à l'identité de l'utilisateur et les extraits de connaissances métier, mais faites des choix. Plus l'historique est long, plus la consommation de tokens est élevée, et les contenus anciens non pertinents diluent le point focal de la question actuelle. En pratique, on peut conserver les dernières tours de conversation et compresser les plus anciens en une phrase de synthèse ; les extraits de connaissances ne sont injectés qu'en petit nombre après recherche, plutôt que de charger toute la base.
Limites de réponse
Dans les instructions système, précisez trois catégories de comportement : ce à quoi on peut répondre, ce qui doit obligatoirement être transféré à un humain, ce qu'il ne faut absolument pas promettre. Les sujets hautement sensibles comme les remboursements, les indemnités, les conseils juridiques et médicaux sont directement paramétrés comme transfert à un humain, sans laisser le modèle improviser. Exigez également que le modèle dise clairement qu'il ne sait pas lorsque les informations sont insuffisantes, plutôt que de compléter une réponse qui semble plausible.
Repli humain et traçabilité
Chaque réponse générée par le modèle doit enregistrer un résumé de l'entrée, la version de sortie et les extraits de connaissances utilisés, pour faciliter le post-mortem. Définissez des conditions de déclenchement claires pour le repli : confiance faible du modèle, présence de mots-clés sensibles, demandes successives non résolues de l'utilisateur. Le repli n'est pas un échec, c'est une partie de la conception.
Évaluation de l'efficacité
En début de mise en production, évaluez par contrôle manuel par échantillonnage le taux de précision des réponses et le taux de transfert à un humain ; une fois stabilisé, introduisez des indicateurs automatiques. Ce qu'il faut vraiment surveiller, ce sont deux types d'erreurs : inventer des informations inexistantes, et ne pas transférer à un humain alors qu'il le faudrait. La première nuit à la confiance, la seconde amplifie le risque.
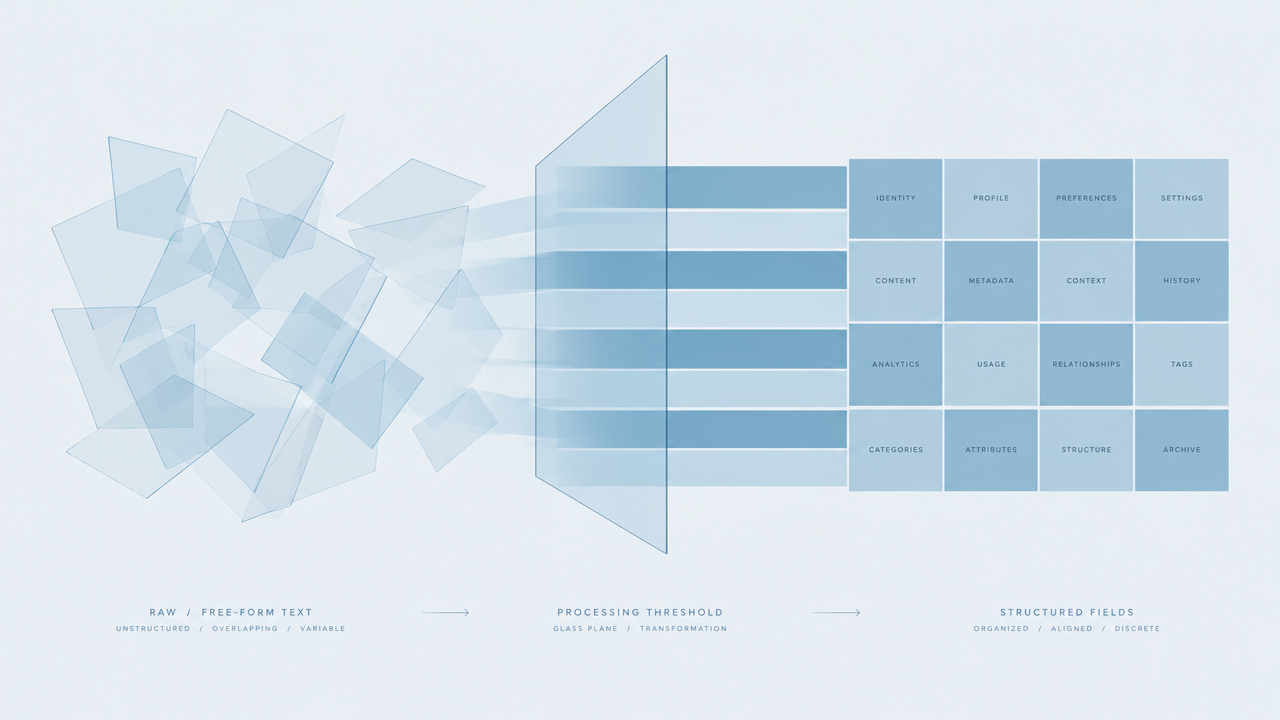
Scénario trois : extraction d'informations structurées
Convertir du texte libre en champs structurés est un usage au rapport coût-bénéfice très élevé : l'entrée est du langage naturel désordonné, la sortie est des paires clé-valeur directement stockables.
Définir d'abord le schéma cible
Avant d'écrire les instructions, fixez la structure cible : noms de champs, types, obligatoires ou non, plages de valeurs, éléments d'énumération. Plus le schéma est précis, plus la sortie est stable. En matière de conception de champs, mieux vaut découper finement plutôt que de mettre plusieurs sémantiques dans un champ texte libre, sinon la validation ultérieure devient impossible.
Contraintes de format de sortie
Exigez que le modèle ne produise que le résultat structuré, sans texte explicatif. Fournissez également un exemple de sortie complet ; l'exemple est plus efficace que la description des règles. Pour les champs d'énumération, listez toutes les valeurs légales dans l'instruction et précisez quel espace réservé utiliser en cas d'impossibilité de jugement.
Validation et tolérance aux erreurs
Effectuez immédiatement une validation programmatique après réception de la sortie : peut-on l'analyser, les champs obligatoires manquent-ils, les valeurs d'énumération sont-elles légales, les valeurs numériques sont-elles dans une plage raisonnable. Ne supprimez pas silencieusement les échantillons en échec d'analyse ; enregistrez l'entrée originale et la sortie du modèle pour itérer sur les instructions. Pour les champs critiques, vous pouvez concevoir une double validation : soumettre ensemble le résultat d'extraction et l'extrait original au modèle pour une confirmation de cohérence.
Traitement des textes longs
Pour les documents dépassant la longueur de traitement en une fois, découpez-les selon les frontières sémantiques avant extraction, puis fusionnez les résultats. Lors du découpage, veillez à ne pas séparer les informations d'un champ entre deux fragments. Lors de la fusion, marquez les champs en conflit et soumettez-les à un arbitrage humain.
Scénario quatre : assistance au code et à la documentation
L'assistance au développement est un scénario naturel pour les modèles textuels, mais il faut l'utiliser au bon endroit.
Explication de code et lecture d'initiation
Face à une base de code inconnue, confiez au modèle le contexte d'un fichier ou d'une fonction, demandez-lui d'expliquer la responsabilité, les entrées-sorties et les effets de bord potentiels. Cet usage a un coût faible et un bénéfice direct, adapté à l'intégration des nouveaux venus et au défrichage de systèmes hérités. L'essentiel est de contrôler la portée du contexte : ne donnez qu'une unité compréhensible de manière autonome à la fois, sans charger tout le dépôt.
Génération de documentation
Générez la documentation d'interface à partir des signatures de fonctions, des commentaires et des exemples d'appel, puis faites-la relire par un humain. Dans l'instruction, précisez le lecteur cible et le format de la documentation, et insistez sur l'interdiction d'inventer le comportement des paramètres. La documentation générée doit être revue avec le code, et non publiée directement.
Commentaires de revue et brouillons de tests
Demander au modèle d'établir une liste de problèmes potentiels sur les fragments modifiés est un bon complément, mais il ne remplace pas la revue humaine. En pratique, positionnez-le comme un « premier passage », à charge pour l'humain de décider quels commentaires méritent d'être suivis. Il en va de même pour les cas de test : les cas générés par le modèle couvrent généralement les chemins courants, et les conditions limites nécessitent toujours un jugement d'ingénieur.
Points d'attention
Ne collez pas de vraies clés, d'adresses internes ou de données personnelles d'utilisateurs dans le prompt. Pour l'usage des API, les numéros de version et les éléments de configuration fournis par le modèle, vérifiez systématiquement dans la documentation officielle — ces détails sont les plus susceptibles de contenir des inventions plausibles mais inexistantes.
Scénario cinq : assistance à l'analyse et à la décision
Les tâches d'analyse légère conviennent aux modèles textuels : organiser de grands volumes de textes épars en conclusions lisibles fait gagner du temps de lecture, sans remplacer le jugement humain.
Catégorisation des commentaires et extraction des points clés
Les retours utilisateurs, les comptes rendus d'entretiens et le contenu des tickets sont des entrées typiques. La méthode consiste à définir d'abord un système de classification, à demander au modèle de classer chaque texte dans une catégorie existante avec une phrase de justification, puis à extraire les points clés de chaque catégorie. Le système de classification doit être défini à l'avance ; une classification ouverte « au hasard » donnera des résultats impossibles à agréger.
Analyse comparative
Présentez côte à côte les descriptions de plusieurs solutions ou produits, demandez au modèle de les comparer point par point selon des dimensions uniformes et d'indiquer la source de l'information. La sortie doit être une comparaison dimensionnée, et non un jugement général de supériorité. Pour les jugements pour lesquels le modèle ne trouve pas de base dans l'entrée, exigez qu'il les marque clairement comme suppositions.
Limites à reconnaître
Les modèles textuels ne sont pas doués pour les statistiques précises et le raisonnement numérique, et ne connaissent pas les faits extérieurs à l'entrée. Tout jugement portant sur des quantités, des proportions ou des tendances doit être calculé séparément à partir de données structurées ; le modèle ne fait qu'expliquer et exprimer. Pour les décisions à haut risque, la sortie ne peut servir que de matériau de référence, et non de conclusion.
Méthode d'évaluation
L'évaluation des tâches analytiques est principalement humaine : prélevez une partie des sorties, vérifiez si la classification est raisonnable, si les points clés manquent des informations critiques, s'il y a des inférences excessives. Réinjecter les problèmes constatés dans les instructions est la méthode d'optimisation la plus efficace.
Stratégies de maîtrise des coûts sous tarification au token
La tarification au token signifie que le coût est directement lié à la longueur du texte ; maîtriser les coûts revient essentiellement à maîtriser l'ampleur de l'entrée et de la sortie.
Estimer d'abord le volume d'appels
L'estimation des coûts part de trois chiffres : nombre d'appels quotidiens moyens, tokens d'entrée moyens, tokens de sortie moyens. Faites tourner un cycle avec des échantillons réels pour obtenir la distribution réelle, plutôt que de la remplir au ressenti. La distribution est souvent plus significative que la moyenne — si quelques requêtes très longues représentent la majeure partie de la consommation, l'optimisation doit porter sur elles en priorité.
Compresser l'entrée
L'entrée est généralement le poste de coût principal. Les moyens possibles incluent : supprimer les descriptions redondantes du gabarit, réduire les exemples au strict nécessaire, remplacer un long historique par une synthèse, n'injecter que les extraits pertinents après recherche. Pour chaque élément, le critère de décision doit être « la qualité de sortie baisse-t-elle après suppression », plutôt qu'une réduction à tout prix.
Contraindre la sortie
La longueur de la sortie est également contrôlable. Dans l'instruction, précisez une limite de mots ou de nombre d'éléments, exigez que la conclusion vienne en premier, sans répéter le contenu de l'entrée ni produire de formules de politesse. Pour les tâches structurées, exiger uniquement les valeurs de champs permet de réduire significativement les tokens inutiles.
Cache et dégradation
Mettez en cache les résultats des requêtes à forte redondance, par exemple des demandes identiques de réécriture de description de produit ; en cas de succès du cache, renvoyez directement le résultat. Concevez des chemins de dégradation pour les chaînes non critiques : en cas d'indisponibilité du modèle, revenez au gabarit ou à la solution à base de règles, pour garantir la continuité du flux principal. Fixez également des limites pour les requêtes uniques et les appels quotidiens, afin d'éviter que le trafic anormal amplifie la consommation.
Observation continue
Après la mise en production, suivez la consommation moyenne de tokens, le taux de nouvelles tentatives en échec et le taux de modification manuelle. La nouvelle tentative est elle-même un coût ; une sortie instable signifie souvent que l'instruction doit être corrigée, plutôt que de réessayer plusieurs fois. Pour les prix en temps réel et les détails de facturation actuels, référez-vous au panneau de tarification du site.
Liste de contrôle pour l'intégration et la mise en production
Confirmez point par point les éléments suivants avant la mise en production, ce qui permet d'éviter la plupart des problèmes courants.
Frontières entrée-sortie
- L'instruction précise-t-elle la tâche, le lecteur cible, le format et les contraintes de longueur
- Un exemple de sortie et une liste de comportements interdits sont-ils fournis
- Des règles claires de transfert à un humain ou de refus de réponse sont-elles définies pour les sujets sensibles et les demandes hors périmètre
- Évite-t-on de transporter clés, adresses internes et données personnelles d'utilisateurs dans l'entrée
Gestion des erreurs et nouvelles tentatives
- Distingue-t-on les erreurs réessayables (timeout, limitation de débit) des erreurs non réessayables (entrée illégale, contenu non conforme)
- Les nouvelles tentatives ont-elles une limite de nombre et une stratégie de backoff, pour éviter d'amplifier les coûts
- Les requêtes encore en échec après nouvelle tentative ont-elles un chemin de repli, plutôt que d'interrompre le flux principal
Journaux et observabilité
- Enregistre-t-on pour chaque appel le résumé de l'entrée, le résultat de sortie, le temps d'exécution et la consommation de tokens
- Les échantillons en échec sont-ils conservés séparément, pour faciliter la reproduction et l'itération des instructions
- Calcule-t-on des indicateurs clés comme la consommation moyenne de tokens, le taux d'échec et le taux de modification manuelle
Évaluation de l'efficacité et itération
- A-t-on effectué une validation à petite échelle avec des échantillons réels avant la mise en production
- Dispose-t-on d'indicateurs de qualité clairs et d'un rythme de contrôle manuel par échantillonnage
- Les modifications d'instructions ont-elles un historique de versions, pour faciliter le retour arrière et la comparaison
Alignement avec les processus métier
- La position de la sortie du modèle dans le processus métier est-elle claire : suggestion, brouillon, ou résultat directement utilisable
- Quelles étapes doivent obligatoirement être confirmées par un humain, et cela est-il formalisé dans le processus
- A-t-on confirmé si ce scénario est plus rentable avec des règles ou une solution traditionnelle
Considérez cette liste comme un seuil de mise en production, et non comme un document à usage unique. Chaque extension à un nouveau scénario, chaque ajustement d'instruction mérite une nouvelle relecture des éléments concernés.
Articles similaires
Voir tous les articles →-

Tutoriel
Comment appeler hailuo-2.3-fast/image-to-video via l'API HiAPI : curl et Python en pratique
La première requête exploitable du palier image-vers-vidéo rapide et économique — de l'ID du modèle au téléchargement du MP4
-

Tutoriel
Comment appeler hailuo-2.3/text-to-video via l'API HiAPI : curl, Python et exemples de requêtes exécutables
-

Tutoriel
Utiliser Kandinsky 6.0 Pro texte-vers-vidéo sur HiAPI : tutoriel curl et Python
Démonstration pratique axée sur la requête : construire l'appel du prompt au clip vidéo, soumettre la requête, interroger l'état d'achèvement et télécharger le résultat