
Tutorial
gpt-6-luna 应用场景实战:5 个高价值用法与接入要点
面向开发者的文本模型落地指南:从场景选型到调用与成本控制
为什么用 gpt-6-luna 做场景验证
选模型之前先选问题类型。gpt-6-luna 是 OpenAI 提供的文本输出模型,按 token 计价,输入与输出都计入消耗。这意味着它天生适合「文本进、文本出」的任务:理解、归纳、改写、生成、判别,而不承担图像、音频等多模态职责。把不合适的任务塞给文本模型,通常不是模型不够强,而是问题本身不该由它解决。
作为场景验证的起点,它有三个现实优势。第一,接口形态统一:一次请求由消息列表构成,工程侧只需要关注输入组织与输出解析,不需要为每个场景引入不同 SDK。第二,计费口径可预测:token 计价让成本与文本长度直接挂钩,验证阶段就能按调用量和平均长度粗算预算,而不必等到账单出来才发现超支。第三,任务边界清晰:纯文本能力让评估指标容易定义——准确率、格式合规率、人工修改率,都是可以量化的。
验证阶段的正确顺序是:先用少量真实样本跑通一条链路,确认输出质量与格式稳定性;再逐步放量,观察 token 消耗曲线;最后才讨论是否扩展到更多业务线。反过来做——先大规模接入、再回头补质量评估——往往会在返工时付出更高代价。
也要清楚它不适合什么。需要实时确定性计算、强一致规则校验、超长文档全文逐字比对的任务,用规则引擎或传统检索方案更划算;模型的价值在于处理模糊、开放、需要语义理解的输入。判断标准很简单:如果把同一个输入交给两个不同的人,他们给出的合理输出是否会有差异?有差异,说明任务需要语义能力;没有差异,说明写规则更省。
Szenario 1: Inhaltsgenerierung und Massentexte
Massentexte sind das direkteste und zugleich fehleranfälligste Szenario. Der Kern liegt nicht darin, „das Modell gut schreiben zu lassen“, sondern darin, „einhundert Ausgaben an dieselbe Spezifikation zu binden“.
Eingaben mit Templates fixieren
Organisiere jeden Aufruf in einer festen Struktur: Aufgabenbeschreibung, Zielgruppe, Ton- und Längenvorgaben, zwingend enthaltene Elemente, verbotene Formulierungen sowie ein Referenzbeispiel. Die Vorlage macht das Verhalten reproduzierbar – bei einem erneuten Lauf derselben Datenmenge driftet der Ausgabestil nicht. Feldbasierte Eingaben erleichtern zudem spätere A/B-Vergleiche, etwa nur die Tonbeschreibung ändern und die Ausgabedifferenz beobachten.
Ausgaben programmatisch prüfen
Gehe nicht davon aus, dass das Modell das Format zwingend einhält. Prüfe direkt nach der Generierung: Liegt die Länge im Bereich, sind verbotene Wörter enthalten, sind Pflichtelemente vollständig, sind strukturierte Felder parsbar? Fehlgeschlagene Einträge gehen in einen Retry oder werden auf ein Template-Fallback herabgestuft, statt direkt in die Datenbank zu wandern. Zähle die Prüfergebnisse in die Qualitätskennzahlen ein – das ist zuverlässiger als manuelle Stichproben.
Zusammenfassung und Umschreibung separat gestalten
Bei Zusammenfassungsaufgaben muss klar sein: „für wen, wie lang, welche Informationen bleiben erhalten“. In der Anweisung ausdrücklich festhalten, den Originalinhalt zu wahren und keine Fakten hinzuzufügen, die nicht im Original stehen; in der Prüfung einen einfachen Faktenabgleich durchführen. Bei Umschreibungsaufgaben die Grenzen des Änderbaren klarziehen: Fachbegriffe, Markennamen und Zahlen dürfen in der Regel nicht verändert werden; diese als Liste in die Eingabe geben und nach der Ausgabe Punkt für Punkt abgleichen.
Batch-Prozesse kontrollierbar halten
Für Batch-Schreibvorgänge empfiehlt sich eine Aufteilung in Shards, wobei pro Shard Erfolgs- und Fehlerzahlen erfasst werden. Fehlgeschlagene Einträge mit Originaltext und Fehlerursache separat ablegen, um sie gebündelt erneut zu versuchen. Nach Abschluss des gesamten Batches einmal den durchschnittlichen Token-Verbrauch und die manuelle Änderungsrate ermitteln – diese beiden Zahlen entscheiden, ob sich diese Kette langfristig lohnt.
Szenario 2: Kundenservice- und Frage-Antwort-Assistent
Die Schwierigkeit im Kundenservice liegt nie in der Modellfähigkeit, sondern im Grenzmanagement. Ein Assistent, der schön antwortet, aber seine Befugnisse überschreitet, birgt ein größeres Risiko als ein konservativ antwortender Assistent.
Kontextorganisation
Gesprächsverlauf, nutzerbezogener Hintergrund und Wissensfragmente aus dem Geschäft gemeinsam in die Eingabe geben, aber mit Bedacht auswählen. Je länger der Verlauf, desto höher der Token-Verbrauch, und frühe irrelevante Inhalte verwässern den Fokus der aktuellen Frage. In der Praxis die letzten Runden behalten und ältere Inhalte zu einer Zusammenfassung verdichten; Wissensfragmente nur nach der Retrieval-Phase in geringer Menge einspielen, nicht die ganze Datenbank hineinpressen.
Antwortgrenzen
In den Systemanweisungen drei Verhaltensklassen klar definieren: was beantwortet werden darf, was zwingend an einen Menschen übergeben werden muss, was auf keinen Fall zugesagt werden darf. Hochsensible Themen wie Erstattungen, Entschädigungen sowie rechtliche und medizinische Beratung direkt als Übergabe an einen Menschen festlegen, nicht dem Modell zur freien Entfaltung überlassen. Zudem vom Modell verlangen, bei unzureichenden Informationen klar zu sagen, dass es etwas nicht weiß, statt eine plausibel klingende Antwort zu ergänzen.
Menschliches Fallback und Nachvollziehbarkeit
Für jede vom Modell generierte Antwort sollten Eingabezusammenfassung, Ausgabeversion und getroffene Wissensfragmente protokolliert werden, um später nachvollziehen zu können. Klare Auslösebedingungen für das Fallback festlegen: geringe Modellkonfidenz, sensible Schlüsselwörter, wiederholte Nachfragen ohne Lösung. Ein Fallback ist kein Fehlschlag, sondern Teil des Designs.
Wirkungsbewertung
In der Anfangsphase die Antwortgenauigkeit und die Übergaberate an Menschen per manueller Stichprobe bewerten, nach Stabilisierung automatische Kennzahlen einführen. Wirklich im Blick behalten muss man zwei Fehlerarten: das Erfinden nicht existierender Informationen und das Ausbleiben einer gebotenen Übergabe an Menschen. Ersteres schadet dem Vertrauen, Letzteres vergrößert das Risiko.
Szenario 3: Extraktion strukturierter Informationen
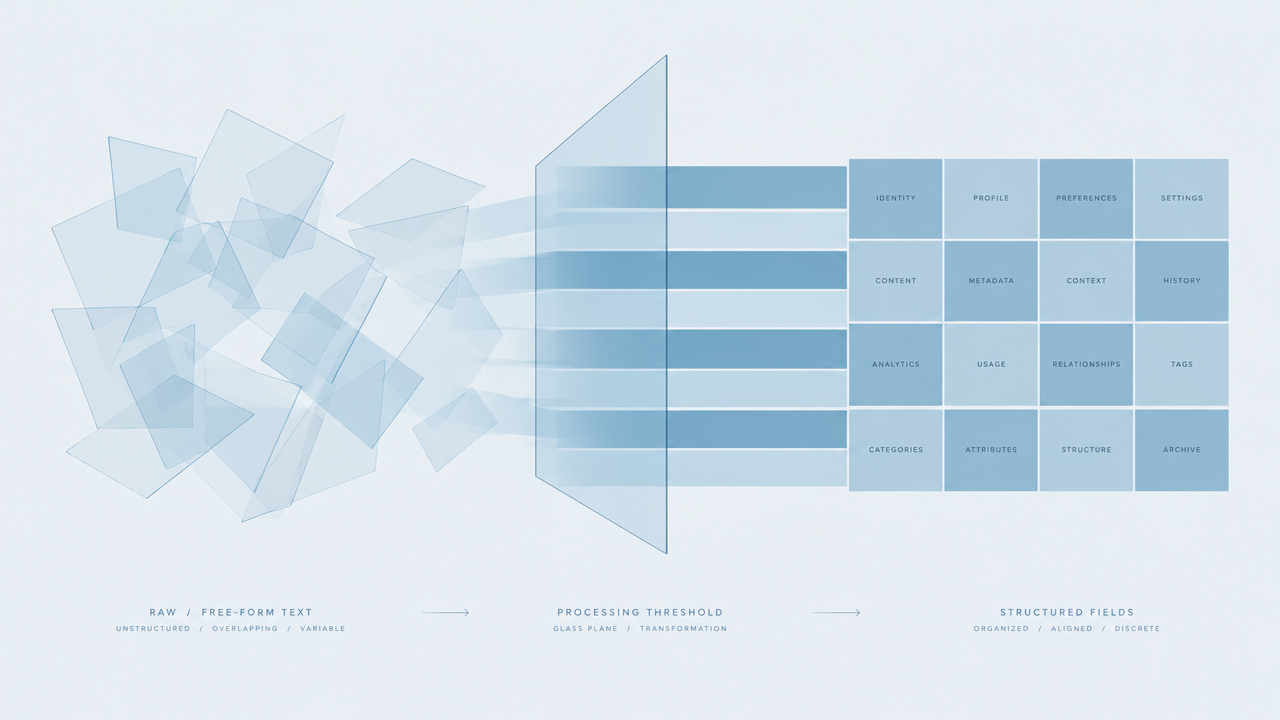
Freitext in strukturierte Felder zu überführen, ist eine Nutzung mit sehr hohem Aufwand-Nutzen-Verhältnis: Die Eingabe ist ungeordnete natürliche Sprache, die Ausgabe direkt datenbankfähige Schlüssel-Wert-Paare.
Zuerst das Ziel-Schema definieren
Bevor man die Anweisung schreibt, die Zielstruktur festlegen: Feldnamen, Typen, ob Pflichtfeld, Wertebereiche, Enum-Werte. Je klarer das Schema, desto stabiler die Ausgabe. Bei der Feldgestaltung lieber feiner aufteilen, als mehrere Semantiken in ein Freitextfeld zu packen, sonst gibt es später keinen Ansatzpunkt für die Prüfung.
Ausgabeformat einschränken
Vom Modell verlangen, ausschließlich das strukturierte Ergebnis ohne erklärenden Text auszugeben. Zugleich ein vollständiges Ausgabebeispiel mitgeben – Beispiele wirken besser als Regelbeschreibungen. Bei Enum-Feldern in der Anweisung alle zulässigen Werte auflisten und angeben, welcher Platzhalter bei Nichtbestimmbarkeit zu verwenden ist.
Prüfung und Fehlertoleranz
Nach Erhalt der Ausgabe sofort programmatisch prüfen: Ist sie parsbar, fehlen Pflichtfelder, sind Enum-Werte gültig, liegen Zahlen in einem plausiblen Bereich? Fehlgeschlagene Parses nicht stillschweigend verwerfen, sondern Originaleingabe und Modellausgabe festhalten, um die Anweisung zu iterieren. Für kritische Felder eine Zweitprüfung vorsehen: Extraktionsergebnis zusammen mit dem Originaltextabschnitt dem Modell zur Konsistenzbestätigung übergeben.
Umgang mit langen Texten
Dokumente, die die Verarbeitungslänge einer Anfrage überschreiten, an semantischen Grenzen aufteilen, dann extrahieren und die Ergebnisse zusammenführen. Beim Aufteilen darauf achten, dass die Information eines Feldes nicht auf zwei Fragmente verteilt wird. In der Zusammenführungsphase Konfliktfelder markieren und menschlicher Entscheidung überlassen.
Szenario 4: Code- und Dokumentationsassistenz
Entwicklungsassistenz ist ein natürliches Szenario für Textmodelle, muss aber an der richtigen Stelle eingesetzt werden.
Code-Erklärung und Einstiegslektüre
Bei unbekannten Codebasen den Kontext einer einzelnen Datei oder Funktion an das Modell geben und es bitten, Aufgaben, Ein- und Ausgaben sowie mögliche Nebenwirkungen zu erläutern. Diese Nutzung ist kostengünstig und unmittelbar nützlich, geeignet für den Einstieg neuer Kolleginnen und die Aufarbeitung von Legacy-Systemen. Entscheidend ist, den Kontextbereich zu begrenzen: immer nur eine eigenständig verständliche Einheit geben, nicht das ganze Repository hineinpressen.
Dokumentationserzeugung
Aus Funktionssignaturen, Kommentaren und Aufrufbeispielen Schnittstellendokumentation erzeugen und anschließend manuell gegenlesen. In der Anweisung Zielgruppe und Format der Dokumentation klar benennen und betonen, dass Parameterverhalten nicht erfunden werden darf. Die erzeugte Dokumentation muss gemeinsam mit dem Code geprüft werden, nicht direkt veröffentlicht.
Review-Hinweise und Testentwürfe
Das Modell eine Liste potenzieller Probleme zu geänderten Codeabschnitten erstellen zu lassen, ist eine gute Ergänzung, ersetzt aber kein menschliches Review. In der Praxis als „einmal vorab durchsehen“ positionieren und vom Menschen entscheiden lassen, welche Hinweise es wert sind, verfolgt zu werden. Analog bei Testfällen: Vom Modell erzeugte Fälle decken meist die üblichen Pfade ab, Randbedingungen erfordern weiterhin technisches Urteilsvermögen.
Hinweise zur Beachtung
Keine echten Schlüssel, internen Adressen oder personenbezogenen Nutzerdaten in den Prompt einfügen. Bei vom Modell genannten API-Nutzungen, Versionsnummern und Konfigurationsoptionen stets die offizielle Dokumentation gegenprüfen – gerade bei solchen Details treten am häufigsten plausibel klingende, aber nicht existierende Erfindungen auf.
Szenario 5: Analyse- und Entscheidungsunterstützung
Leichte Analyseaufgaben eignen sich für Textmodelle: Große Mengen verstreuten Textes zu lesbaren Schlussfolgerungen verdichten – das spart Lesezeit, ersetzt aber nicht das Urteil des Menschen.
Kommentar-Kategorisierung und Kernpunkt-Extraktion
Nutzerfeedback, Interviewprotokolle und Ticketinhalte sind typische Eingaben. Vorgehen: Zuerst ein Kategoriensystem definieren, das Modell jeden Text einer bestehenden Kategorie zuordnen und eine Begründung in einem Satz liefern lassen; dann für jede Kategorie die Kernpunkte herausarbeiten. Das Kategoriensystem muss vorab feststehen, ein offenes „einfach einordnen“ führt zu nicht aggregierbaren Ergebnissen.
Vergleichsanalyse
Beschreibungen mehrerer Lösungen oder Produkte nebeneinander geben und das Modell bitten, sie entlang einheitlicher Dimensionen Punkt für Punkt zu vergleichen und die Informationsquelle zu kennzeichnen. Die Ausgabe sollte eine dimensionierte Gegenüberstellung sein, keine pauschale Vor- und Nachteilbewertung. Bei Urteilen, für die das Modell in der Eingabe keine Grundlage findet, soll es diese ausdrücklich als Vermutung kennzeichnen.
Unvermeidliche Grenzen
Textmodelle sind schwach bei präziser Statistik und numerischem Schließen und kennen keine Fakten außerhalb der Eingabe. Bei allem, was Mengen, Anteile und Trends betrifft, sollte die Berechnung separat auf Basis strukturierter Daten erfolgen – das Modell übernimmt nur Erklärung und Darstellung. Bei risikoreichen Entscheidungen kann die Ausgabe nur Referenzmaterial sein, nicht Schlussfolgerung.
Bewertungsmethode
Analyseaufgaben werden überwiegend manuell bewertet: einen Teil der Ausgaben herausnehmen, prüfen, ob die Kategorisierung sinnvoll ist, ob Kernpunkte Schlüsselinformationen auslassen, ob übermäßig inferiert wurde. Die gefundenen Probleme in die Anweisung zurückschreiben – das ist die wirksamste Optimierung.
Kostenkontrollstrategien unter Token-Abrechnung
Abrechnung nach Token bedeutet, dass die Kosten direkt mit der Textlänge zusammenhängen; Kostenkontrolle ist im Kern die Kontrolle des Umfangs von Eingabe und Ausgabe.
Zuerst das Aufrufvolumen schätzen
Die Kostenschätzung beginnt bei drei Zahlen: Aufrufe pro Tag im Durchschnitt, durchschnittliche Eingabe-Token, durchschnittliche Ausgabe-Token. Mit echten Stichproben einen Durchlauf machen und die tatsächliche Verteilung ermitteln, statt aus dem Bauch heraus zu schätzen. Die Verteilung ist oft aussagekräftiger als der Mittelwert – wenn wenige überlange Anfragen den Großteil des Verbrauchs ausmachen, sollte die Optimierung genau dort ansetzen.
Eingaben komprimieren
Die Eingabe ist oft der Kostentreiber. Machbare Maßnahmen: redundante Erläuterungen im Template streichen, Beispiele auf das Nötige reduzieren, lange Verläufe durch Zusammenfassungen ersetzen, nach der Retrieval-Phase nur relevante Fragmente einspielen. Jede Maßnahme am Maßstab „sinkt die Ausgabequalität nach dem Weglassen?“ messen, statt blind zu kürzen.
Ausgaben einschränken
Auch die Ausgabelänge ist kontrollierbar. In der Anweisung eine Obergrenze für Zeichen oder Einträge festlegen, Schlussfolgerungen zuerst, keine Wiederholung der Eingabe, keine Floskeln verlangen. Bei strukturierten Aufgaben nur Feldwerte ausgeben lassen – das reduziert unnötige Token deutlich.
Caching und Degradierung
Bei stark wiederholenden Anfragen Ergebnisse cachen, etwa identische Anforderungen zur Umschreibung von Produktbeschreibungen: Bei Cache-Treffer direkt zurückgeben. Für nicht-kritische Ketten einen Degradierungspfad vorsehen: Bei Modellausfall auf Template- oder Regelverfahren zurückfallen, damit der Hauptprozess nicht abbricht. Zugleich Obergrenzen für Einzelaufrufe und Tagesaufrufe setzen, um Kostenausweitung durch abnormale Last zu verhindern.
Kontinuierliche Beobachtung
Nach dem Start durchschnittlichen Token-Verbrauch, Fehler-Wiederholungsrate und manuelle Änderungsrate verfolgen. Wiederholungen kosten selbst Geld; instabile Ausgaben bedeuten meist, dass die Anweisung überarbeitet werden muss, statt es einfach öfter zu versuchen. Für aktuelle Echtzeitpreise und Abrechnungsdetails gilt das Preispanel der Website als maßgeblich.
Checkliste für die Integration in die Praxis
Vor dem Start die folgenden Punkte einzeln bestätigen – das vermeidet die meisten häufigen Probleme.
Grenzen von Eingabe und Ausgabe
- Sind in der Anweisung Aufgabe, Zielgruppe, Format und Längenvorgaben klar festgelegt?
- Sind Ausgabebeispiele und eine Liste verbotener Verhaltensweisen vorhanden?
- Sind für sensible Themen und befugnisüberschreitende Anfragen klare Regeln zur Übergabe an Menschen oder zur Ablehnung definiert?
- Ist vermieden, dass Eingaben Schlüssel, interne Adressen und personenbezogene Daten enthalten?
Fehlerbehandlung und Wiederholungen
- Sind wiederholbare Fehler (Timeout, Rate-Limiting) und nicht wiederholbare Fehler (ungültige Eingabe, Inhaltsverstoß) unterschieden?
- Gibt es für Wiederholungen eine Obergrenze und eine Backoff-Strategie, um Kostenausweitung zu vermeiden?
- Gibt es für Anfragen, die auch nach Wiederholung fehlschlagen, einen Fallback-Pfad, statt den Hauptprozess abzubrechen?
Protokollierung und Beobachtbarkeit
- Sind für jeden Aufruf Eingabezusammenfassung, Ergebnis, Dauer und Token-Verbrauch protokolliert?
- Werden fehlgeschlagene Stichproben separat aufbewahrt, um sie zu reproduzieren und die Anweisung zu iterieren?
- Sind Kennzahlen wie durchschnittlicher Token-Verbrauch, Fehlerrate und manuelle Änderungsrate erhoben?
Wirkungsbewertung und Iteration
- Wurde vor dem Start eine kleine Validierung mit echten Stichproben durchgeführt?
- Gibt es klare Qualitätskennzahlen und einen Rhythmus für manuelle Stichproben?
- Gibt es eine Versionshistorie für Anweisungsänderungen, um Rollback und Vergleich zu ermöglichen?
Ausrichtung an Geschäftsprozessen
- Ist die Position der Modellausgabe im Geschäftsprozess klar: Empfehlung, Entwurf oder direkt verwendbares Ergebnis?
- Welche Schritte müssen von Menschen bestätigt werden, und ist das im Prozess verankert?
- Ist bestätigt, ob für dieses Szenario Regeln oder klassische Verfahren günstiger wären?
Behandle diese Checkliste als Startschwelle, nicht als einmaliges Dokument. Bei jeder Erweiterung um ein neues Szenario und bei jeder Anpassung einer Anweisung lohnt es sich, die relevanten Punkte erneut durchzugehen.
Ähnliche Artikel
Alle Artikel ansehen →-

Tutorial
So rufen Sie hailuo-2.3-fast/image-to-video über die HiAPI API auf: curl und Python in der Praxis
Die erste lauffähige Anfrage für die schnelle, kostengünstige Bild-zu-Video-Stufe – von der Modell-ID bis zum heruntergeladenen MP4
-

Tutorial
So rufen Sie hailuo-2.3/text-to-video über die HiAPI API auf: curl, Python und lauffähige Anfragebeispiele
-

Tutorial
Kandinsky 6.0 Pro Text-zu-Video auf HiAPI: curl- und Python-Tutorial
Eine anfrageorientierte praktische Demonstration: Aufbau des Aufrufs vom Prompt zum Videoclip, Absenden der Anfrage, Abfragen des Fertigstellungsstatus und Herunterladen des Ergebnisses