
チュートリアル
gpt-6-luna 応用シーン実践:5つの高価値な活用方法と導入の要点
開発者向けテキストモデル実装ガイド:シーン選定から呼び出し・コスト管理まで
なぜ gpt-6-luna でシーン検証を行うのか
モデルを選ぶ前に、問題の種類を選ぶ。gpt-6-luna は OpenAI が提供するテキスト出力モデルで、token 課金制であり、入力と出力の双方が消費として計上される。つまり、これは本質的に「テキスト入力・テキスト出力」のタスク——理解、要約、改写、生成、判別——に適しており、画像や音声などのマルチモーダルな役割は担わない。不適切なタスクをテキストモデルに押し付けるのは、たいていモデルが不十分なのではなく、その問題自体をモデルで解くべきではないからだ。
シーン検証の出発点として、これには三つの現実的な利点がある。第一に、インターフェースの形態が統一されている:1回のリクエストはメッセージリストで構成され、エンジニアリング側は入力の構成と出力の解析にだけ注目すればよく、シーンごとに異なる SDK を導入する必要がない。第二に、課金基準が予測可能:token 課金によりコストはテキスト長に直接連動するため、検証段階で呼び出し量と平均長から予算を概算でき、請求書が出てから予算超過に気づく必要がない。第三に、タスクの境界が明確:純粋なテキスト能力により評価指標を定義しやすい——正確率、形式準拠率、人手修正率は、いずれも定量化できる。
検証段階の正しい順序は次のとおり。まず少量の実サンプルで1本の経路を通し、出力品質と形式の安定性を確認する。次に徐々に量を増やし、token 消費の曲線を観察する。最後に、より多くの業務ラインへ拡張するかどうかを議論する。逆のやり方——まず大規模に導入し、後から品質評価を補う——は、手戻りの際により高い代价を払うことが多い。
また、何に適さないかも明確にすべきだ。リアルタイムの確定的な計算、強い一貫性を持つルール検証、超長文書の全文逐字照合が必要なタスクには、ルールエンジンや従来の検索手法の方が割に合う。モデルの価値は、曖昧で、開放的で、意味理解を要する入力の処理にある。判断基準は簡単だ。同じ入力を二人の異なる人に渡したとき、彼らが出す合理的な出力に差異が生じるか? 差異があれば、そのタスクには意味能力が必要だ。差異がなければ、ルールを書く方が省コストだ。
シーン1:コンテンツ生成と一括コピーライティング
一括コピーライティングは最も直接的で、最も陥りやすいシーンだ。その核心は「モデルにうまく書かせること」ではなく、「100件の出力をすべて同じ規範に適合させること」にある。
入力はテンプレートで固定する
各呼び出しを固定構造に組織する:タスク説明、対象読者、語調と長さの制約、必ず含める要素、禁止する表現、そして1件の参考サンプル。テンプレート化の利点は挙動が再現可能なこと——同じデータ群で再実行しても、出力スタイルがぶれない。フィールド化された入力は後続の A/B 比較にも便利で、たとえば語調の記述だけを変えて出力の差異を観察できる。
出力はプログラム的に検証する
モデルが必ず形式を守るとは仮定しない。生成完了後すぐに検証する:長さは範囲内か、禁止語を含んでいないか、必須要素は揃っているか、構造化フィールドは解析可能か。検証に失敗した項目は再試行またはテンプレートによるフォールバックに回し、直接データベースへは入れない。検証結果を品質指標に計上する方が、人手による抜き取り検査より信頼できる。
要約と改写は別途設計する
要約系タスクでは「誰に見せるか、どれくらいの長さか、どの情報を残すか」を明確にする。指示には原意を保ち、原文にない事実を追加しないことを明記し、検証段階で簡単な事実照合を行う。改写系タスクでは変更可能な境界を明確にする:用語、ブランド名、数字は通常変更を許さず、これらは入力でリスト形式として与え、出力後に項目ごとに照合すべきだ。
一括処理は制御可能にする
一括書き込みは分割処理を推奨し、各片ごとに成功数と失敗数を記録する。失敗項目は原文とエラー理由を別途保存し、集中的な再試行を容易にする。バッチ全体が完了したら、平均 token 消費と人手修正率を一度統計する。この二つの数字が、この経路を長期的に維持する価値があるかを決める。
シーン2:カスタマーサポートと質問応答アシスタント
カスタマーサポートシーンの難点は、これまでモデル能力ではなく境界管理にある。美しい回答をするが権限を越えるアシスタントは、保守的な回答をするアシスタントよりリスクが大きい。
コンテキストの構成
会話履歴、ユーザー身元に関連する背景、業務知識の断片をまとめて入力に入れるが、取捨選択が必要だ。履歴が長いほど token 消費が高くなり、初期の無関係な内容が現在の問題の重点を希釈する。実践では直近の数ターンの会話を保持し、より以前の内容を1文の要約に圧縮する。知識断片は検索後の少量注入のみとし、データベース全体を詰め込まない。
回答の境界
システム指示で三種類の行為を明確にする:何に回答できるか、何を必ず人間に転送するか、何を絶対に約束してはならないか。返金、賠償、法律・医療アドバイスといった高感度な話題は、直接人間転送に設定し、モデルに自由に語らせない。同時に、情報不足時にモデルが明示的に「わからない」と言い、もっともらしい答えを補完しないよう要求する。
人手フォールバックと追跡可能性
モデルが生成した各回答には、入力要約、出力バージョン、ヒットした知識断片を記録し、事後の振り返りを容易にする。明確なフォールバック発動条件を設定する:モデル信頼度が低い、感度キーワードを含む、ユーザーが連続して追問しても未解決。フォールバックは失敗ではなく、設計の一部だ。
効果評価
運用初期は人手による抜き取り検査で回答正確率と人間転送率を評価し、安定後に自動指標を導入する。本当に注視すべきは二種類の誤りだ:存在しない情報を捏造すること、人間転送すべきなのに転送しないこと。前者は信頼を損ない、後者はリスクを増幅する。
シーン3:構造化情報の抽出
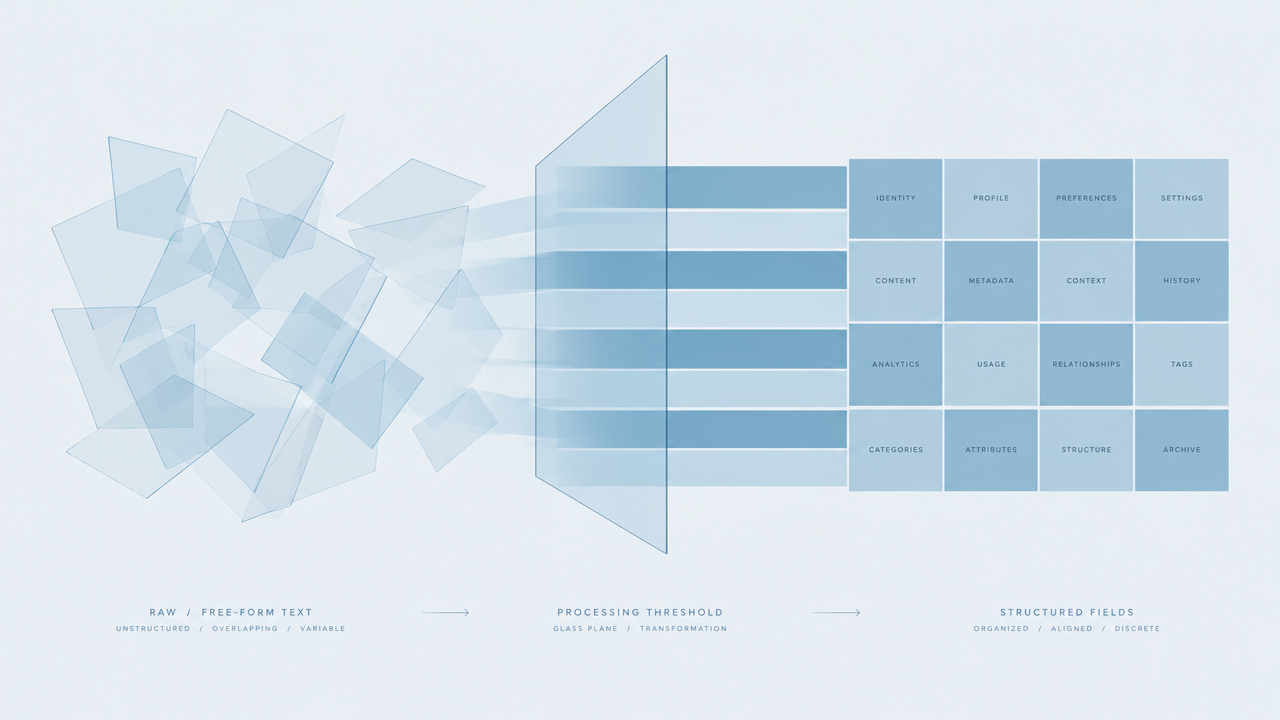
自由テキストを構造化フィールドに変換することは、投資対効果の高い活用法だ:入力は雑然とした自然言語、出力は直接データベースに入れられるキーと値のペア。
まず目標 schema を定義する
指示を書く前に、目標構造を確定する:フィールド名、型、必須かどうか、値の範囲、列挙項目。schema が明確なほど出力は安定する。フィールド設計では細かく分割する方がよく、複数の意味を1つの自由テキストフィールドに詰め込まない。さもなければ後続の検証が手に負えなくなる。
出力形式の制約
モデルには構造化結果のみを出力させ、説明的な文字を付けさせない。同時に完全な出力サンプルを1件示す。サンプルはルール記述より効果的だ。列挙フィールドについては、指示にすべての合法な値を列挙し、判断できない場合にどのプレースホルダーを入れるか説明する。
検証とフォールトトレランス
出力を受け取ったらすぐにプログラム的に検証する:解析できるか、必須フィールドが欠けていないか、列挙値が合法か、数値が合理的な範囲内か。解析に失敗したサンプルは黙って捨てず、元の入力とモデル出力を記録し、指示の反復に用いる。重要フィールドについては二次検証を設計できる:抽出結果と原文断片を一緒にモデルへ渡し、一貫性を確認させる。
長文テキストの処理
1回の処理長を超える文書は、意味境界で分割してから抽出し、最後に結果を統合する。分割時に1つのフィールドの情報が2つの断片に分かれないよう注意する。統合段階では衝突するフィールドにマークを付け、人手による裁定に委ねる。
シーン4:コードとドキュメントの補助
開発補助はテキストモデルの自然なシーンだが、正しい位置で使う必要がある。
コード解説と入門読解
不慣れなコードベースに直面したとき、単一ファイルまたは関数のコンテキストをモデルに渡し、責務、入出力、潜在的副作用を説明させる。この活用法は低コストで効果が直接的であり、新人の習得やレガシーシステムの整理に適する。要点はコンテキスト範囲の制御だ:一度に独立して理解できる1つの単位だけを与え、リポジトリ全体を詰め込まない。
ドキュメント生成
関数シグネチャ、コメント、呼び出し例からインターフェースドキュメントを生成し、人手で校正する。指示にはドキュメントの対象読者と形式を明確にし、パラメータの挙動を捏造してはならないことを強調する。生成されたドキュメントはコードと一緒にレビューする必要があり、直接公開してはならない。
レビュー意見とテスト草稿
モデルに変更断片への潜在的問題リストを出させるのは優れた補完手段だが、人手レビューの代替にはならない。実践では「まず一通り通す」と位置づけ、どの意見を追跡する価値があるかは人が決める。テストケースも同様だ:モデル生成のケースは通常よくある経路をカバーするが、境界条件には依然としてエンジニアリング判断が必要だ。
注意事項
プロンプトに実際のキー、内部アドレス、ユーザープライバシーデータを貼り付けない。モデルが示す API の用法、バージョン番号、設定項目は、必ず公式ドキュメントに戻って照合する——こうした細部は、もっともらしいが存在しない捏造内容が最も現れやすい。
シーン5:分析と意思決定の補助
軽量な分析タスクはテキストモデルに適する:大量の断片的なテキストを読みやすい結論に整理し、節約するのは人の読む時間であり、人の判断を代替するものではない。
コメント分類と要点抽出
ユーザーフィードバック、インタビュー記録、チケット内容は、いずれも典型的な入力だ。やり方はまず分類体系を定義し、モデルに各テキストを既存カテゴリへ分類させ、1文の理由を付けさせる。次に各カテゴリの要点を抽出する。分類体系は事前に決めておく必要があり、開放的な「適当に分類」では集約できない結果になる。
比較分析
複数の方案や製品の記述を並べて与え、モデルに統一された次元で項目ごとに比較させ、情報源を明記させる。出力は次元化された対照であるべきで、総花的な優劣の表明ではない。モデルが入力中に根拠を見つけられなかった判断については、推測と明記させる。
認めるべき限界
テキストモデルは正確な統計や数値推論が苦手で、入力外の事実も知らない。数量、比率、傾向に関する判断は、構造化データに基づいて別途計算し、モデルは解釈と表現だけを担う。高リスクな意思決定では、出力は参考資料に過ぎず、結論にはできない。
評価方法
分析系タスクの評価は人手が主体だ:出力の一部を抽出し、分類が合理的か、要点が重要な情報を欠いていないか、過度な推論がないかを確認する。発見した問題を指示に書き戻すことが、最も効果的な最適化手段だ。
token 課金下のコスト管理戦略
token 課金とは、コストがテキスト長に直接関連することを意味し、コスト管理は本質的に入力と出力の規模を制御することだ。
まず呼び出し量を見積もる
コスト見積もりは三つの数から始まる:平均日次呼び出し回数、平均入力 token、平均出力 token。実サンプルで1ラウンド走らせ、実際の分布を取得する。感覚で埋めない。分布は平均値より意味を持つことが多い——少数の超長リクエストが消費の大部分を占めるなら、最適化の重点はそこに置くべきだ。
入力を圧縮する
入力は通常コストの主要部分だ。可能な手段には以下がある:テンプレート内の冗長な説明を削除する、サンプルを必要最低限に精簡する、長い履歴を要約で置き換える、検索後に関連断片のみを注入する。いずれも「削除後に出力品質が低下するか」を判断基準とし、ただひたすら精簡してはならない。
出力を制約する
出力の長さも同様に制御可能だ。指示で字数または項目数の上限を明確にし、結論を先に、入力内容を繰り返さず、挨拶文を出力しないよう要求する。構造化タスクではフィールド値のみを出力させることで、無効な token を著しく削減できる。
キャッシュとフォールバック
重複度の高いリクエストには結果キャッシュを行う。たとえば同じ商品説明の改写要求は、キャッシュにヒットしたら直接返す。非核心経路にはフォールバック経路を設計する:モデルが利用不可のときはテンプレートやルール方案へ戻し、主フローを途絶させない。同時に単回リクエストと日次呼び出しの上限を設定し、異常トラフィックによる消費の拡大を防ぐ。
継続的な観察
運用後は平均 token 消費、失敗再試行率、人手修正率を追跡する。再試行自体がコストであり、出力が不安定な場合はたいてい指示を修正すべきで、何度も試すべきではない。現在のリアルタイム価格と課金細則は、サイトの価格パネルを基準とする。
導入実装チェックリスト
公開前に以下を項目ごとに確認すれば、ほとんどの一般的な問題を回避できる。
入力と出力の境界
- 指示でタスク、対象読者、形式、長さの制約が明確になっているか
- 出力サンプルと禁止行為リストが提供されているか
- 感度の高い話題や権限を越えるリクエストに、明確な人間転送または拒否ルールが設定されているか
- 入力にキー、内部アドレス、ユーザープライバシーデータを持ち込まないようにしているか
エラー処理と再試行
- 再試行可能なエラー(タイムアウト、レート制限)と再試行不能なエラー(不正な入力、内容違反)を区別しているか
- 再試行に回数上限とバックオフ戦略があり、コストの拡大を避けているか
- 再試行しても失敗するリクエストにフォールバック経路があり、主フローを中断させていないか
ログと可観測性
- 各呼び出しの入力要約、出力結果、所要時間、token 消費を記録しているか
- 失敗サンプルを別途保存し、再現と指示の反復を容易にしているか
- 平均 token 消費、失敗率、人手修正率などの重要指標を統計しているか
効果評価と反復
- 公開前に実サンプルで小規模な検証を行ったか
- 明確な品質指標と人手抜き取り検査のリズムがあるか
- 指示の変更にバージョン記録があり、ロールバックと比較が容易か
業務フローとの整合
- モデル出力の業務フロー上の位置が明確か:提案か、草稿か、それとも直接採用できる結果か
- どの环节で必ず人が確認する必要があるか、それがフローに固められているか
- このシーンでルールや従来の方案の方が割に合うかどうかを確認したか
このチェックリストを公開の門槛として扱い、一度きりの文書にしないこと。新しいシーンを拡張するたび、指示を調整するたびに、関連項目をもう一度見直す価値がある。
関連記事
すべての記事を見る →-

チュートリアル
HiAPI API で hailuo-2.3-fast/image-to-video を呼び出す方法:curl と Python の実践
高速・低コストな画像から動画へのティアにおける最初の実行可能なリクエスト — モデル ID から MP4 のダウンロードまで
-

チュートリアル
HiAPI APIでhailuo-2.3/text-to-videoを呼び出す方法:curl、Python、実行可能なリクエスト例
-

チュートリアル
HiAPI で Kandinsky 6.0 Pro のテキストto動画を使用する:curl と Python チュートリアル
リクエスト優先の実践デモ:プロンプトから動画クリップへの呼び出しを構築し、リクエストを送信し、完了状態をポーリングし、結果をダウンロードする