
Tutoriale
Scenari applicativi pratici di gpt-6-luna: 5 usi ad alto valore e punti chiave di integrazione
Guida per sviluppatori all'adozione dei modelli testuali: dalla scelta degli scenari alle chiamate e al controllo dei costi
Perché usare gpt-6-luna per la validazione degli scenari
Prima di scegliere il modello, scegli il tipo di problema. gpt-6-luna è un modello di output testuale fornito da OpenAI, con tariffazione a token: sia l'input che l'output vengono conteggiati nel consumo. Questo significa che è naturalmente adatto a compiti «testo in ingresso, testo in uscita»: comprensione, sintesi, riscrittura, generazione, discriminazione, senza assumersi responsabilità multimodali come immagini o audio. Assegnare al modello testuale compiti non adatti di solito non dipende dal fatto che il modello non sia abbastanza potente, ma dal fatto che il problema stesso non dovrebbe essere risolto da lui.
Come punto di partenza per la validazione degli scenari, presenta tre vantaggi concreti. Primo, forma di interfaccia uniforme: una richiesta è composta da una lista di messaggi, e lato engineering basta occuparsi dell'organizzazione dell'input e dell'interpretazione dell'output, senza introdurre SDK diversi per ogni scenario. Secondo, criterio di fatturazione prevedibile: la tariffazione a token lega direttamente il costo alla lunghezza del testo, così già in fase di validazione si può stimare approssimativamente il budget in base al volume di chiamate e alla lunghezza media, senza dover aspettare la fattura per scoprire di aver sforato. Terzo, confini del compito chiari: la capacità puramente testuale rende facili da definire le metriche di valutazione — accuratezza, tasso di conformità al formato, tasso di modifiche manuali, tutte quantificabili.
L'ordine corretto in fase di validazione è: prima far funzionare una catena con un piccolo numero di campioni reali, confermando qualità dell'output e stabilità del formato; poi aumentare gradualmente il volume, osservando la curva di consumo dei token; solo alla fine discutere se estendere ad altre linee di business. Fare il contrario — integrare su larga scala prima e tornare poi a integrare la valutazione della qualità — spesso comporta un costo più alto in fase di rifacimento.
Bisogna anche essere chiari su cosa non è adatto. Per compiti che richiedono calcoli deterministici in tempo reale, validazione rigorosa di regole coerenti, confronto letterale integrale di documenti molto lunghi, è più conveniente usare un motore di regole o una soluzione di retrieval tradizionale; il valore del modello sta nel gestire input ambigui, aperti, che richiedono comprensione semantica. Il criterio è semplice: se lo stesso input viene dato a due persone diverse, i loro output ragionevoli sarebbero diversi? Se sì, il compito richiede capacità semantica; se no, scrivere regole è più economico.
Scenario uno: generazione di contenuti e copy in batch
Il copy in batch è lo scenario più diretto e anche quello in cui è più facile incorrere in errori. Il suo nucleo non è «far scrivere bene al modello», ma «far sì che cento output rispettino tutti lo stesso insieme di regole».
Input fissato con un template
Organizza ogni chiamata in una struttura fissa: descrizione del compito, pubblico di riferimento, vincoli di tono e lunghezza, elementi obbligatori, espressioni vietate e un esempio di riferimento. Il vantaggio della modellizzazione è la riproducibilità del comportamento — con gli stessi dati, eseguendo di nuovo, lo stile dell'output non varia. L'input a campi facilita anche successivi confronti A/B, ad esempio modificando solo la descrizione del tono per osservare le differenze nell'output.
Validazione programmatica dell'output
Non dare per scontato che il modello rispetti sempre il formato. Dopo la generazione, valida immediatamente: la lunghezza è nell'intervallo? contiene parole vietate? gli elementi obbligatori sono completi? i campi strutturati sono interpretabili? Le voci che falliscono la validazione vanno in retry o degradano a un fallback basato su template, non vanno inserite direttamente nel database. Contare i risultati della validazione nelle metriche di qualità è più affidabile del campionamento manuale.
Sintesi e riscrittura progettate separatamente
Per i compiti di sintesi specifica «per chi, quanto lungo, quali informazioni conservare». Nell'istruzione scrivi chiaramente di conservare il significato originale, di non aggiungere fatti non presenti nel testo, e nella validazione fai un semplice confronto fattuale. Per i compiti di riscrittura specifica invece i confini modificabili: termini tecnici, nomi di brand, numeri di solito non sono modificabili; questi vanno forniti nell'input come elenco e verificati voce per voce dopo l'output.
Processo batch controllabile
Per la scrittura in batch si consiglia l'elaborazione a blocchi, registrando per ogni blocco il numero di successi e fallimenti. Le voci fallite conservano separatamente il testo originale e il motivo dell'errore, per facilitare il retry concentrato. Al termine dell'intero lotto, calcola una volta il consumo medio di token e il tasso di modifiche manuali: questi due numeri determinano se vale la pena mantenere questa catena a lungo termine.
Scenario due: assistente clienti e domande-risposte
La difficoltà dello scenario di assistenza clienti non è mai nella capacità del modello, ma nella gestione dei confini. Un assistente che risponde bene ma eccede le proprie competenze è più rischioso di un assistente che risponde in modo prudente.
Organizzazione del contesto
Inserisci nell'input insieme la cronologia della conversazione, il contesto relativo all'identità dell'utente e i frammenti di conoscenza aziendale, ma con selettività. Più lunga è la cronologia, maggiore è il consumo di token, e i contenuti irrilevanti iniziali diluiscono il focus della domanda attuale. In pratica si possono conservare gli ultimi turni di conversazione e comprimere i contenuti più vecchi in una sintesi di una frase; i frammenti di conoscenza vanno iniettati solo in piccola quantità dopo il retrieval, non inserendo l'intero database.
Confini della risposta
Nelle istruzioni di sistema definisci chiaramente tre tipi di comportamento: cosa può rispondere, cosa deve necessariamente passare a un operatore umano, cosa assolutamente non può promettere. Argomenti altamente sensibili come rimborsi, indennizzi, consigli legali e medici vanno impostati direttamente come passaggio a operatore umano, senza lasciare al modello libera interpretazione. Allo stesso tempo richiedi al modello di dichiarare esplicitamente di non sapere quando le informazioni sono insufficienti, invece di completare con una risposta che sembra ragionevole.
Fallback umano e tracciabilità
Per ogni risposta generata dal modello vanno registrati la sintesi dell'input, la versione dell'output e i frammenti di conoscenza corrispondenti, per facilitare la revisione successiva. Imposta condizioni chiare di attivazione del fallback: bassa confidenza del modello, presenza di parole chiave sensibili, domande ripetute dall'utente senza soluzione. Il fallback non è un fallimento, ma parte della progettazione.
Valutazione dell'efficacia
Nella fase iniziale di lancio, valuta con campionamento manuale il tasso di accuratezza delle risposte e il tasso di passaggio a operatore umano; dopo la stabilizzazione introduci metriche automatiche. Ciò che va realmente monitorato sono due tipi di errore: inventare informazioni inesistenti e non passare a operatore umano quando dovrebbe. Il primo danneggia la fiducia, il secondo amplifica il rischio.
Scenario tre: estrazione di informazioni strutturate
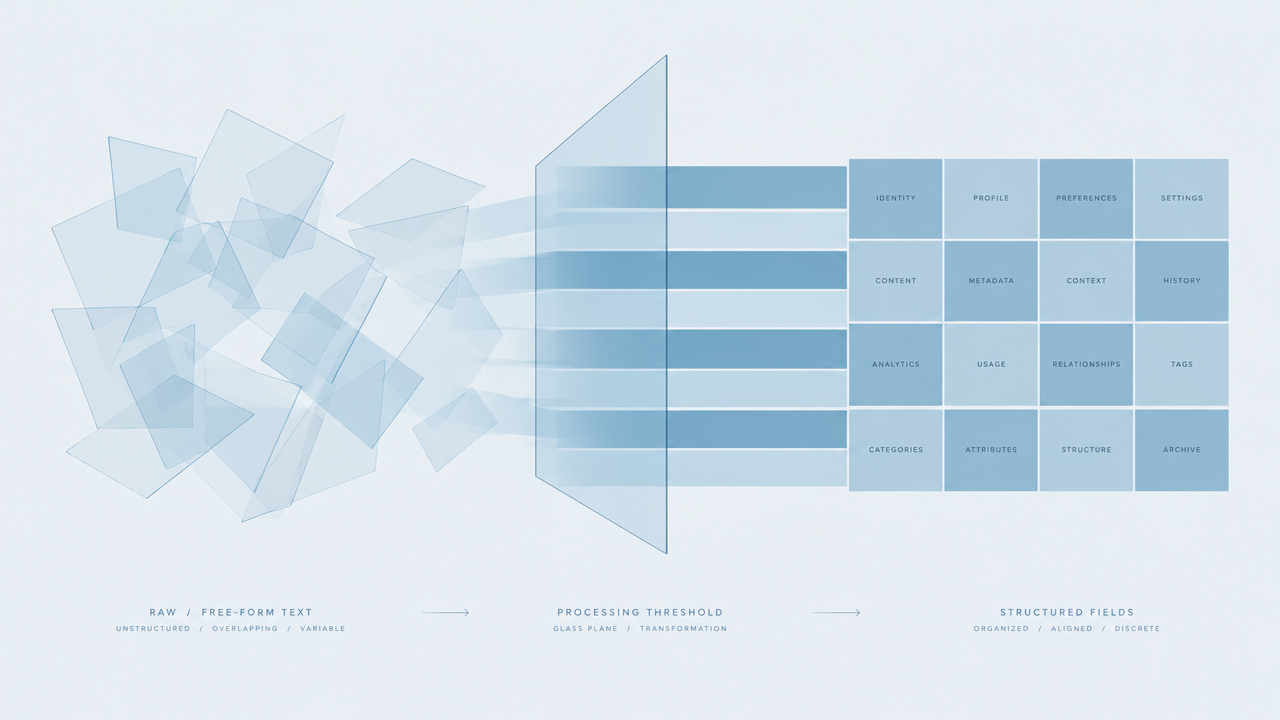
Convertire testo libero in campi strutturati è un uso con un rapporto costo-beneficio molto alto: l'input è linguaggio naturale disordinato, l'output è coppie chiave-valore direttamente inseribili nel database.
Definisci prima lo schema di destinazione
Prima di scrivere le istruzioni, definisci la struttura di destinazione: nomi dei campi, tipi, obbligatorietà, intervalli di valori, voci di enumerazione. Più lo schema è chiaro, più l'output è stabile. Nella progettazione dei campi meglio sminuzzare, piuttosto che inserire più semantiche in un unico campo di testo libero, altrimenti le successive validazioni diventano impossibili.
Vincoli sul formato di output
Richiedi al modello di produrre solo il risultato strutturato, senza testo esplicativo. Fornisci anche un esempio completo di output: l'esempio è più efficace della descrizione delle regole. Per i campi enumerati, elenca nell'istruzione tutti i valori legali e specifica quale segnaposto inserire quando non è possibile determinare il valore.
Validazione e tolleranza agli errori
Dopo aver ricevuto l'output, esegui immediatamente una validazione programmatica: è interpretabile? mancano campi obbligatori? i valori enumerati sono legali? i valori numerici sono in un intervallo ragionevole? I campioni che falliscono l'interpretazione non vanno scartati silenziosamente, ma vanno registrati insieme all'input originale e all'output del modello, per iterare le istruzioni. Per i campi critici si può progettare una doppia validazione: sottoporre al modello il risultato dell'estrazione insieme al frammento di testo originale per una conferma di coerenza.
Gestione di testi lunghi
Per i documenti che superano la lunghezza di una singola elaborazione, suddividili secondo i confini semantici, poi estrai, infine unisci i risultati. Nella suddivisione evita che le informazioni di un campo vengano separate in due frammenti. Nella fase di unione, contrassegna i campi in conflitto e lascia la decisione a un operatore umano.
Scenario quattro: supporto a codice e documentazione
Il supporto allo sviluppo è uno scenario naturale per i modelli testuali, ma va usato nel posto giusto.
Spiegazione del codice e lettura introduttiva
Di fronte a una codebase non familiare, fornisci al modello il contesto di un singolo file o funzione e chiedigli di spiegare responsabilità, input/output e potenziali effetti collaterali. Questo uso ha basso costo e beneficio diretto, adatto all'inserimento dei nuovi arrivati e alla riorganizzazione di sistemi legacy. Il punto chiave è controllare l'ambito del contesto: fornire una sola unità comprensibile in modo indipendente alla volta, non inserire l'intero repository.
Generazione di documentazione
Genera la documentazione delle interfacce a partire da firme delle funzioni, commenti ed esempi di chiamata, poi fai correggere manualmente. Nell'istruzione specifica il pubblico di riferimento e il formato della documentazione, e sottolinea di non inventare comportamenti dei parametri. La documentazione generata deve essere revisionata insieme al codice, non pubblicata direttamente.
Pareri di revisione e bozze di test
Chiedere al modello un elenco di potenziali problemi sui frammenti modificati è un buon strumento complementare, ma non può sostituire la revisione umana. In pratica lo si posiziona come «una prima passata», lasciando alla persona decidere quali osservazioni vale la pena seguire. Lo stesso vale per i casi di test: quelli generati dal modello di solito coprono i percorsi comuni, mentre le condizioni limite richiedono ancora il giudizio dell'engineering.
Avvertenze
Non incollare nei prompt chiavi reali, indirizzi interni o dati personali degli utenti. Per l'uso delle API, i numeri di versione e le voci di configurazione forniti dal modello, verifica sempre sulla documentazione ufficiale — questi dettagli sono i più soggetti a contenuti inventati che sembrano ragionevoli ma non esistono.
Scenario cinque: supporto all'analisi e alle decisioni
I compiti di analisi leggera sono adatti al modello testuale: organizzare grandi quantità di testo sparso in conclusioni leggibili fa risparmiare il tempo di lettura delle persone, non sostituisce il loro giudizio.
Categorizzazione dei commenti ed estrazione dei punti chiave
Feedback degli utenti, registrazioni di interviste, contenuti dei ticket sono tutti input tipici. L'approccio è definire prima il sistema di classificazione, far assegnare dal modello ogni testo a una categoria esistente con una motivazione in una frase, poi estrarre i punti chiave per ciascuna categoria. Il sistema di classificazione va definito in anticipo: una categorizzazione aperta e «libera» produce risultati non aggregabili.
Analisi comparativa
Fornisci in parallelo le descrizioni di più soluzioni o prodotti, chiedendo al modello di confrontarli voce per voce secondo dimensioni uniformi e di indicare la fonte delle informazioni. L'output deve essere un confronto per dimensioni, non un giudizio generico di superiorità o inferiorità. Per i giudizi per cui il modello non trova basi nell'input, richiedi che li contrassegni esplicitamente come ipotesi.
Limiti da riconoscere
I modelli testuali non sono bravi in statistica precisa e ragionamento numerico, né conoscono fatti al di fuori dell'input. Qualsiasi giudizio che riguardi quantità, proporzioni, tendenze deve basarsi su calcoli separati su dati strutturati; il modello si occupa solo di spiegazione ed espressione. Per decisioni ad alto rischio, l'output può essere solo materiale di riferimento, non una conclusione.
Modalità di valutazione
La valutazione dei compiti di analisi è principalmente manuale: estrai una parte degli output, verifica se la classificazione è ragionevole, se i punti chiave omettono informazioni critiche, se vi sono inferenze eccessive. Riscrivere nelle istruzioni i problemi individuati è il metodo di ottimizzazione più efficace.
Strategie di controllo dei costi con tariffazione a token
La tariffazione a token significa che il costo è direttamente correlato alla lunghezza del testo; controllare i costi significa essenzialmente controllare la scala di input e output.
Stima prima il volume di chiamate
La stima dei costi parte da tre numeri: numero medio di chiamate giornaliere, token medi in input, token medi in output. Esegui un ciclo con campioni reali per ottenere la distribuzione effettiva, invece di riempire a sensazione. Spesso la distribuzione è più significativa della media — se poche richieste molto lunghe assorbono la maggior parte del consumo, l'ottimizzazione dovrebbe concentrarsi su di esse.
Comprimi l'input
L'input è di solito la voce di costo maggiore. Le misure praticabili includono: eliminare le spiegazioni ridondanti nel template, ridurre gli esempi allo stretto necessario, sostituire la cronologia lunga con una sintesi, iniettare solo i frammenti rilevanti dopo il retrieval. Per ciascuna, il criterio è «la qualità dell'output peggiora dopo averla eliminata?», non una riduzione fine a se stessa.
Vincola l'output
Anche la lunghezza dell'output è controllabile. Nell'istruzione specifica un limite massimo di parole o di voci, richiedi di mettere prima le conclusioni, di non ripetere il contenuto dell'input, di non produrre frasi di cortesia. Per i compiti strutturati, richiedere solo i valori dei campi riduce significativamente i token inutili.
Cache e degradazione
Per le richieste con alto grado di ripetizione, usa la cache dei risultati, ad esempio richieste identiche di riscrittura di descrizioni di prodotti: in caso di hit della cache restituisci direttamente. Per le catene non critiche progetta percorsi di degradazione: quando il modello non è disponibile, torna a template o soluzioni a regole, garantendo la continuità del flusso principale. Imposta anche limiti massimi per singola richiesta e per le chiamate giornaliere, per evitare che traffico anomalo amplifichi il consumo.
Osservazione continua
Dopo il lancio monitora il consumo medio di token, il tasso di retry per fallimento e il tasso di modifiche manuali. Il retry stesso è un costo: un output instabile spesso indica che le istruzioni vanno corrette, non che bisogna riprovare più volte. Per i prezzi in tempo reale e i dettagli di fatturazione attuali, fai riferimento al pannello prezzi del sito.
Checklist per l'integrazione operativa
Verificare voce per voce i seguenti contenuti prima del lancio permette di evitare la maggior parte dei problemi comuni.
Confini di input e output
- Nelle istruzioni sono chiari compito, pubblico di riferimento, formato e vincoli di lunghezza?
- Sono forniti esempi di output ed elenco dei comportamenti vietati?
- Per argomenti sensibili e richieste che eccedono le competenze sono state definite regole chiare di passaggio a operatore umano o di rifiuto?
- Si evita di includere nell'input chiavi, indirizzi interni e dati personali degli utenti?
Gestione degli errori e retry
- Sono distinti gli errori ritentabili (timeout, rate limiting) da quelli non ritentabili (input non valido, contenuto illecito)?
- Il retry ha un limite massimo di tentativi e una strategia di backoff, per evitare di amplificare i costi?
- Le richieste che falliscono anche dopo il retry hanno un percorso di fallback, invece di interrompere il flusso principale?
Log e osservabilità
- Sono registrati per ogni chiamata la sintesi dell'input, il risultato dell'output, il tempo di esecuzione e il consumo di token?
- I campioni falliti sono conservati separatamente, per facilitare la riproduzione e l'iterazione delle istruzioni?
- Sono misurate metriche chiave come consumo medio di token, tasso di fallimento e tasso di modifiche manuali?
Valutazione dell'efficacia e iterazione
- Prima del lancio è stata fatta una validazione su piccola scala con campioni reali?
- Ci sono metriche di qualità chiare e una cadenza di campionamento manuale?
- Le modifiche alle istruzioni hanno una registrazione delle versioni, per facilitare rollback e confronti?
Allineamento con i processi di business
- È chiaro il ruolo dell'output del modello nel processo di business: è un suggerimento, una bozza o un risultato direttamente utilizzabile?
- Quali fasi richiedono necessariamente la conferma umana, ed è già consolidato nel processo?
- È stato confermato se per questo scenario regole o soluzioni tradizionali siano più convenienti?
Considera questa checklist come una soglia di lancio, non come un documento una tantum. Ogni volta che si estende un nuovo scenario e ogni volta che si modificano le istruzioni, vale la pena ripercorrere le voci pertinenti.
Articoli correlati
Vedi tutti gli articoli →-

Tutoriale
Come chiamare hailuo-2.3-fast/image-to-video tramite l'API HiAPI: pratica con curl e Python
La prima richiesta funzionante per il livello image-to-video veloce ed economico — dall'ID del modello al download di un MP4
-

Tutoriale
Come chiamare hailuo-2.3/text-to-video tramite l'API HiAPI: curl, Python ed esempi di richiesta eseguibili
-

Tutoriale
Utilizzare Kandinsky 6.0 Pro su HiAPI per la generazione di video da testo: tutorial con curl e Python
Dimostrazione pratica guidata dalla richiesta: costruire la chiamata da prompt a clip video, inviare la richiesta, monitorare lo stato di completamento e scaricare il risultato