
Tutorial
gpt-6-luna em cenários reais: 5 usos de alto valor e pontos de integração
Guia para desenvolvedores sobre a implementação de modelos de texto: da escolha do cenário à chamada e ao controle de custos
Por que usar gpt-6-luna para validar cenários
Antes de escolher o modelo, escolha o tipo de problema. gpt-6-luna é um modelo de saída de texto fornecido pela OpenAI, com preço por token, em que entrada e saída contam no consumo. Isso significa que ele é naturalmente adequado para tarefas de "texto entra, texto sai": compreender, resumir, reescrever, gerar e classificar, sem assumir responsabilidades multimodais como imagem e áudio. Colocar tarefas inadequadas em um modelo de texto geralmente não é sinal de que o modelo é fraco, mas de que o problema não deveria ser resolvido por ele.
Como ponto de partida para validar cenários, ele tem três vantagens práticas. Primeiro, formato de interface unificado: uma requisição é composta por uma lista de mensagens, e o lado de engenharia só precisa cuidar da organização da entrada e da análise da saída, sem introduzir SDKs diferentes para cada cenário. Segundo, base de cobrança previsível: o preço por token vincula diretamente o custo ao comprimento do texto, permitindo estimar o orçamento na fase de validação a partir do volume de chamadas e do comprimento médio, sem descobrir o excesso só na fatura. Terceiro, limites de tarefa claros: a capacidade puramente textual torna as métricas de avaliação fáceis de definir — taxa de acurácia, taxa de conformidade de formato e taxa de edição manual são todas quantificáveis.
A ordem correta na fase de validação é: primeiro executar uma cadeia completa com uma pequena amostra real, confirmando a qualidade da saída e a estabilidade do formato; depois aumentar o volume gradualmente, observando a curva de consumo de tokens; só então discutir a expansão para mais linhas de negócio. Fazer o contrário — integrar em larga escala primeiro e depois voltar para complementar a avaliação de qualidade — costuma custar mais caro em retrabalho.
Também é preciso saber para que ele não serve. Tarefas que exigem cálculo determinístico em tempo real, validação de regras com consistência forte ou comparação literal de documentos muito longos são mais vantajosas com mecanismos de regras ou soluções tradicionais de recuperação; o valor do modelo está em lidar com entradas ambíguas, abertas e que exigem compreensão semântica. O critério é simples: se a mesma entrada for entregue a duas pessoas diferentes, as saídas razoáveis delas seriam diferentes? Se sim, a tarefa exige capacidade semântica; se não, escrever regras economiza mais.
Cenário 1: geração de conteúdo e textos em lote
Textos em lote são o cenário mais direto e também o mais sujeito a armadilhas. O ponto central não é "fazer o modelo escrever bem", mas "fazer cem saídas seguirem o mesmo conjunto de normas".
Entrada fixada com modelo
Organize cada chamada em uma estrutura fixa: descrição da tarefa, público-alvo, restrições de tom e comprimento, elementos obrigatórios, expressões proibidas e um exemplo de referência. A modelagem traz comportamento reproduzível — a mesma base de dados, em outra execução, não faz o estilo da saída variar. A entrada em campos também facilita comparações A/B posteriores, por exemplo, alterando apenas a descrição de tom para observar diferenças na saída.
Validação programática da saída
Não presuma que o modelo sempre respeitará o formato. Valide imediatamente após a geração: o comprimento está dentro do intervalo, há palavras proibidas, os elementos obrigatórios estão completos, os campos estruturados são analisáveis. Itens que falham na validação seguem para nova tentativa ou caem em um fallback de modelo, em vez de serem gravados diretamente. Contabilizar os resultados de validação nas métricas de qualidade é mais confiável do que amostragem manual.
Resumo e reescrita projetados separadamente
Tarefas de resumo precisam deixar claro "para quem, com que comprimento, quais informações preservar". Na instrução, escreva explicitamente para preservar o sentido original e não adicionar fatos ausentes no original, e faça uma comparação simples de fatos na etapa de validação. Tarefas de reescrita precisam definir os limites do que pode ser alterado: termos, nomes de marca e números normalmente não podem ser modificados; isso deve ser fornecido como lista na entrada e conferido item a item após a saída.
Fluxo em lote controlável
Para gravação em lote, recomenda-se processamento em partes, registrando em cada parte o número de sucessos e falhas. Itens com falha devem guardar separadamente o texto original e o motivo do erro, facilitando novas tentativas concentradas. Após concluir o lote, calcule uma vez o consumo médio de tokens e a taxa de edição manual; esses dois números determinam se vale manter essa cadeia a longo prazo.
Cenário 2: atendimento ao cliente e assistente de perguntas e respostas
A dificuldade do atendimento ao cliente nunca está na capacidade do modelo, mas na gestão de limites. Um assistente que responde bonito mas excede a autoridade tem risco maior do que um assistente conservador.
Organização do contexto
Coloque no input o histórico da conversa, o contexto relacionado à identidade do usuário e trechos de conhecimento de negócio, mas com critério. Quanto mais longo o histórico, maior o consumo de tokens, e conteúdo inicial irrelevante dilui o foco da pergunta atual. Na prática, pode-se manter as últimas rodadas de conversa e comprimir o conteúdo mais antigo em uma frase de resumo; os trechos de conhecimento devem ser injetados em pequena quantidade após recuperação, não com a base inteira inserida.
Limites da resposta
Na instrução do sistema, defina explicitamente três tipos de comportamento: o que pode ser respondido, o que deve ser encaminhado a um atendente humano e o que jamais pode ser prometido. Temas altamente sensíveis como reembolso, indenização, orientação jurídica e médica devem ser definidos diretamente como encaminhamento humano, sem deixar o modelo improvisar. Também exija que o modelo diga claramente que não sabe quando faltam informações, em vez de completar uma resposta que soa razoável.
Fallback humano e rastreabilidade
Cada resposta gerada pelo modelo deve registrar o resumo da entrada, a versão da saída e os trechos de conhecimento acionados, para revisão posterior. Defina condições claras de acionamento do fallback: baixa confiança do modelo, palavras-chave sensíveis, perguntas consecutivas não resolvidas do usuário. O fallback não é fracasso, é parte do design.
Avaliação de resultados
No início da operação, use amostragem manual para avaliar a taxa de acurácia das respostas e a taxa de encaminhamento humano; após estabilizar, introduza métricas automáticas. O que realmente precisa ser monitorado são dois tipos de erro: inventar informações inexistentes e não encaminhar ao humano quando deveria. O primeiro prejudica a confiança; o segundo amplia o risco.
Cenário 3: extração de informações estruturadas
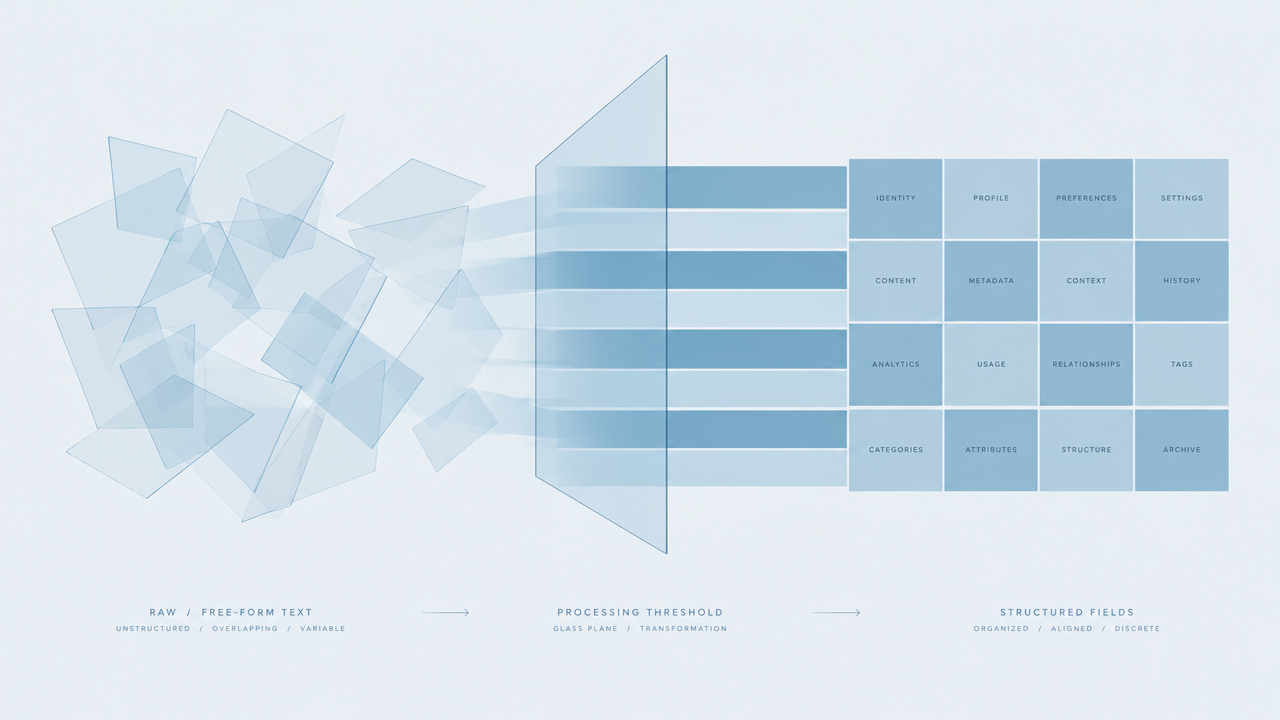
Converter texto livre em campos estruturados é um uso com alta relação custo-benefício: a entrada é linguagem natural desorganizada e a saída é um par chave-valor pronto para gravação.
Defina primeiro o schema de destino
Antes de escrever a instrução, defina a estrutura de destino: nomes de campos, tipos, obrigatoriedade, intervalos de valor e itens de enumeração. Quanto mais claro o schema, mais estável a saída. No design dos campos, prefira detalhar em vez de colocar múltiplos significados em um único campo de texto livre, pois isso inviabiliza a validação posterior.
Restrições de formato de saída
Exija que o modelo produza apenas o resultado estruturado, sem texto explicativo. Forneça também um exemplo completo de saída; exemplos são mais eficazes do que descrições de regras. Para campos de enumeração, liste na instrução todos os valores válidos e indique qual marcador usar quando não for possível determinar.
Validação e tolerância a erros
Após obter a saída, faça validação programática imediata: é possível analisar, faltam campos obrigatórios, os valores de enumeração são válidos, os números estão em intervalos razoáveis. Amostras com falha de análise não devem ser descartadas silenciosamente; registre a entrada original e a saída do modelo para iterar a instrução. Para campos críticos, pode-se projetar uma segunda validação: entregar ao modelo o resultado da extração junto com o trecho original para confirmar consistência.
Tratamento de textos longos
Documentos que excedem o comprimento de processamento de uma chamada devem ser divididos por limites semânticos, extraídos e depois mesclados. Ao dividir, evite que a informação de um campo seja repartida entre dois trechos. Na fase de mesclagem, marque campos conflitantes para decisão humana.
Cenário 4: apoio a código e documentação
O apoio ao desenvolvimento é um cenário natural para modelos de texto, mas deve ser usado no lugar certo.
Explicação de código e leitura inicial
Diante de uma base de código desconhecida, entregue ao modelo o contexto de um único arquivo ou função e peça que explique responsabilidades, entradas e saídas e efeitos colaterais potenciais. Esse uso tem baixo custo e benefício direto, sendo adequado para integração de novos membros e organização de sistemas legados. O ponto crítico é controlar o escopo do contexto: entregue de cada vez apenas uma unidade compreensível de forma independente, não o repositório inteiro.
Geração de documentação
Gerar documentação de interface a partir de assinaturas de funções, comentários e exemplos de chamada, seguida de revisão manual. Na instrução, deixe claros o público-alvo e o formato da documentação, e enfatize que não se deve inventar comportamentos de parâmetros. A documentação gerada deve ser revisada junto com o código, não publicada diretamente.
Pareceres de revisão e rascunhos de testes
Pedir ao modelo uma lista de problemas potenciais em trechos alterados é um bom complemento, mas não substitui a revisão humana. Na prática, posicione-o como "uma primeira passada", com a pessoa decidindo quais opiniões merecem acompanhamento. O mesmo vale para casos de teste: os gerados pelo modelo normalmente cobrem caminhos comuns; condições de borda ainda exigem julgamento de engenharia.
Pontos de atenção
Não cole chaves reais, endereços internos ou dados privados de usuários no prompt. Para usos de API, números de versão e itens de configuração fornecidos pelo modelo, sempre confira na documentação oficial — esses detalhes são os mais propensos a conteúdo inventado que parece razoável mas não existe.
Cenário 5: apoio à análise e à decisão
Tarefas de análise leve são adequadas para modelos de texto: organizar grande quantidade de texto disperso em conclusões legíveis economiza tempo de leitura das pessoas, sem substituir o julgamento humano.
Classificação de comentários e extração de pontos-chave
Feedback de usuários, registros de entrevistas e conteúdo de tickets são entradas típicas. O método é definir primeiro o sistema de classificação, pedir ao modelo que classifique cada texto em uma categoria existente e forneça uma justificativa em uma frase; depois extrair os pontos-chave de cada categoria. O sistema de classificação deve ser definido previamente; uma "classificação livre" aberta gera resultados impossíveis de agregar.
Análise comparativa
Apresente lado a lado as descrições de várias soluções ou produtos, peça ao modelo que compare item a item segundo dimensões uniformes e indique a fonte das informações. A saída deve ser uma comparação por dimensões, não uma declaração genérica de vantagens e desvantagens. Para julgamentos sem base encontrada na entrada, exija que o modelo os marque explicitamente como suposição.
Limitações que devem ser reconhecidas
Modelos de texto não são bons em estatística precisa e raciocínio numérico, nem conhecem fatos fora da entrada. Qualquer julgamento envolvendo quantidade, proporção ou tendência deve ser calculado separadamente com base em dados estruturados, cabendo ao modelo apenas explicar e expressar. Para decisões de alto risco, a saída só pode servir como material de referência, nunca como conclusão.
Forma de avaliação
A avaliação de tarefas analíticas é principalmente manual: extraia parte das saídas, verifique se a classificação é razoável, se os pontos-chave omitem informações críticas e se há inferência excessiva. Registrar os problemas encontrados de volta na instrução é o meio de otimização mais eficaz.
Estratégias de controle de custos com preço por token
Preço por token significa que o custo está diretamente relacionado ao comprimento do texto; controlar custos é, essencialmente, controlar a escala da entrada e da saída.
Estime primeiro o volume de chamadas
A estimativa de custo começa com três números: chamadas diárias médias, tokens médios de entrada e tokens médios de saída. Execute uma rodada com amostras reais para obter a distribuição efetiva, em vez de preencher por intuição. A distribuição costuma ser mais significativa do que a média — se poucas requisições muito longas concentram a maior parte do consumo, a otimização deve focar nelas.
Comprima a entrada
A entrada normalmente é a maior parte do custo. Medidas viáveis incluem: remover descrições redundantes do modelo, simplificar exemplos ao necessário, substituir históricos longos por resumos e injetar apenas trechos relevantes após recuperação. Cada item deve ser julgado pelo critério "a qualidade da saída cai se eu remover isto?", não por simplificação cega.
Restrinja a saída
O comprimento da saída também é controlável. Defina na instrução limites de palavras ou de itens, exija conclusão primeiro, sem repetir o conteúdo da entrada e sem fórmulas de cortesia. Para tarefas estruturadas, exigir apenas os valores dos campos pode reduzir significativamente tokens inúteis.
Cache e degradação
Faça cache de resultados para requisições com alta repetição, por exemplo, necessidades idênticas de reescrita de descrição de produto, retornando direto do cache quando houver acerto. Projete caminhos de degradação para cadeias não críticas: quando o modelo estiver indisponível, volte a modelos ou soluções de regras, garantindo que o fluxo principal não pare. Defina também limites de chamadas por requisição e por dia, evitando que tráfego anormal amplie o consumo.
Observação contínua
Após a operação, acompanhe o consumo médio de tokens, a taxa de novas tentativas por falha e a taxa de edição manual. A repetição em si é custo; saídas instáveis geralmente indicam que a instrução precisa ser corrigida, não que se deva tentar mais vezes. Os preços atuais em tempo real e as regras de cobrança devem ser consultados no painel de preços do site.
Checklist de implementação da integração
Confirmar item a item o conteúdo a seguir antes da operação evita a maioria dos problemas comuns.
Limites de entrada e saída
- A instrução define claramente tarefa, público-alvo, formato e restrições de comprimento
- Foram fornecidos exemplos de saída e lista de comportamentos proibidos
- Temas sensíveis e pedidos que excedem a autoridade têm regras claras de encaminhamento humano ou recusa
- Evita-se incluir chaves, endereços internos e dados privados de usuários na entrada
Tratamento de erros e novas tentativas
- Foram distinguidos erros repetíveis (timeout, limite de taxa) e não repetíveis (entrada inválida, violação de conteúdo)
- As novas tentativas têm limite de quantidade e estratégia de backoff, evitando ampliar custos
- Requisições que ainda falham após novas tentativas têm caminho de fallback, sem interromper o fluxo principal
Logs e observabilidade
- Registram-se o resumo da entrada, o resultado da saída, o tempo de execução e o consumo de tokens de cada chamada
- Amostras com falha são guardadas separadamente, facilitando reprodução e iteração da instrução
- Foram calculadas métricas-chave como consumo médio de tokens, taxa de falha e taxa de edição manual
Avaliação de resultados e iteração
- Antes da operação, foi feita validação em pequena escala com amostras reais
- Há métricas de qualidade claras e ritmo definido de amostragem manual
- Alterações na instrução têm registro de versão, facilitando reversão e comparação
Alinhamento com o fluxo de negócio
- É claro o papel da saída do modelo no fluxo de negócio: sugestão, rascunho ou resultado diretamente utilizável
- Quais etapas exigem confirmação humana e se isso já está fixado no processo
- Confirmou-se se regras ou soluções tradicionais são mais vantajosas para esse cenário
Trate esta lista como um critério de entrada em operação, não como um documento de uso único. Cada expansão para um novo cenário e cada ajuste de instrução merecem uma nova passagem pelos itens relacionados.
Artigos relacionados
Ver todos os artigos →-

Tutorial
Como chamar hailuo-2.3-fast/image-to-video pela API HiAPI: curl e Python na prática
A primeira requisição executável do nível rápido e econômico de geração de vídeo a partir de imagem — do ID do modelo ao download do MP4
-

Tutorial
Como chamar hailuo-2.3/text-to-video pela API HiAPI: curl, Python e exemplos de requisição executáveis
-

Tutorial
Usar Kandinsky 6.0 Pro text-to-video na HiAPI: tutorial de curl e Python
Demonstração prática com foco na requisição: montar a chamada de prompt para clipe de vídeo, enviar a requisição, consultar o status de conclusão e baixar o resultado