
Сравнительный обзор
Kimi K3.1 Pro против Opus 5.5: как выбрать
Два флагмана по одной цене, но с разными сильными сторонами: паритет в программировании, вдвое меньше галлюцинаций, контекст 1M — ответ зависит от вашего сценария
После выхода Kimi K3.1 Pro чаще всего спрашивают: как же выбрать между ним и Claude Opus 5.5. Официальные цены API у этих моделей почти одинаковы (вход $2 / выход $10 за 1M токенов), поэтому ответ не в цене, а в типе ваших задач. В этой статье разбираем по сценариям.
Сначала выводы
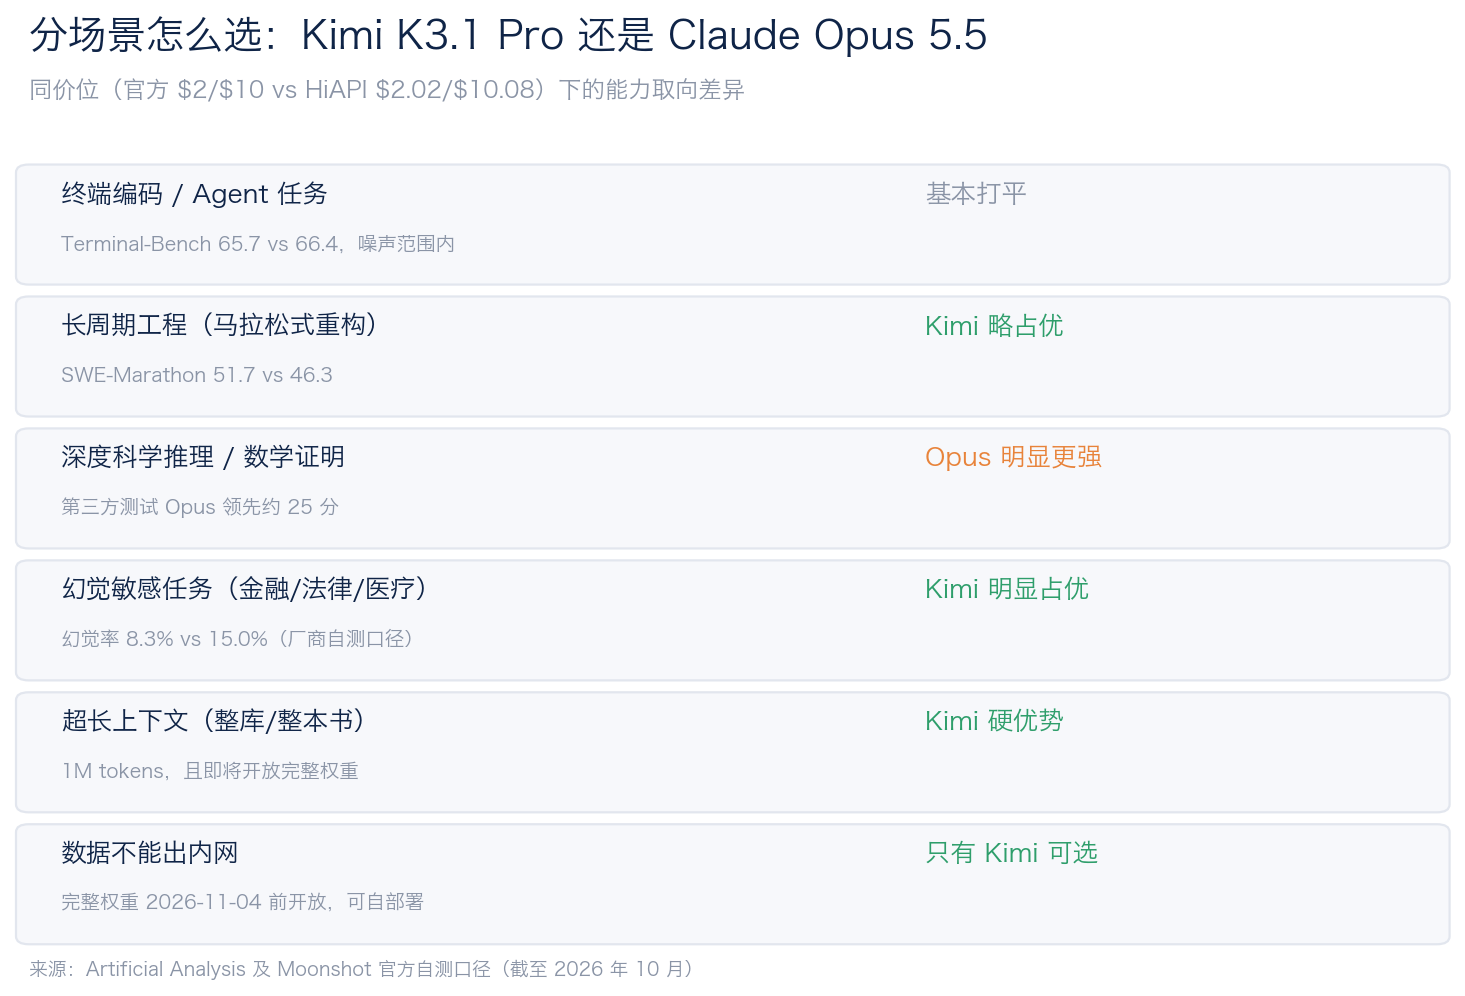
- Цены сравнялись: официально Kimi K3.1 Pro — $2/$10, а claude-opus-5-5 на HiAPI — $2.02/$10.08 (по состоянию на октябрь 2026). По одной цене сравнивают способности, а не экономию
- В программировании примерный паритет: Terminal-Bench 65.7 против 66.4, а на SWE-Marathon Kimi вырвался вперёд — 51.7 против 46.3
- Галлюцинации у Kimi заметно ниже: 8.3% против 15.0%, примерно вдвое
- Глубокое научное рассуждение явно сильнее у Opus: в сторонних тестах лидирует примерно на 25 баллов
- Уникальный козырь Kimi: контекст 1M и скорое открытие полных весов (обещано до 2026-11-04)
Сначала нужно прояснить важный методологический момент: большинство сравнительных цифр, гуляющих по сети, взяты из официальных самотестов Moonshot, причём Kimi по умолчанию работает на max effort, а Opus — на medium, так что условия не полностью равны. Совокупная оценка из нескольких сторонних источников согласуется: локальный вырвался вперёд, но в целом лидерства нет. Дальнейший анализ опирается на этот консенсус.
Контекст: AA-рейтинг поднялся до 4-го места, что улучшено в K3.1
В индексе интеллекта Artificial Analysis Kimi K3.1 Pro получил 55 баллов и занял 4-е место. Первые три места — Claude Opus 5.5 (58), Claude Sonnet 5.5 (56) и Muse Wonder Full (56). Предыдущее поколение K3 набрало 44 балла, то есть за это поколение добавлено сразу 11 баллов. Когда полные веса будут опубликованы по плану, это будет модель с открытыми весами с наивысшим баллом в рейтинге AA.
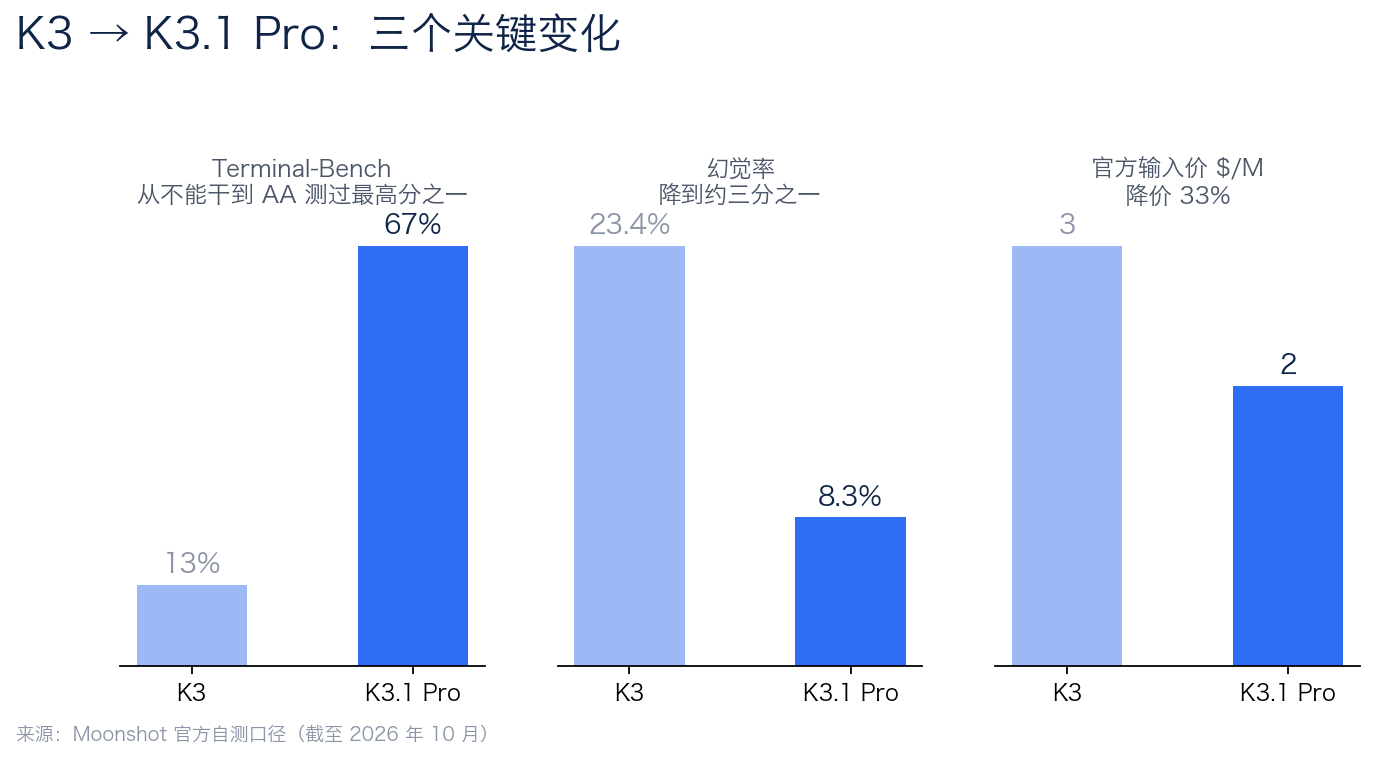
K3.1 Pro — это обновление K3 на этапе посттренировки, архитектура не изменилась: 2.8T общих параметров, MoE с 104B активных, контекст 1M, поддержка текста и изображений на входе (без аудио и видео). Улучшения сосредоточены в посттренировке, наибольшие изменения в трёх областях:
- Скачок в Agentic-программировании: Terminal-Bench с 13% до 67% — это переход от «не умеет» к «наивысшему баллу, который AA измерял на этом бенчмарке»
- Доля галлюцинаций сокращена до трети: с 23.4% до 8.3%
- Официальное снижение цены на 33%: с $3/$15 до $2/$10, скорость примерно удвоилась
Реакция китайского сообщества на релиз была прямой: 36kr сообщает, что квоты в день запуска «сгорели за 10 минут». Ажиотаж настоящий, но нам важнее, какую модель он сможет заменить в вашем повседневном рабочем процессе.
Сравнение по сценариям
Программирование и Agent-задачи: примерный паритет, разные акценты
Это самая неожиданная часть. На Terminal-Bench 4.0 K3.1 Pro получил 65.7% (по официальным самотестам Moonshot), у Opus 5.5 — 66.4%, разница в пределах шума. На более длительном SWE-Marathon Kimi вырвался вперёд: 51.7 против 46.3. В подрейтинге Agentic GDPval-AA от AA K3.1 Pro занимает 3-е место (1,846 Elo).
Если перевести на человеческий: если ваши Agent-задачи — это «многошаговая работа в терминале» или «марафонский крупный рефакторинг», обе модели справятся, и у Kimi есть небольшое преимущество на длинных задачах. Если вы активный пользователь Claude Code, можете обратиться к нашему прошлому практическому тесту: мы подключили Claude Code к API-ключу hiapi и прогнали его, и теперь в этом процессе появился ещё один кандидат.
Практическая рекомендация: в таких сценариях не верьте бенчмаркам — прогоните по 20 реальным задачам из вашего репозитория и используйте ту модель, у которой выше доля успешных прохождений. Модели по одной цене, так что стоимость канареечного теста двух моделей почти нулевая.
Глубокое рассуждение: Opus по-прежнему явно сильнее
Это та база, которую удерживает Opus 5.5. В сторонних тестах в глубоком научном рассуждении Opus лидирует примерно на 25 баллов; по совокупному индексу интеллекта Opus 58 против 55 — лидерство на 3 балла. Если ваша работа — математические доказательства, сложный научный анализ, многошаговые логические выводы, то разрыв здесь реальный, и K3.1 Pro пока его не догоняет.
Галлюцинации: у Kimi примерно вдвое меньше, чем у Opus
8.3% против 15.0% (по официальным самотестам Moonshot) — в сценариях, где нужна фактическая точность, такая разница качественная. Финансовые исследования, резюмирование юридических текстов, медицинские вопросы-ответы, базы знаний службы поддержки — в таких задачах, где «ошибка в одном слове требует переделки», низкая доля галлюцинаций ценнее, чем несколько лишних баллов в бенчмарке. Это также одно из самых больших улучшений K3.1 относительно K3 (23.4% → 8.3%).
Длинный контекст: 1M у Kimi — твёрдое преимущество
У обеих моделей есть способность к длинному контексту, но 1M токенов у Kimi K3.1 Pro спокойнее справляется со сценариями, где нужно скормить целую книгу, весь репозиторий кода или длинный финансовый отчёт. Что ещё важнее, скоро откроют полные веса: для команд, чьи данные не могут покинуть внутреннюю сеть, комбинация «открытые веса + контекст 1M + возможности флагманского уровня» — то, чего Opus 5.5 дать не может.
Цена и скорость
Сначала проясним цены (по состоянию на октябрь 2026):
| Модель | Официальный вход | Официальный выход | Цена на платформе HiAPI |
|---|---|---|---|
| Kimi K3.1 Pro | $2/M | $10/M | [$2.1548/$11.2714 (по состоянию на 2026-10): цена платформы, после запуска уточнить по /api/pricing и заполнить] |
| claude-opus-5-5 | — | — | $2.02 / $10.08 (чтение из кэша $0.10/M) |
У K3.1 Pro официально есть ещё цена попадания в кэш $0.20/M, а также вариант Highspeed ($4/$20, скорость в 2-3 раза выше), подходящий для онлайн-сценариев, чувствительных к задержке. Предыдущее поколение Kimi K3 на HiAPI стоит $2.1548/$11.2714 — для справки.
По скорости данные из разных источников расходятся в диапазоне 27-80 токенов/с — это скорее медленная категория, но вдвое быстрее K3. В расчёте стоимости на задачу от AA K3.1 Pro стоит $1.98, столько же, сколько K3, и с учётом роста возможностей соотношение цена-качество улучшилось.
Итог по ценовому сегменту в одну фразу: это не «дешёвый претендент против дорогого эталона», а в той же ценовой категории обмен более низкой доли галлюцинаций и более длинного контекста на более слабое глубокое рассуждение.
Как выбрать: ответ по сценариям
Выбирайте Kimi K3.1 Pro, если:
- Ваши задачи — Agentic-программирование, работа в терминале, длительный цикл разработки ПО
- Вам критически важна доля галлюцинаций (финансы, право, медицина, вопросы-ответы по базе знаний)
- Вам нужен контекст 1M для обработки целых материалов
- Вам нужен self-hosting (ждать открытия весов) или требуется аудируемость открытых весов
Выбирайте Claude Opus 5.5, если:
- В основе вашей работы — глубокое научное рассуждение, сложная математика, многошаговая логика
- Вам нужна зрелость, проверенная более длительным временем
- Ваш рабочий процесс уже глубоко привязан к экосистеме Anthropic
Прагматичный подход, охватывающий оба варианта: одна цена означает, что можно маршрутизировать по задачам — задачи рассуждения направлять в Opus, программирование и фактические вопросы-ответы — в Kimi. Чтобы узнать полные границы возможностей Opus 5.5, смотрите его страницу с описанием модели.
Частые вопросы
Что лучше пишет код — Kimi K3.1 Pro или Claude Opus 5.5?
Примерный паритет. На Terminal-Bench 4.0 — 65.7 против 66.4 (официальные самотесты Moonshot), на более длительном SWE-Marathon Kimi вырвался вперёд — 51.7 против 46.3. На самом деле стоит прогнать обе модели на вашем собственном наборе задач, а не смотреть только на рейтинги.
Действительно ли у Kimi K3.1 Pro доля галлюцинаций ниже, чем у Opus 5.5?
По официальным самотестам Moonshot — 8.3% против 15.0%, примерно вдвое. По этому отдельному показателю сторонние подтверждения относительно весомы, и это самое обоснованное преимущество K3.1. Но учтите, что при самотестах Kimi работает на max effort, и настройка effort при реальном развёртывании влияет на результаты.
Каково контекстное окно Kimi K3.1 Pro?
1M токенов, на входе текст и изображения. Скармливание целых материалов и всего репозитория кода — его сильная сторона. У Opus 5.5 длинный контекст тоже неплох, но по объёму Kimi просторнее.
Откроет ли Kimi K3.1 Pro веса?
Moonshot уже обещал открыть полные веса до 2026-11-04. После выполнения обещания это будет модель с открытыми весами с наивысшим баллом в рейтинге AA. Для команд, которым нужно приватное развёртывание, это железный аргумент в её пользу.
Сколько стоит API Kimi K3.1 Pro?
Официальная цена $2 за вход, $10 за выход (за 1M токенов), попадание в кэш $0.20, а также вариант Highspeed $4/$20 (в 2-3 раза быстрее). Цена на платформе HiAPI [$2.1548/$11.2714 (по состоянию на 2026-10): цена платформы, после запуска уточнить по /api/pricing и заполнить].
При том же бюджете как выгоднее всего сочетать две модели?
Маршрутизация по задачам: глубокое рассуждение — в Opus 5.5, программирование, фактические вопросы-ответы и длинные документы — в Kimi. Цена за единицу у них почти одинакова, дополнительные затраты на маршрутизацию — это в основном трудозатраты на поддержку двух наборов вызовов.
Ключевые выводы
Kimi K3.1 Pro и Claude Opus 5.5 — два разных ответа в одной ценовой категории. Kimi обменивает преимущество Opus в глубоком рассуждении на низкую долю галлюцинаций, контекст 1M, Agentic-программирование и скорое открытие весов. Ни одна модель не лучше во всех сценариях, и консенсус сторонних источников — локальный вырвался вперёд, а не полное лидерство. Маршрутизируйте по типу задач или сначала проведите реальный тест на наборе задач — это надёжнее любого рейтинга. На HiAPI claude-opus-5-5 уже можно запускать, а до выхода kimi-k3.1-pro можно сначала отладить процесс на kimi-k3.
Статьи этой серии
Похожие статьи
Все статьи →-

Сравнительный обзор
Wan 2.6 Flash против Wan 2.7: стоит ли обновляться?
720P-бюджет и готовые ролики 1080P с лисой и автомобилем; для каждой группы указаны аудиоусловия и фактический тариф.
-

Сравнительный обзор
Vidu Q4 Preview vs Kling 3.0: как выбрать генерацию видео из изображения?
Для звука по умолчанию, 16 секунд и 5 разрешений выбирайте Vidu Q4 Preview; для фиксации кадра начальным и конечным изображениями — Kling 3.0. В комплекте два сравнения с одинаковым промптом: гидросамолёт и бариста.
-

Сравнительный обзор
Альтернатива Replicate: сравнение hiapi и Replicate для генерации изображений и видео (2026)
Что нужно изменить в вызовах прогнозов, webhook и тарификации при переходе с Replicate на hiapi, плюс чек-лист миграции из 10 шагов.