
비교 평가
Kimi K3.1 Pro vs Opus 5.5: 어떻게 선택할까
같은 가격대, 서로 다른 강점을 가진 두 플래그십: 코딩 대등, 환각률 절반, 1M 컨텍스트, 여러분의 시나리오가 답을 결정합니다
Kimi K3.1 Pro가 출시된 후 가장 많이 받는 질문은 바로 이것입니다: Claude Opus 5.5와 도대체 어떻게 선택해야 하는가. 두 모델의 공식 API 가격은 거의 똑같기 때문에(입력 $2 / 출력 $10, 1M tokens당) 답은 가격이 아니라 여러분의 작업 유형에 있습니다. 이 글은 시나리오별로 나누어 설명합니다.
먼저 결론부터
- 가격 대등: Kimi K3.1 Pro 공식 $2/$10, HiAPI의 claude-opus-5-5는 $2.02/$10.08(2026년 10월 기준). 같은 가격대에서는 비용 절감이 아니라 능력 지향을 비교하는 것입니다
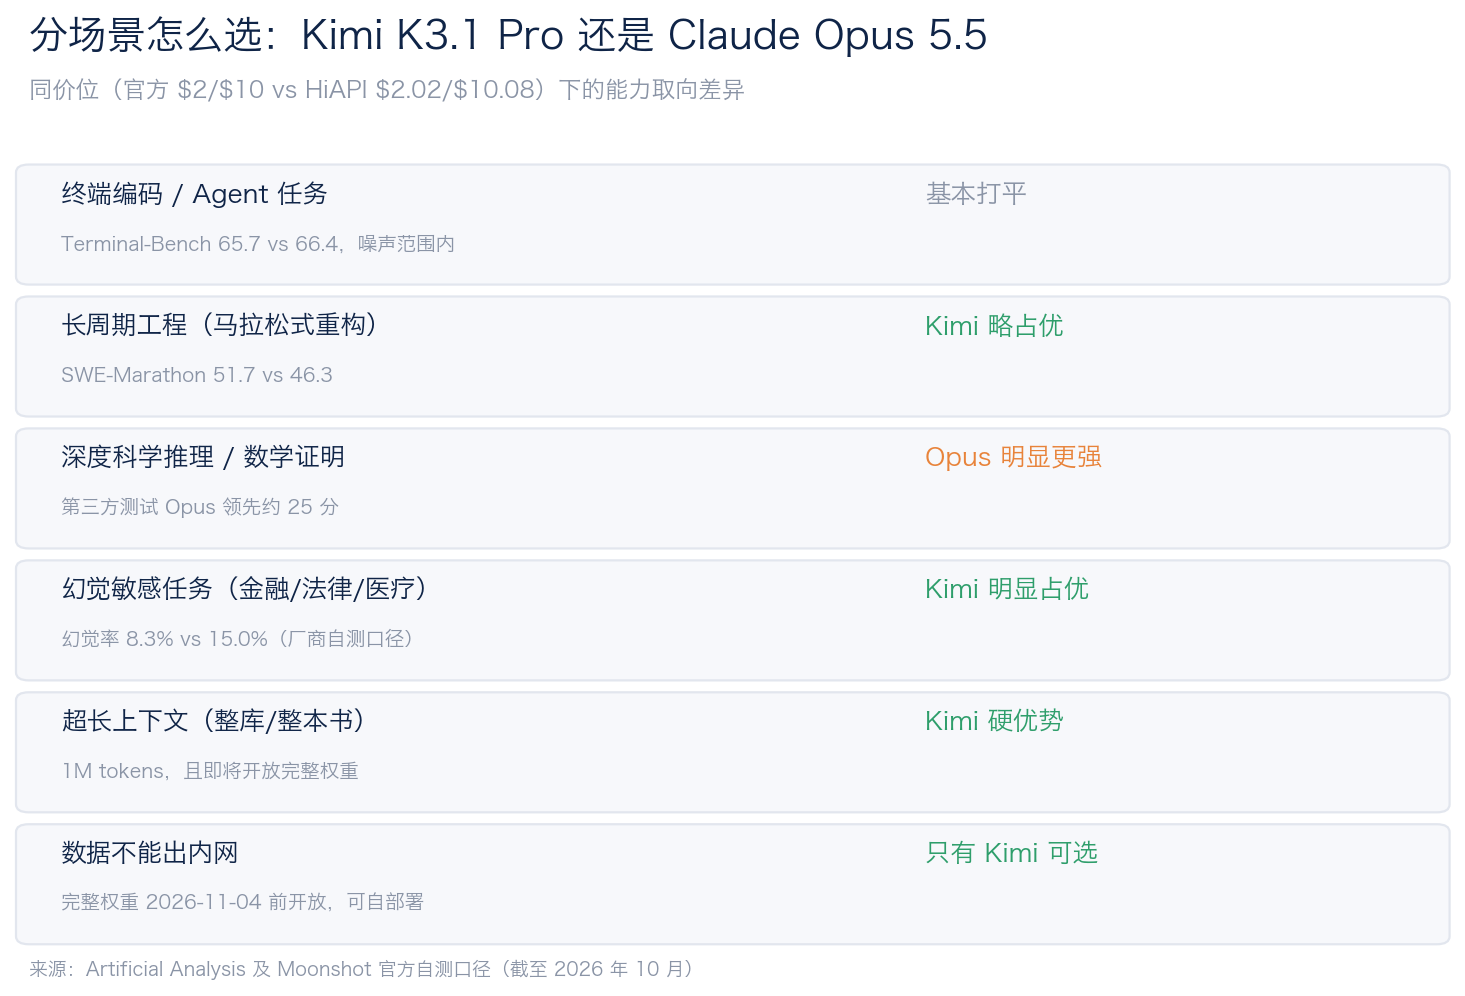
- 코딩 사실상 대등: Terminal-Bench에서 65.7 대 66.4, Kimi는 SWE-Marathon에서 51.7 대 46.3으로 앞섰습니다
- 환각률 Kimi가 확실히更低: 8.3% 대 15.0%, 약 절반
- 심층 과학 추론 Opus가 확실히更强: 제3자 테스트에서 약 25점 앞섬
- Kimi만의 강점: 1M 컨텍스트, 곧 전체 가중치 공개 예정(2026-11-04 이전 약속)
먼저 짚고 넘어가야 할 전제가 있습니다: 인터넷에 유포된 비교 수치 대부분은 Moonshot 공식 자체 테스트에서 나온 것이고, Kimi는 기본적으로 max effort로, Opus는 기본적으로 medium으로 실행되기 때문에 양측의 화력이 완전히 대등하지는 않습니다. 여러 제3자 소스의 종합 판단은 일치합니다: 부분적 역전, 전체적 미도달. 아래 분석은 모두 이 합의를 전제로 합니다.
배경: AA 리더보드 4위, K3.1에서 무엇이 업그레이드되었나
Artificial Analysis의 지능 지수에서 Kimi K3.1 Pro는 55점을 받아 4위입니다. 상위 3개는 Claude Opus 5.5(58), Claude Sonnet 5.5(56), Muse Wonder Full(56)입니다. 이전 세대 K3는 44점이었으니, 이번 세대에 한 번에 11점을 따라잡은 셈입니다. 전체 가중치가 예정대로 공개되면 AA 리더보드에서 점수가 가장 높은 오픈 가중치 모델이 됩니다.
K3.1 Pro는 K3의 후속 학습(post-training) 업그레이드 버전으로 아키텍처는 변하지 않았습니다: 총 파라미터 2.8T, 활성 104B의 MoE, 1M 컨텍스트, 텍스트와 이미지 입력 지원(음성·영상 제외). 업그레이드는 후속 학습에 집중되었고, 가장 큰 변화는 세 가지입니다:
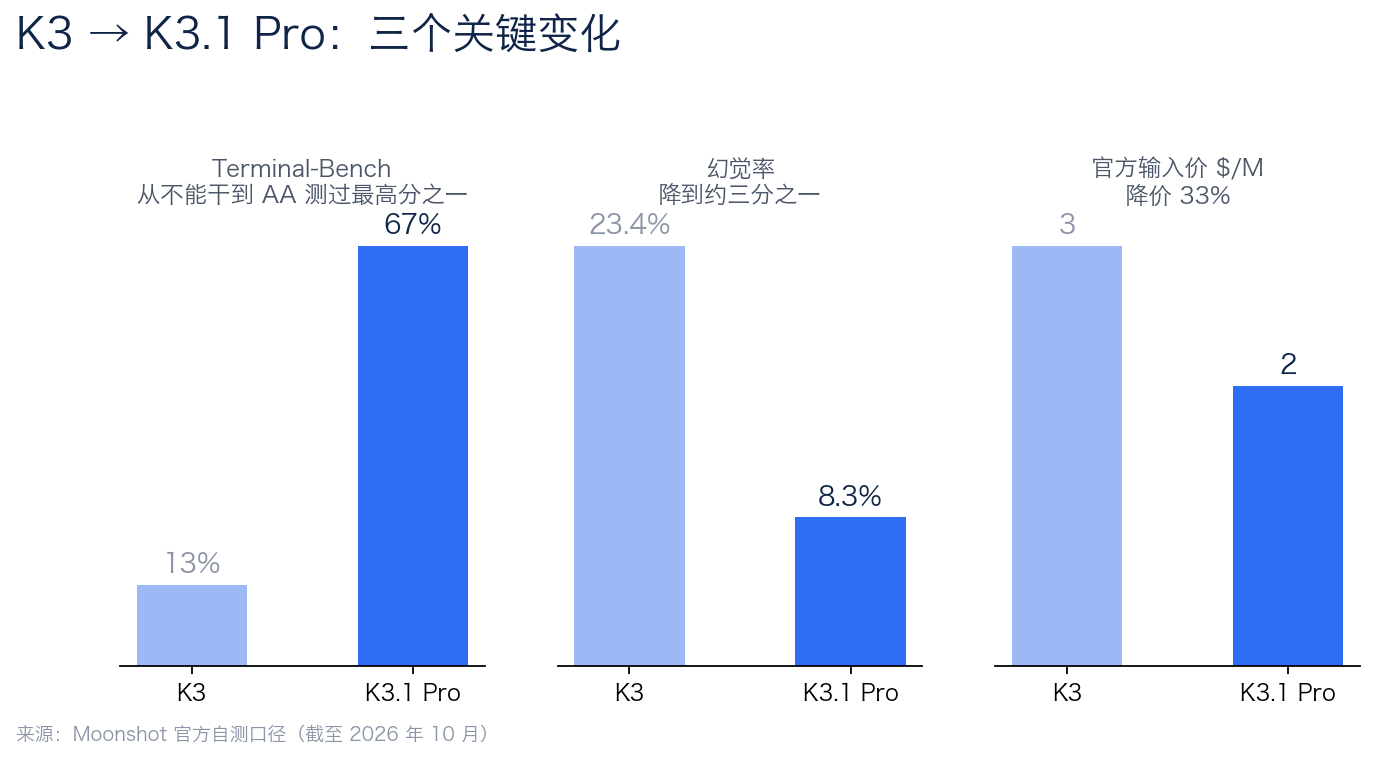
- Agentic 코딩 도약: Terminal-Bench가 13%에서 67%로 상승, 이는 '못 한다'에서 'AA가 해당 벤치마크에서 측정한 최고 점수'로의 도약입니다
- 환각률 3분의 1로 감소: 23.4%에서 8.3%로
- 공식 가격 33% 인하: $3/$15에서 $2/$10로, 속도는 약 2배 향상
중국어 커뮤니티의 반응은 매우 직접적이었습니다: 36kr은 출시 당일 할당량이 '10분 만에 소진'되었다고 보도했습니다. 화제성은 사실이지만, 우리는 이것이 일상 워크플로에서 어떤 모델을 대체할 수 있는지에 더 관심이 있습니다.
시나리오 비교
코딩 및 Agent 작업: 사실상 대등, 지향은 다름
이 부분이 가장 의외입니다. Terminal-Bench 4.0에서 K3.1 Pro는 65.7%(Moonshot 공식 자체 테스트 기준), Opus 5.5는 66.4%로 차이는 노이즈 범위 내입니다. 더 긴 주기의 SWE-Marathon에서는 Kimi가 51.7 대 46.3으로 앞섰습니다. AA의 Agentic 세부 리더보드 GDPval-AA에서 K3.1 Pro는 3위(1,846 Elo)입니다.
쉽게 말하면: 여러분의 Agent 작업이 '터미널에서 다단계 작업'이거나 '마라톤식 대규모 리팩터링'이라면 두 모델 모두 감당할 수 있고, Kimi는 긴 작업에서 약간 우세합니다. Claude Code의 헤비 유저라면 이전 실측을 참고하세요: Claude Code를 hiapi의 API Key에 연결해 한 바퀴 돌려보았습니다, 그 프로세스에 이제 후보 모델이 하나 더 생겼습니다.
실전 조언: 이런 시나리오에서는 벤치마크를 믿지 말고, 여러분 저장소의 실제 20개 작업을 각각 돌려보고 통과율이 높은 쪽을 쓰세요. 두 모델이 같은 가격대이므로 듀얼 모델 그레이딩 비용은 거의 제로입니다.
심층 추론: Opus가 여전히 확실히更强
이 부분은 Opus 5.5가 지키는 기본 영역입니다. 제3자 테스트에서 심층 과학 추론은 Opus가 약 25점 앞서고, 종합 지능 지수는 Opus 58 대 55로 3점 앞섭니다. 여러분의 업무가 수학 증명, 복잡한 과학 분석, 다중 홉 논리 추론이라면 이 격차는 실재하며 K3.1 Pro는 당분간 따라잡지 못합니다.
환각률: Kimi가 Opus의 약 절반
8.3% 대 15.0%(Moonshot 공식 자체 테스트 기준), 이 격차는 사실 정확성이 필요한 시나리오에서 질적 변화입니다. 금융 리서치, 법률 텍스트 요약, 의료 Q&A, 고객센터 지식베이스처럼 '한 글자만 틀려도 재작업'이 필요한 작업에서는 낮은 환각률이 벤치마크 몇 점보다 훨씬 가치 있습니다. 이는 K3.1이 K3 대비 가장 크게 개선된 단일 항목 중 하나이기도 합니다(23.4% → 8.3%).
긴 컨텍스트: Kimi의 1M은 확실한 우위
두 모델 모두 긴 컨텍스트 능력을 갖추고 있지만, Kimi K3.1 Pro의 1M tokens는 책 한 권, 코드베이스 전체, 긴 재무보고서를 먹이는 시나리오에서 더 여유롭습니다. 더 중요한 것은 곧 전체 가중치를 공개한다는 점입니다: 데이터를 내부망 밖으로 내보낼 수 없는 팀에게 '오픈소스 + 1M 컨텍스트 + 플래그십급 능력'이라는 조합은 Opus 5.5가 줄 수 없습니다.
가격과 속도
먼저 가격을 명확히 정리합니다(2026년 10월 기준):
| 모델 | 공식 입력 | 공식 출력 | HiAPI 플랫폼 가격 |
|---|---|---|---|
| Kimi K3.1 Pro | $2/M | $10/M | [$2.1548/$11.2714(2026-10 기준):플랫폼 가격, 출시 후 /api/pricing 확인하여 재기입] |
| claude-opus-5-5 | — | — | $2.02 / $10.08(캐시 읽기 $0.10/M) |
K3.1 Pro 공식에는 캐시 적중 가격 $0.20/M도 있고, Highspeed 변형($4/$20, 속도 2-3배)은 지연에 민감한 온라인 시나리오에 적합합니다. 이전 세대 Kimi K3는 HiAPI에서 $2.1548/$11.2714이니 참고하세요.
속도는 소스마다 27-80 tokens/초로 엇갈리며 느린 편에 속하지만, K3보다는 두 배 빨라졌습니다. AA의 작업당 비용 산정에서 K3.1 Pro는 $1.98로 K3와 동일하며, 능력 향상을 고려하면 가성비는 개선된 것입니다.
가격대를 한 문장으로 요약하면: 이것은 '싼 도전자가 비싼 기준을 치는' 것이 아니라, 같은 가격대에서 더 낮은 환각률과 더 긴 컨텍스트로 더 약한 심층 추론을 맞바꾸는 것입니다.
어떻게 선택할까: 시나리오별 답
Kimi K3.1 Pro를 선택하세요, 만약:
- 여러분의 작업이 Agentic 코딩, 터미널 조작, 장기 소프트웨어 엔지니어링이라면
- 환각률을 극도로 중시한다면(금융, 법률, 의료, 지식베이스 Q&A)
- 1M 컨텍스트로 자료 전체를 처리해야 한다면
- 자체 호스팅이 필요하거나(가중치 공개 대기) 오픈 가중치의 감사 가능성을 요구한다면
Claude Opus 5.5를 선택하세요, 만약:
- 핵심이 심층 과학 추론, 복잡한 수학, 다중 홉 논리라면
- 더 오랜 기간 검증된 성숙도를 원한다면
- 워크플로가 이미 Anthropic 생태계에 깊이 묶여 있다면
양쪽을 모두 취하는 실용적 방법: 같은 가격대라는 것은 작업별 라우팅이 가능하다는 뜻입니다. 추론 작업은 Opus, 코딩과 사실 Q&A는 Kimi로 보내세요. Opus 5.5의 전체 능력 경계를 알고 싶다면 모델 상세 페이지를 보세요.
자주 묻는 질문
Kimi K3.1 Pro와 Claude Opus 5.5 중 어느 것이 코드를 더 잘 작성하나요?
사실상 대등합니다. Terminal-Bench 4.0에서 65.7 대 66.4(Moonshot 공식 자체 테스트), 더 긴 주기의 SWE-Marathon에서는 Kimi가 51.7 대 46.3으로 앞섰습니다. 정말 해야 할 일은 여러분 자신의 작업 세트로 각각 돌려보는 것이지, 리더보드만 보는 것이 아닙니다.
Kimi K3.1 Pro의 환각률이 정말 Opus 5.5보다 낮나요?
Moonshot 공식 자체 테스트 기준으로 8.3% 대 15.0%, 약 절반입니다. 이 항목의 제3자 뒷받침은 상대적으로 충분하며 K3.1의 가장 탄탄한 강점입니다. 다만 자체 테스트 기준에서 Kimi는 max effort로 실행되므로, 실제 배포 시 effort 설정이 성능에 영향을 줄 수 있습니다.
Kimi K3.1 Pro의 컨텍스트 윈도우는 얼마나 되나요?
1M tokens, 텍스트와 이미지 입력을 지원합니다. 자료 전체, 코드베이스 전체를 먹이는 것이 강점입니다. Opus 5.5의 긴 컨텍스트 능력도 괜찮지만, 규모 면에서 Kimi가 더 여유롭습니다.
Kimi K3.1 Pro는 가중치를 공개하나요?
Moonshot은 2026-11-04 이전에 전체 가중치를 공개하겠다고 약속했습니다. 이행되면 AA 리더보드에서 점수가 가장 높은 오픈 가중치 모델이 됩니다. 프라이빗 배포가 필요한 팀에게 이것은 선택의 확고한 이유입니다.
Kimi K3.1 Pro API 가격은 얼마인가요?
공식 가격은 $2/입력, $10/출력(1M tokens당), 캐시 적중 $0.20, 별도로 Highspeed 변형 $4/$20(2-3배 빠름)이 있습니다. HiAPI 플랫폼 가격은 [$2.1548/$11.2714(2026-10 기준):플랫폼 가격, 출시 후 /api/pricing 확인하여 재기입]입니다.
같은 예산으로 두 모델을 어떻게 조합하는 것이 가장 경제적인가요?
작업별 라우팅: 심층 추론은 Opus 5.5, 코딩·사실 Q&A·긴 문서는 Kimi. 두 모델의 단가가 거의 같으므로 라우팅의 추가 비용은 주로 두 세트의 호출을 유지하는 엔지니어링 노력입니다.
핵심 결론
Kimi K3.1 Pro와 Claude Opus 5.5는 같은 가격대의 두 가지 다른 답입니다. Kimi는 낮은 환각률, 1M 컨텍스트, Agentic 코딩 및 곧 다가올 오픈 가중치로 Opus의 심층 추론 우위를 맞바꿉니다. 모든 시나리오에서 더 나은 모델은 없으며, 제3자 합의도 전체 우위가 아닌 부분적 역전입니다. 작업 유형별로 라우팅하거나, 먼저 실제 작업 세트로 한 라운드 실측하는 것이 어떤 리더보드보다 신뢰할 만합니다. HiAPI에서는 claude-opus-5-5가 이미 실행 가능하며, kimi-k3.1-pro 출시 전에는 kimi-k3로 먼저 프로세스를 검증할 수 있습니다.
같은 시리즈 글
관련 글
모든 아티클 보기 →-

비교 평가
Wan 2.6 Flash vs Wan 2.7: 업그레이드해야 할까?
720P 예산과 1080P 여우·자동차 완성본; 그룹별 오디오 조건과 실제 등급 표기.
-

비교 평가
Vidu Q4 Preview vs Kling 3.0: 이미지-투-비디오, 어떻게 선택할까?
기본 유음, 16초, 5단계 해상도가 필요하면 Vidu Q4 Preview, 첫/마지막 프레임으로 화면을 고정하려면 Kling 3.0. 수상 비행기와 바리스타 두 그룹의 동일 프롬프트 대조 포함.
-

비교 평가
Replicate 대안: hiapi vs Replicate 이미지 및 영상 생성 비교 (2026)
Replicate에서 hiapi로 마이그레이션할 때 예측 호출, webhook, 과금을 각각 어떻게 바꿔야 하는지, 10단계 마이그레이션 체크리스트 포함.