
Comparativa
Kimi K3.1 Pro vs Opus 5.5: cómo elegir
Dos modelos insignia al mismo precio con fortalezas distintas: programación empatada, tasa de alucinación a la mitad, contexto de 1M; tu escenario decide la respuesta
Tras el lanzamiento de Kimi K3.1 Pro, la pregunta más frecuente es: ¿cómo elegir entre él y Claude Opus 5.5? El precio oficial de la API de ambos modelos es prácticamente idéntico ($2 de entrada / $10 de salida por 1M tokens), así que la respuesta no está en el precio, sino en el tipo de tarea. Este artículo lo desglosa por escenarios.
Primero, la conclusión
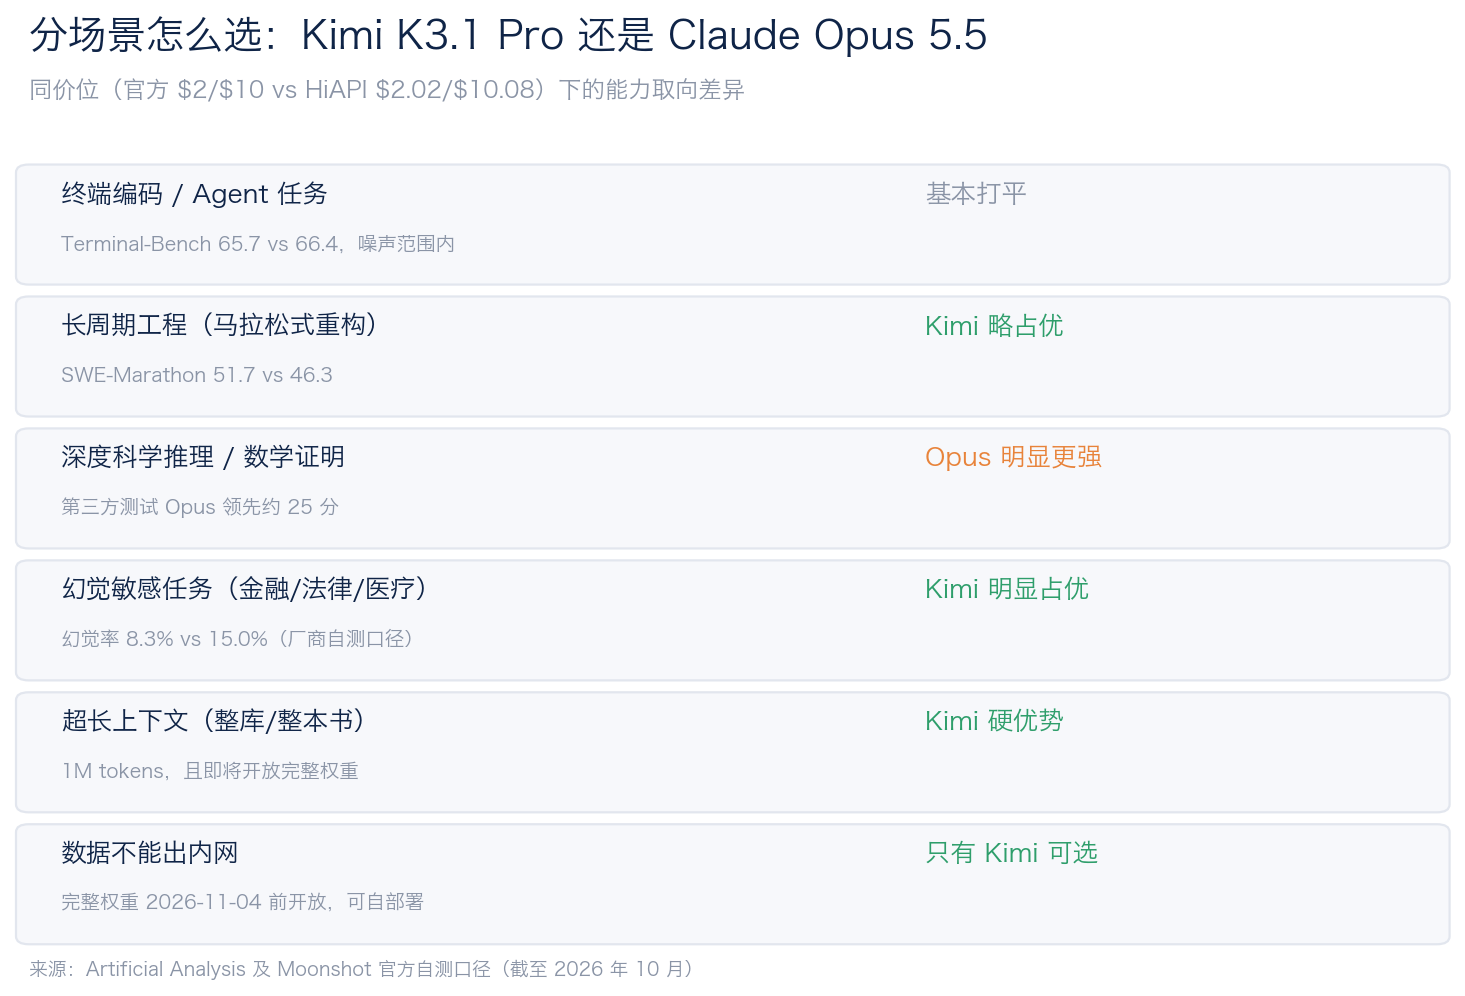
- Precio empatado: Kimi K3.1 Pro oficial $2/$10, claude-opus-5-5 en HiAPI es $2.02/$10.08 (a octubre de 2026). A igual precio se compara la orientación de capacidades, no el ahorro
- Programación prácticamente empatada: en Terminal-Bench 65.7 frente a 66.4; Kimi supera en SWE-Marathon 51.7 frente a 46.3
- Tasa de alucinación claramente menor en Kimi: 8.3% frente a 15.0%, aproximadamente la mitad
- Razonamiento científico profundo claramente más fuerte en Opus: ventaja de unos 25 puntos en pruebas de terceros
- Las cartas exclusivas de Kimi: contexto de 1M y apertura inminente de los pesos completos (compromiso antes del 2026-11-04)
Una cuestión de criterio que hay que aclarar primero: la mayoría de las cifras comparativas que circulan en la red provienen de autoevaluaciones oficiales de Moonshot, y Kimi se ejecuta por defecto en max effort mientras que Opus lo hace en medium, por lo que la potencia de ambos no es del todo equivalente. El juicio conjunto de múltiples fuentes de terceros es consistente: superación puntual, sin liderazgo global. El análisis siguiente se basa en este consenso.
Contexto: cuarto puesto en la tabla AA, qué mejoró K3.1
En el índice de inteligencia de Artificial Analysis, Kimi K3.1 Pro obtiene 55 puntos y se sitúa cuarto. Los tres primeros son Claude Opus 5.5 (58), Claude Sonnet 5.5 (56) y Muse Wonder Full (56). La generación anterior, K3, tenía 44 puntos, es decir, esta generación ha recortado 11 puntos de golpe. Cuando los pesos completos se publiquen según lo previsto, será el modelo de pesos abiertos con mayor puntuación en la tabla AA.
K3.1 Pro es una versión mejorada de K3 mediante post-entrenamiento, sin cambios de arquitectura: 2.8T de parámetros totales, MoE con 104B activos, contexto de 1M, admite entrada de texto e imágenes (sin audio ni vídeo). Las mejoras se concentran en el post-entrenamiento, y los tres cambios más importantes son:
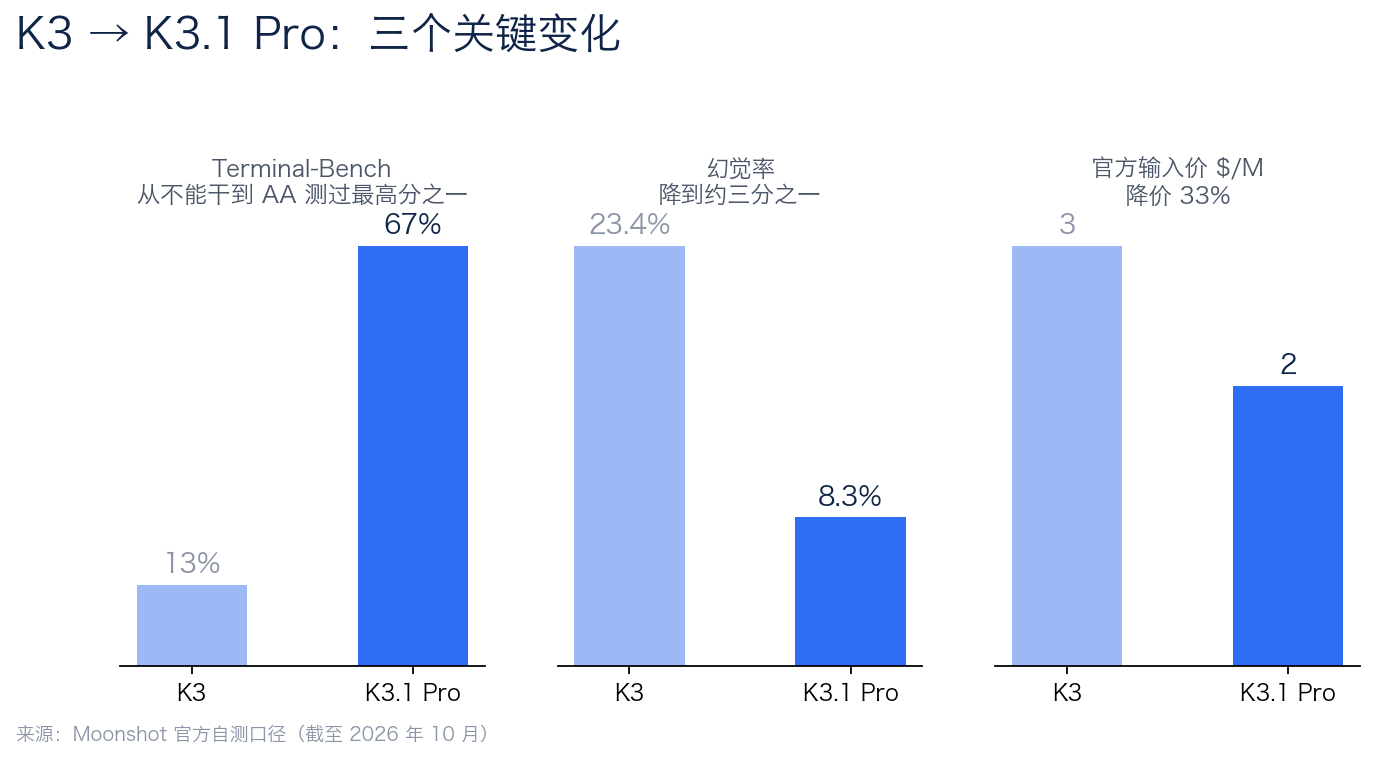
- Salto en programación agéntica: Terminal-Bench pasa del 13% al 67%, un salto de «no sirve» a «la puntuación más alta que AA ha medido en este benchmark»
- Tasa de alucinación reducida a un tercio: del 23.4% al 8.3%
- Recorte oficial de precio del 33%: de $3/$15 a $2/$10, con una velocidad aproximadamente duplicada
La reacción de la comunidad china al lanzamiento fue muy directa: 36kr informó que la cuota se «agotó en 10 minutos» el día del lanzamiento. La expectación es real, pero nos interesa más qué modelo puede sustituir en tu flujo de trabajo diario.
Comparación por escenarios
Programación y tareas de agente: prácticamente empatados, con enfoques distintos
Esta es la parte más sorprendente. En Terminal-Bench 4.0, K3.1 Pro obtiene un 65.7% (según la autoevaluación oficial de Moonshot), y Opus 5.5 un 66.4%, una diferencia dentro del margen de ruido. En el SWE-Marathon, de ciclo más largo, Kimi supera con 51.7 frente a 46.3. En la subcategoría agéntica GDPval-AA de AA, K3.1 Pro ocupa el tercer puesto (1,846 Elo).
Traducido a lenguaje llano: si tu tarea de agente consiste en «realizar trabajo de varios pasos en la terminal» o en «refactorizaciones grandes tipo maratón», ambos modelos pueden con ello, y Kimi tiene incluso una ligera ventaja en tareas largas. Si eres un usuario intensivo de Claude Code, puedes consultar nuestra prueba anterior: conectamos Claude Code a la API Key de hiapi y lo ejecutamos, ese flujo ahora tiene un modelo candidato más.
Recomendación práctica: en este tipo de escenarios no te fíes de los benchmarks; ejecuta 20 tareas reales de tu repositorio y usa el que tenga mayor tasa de éxito. Ambos modelos cuestan lo mismo, así que el coste de un despliegue en gris con ambos modelos es casi nulo.
Razonamiento profundo: Opus sigue siendo claramente más fuerte
Este es el terreno que Opus 5.5 defiende. En pruebas de terceros, Opus lidera por unos 25 puntos en razonamiento científico profundo; en el índice de inteligencia global, Opus 58 frente a 55, una ventaja de 3 puntos. Si tu trabajo consiste en demostraciones matemáticas, análisis científico complejo o deducción lógica de múltiples saltos, la diferencia en este nivel es real y K3.1 Pro aún no puede alcanzarla.
Tasa de alucinación: Kimi es aproximadamente la mitad que Opus
8.3% frente a 15.0% (según la autoevaluación oficial de Moonshot); esta diferencia es cualitativa en escenarios que requieren exactitud factual. En investigación financiera, resúmenes de textos legales, preguntas y respuestas médicas o bases de conocimiento de atención al cliente, tareas en las que «un solo error obliga a rehacer el trabajo», una baja tasa de alucinación vale mucho más que unos puntos de benchmark. Este es también uno de los aspectos en los que K3.1 más ha mejorado respecto a K3 (23.4% → 8.3%).
Contexto largo: el 1M de Kimi es una ventaja firme
Ambos modelos tienen capacidad de contexto largo, pero los 1M tokens de Kimi K3.1 Pro son más holgados en escenarios de alimentar un libro entero, un repositorio de código completo o informes financieros extensos. Más importante aún: abrirá pronto los pesos completos, y para equipos cuyos datos no pueden salir de la red interna, la combinación «código abierto + contexto de 1M + capacidad de nivel insignia» es algo que Opus 5.5 no puede ofrecer.
Precio y velocidad
Primero, aclaremos los precios (a octubre de 2026):
| Modelo | Entrada oficial | Salida oficial | Precio en la plataforma HiAPI |
|---|---|---|---|
| Kimi K3.1 Pro | $2/M | $10/M | [$2.1548/$11.2714 (a 2026-10): precio de plataforma, verificar y rellenar desde /api/pricing tras el lanzamiento] |
| claude-opus-5-5 | — | — | $2.02 / $10.08 (lectura de caché $0.10/M) |
K3.1 Pro tiene además un precio oficial de acierto de caché de $0.20/M, y una variante Highspeed ($4/$20, 2-3 veces más rápida), adecuada para escenarios en línea sensibles a la latencia. La generación anterior, Kimi K3, cuesta $2.1548/$11.2714 en HiAPI, como referencia.
En cuanto a velocidad, las fuentes manejan cifras de entre 27 y 80 tokens/segundo, lo que lo sitúa en la franja lenta, pero el doble de rápido que K3. En el cálculo de coste por tarea de AA, K3.1 Pro es $1.98, igual que K3; considerando la mejora de capacidades, la relación calidad-precio ha mejorado.
Resumen del apartado de precios en una frase: no es «un retador barato contra un referente caro», sino que a igual precio se cambia una menor tasa de alucinación y un contexto más largo por un razonamiento profundo más débil.
Cómo elegir: respuesta por escenario
Elige Kimi K3.1 Pro si:
- Tus tareas son programación agéntica, operación en terminal o ingeniería de software de ciclo largo
- Te importa enormemente la tasa de alucinación (finanzas, legal, medicina, preguntas y respuestas sobre bases de conocimiento)
- Necesitas un contexto de 1M para procesar materiales completos
- Necesitas autohospedaje (a la espera de los pesos abiertos) o exiges pesos abiertos auditables
Elige Claude Opus 5.5 si:
- Tu núcleo es el razonamiento científico profundo, las matemáticas complejas o la lógica de múltiples saltos
- Buscas una madurez contrastada durante más tiempo
- Tu flujo de trabajo ya está profundamente vinculado al ecosistema de Anthropic
Enfoque pragmático para cubrir ambos frentes: a igual precio se puede enrutar por tarea; las tareas de razonamiento van a Opus, y la programación y las preguntas factuales a Kimi. Para conocer los límites completos de capacidades de Opus 5.5, consulta su página de detalles del modelo.
Preguntas frecuentes
¿Qué modelo escribe mejor código, Kimi K3.1 Pro o Claude Opus 5.5?
Prácticamente empatados. En Terminal-Bench 4.0, 65.7 frente a 66.4 (autoevaluación oficial de Moonshot); en el SWE-Marathon, de ciclo más largo, Kimi supera 51.7 frente a 46.3. Lo que realmente deberías hacer es ejecutar tu propio conjunto de tareas en ambos, no mirar solo los rankings.
¿Es realmente menor la tasa de alucinación de Kimi K3.1 Pro que la de Opus 5.5?
Según la autoevaluación oficial de Moonshot, 8.3% frente a 15.0%, aproximadamente la mitad. La corroboración de terceros en este aspecto concreto es relativamente sólida y constituye la ventaja más defendible de K3.1. No obstante, hay que tener en cuenta que en la autoevaluación Kimi se ejecuta en max effort, y la configuración de effort en el despliegue real afectará al rendimiento.
¿Qué tamaño tiene la ventana de contexto de Kimi K3.1 Pro?
1M tokens, con entrada de texto e imágenes. Procesar materiales completos o repositorios de código enteros es su punto fuerte. La capacidad de contexto largo de Opus 5.5 también es buena, pero en magnitud Kimi es más holgado.
¿Abrirá sus pesos Kimi K3.1 Pro?
Moonshot se ha comprometido a abrir los pesos completos antes del 2026-11-04. Una vez cumplido, será el modelo de pesos abiertos con mayor puntuación en la tabla AA. Para los equipos que necesitan despliegue privado, esta es una razón de peso para elegirlo.
¿Cuánto cuesta la API de Kimi K3.1 Pro?
Precio oficial $2 de entrada y $10 de salida (por 1M tokens), acierto de caché $0.20, y una variante Highspeed a $4/$20 (2-3 veces más rápida). Precio en la plataforma HiAPI [$2.1548/$11.2714 (a 2026-10): precio de plataforma, verificar y rellenar desde /api/pricing tras el lanzamiento].
Con el mismo presupuesto, ¿cómo combinar ambos modelos de la forma más rentable?
Enrutando por tarea: el razonamiento profundo va a Opus 5.5, y la programación, las preguntas factuales y los documentos largos a Kimi. El precio unitario de ambos es casi idéntico; el coste adicional del enrutamiento es principalmente el esfuerzo de ingeniería de mantener dos conjuntos de llamadas.
Conclusiones clave
Kimi K3.1 Pro y Claude Opus 5.5 son dos respuestas distintas al mismo precio. Kimi cambia la ventaja de razonamiento profundo de Opus por una baja tasa de alucinación, un contexto de 1M, programación agéntica y la próxima apertura de pesos. Ningún modelo es mejor en todos los escenarios, y el consenso de terceros también es una superación puntual, no un liderazgo global. Enrutar según tu tipo de tarea, o hacer primero una ronda de pruebas reales con tu conjunto de tareas, es más fiable que mirar cualquier ranking. En HiAPI, claude-opus-5-5 ya está disponible para ejecutar; antes del lanzamiento de kimi-k3.1-pro, puedes usar kimi-k3 para poner a punto el flujo.
Artículos de la misma serie
Artículos relacionados
Ver todos los artículos →-

Comparativa
Wan 2.6 Flash vs Wan 2.7: ¿conviene actualizar?
Presupuesto en 720P y resultados en 1080P del zorro y el coche; condiciones de audio y nivel real indicados grupo por grupo.
-

Comparativa
Vidu Q4 Preview vs Kling 3.0: ¿cómo elegir para imagen a video?
Si quieres sonido por defecto, 16 segundos y 5 niveles de resolución, elige Vidu Q4 Preview; si quieres fijar la imagen con fotogramas inicial y final, elige Kling 3.0. Incluye dos comparativas con el mismo prompt: hidroavión y barista.
-

Comparativa
Alternativa a Replicate: comparativa de generación de imagen y vídeo entre hiapi y Replicate (2026)
Qué hay que cambiar en las llamadas de predicción, los webhooks y la facturación al migrar de Replicate a hiapi, con una lista de migración de 10 pasos.