
比較レビュー
Kimi K3.1 Pro 対 Opus 5.5:どう選ぶか
同価格で異なる強みを持つ二つのフラッグシップ:コーディングは互角、幻覚率は半減、1M コンテキスト、あなたの場面が答えを決める
Kimi K3.1 Pro のリリース後、最も多く聞かれる質問は「Claude Opus 5.5 とどう選ぶか」です。この二つのモデルの公式 API 価格はほぼ同一(入力 $2 / 出力 $10 每 1M tokens)なので、答えは価格ではなく、あなたのタスクの種類にあります。この記事では場面ごとに分けて解説します。
まず結論から
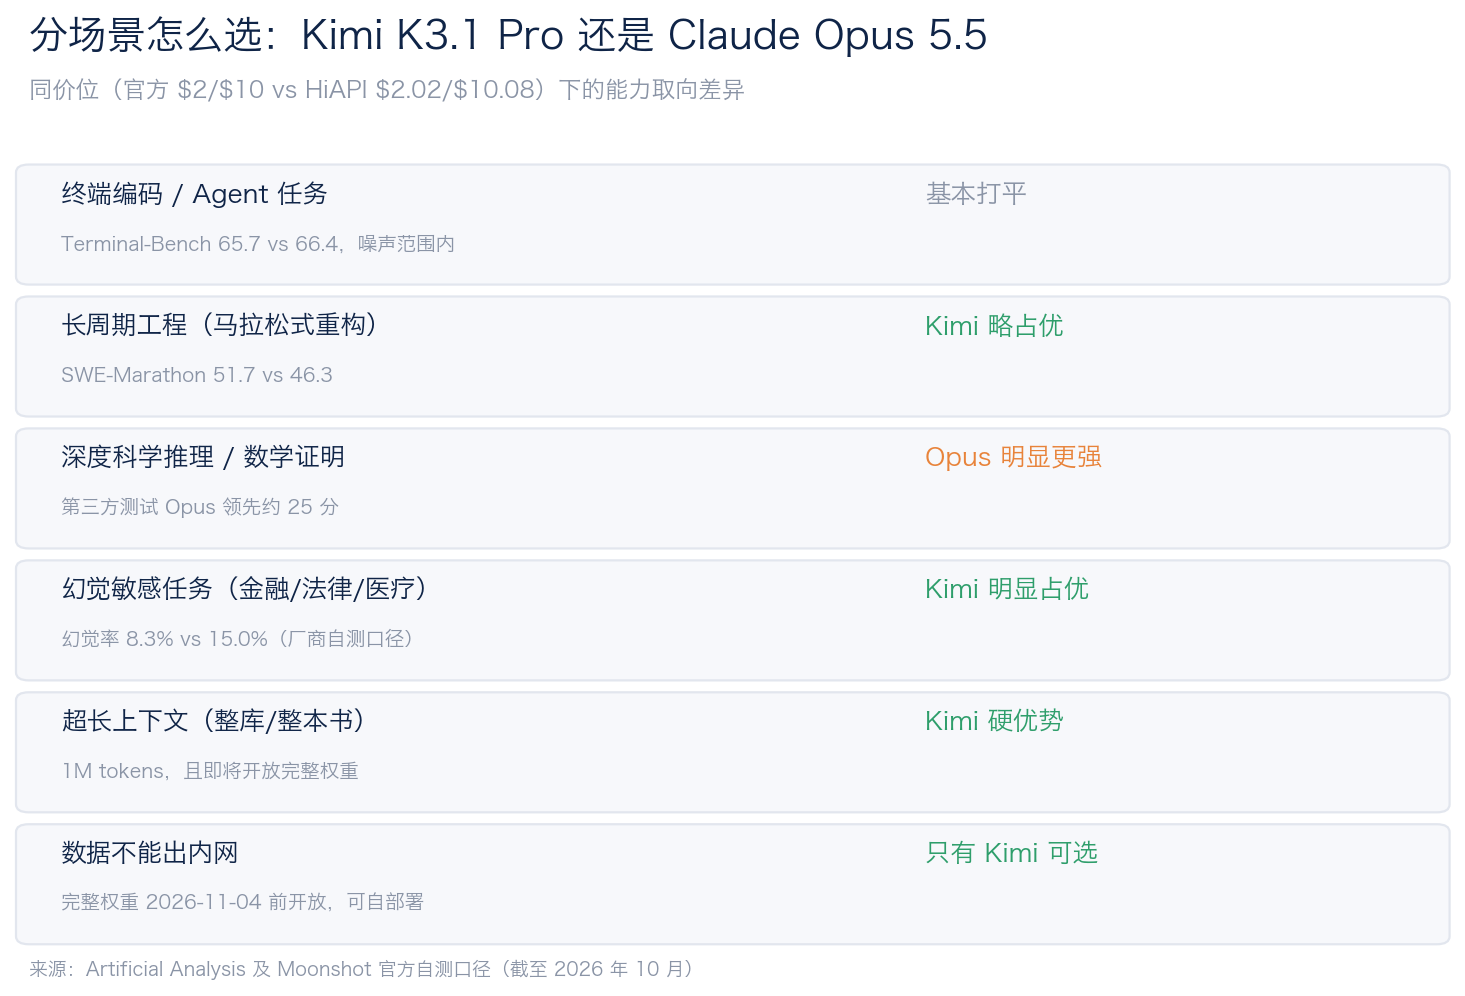
- 価格は互角:Kimi K3.1 Pro 公式は $2/$10、HiAPI 上の claude-opus-5-5 は $2.02/$10.08(2026 年 10 月時点)。同じ価格帯ではコスト削減ではなく能力の方向性を比べることになります
- コーディングはほぼ互角:Terminal-Bench では 65.7 対 66.4、Kimi は SWE-Marathon では 51.7 対 46.3 で逆転しています
- 幻覚率は Kimi が明らかに低い:8.3% 対 15.0% で約半分です
- 深い科学的推論は Opus が明らかに強い:第三者テストで約 25 点リードしています
- Kimi 独自の強み:1M コンテキスト、まもなく完全な重みを公開予定(2026-11-04 までを約束)
まず明確にしておくべき前提があります。ネット上に流れる比較数値の多くは Moonshot 公式の自社テストに由来し、しかも Kimi は既定で max effort、Opus は既定で medium で動作するため、両者の火力は完全に対等ではありません。複数の第三者ソースの総合判断は一致しています:局所的な逆転はあるが、全体では全面的にリードしているわけではない。以下の分析はこの共通認識に基づいています。
背景:AA ランキングで 4 位に浮上、K3.1 で何がアップグレードされたか
Artificial Analysis のインテリジェンス指数で、Kimi K3.1 Pro は 55 点を獲得し 4 位にランクインしました。上位 3 位は Claude Opus 5.5(58)、Claude Sonnet 5.5(56)、Muse Wonder Full(56)です。前世代の K3 は 44 点だったので、この世代で一気に 11 点を追い上げたことになります。完全な重みが予定通り公開されれば、AA ランキングで最高スコアのオープンウェイトモデルになります。
K3.1 Pro は K3 のポストトレーニング版アップグレードで、アーキテクチャは変わっていません:総パラメータ 2.8T、アクティブ 104B の MoE、1M コンテキスト、テキストと画像入力に対応(音声・動画は含まない)。アップグレードはポストトレーニングに集中しており、最も大きく変わったのは三つの点です:
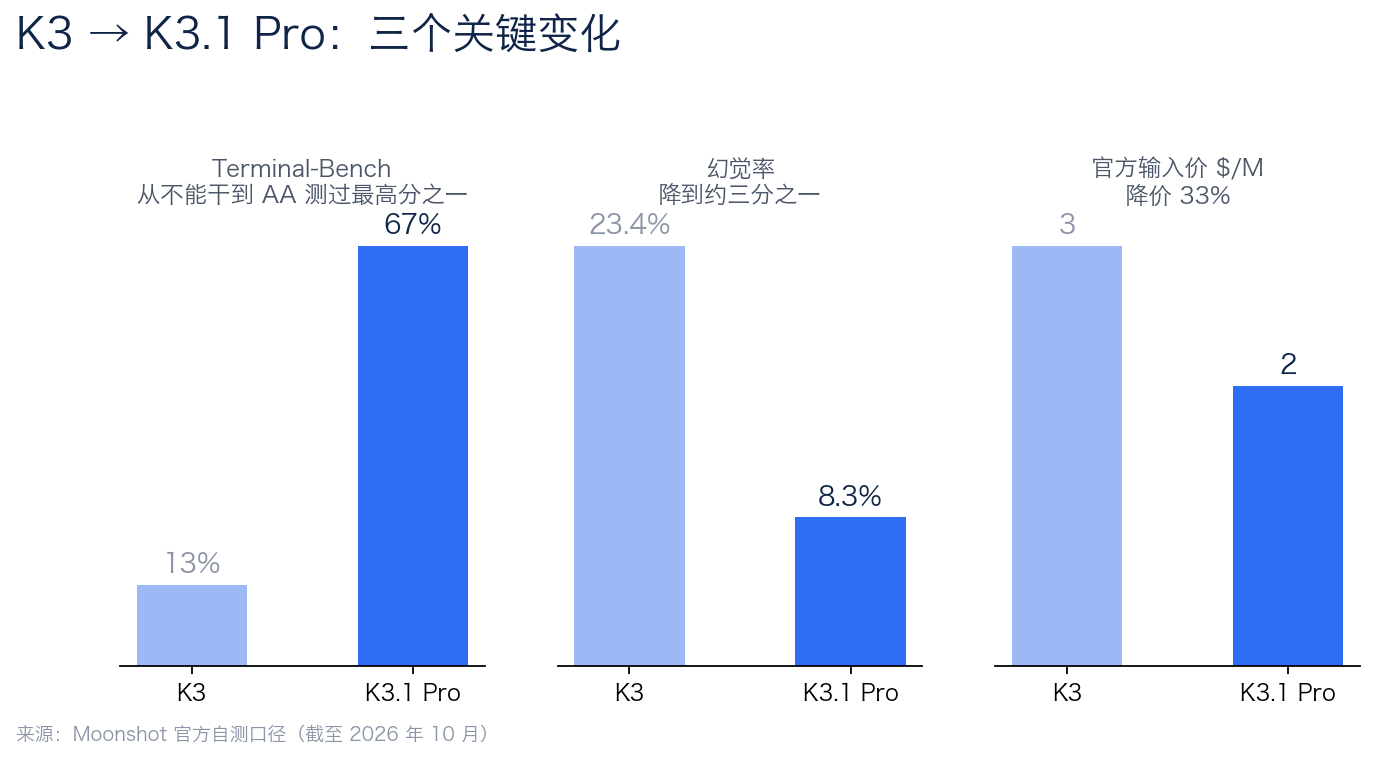
- Agentic コーディングの飛躍:Terminal-Bench が 13% から 67% へ。「できない」から「AA がこのベンチマークで計測した最高スコア」への飛躍です
- 幻覚率を 3 分の 1 に削減:23.4% から 8.3% へ
- 公式価格を 33% 値下げ:$3/$15 から $2/$10 へ、速度も約 2 倍に
中国語コミュニティの今回のリリースへの反応は直接的で、36kr は公開当日にクォータが「10 分で焼き尽くされた」と報じています。熱量は本物ですが、私たちがより関心があるのは、これがあなたの日常ワークフローでどのモデルを置き換えられるかです。
場面別比較
コーディングと Agent タスク:ほぼ互角、方向性が異なる
ここが最も意外な部分です。Terminal-Bench 4.0 で K3.1 Pro は 65.7%(Moonshot 公式の自社テスト基準)、Opus 5.5 は 66.4% で、差はノイズの範囲内です。より長周期の SWE-Marathon では Kimi が 51.7 対 46.3 で逆転しています。AA の Agentic 细分ランキング GDPval-AA では、K3.1 Pro は 3 位(1,846 Elo)です。
噛み砕いて言えば、あなたの Agent タスクが「ターミナルで多段階の作業を行う」あるいは「マラソン式の大規模リファクタリング」であれば、どちらのモデルも対応でき、Kimi は長いタスクでやや優位です。Claude Code のヘビーユーザーなら、以前の実測を参考にしてください:Claude Code を hiapi の API Key に接続して一通り実行してみた、そのフローに今はもう一つ候補モデルが加わります。
実践的なアドバイス:この種の場面ではスコアを信じず、あなたのリポジトリにある実際の 20 タスクをそれぞれ実行し、通過率が高い方を使ってください。両モデルは同価格なので、デュアルモデルで段階的に切り替えるコストはほぼゼロです。
深い推論:Opus は依然として明らかに強い
これは Opus 5.5 が守る基本領域です。第三者テストでは、深い科学的推論で Opus が約 25 点リードし、総合インテリジェンス指数でも Opus 58 対 55 で 3 点リードしています。あなたの仕事が数学の証明、複雑な科学分析、多段ホップの論理推論であれば、この階層の差は実在し、K3.1 Pro はまだ追いつけません。
幻覚率:Kimi は Opus の約半分
8.3% 対 15.0%(Moonshot 公式の自社テスト基準)で、この差は事実の正確性が求められる場面では質的な変化です。金融リサーチ、法律文書の要約、医療問答、カスタマーサポート知識ベースなど、「一文字間違えるとやり直しになる」タスクでは、低い幻覚率はスコアが数点高いことよりはるかに価値があります。これも K3.1 が K3 に対して最も大きく進歩した単項目の一つです(23.4% → 8.3%)。
長いコンテキスト:Kimi の 1M は明確な優位
両モデルとも長いコンテキスト能力を持っていますが、Kimi K3.1 Pro の 1M tokens は本一冊、コードベース全体、長い決算資料を投入する場面でより余裕があります。さらに重要なのは完全な重みをまもなく公開することです。データを社内ネットワークから出せないチームにとって、「オープンソース + 1M コンテキスト + フラッグシップ級能力」という組み合わせは Opus 5.5 には提供できません。
価格と速度
まず価格を整理します(2026 年 10 月時点):
| モデル | 公式入力 | 公式出力 | HiAPI プラットフォーム価格 |
|---|---|---|---|
| Kimi K3.1 Pro | $2/M | $10/M | [$2.1548/$11.2714(2026-10 時点):プラットフォーム価格、リリース後に /api/pricing を確認して反映] |
| claude-opus-5-5 | — | — | $2.02 / $10.08(キャッシュ読み取り $0.10/M) |
K3.1 Pro 公式にはキャッシュヒット価格 $0.20/M があり、さらに Highspeed バリアント($4/$20、速度 2-3 倍)はレイテンシに敏感なオンライン場面に適しています。前世代の Kimi K3 は HiAPI 上では $2.1548/$11.2714 で、参考までに。
速度については各ソースの基準が 27-80 tokens/秒の間にあり、やや遅い部類ですが、K3 より 2 倍速くなっています。AA のタスクあたりコスト試算では、K3.1 Pro は $1.98 で K3 と同等、能力向上を考慮するとコストパフォーマンスは改善しています。
価格帯を一言でまとめると:これは「安い挑戦者が高いベンチマークに挑む」話ではなく、同価格帯でより低い幻覚率とより長いコンテキストを、より弱い深い推論と引き換えにする話です。
どう選ぶか:場面別の答え
Kimi K3.1 Pro を選ぶのは、次の場合:
- あなたのタスクが Agentic コーディング、ターミナル操作、長周期のソフトウェアエンジニアリングである
- 幻覚率を極めて重視する(金融、法律、医療、知識ベース問答)
- 1M コンテキストで資料全体を処理する必要がある
- セルフホストが必要(重み公開待ち)、またはオープンウェイトで監査可能であることを求める
Claude Opus 5.5 を選ぶのは、次の場合:
- あなたの核心が深い科学的推論、複雑な数学、多段ホップの論理である
- より長期間検証された成熟度を求める
- あなたのワークフローがすでに Anthropic エコシステムに深く結びついている
両方を活かす実践的な方法:同価格はタスクごとのルーティングが可能であることを意味し、推論系タスクは Opus、コーディングと事実問答は Kimi に回します。Opus 5.5 の完全な能力範囲を知りたい場合は、モデル詳細ページをご覧ください。
よくある質問
Kimi K3.1 Pro と Claude Opus 5.5 はどちらがコードを書くのが上手いですか?
ほぼ互角です。Terminal-Bench 4.0 では 65.7 対 66.4(Moonshot 公式自社テスト)、より長周期の SWE-Marathon では Kimi が 51.7 対 46.3 で逆転しています。本当にやるべきは、あなた自身のタスクセットでそれぞれ実行することであり、ランキングだけを見ないことです。
Kimi K3.1 Pro の幻覚率は本当に Opus 5.5 より低いですか?
Moonshot 公式の自社テスト基準では 8.3% 対 15.0% で約半分です。この単項目は第三者の裏付けが比較的十分で、K3.1 の最も確かな優位性です。ただし自社テスト基準では Kimi が max effort で動作している点に注意が必要で、実際のデプロイ時の effort 設定が性能に影響します。
Kimi K3.1 Pro のコンテキストウィンドウはどのくらいですか?
1M tokens で、テキストと画像入力に対応します。資料全体、コードベース全体を投入するのが強みです。Opus 5.5 の長いコンテキスト能力も悪くありませんが、規模の面では Kimi の方が余裕があります。
Kimi K3.1 Pro は重みを公開しますか?
Moonshot は 2026-11-04 までの完全な重みの公開を約束しています。実現すれば AA ランキングで最高スコアのオープンウェイトモデルになります。プライベートデプロイが必要なチームにとって、これは選ぶべき明確な理由です。
Kimi K3.1 Pro API はいくらですか?
公式価格は $2/入力、$10/出力(每 1M tokens)、キャッシュヒット $0.20、さらに Highspeed バリアント $4/$20(2-3 倍速)。HiAPI プラットフォーム価格は [$2.1548/$11.2714(2026-10 時点):プラットフォーム価格、リリース後に /api/pricing を確認して反映]。
同じ予算で、二つのモデルをどう組み合わせるのが最もお得ですか?
タスクごとのルーティング:深い推論は Opus 5.5、コーディング、事実問答、長文ドキュメントは Kimi。両者の単価はほぼ同じで、ルーティングの追加コストは主に二系統の呼び出しを維持するエンジニアリング工数です。
重要な結論
Kimi K3.1 Pro と Claude Opus 5.5 は同価格帯の二つの異なる答えです。Kimi は低い幻覚率、1M コンテキスト、Agentic コーディング、そしてまもなく来るオープンウェイトで、Opus の深い推論の優位性と引き換えにしています。すべての場面でより優れたモデルは存在せず、第三者の共通認識も全面的リードではなく局所的な逆転です。タスクの種類に応じてルーティングするか、まず実際のタスクセットで一通り検証する方が、どんなランキングを見るよりも信頼できます。HiAPI 上では claude-opus-5-5 がすでに実行可能で、kimi-k3.1-pro のリリース前は kimi-k3 でフローを通しておけます。
同シリーズの記事
関連記事
すべての記事を見る →-

比較レビュー
Wan 2.6 Flash vs Wan 2.7:アップグレードすべきか?
720Pの予算と1080Pのキツネ・自動車完成品。組ごとに音声条件と実際のグレードを明記。
-

比較レビュー
Vidu Q4 Preview vs Kling 3.0:image-to-videoはどう選ぶ?
デフォルトで音声あり、16秒、5段階の解像度ならVidu Q4 Preview。開始・終了フレームで画面を固定するならKling 3.0。水上飛行機とバリスタの2組、同一プロンプトでの比較付き。
-

比較レビュー
Replicate の代替案:hiapi と Replicate の画像・動画生成比較(2026年)
Replicate から hiapi へ移行する際、予測呼び出し、webhook、課金をそれぞれどう変更するか、10 ステップの移行チェックリスト付き。