
Comparatif et évaluation
Kimi K3.1 Pro vs Opus 5.5 : comment choisir
Deux fleurons au même prix aux atouts différents : codage à égalité, taux d'hallucination divisé par deux, contexte de 1 M ; votre scénario décide de la réponse
Depuis la sortie de Kimi K3.1 Pro, la question la plus fréquente est : comment choisir entre lui et Claude Opus 5.5 ? Les tarifs API officiels des deux modèles sont quasiment identiques (2 $ en entrée / 10 $ en sortie pour 1 M tokens), la réponse ne se trouve donc pas dans le prix, mais dans le type de tâche. Cet article détaille les scénarios un par un.
La conclusion d'abord
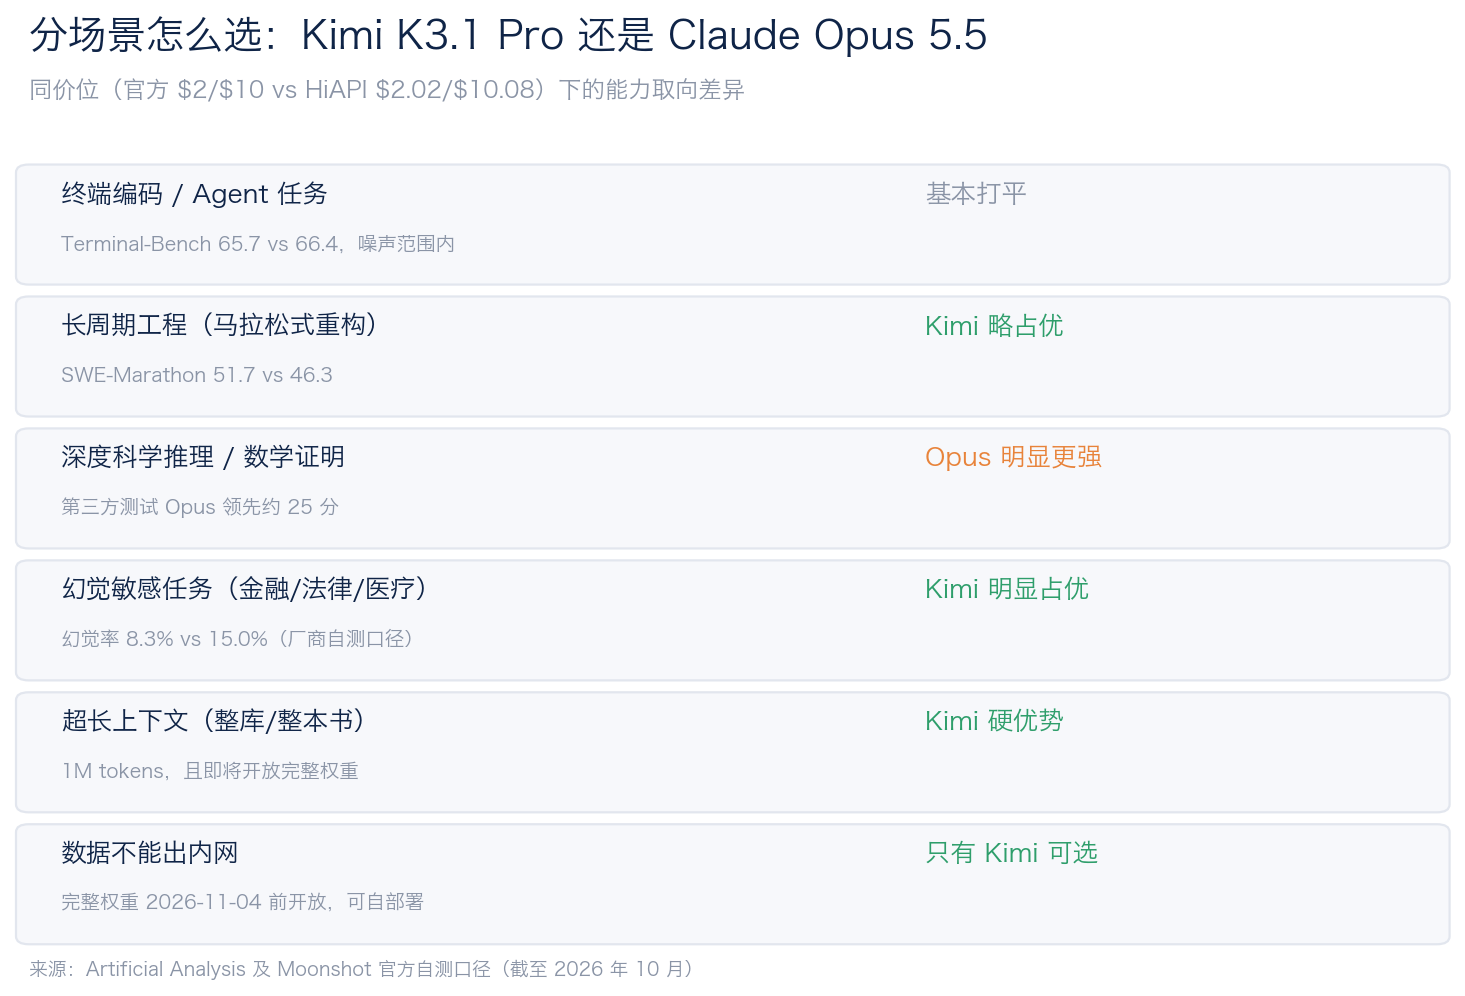
- Tarifs à égalité : Kimi K3.1 Pro officiel à 2 $/10 $, claude-opus-5-5 sur HiAPI à 2,02 $/10,08 $ (en octobre 2026). À prix égal, on compare des orientations de capacités, pas des économies
- Codage globalement à égalité : 65,7 contre 66,4 sur Terminal-Bench, Kimi passe devant sur SWE-Marathon avec 51,7 contre 46,3
- Taux d'hallucination nettement plus bas chez Kimi : 8,3 % contre 15,0 %, environ la moitié
- Raisonnement scientifique approfondi nettement plus fort chez Opus : environ 25 points d'avance selon des tests tiers
- Les atouts propres à Kimi : contexte de 1 M, ouverture prochaine des poids complets (promise avant le 2026-11-04)
Un point de méthode à clarifier d'emblée : la plupart des chiffres comparatifs qui circulent proviennent des auto-évaluations officielles de Moonshot, et Kimi tourne par défaut en max effort tandis qu'Opus est par défaut en medium ; les deux ne sont donc pas tout à fait sur un pied d'égalité. Le jugement convergent de plusieurs sources tierces est cohérent : dépassement local, pas d'avance globale. L'analyse ci-dessous repose sur ce consensus.
Contexte : 4e place au classement AA, ce que K3.1 a amélioré
Sur l'indice d'intelligence d'Artificial Analysis, Kimi K3.1 Pro obtient 55 points et se classe 4e. Le trio de tête est Claude Opus 5.5 (58), Claude Sonnet 5.5 (56) et Muse Wonder Full (56). La génération précédente, K3, était à 44 points : cette génération a donc rattrapé 11 points d'un coup. Une fois les poids complets publiés comme prévu, il deviendra le modèle à poids ouverts le mieux noté du classement AA.
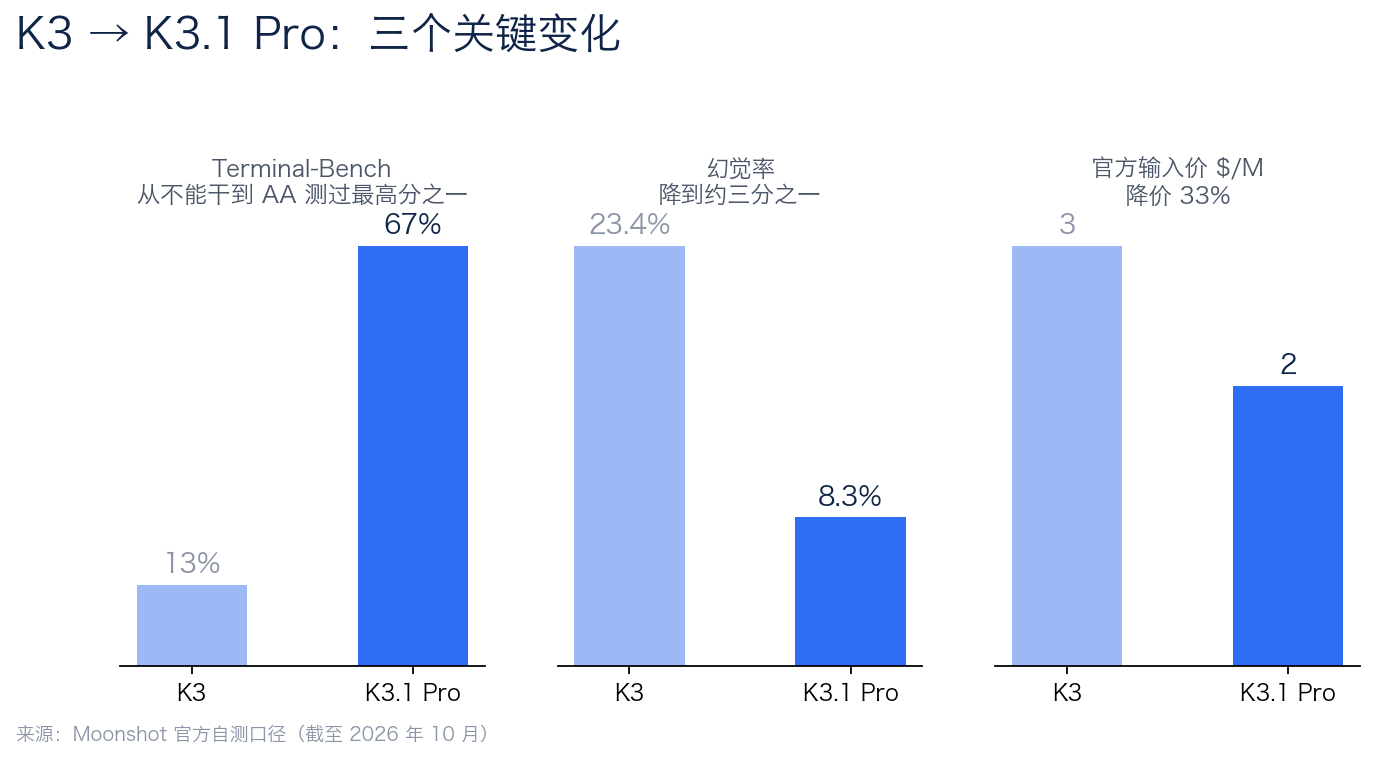
K3.1 Pro est une version post-entraînée de K3, l'architecture est inchangée : MoE de 2,8 T de paramètres totaux, 104 B activés, contexte de 1 M, entrée texte et image (hors audio et vidéo). Les améliorations se concentrent sur le post-entraînement, avec trois changements majeurs :
- Saut en codage agentique : Terminal-Bench passe de 13 % à 67 %, un écart entre « incapable » et « meilleur score mesuré par AA sur ce benchmark »
- Taux d'hallucination divisé par trois : de 23,4 % à 8,3 %
- Baisse officielle de 33 % : de 3 $/15 $ à 2 $/10 $, avec une vitesse environ doublée
La réaction de la communauté chinoise à cette sortie a été directe : selon 36kr, le quota d'accès a été « épuisé en 10 minutes » le jour du lancement. L'engouement est réel, mais ce qui nous intéresse davantage, c'est quel modèle il peut remplacer dans votre flux de travail quotidien.
Comparaison par scénario
Codage et tâches d'agent : quasi-égalité, orientations différentes
C'est la partie la plus surprenante. Sur Terminal-Bench 4.0, K3.1 Pro obtient 65,7 % (selon l'auto-évaluation officielle de Moonshot), Opus 5.5 est à 66,4 %, l'écart est dans la marge de bruit. Sur le plus long SWE-Marathon, Kimi dépasse avec 51,7 contre 46,3. Sur GDPval-AA, la sous-catégorie Agentic du classement AA, K3.1 Pro est 3e (1 846 Elo).
En clair : si vos tâches d'agent consistent à « exécuter plusieurs étapes dans un terminal » ou à « de grandes refactorisations de type marathon », les deux modèles tiennent la route, et Kimi a même un léger avantage sur les tâches longues. Si vous êtes un utilisateur intensif de Claude Code, vous pouvez vous référer à notre test précédent : nous avons fait tourner Claude Code avec la clé API hiapi, ce flux de travail dispose désormais d'un modèle candidat supplémentaire.
Recommandation pratique : dans ce type de scénario, ne vous fiez pas aux scores, faites tourner vos 20 vraies tâches du dépôt et prenez celui qui a le meilleur taux de réussite. Les deux modèles sont au même prix, le coût d'un déploiement en double modèle avec bascule progressive est quasi nul.
Raisonnement approfondi : Opus reste nettement plus fort
C'est le bastion d'Opus 5.5. Dans les tests tiers, Opus devance d'environ 25 points en raisonnement scientifique approfondi ; sur l'indice d'intelligence global, Opus mène par 58 contre 55, soit 3 points d'avance. Si votre travail consiste en démonstrations mathématiques, analyses scientifiques complexes ou déductions logiques à plusieurs sauts, l'écart à ce niveau est réel et K3.1 Pro ne peut pas encore le combler.
Taux d'hallucination : Kimi environ la moitié d'Opus
8,3 % contre 15,0 % (selon l'auto-évaluation officielle de Moonshot), cet écart est un changement de nature dans les scénarios exigeant l'exactitude factuelle. Recherche financière, résumés de textes juridiques, questions-réponses médicales, bases de connaissances du service client : dans ces tâches où « une seule erreur oblige à tout refaire », un faible taux d'hallucination vaut bien plus que quelques points de score. C'est d'ailleurs l'une des progressions les plus marquées de K3.1 par rapport à K3 (23,4 % → 8,3 %).
Contexte long : le 1 M de Kimi est un avantage réel
Les deux modèles ont des capacités de contexte long, mais le 1 M tokens de Kimi K3.1 Pro est plus à l'aise pour ingérer un livre entier, tout un dépôt de code ou de longs rapports financiers. Plus important encore, il ouvrira bientôt ses poids complets : pour les équipes dont les données ne peuvent pas sortir du réseau interne, la combinaison « open source + contexte 1 M + capacités de niveau phare » est quelque chose qu'Opus 5.5 ne peut pas offrir.
Prix et vitesse
Clarifions d'abord les prix (en octobre 2026) :
| Modèle | Entrée officielle | Sortie officielle | Prix sur la plateforme HiAPI |
|---|---|---|---|
| Kimi K3.1 Pro | 2 $/M | 10 $/M | [2,1548 $/11,2714 $ (en octobre 2026) : tarif de la plateforme, à vérifier et compléter via /api/pricing après la mise en ligne] |
| claude-opus-5-5 | — | — | 2,02 $ / 10,08 $ (lecture de cache 0,10 $/M) |
K3.1 Pro propose aussi un tarif officiel de cache hit à 0,20 $/M, ainsi qu'une variante Highspeed (4 $/20 $, 2 à 3 fois plus rapide), adaptée aux scénarios en ligne sensibles à la latence. La génération précédente, Kimi K3, est à 2,1548 $/11,2714 $ sur HiAPI, pour référence.
En termes de vitesse, les sources varient entre 27 et 80 tokens/seconde, ce qui le place dans la catégorie plutôt lente, mais deux fois plus rapide que K3. Selon l'estimation du coût par tâche d'AA, K3.1 Pro est à 1,98 $, au niveau de K3 ; compte tenu de l'amélioration des capacités, le rapport qualité-prix s'améliore.
En une phrase sur le prix : ce n'est pas « le challenger bon marché face à la référence chère », mais à prix égal, échanger un taux d'hallucination plus faible et un contexte plus long contre un raisonnement approfondi plus faible.
Comment choisir : des réponses par scénario
Choisissez Kimi K3.1 Pro si :
- Vos tâches sont du codage agentique, des opérations en terminal, de l'ingénierie logicielle de longue durée
- Vous tenez énormément au taux d'hallucination (finance, droit, médical, questions-réponses sur base de connaissances)
- Vous avez besoin d'un contexte de 1 M pour traiter un dossier entier
- Vous avez besoin d'auto-hébergement (en attendant l'ouverture des poids) ou exigez des poids ouverts auditables
Choisissez Claude Opus 5.5 si :
- Votre cœur de métier est le raisonnement scientifique approfondi, les mathématiques complexes, la logique à plusieurs sauts
- Vous recherchez une maturité éprouvée sur une plus longue durée
- Votre flux de travail est déjà profondément lié à l'écosystème Anthropic
L'approche pragmatique qui combine les deux : à prix égal, vous pouvez router selon la tâche, Opus pour le raisonnement, Kimi pour le codage et les questions factuelles. Pour comprendre les limites complètes d'Opus 5.5, consultez sa page de détails du modèle.
Questions fréquentes
Kimi K3.1 Pro ou Claude Opus 5.5 : lequel code le mieux ?
Quasi-égalité. 65,7 contre 66,4 sur Terminal-Bench 4.0 (auto-évaluation officielle de Moonshot), et Kimi dépasse sur le plus long SWE-Marathon avec 51,7 contre 46,3. Ce qu'il faut vraiment faire, c'est faire tourner vos propres jeux de tâches, pas seulement regarder les classements.
Le taux d'hallucination de Kimi K3.1 Pro est-il vraiment inférieur à celui d'Opus 5.5 ?
Selon l'auto-évaluation officielle de Moonshot, 8,3 % contre 15,0 %, soit environ la moitié. Les corroborations tierces sur ce point sont relativement solides, c'est l'avantage le plus défendable de K3.1. Attention toutefois : dans le protocole d'auto-évaluation, Kimi tourne en max effort, et le réglage d'effort en déploiement réel influence les performances.
Quelle est la fenêtre de contexte de Kimi K3.1 Pro ?
1 M tokens, entrée texte et image. Ingérer un dossier entier ou tout un dépôt de code est son point fort. Opus 5.5 a aussi de bonnes capacités de contexte long, mais Kimi est plus large en ordre de grandeur.
Kimi K3.1 Pro ouvrira-t-il ses poids ?
Moonshot s'est engagé à ouvrir les poids complets avant le 2026-11-04. Une fois tenu, il sera le modèle à poids ouverts le mieux noté du classement AA. Pour les équipes ayant besoin d'un déploiement privé, c'est une raison décisive de le choisir.
Combien coûte l'API Kimi K3.1 Pro ?
Tarif officiel 2 $ en entrée, 10 $ en sortie (pour 1 M tokens), cache hit à 0,20 $, plus une variante Highspeed à 4 $/20 $ (2 à 3 fois plus rapide). Tarif sur la plateforme HiAPI : [2,1548 $/11,2714 $ (en octobre 2026) : tarif de la plateforme, à vérifier et compléter via /api/pricing après la mise en ligne].
Avec le même budget, comment combiner au mieux les deux modèles ?
Router selon la tâche : Opus 5.5 pour le raisonnement approfondi, Kimi pour le codage, les questions factuelles et les documents longs. Les prix unitaires étant presque identiques, le coût supplémentaire du routage est surtout l'ingénierie de maintenir deux ensembles d'appels.
Conclusions clés
Kimi K3.1 Pro et Claude Opus 5.5 sont deux réponses différentes au même prix. Kimi échange l'avantage de raisonnement approfondi d'Opus contre un faible taux d'hallucination, un contexte de 1 M, le codage agentique et l'ouverture prochaine des poids. Aucun modèle n'est meilleur dans tous les scénarios, et le consensus tiers est un dépassement local plutôt qu'une avance globale. Router selon votre type de tâche, ou commencer par un test réel sur votre jeu de tâches, est plus fiable que n'importe quel classement. Sur HiAPI, claude-opus-5-5 est déjà disponible ; avant la mise en ligne de kimi-k3.1-pro, vous pouvez valider le flux avec kimi-k3.
Articles de la même série
Articles similaires
Voir tous les articles →-

Comparatif et évaluation
Wan 2.6 Flash vs Wan 2.7 : faut-il passer à la version supérieure ?
Budget 720P et rendus 1080P du renard et de la voiture ; conditions audio et palier réel indiqués groupe par groupe.
-

Comparatif et évaluation
Vidu Q4 Preview vs Kling 3.0 : quel modèle image-vers-vidéo choisir ?
Audio par défaut, 16 secondes et 5 paliers de résolution : choisissez Vidu Q4 Preview ; verrouillage des images par frames de début et de fin : choisissez Kling 3.0. Avec deux comparaisons à prompt identique, sur un hydravion et une barista.
-

Comparatif et évaluation
Alternative à Replicate : comparatif hiapi vs Replicate pour la génération d'images et de vidéos (2026)
Ce qui doit changer dans les appels de prédiction, les webhooks et la facturation lors d'une migration de Replicate vers hiapi, avec une liste de migration en 10 étapes.