
Confronto e valutazione
Kimi K3.1 Pro vs Opus 5.5: come scegliere
Due flagship allo stesso prezzo con punti di forza diversi: coding alla pari, tasso di allucinazione dimezzato, contesto da 1M; il tuo scenario decide la risposta
Dopo il lancio di Kimi K3.1 Pro, la domanda più frequente è: come scegliere tra lui e Claude Opus 5.5? I prezzi delle API ufficiali dei due modelli sono quasi identici ($2 in input / $10 in output per 1M token), quindi la risposta non sta nel prezzo, ma nel tipo di attività. Questo articolo analizza i vari scenari uno per uno.
In sintesi
- Prezzi alla pari: Kimi K3.1 Pro ufficiale $2/$10, claude-opus-5-5 su HiAPI è $2,02/$10,08 (ottobre 2026). A parità di prezzo si confrontano le capacità, non si risparmia
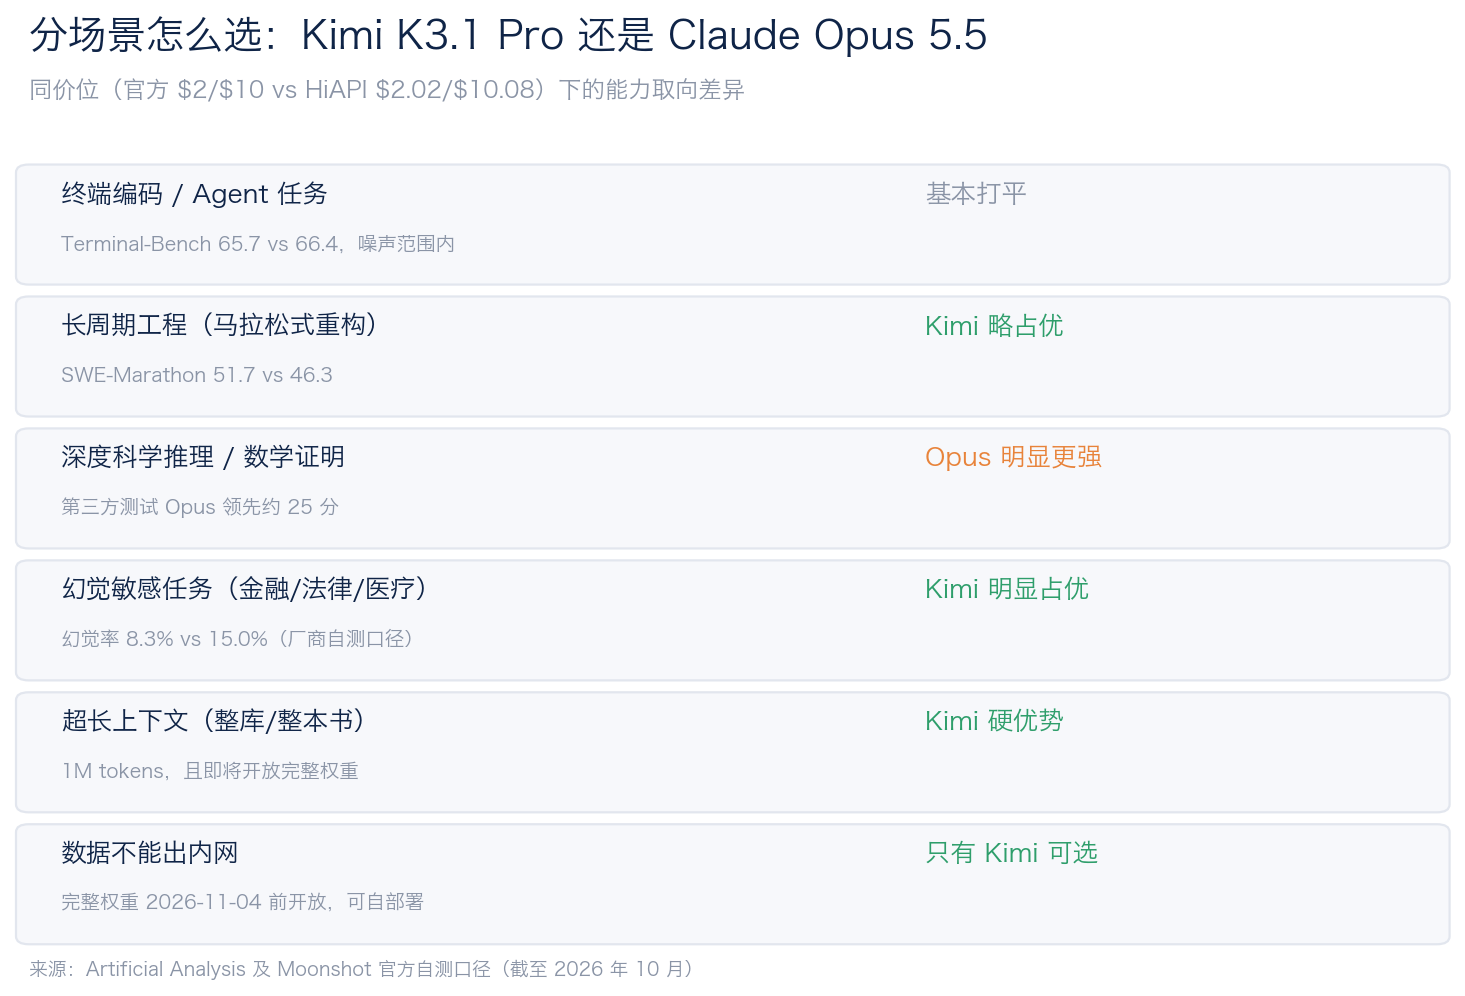
- Coding sostanzialmente alla pari: su Terminal-Bench 65,7 contro 66,4, su SWE-Marathon Kimi è avanti 51,7 contro 46,3
- Tasso di allucinazione nettamente più basso per Kimi: 8,3% contro 15,0%, circa la metà
- Ragionamento scientifico profondo decisamente più forte in Opus: circa 25 punti di vantaggio nei test di terze parti
- Le carte esclusive di Kimi: contesto da 1M e pesi completi in arrivo (impegno entro il 2026-11-04)
Una precisazione metodologica da fare subito: la maggior parte dei numeri di confronto diffusi online proviene da autotest ufficiali di Moonshot, e Kimi gira di default a max effort mentre Opus è di default a medium, quindi i due non sono del tutto alla pari in termini di sforzo. La valutazione complessiva di più fonti terze è concorde: superamento localizzato, non leadership complessiva. L'analisi che segue si basa su questo consenso.
Contesto: quarto posto nella classifica AA, cosa ha migliorato K3.1
Nell'indice di intelligenza di Artificial Analysis, Kimi K3.1 Pro ottiene 55 punti e si classifica al 4° posto. I primi tre sono Claude Opus 5.5 (58), Claude Sonnet 5.5 (56) e Muse Wonder Full (56). La generazione precedente K3 era a 44 punti, quindi questa generazione ha recuperato ben 11 punti in un colpo. Quando i pesi completi saranno rilasciati come previsto, sarà il modello a pesi aperti con il punteggio più alto nella classifica AA.
K3.1 Pro è un aggiornamento post-training di K3, l'architettura non è cambiata: MoE con 2,8T parametri totali e 104B attivi, contesto da 1M, supporto per input testuali e immagini (non audio/video). Il potenziamento si concentra sul post-training, con tre cambiamenti principali:
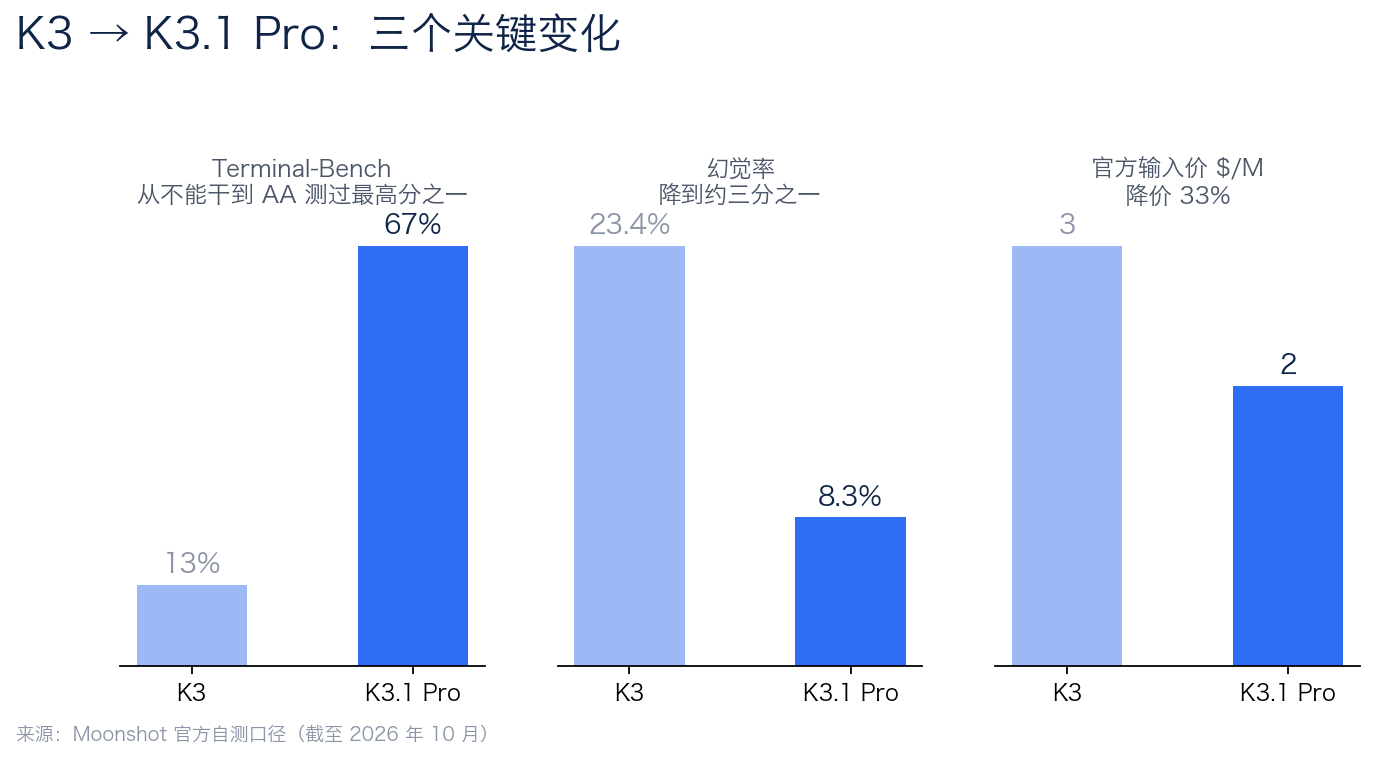
- Salto nel coding agentico: Terminal-Bench passa dal 13% al 67%, un balzo da «non è in grado» al «punteggio più alto mai misurato da AA su questo benchmark»
- Tasso di allucinazione ridotto a un terzo: dal 23,4% all'8,3%
- Riduzione ufficiale dei prezzi del 33%: da $3/$15 a $2/$10, velocità circa raddoppiata
La reazione della community cinese al lancio è stata diretta: secondo 36kr, la quota disponibile il giorno del lancio è stata «bruciata in 10 minuti». L'entusiasmo è reale, ma a noi interessa di più quale modello può sostituire nel tuo flusso di lavoro quotidiano.
Confronto per scenario
Coding e attività Agent: sostanzialmente alla pari, orientamenti diversi
Questa è la parte più sorprendente. Su Terminal-Bench 4.0 K3.1 Pro ottiene il 65,7% (secondo gli autotest ufficiali di Moonshot), Opus 5.5 è al 66,4%, differenza nel range del rumore. Sul più lungo SWE-Marathon Kimi è avanti 51,7 contro 46,3. Nella sotto-classifica Agentic di AA, GDPval-AA, K3.1 Pro è al 3° posto (1.846 Elo).
In parole povere: se le tue attività Agent consistono nel «lavorare in più passaggi nel terminale» o in «refactoring di grandi dimensioni in stile maratona», entrambi i modelli reggono, e Kimi ha un leggero vantaggio sui compiti lunghi. Se sei un utente accanito di Claude Code, puoi consultare il nostro test precedente: abbiamo collegato Claude Code all'API Key di hiapi e fatto un giro di prova; quel flusso di lavoro ora ha un modello candidato in più.
Consiglio pratico: in questi scenari non fidarti dei benchmark, esegui 20 attività reali del tuo repository su ciascun modello e usa quello con il tasso di successo più alto. A parità di prezzo, il costo di un rilascio graduale con due modelli è quasi nullo.
Ragionamento profondo: Opus resta nettamente più forte
Questo è il terreno che Opus 5.5 difende saldamente. Nei test di terze parti, nel ragionamento scientifico profondo Opus è avanti di circa 25 punti; nell'indice di intelligenza complessivo Opus è a 58 contro 55, 3 punti di vantaggio. Se il tuo lavoro riguarda dimostrazioni matematiche, analisi scientifiche complesse o deduzioni logiche multi-hop, il divario in questo ambito è reale e K3.1 Pro per ora non lo colma.
Tasso di allucinazione: Kimi è circa la metà di Opus
8,3% contro 15,0% (secondo gli autotest ufficiali di Moonshot): in scenari che richiedono accuratezza fattuale questa differenza è qualitativa. Ricerca finanziaria, sintesi di testi legali, question answering sanitario, knowledge base per il servizio clienti: per queste attività in cui «un errore di una parola impone di rifare tutto», un basso tasso di allucinazione vale molto più di qualche punto in più nei benchmark. È anche uno dei singoli miglioramenti più netti di K3.1 rispetto a K3 (23,4% → 8,3%).
Contesto lungo: il 1M di Kimi è un vantaggio concreto
Entrambi i modelli hanno capacità di contesto lungo, ma il 1M token di Kimi K3.1 Pro è più a suo agio quando si alimenta un intero libro, un intero codebase o lunghi report finanziari. Ancora più importante è il prossimo rilascio dei pesi completi: per i team i cui dati non possono uscire dalla rete interna, la combinazione «open source + contesto 1M + capacità di livello flagship» è qualcosa che Opus 5.5 non può offrire.
Prezzo e velocità
Mettiamo subito in chiaro i prezzi (ottobre 2026):
| Modello | Input ufficiale | Output ufficiale | Prezzo piattaforma HiAPI |
|---|---|---|---|
| Kimi K3.1 Pro | $2/M | $10/M | [$2,1548/$11,2714 (ottobre 2026): prezzo di piattaforma, da verificare e completare tramite /api/pricing dopo il lancio] |
| claude-opus-5-5 | — | — | $2,02 / $10,08 (lettura cache $0,10/M) |
K3.1 Pro ha anche un prezzo ufficiale con cache hit di $0,20/M e una variante Highspeed ($4/$20, 2-3 volte più veloce), adatta a scenari online sensibili alla latenza. Il predecessore Kimi K3 su HiAPI è a $2,1548/$11,2714, per riferimento.
Sulla velocità le fonti riportano valori tra 27 e 80 token/secondo, collocandosi nella fascia lenta, ma è il doppio di K3. Nella stima del costo per attività di AA, K3.1 Pro è a $1,98, in linea con K3; considerato il miglioramento delle capacità, il rapporto qualità/prezzo è migliorato.
In una frase, il capitolo prezzi: non è «lo sfidante economico contro il riferimento costoso», ma a parità di prezzo si scambiano un tasso di allucinazione più basso e un contesto più lungo contro un ragionamento profondo più debole.
Come scegliere: risposte per scenario
Scegli Kimi K3.1 Pro se:
- Le tue attività sono coding agentico, operazioni da terminale, ingegneria del software di lungo periodo
- Tieni moltissimo al tasso di allucinazione (finanza, legale, sanitario, question answering su knowledge base)
- Hai bisogno di un contesto da 1M per elaborare interi volumi di materiale
- Hai bisogno di self-hosting (in attesa del rilascio dei pesi) o richiedi pesi aperti verificabili
Scegli Claude Opus 5.5 se:
- Il tuo核心 è il ragionamento scientifico profondo, la matematica complessa, la logica multi-hop
- Cerchi una maturità collaudata più a lungo
- Il tuo flusso di lavoro è già profondamente legato all'ecosistema Anthropic
L'approccio pragmatico che copre entrambi i fronti: a parità di prezzo puoi instradare per attività, usando Opus per i compiti di ragionamento e Kimi per coding e domande fattuali. Per conoscere i limiti completi delle capacità di Opus 5.5, consulta la sua pagina di dettaglio del modello.
Domande frequenti
Kimi K3.1 Pro o Claude Opus 5.5: quale scrive codice meglio?
Sostanzialmente alla pari. Su Terminal-Bench 4.0 65,7 contro 66,4 (autotest ufficiale Moonshot), sul più lungo SWE-Marathon Kimi è avanti 51,7 contro 46,3. La cosa giusta da fare è eseguire il tuo set di attività su entrambi, non guardare solo le classifiche.
Il tasso di allucinazione di Kimi K3.1 Pro è davvero inferiore a quello di Opus 5.5?
Secondo gli autotest ufficiali Moonshot, 8,3% contro 15,0%, circa la metà. Le conferme di terze parti su questo singolo indicatore sono relativamente solide ed è il vantaggio più difendibile di K3.1. Attenzione però: negli autotest Kimi gira a max effort, e l'impostazione di effort in fase di deployment reale influisce sulle prestazioni.
Qual è la finestra di contesto di Kimi K3.1 Pro?
1M token, con input testuali e immagini. Elaborare interi volumi di materiale o interi codebase è il suo punto di forza. Anche Opus 5.5 ha buone capacità di contesto lungo, ma in termini di ordine di grandezza Kimi è più ampio.
Kimi K3.1 Pro rilascerà i pesi?
Moonshot si è impegnata a rilasciare i pesi completi entro il 2026-11-04. Una volta mantenuto l'impegno, sarà il modello a pesi aperti con il punteggio più alto nella classifica AA. Per i team che necessitano di deployment privato, è una ragione decisiva per sceglierlo.
Quanto costa l'API di Kimi K3.1 Pro?
Prezzo ufficiale $2/input, $10/output (per 1M token), cache hit $0,20, più una variante Highspeed $4/$20 (2-3 volte più veloce). Prezzo piattaforma HiAPI [$2,1548/$11,2714 (ottobre 2026): prezzo di piattaforma, da verificare e completare tramite /api/pricing dopo il lancio].
Con lo stesso budget, qual è il modo più conveniente di combinare i due modelli?
Instradando per attività: Opus 5.5 per il ragionamento profondo, Kimi per coding, domande fattuali e documenti lunghi. Il prezzo unitario è quasi identico, quindi il costo aggiuntivo dell'instradamento è soprattutto l'impegno ingegneristico di mantenere due set di chiamate.
Conclusioni chiave
Kimi K3.1 Pro e Claude Opus 5.5 sono due risposte diverse allo stesso prezzo. Kimi scambia il vantaggio di ragionamento profondo di Opus con un basso tasso di allucinazione, contesto da 1M, coding agentico e l'imminente rilascio dei pesi aperti. Nessun modello è migliore in tutti gli scenari, e il consenso delle terze parti è un superamento localizzato, non una leadership complessiva. Instradare in base al tipo di attività, o fare prima un giro di test con il proprio set reale di attività, è più affidabile di qualsiasi classifica. Su HiAPI claude-opus-5-5 è già disponibile; prima del lancio di kimi-k3.1-pro, puoi provare il flusso con kimi-k3.
Articoli della stessa serie
Articoli correlati
Vedi tutti gli articoli →-

Confronto e valutazione
Wan 2.6 Flash vs Wan 2.7: conviene aggiornare?
Budget 720P e risultati 1080P di volpe e auto; condizioni audio e livello effettivo indicati per ogni gruppo.
-

Confronto e valutazione
Vidu Q4 Preview vs Kling 3.0: come scegliere per il video da immagine?
Con audio di default, 16 secondi e 5 livelli di risoluzione scegli Vidu Q4 Preview; con primo e ultimo frame per bloccare l'immagine scegli Kling 3.0. In allegato due confronti con lo stesso prompt: idrovolante e barista.
-

Confronto e valutazione
Alternativa a Replicate: confronto hiapi vs Replicate per la generazione di immagini e video (2026)
Cosa cambia nelle chiamate di prediction, nei webhook e nella fatturazione quando si migra da Replicate a hiapi, con una checklist di migrazione in 10 passaggi.