
Vergleichstest
Kimi K3.1 Pro vs. Opus 5.5: Welches Modell wählen
Zwei Flaggschiffe zum gleichen Preis mit unterschiedlichen Stärken: gleichauf bei der Programmierung, halbierte Halluzinationsrate, 1M Kontext – Ihr Szenario entscheidet
Seit der Veröffentlichung von Kimi K3.1 Pro lautet die häufigste Frage: Wie wählt man zwischen ihm und Claude Opus 5.5? Die offiziellen API-Preise beider Modelle sind nahezu identisch (Input $2 / Output $10 pro 1M Tokens), die Antwort liegt also nicht beim Preis, sondern bei der Art Ihrer Aufgabe. Dieser Artikel schlüsselt die Entscheidung nach Szenarien auf.
Fazit vorweg
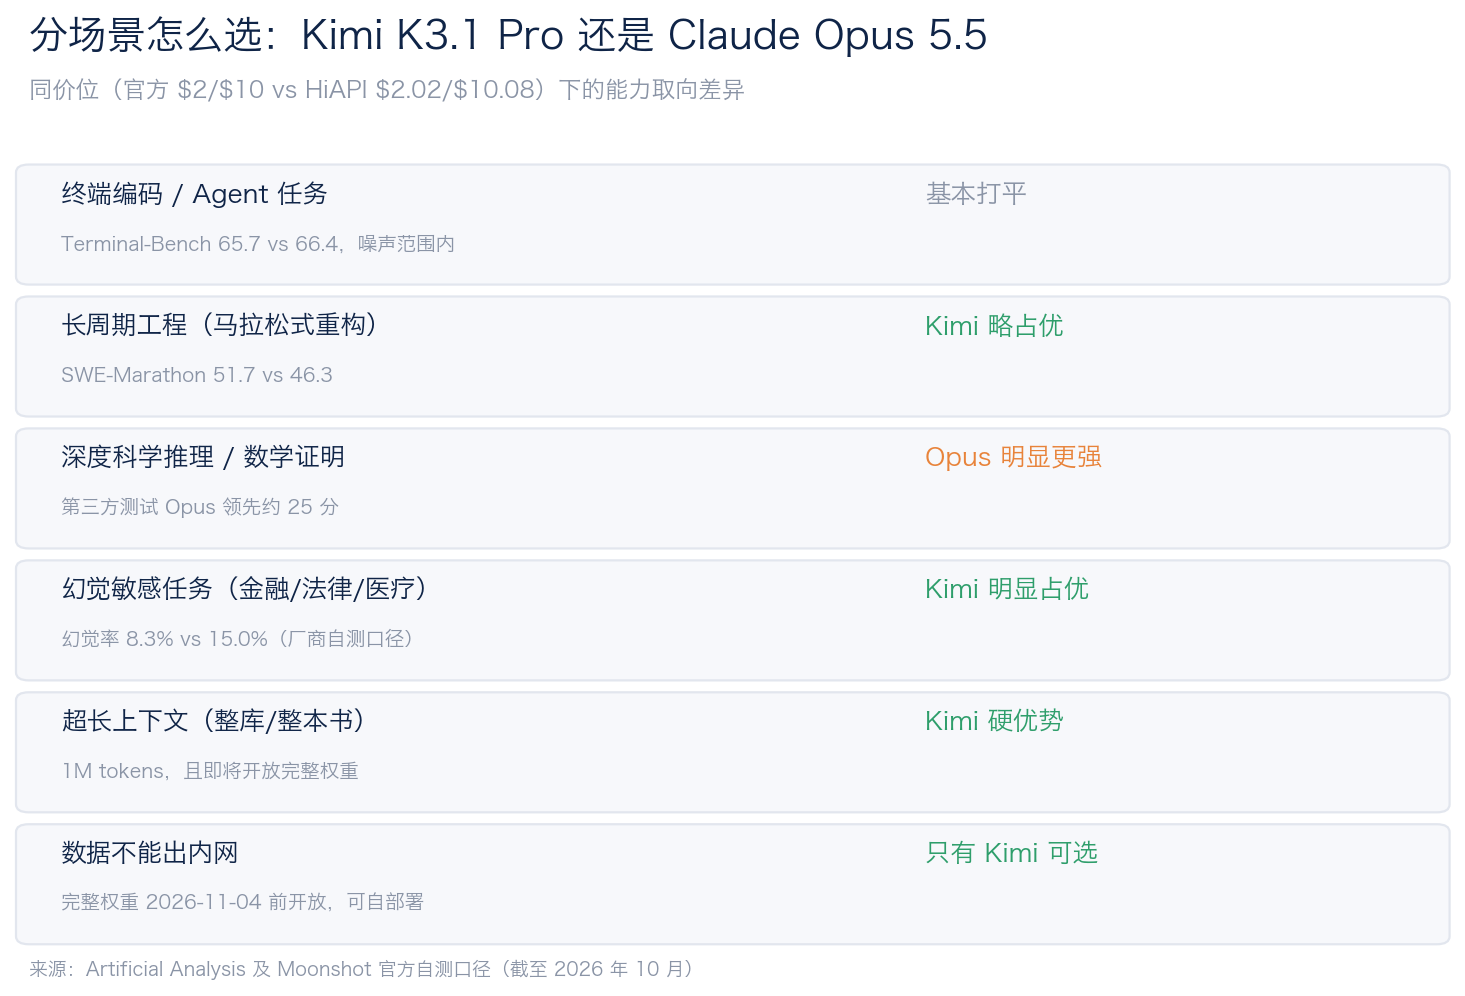
- Gleicher Preis: Kimi K3.1 Pro kostet offiziell $2/$10, claude-opus-5-5 auf HiAPI $2.02/$10.08 (Stand Oktober 2026). Bei gleichem Preis zählt die Ausrichtung der Fähigkeiten, nicht das Sparen
- Programmierung praktisch gleichauf: Terminal-Bench 65.7 gegenüber 66.4, bei SWE-Marathon liegt Kimi mit 51.7 gegenüber 46.3 vorn
- Halluzinationsrate bei Kimi deutlich niedriger: 8,3 % gegenüber 15,0 %, etwa die Hälfte
- Tiefes wissenschaftliches Schlussfolgern bei Opus deutlich stärker: rund 25 Punkte Vorsprung in Drittanbieter-Tests
- Kims Alleinstellungsmerkmale: 1M Kontext und die baldige Freigabe der vollständigen Gewichte (zugesagt bis 04.11.2026)
Eine wichtige Vorbemerkung zur Methodik: Die im Netz kursierenden Vergleichszahlen stammen überwiegend aus Moonshots eigenen Tests, und Kimi läuft standardmäßig mit max effort, Opus standardmäßig mit medium – die Bedingungen sind also nicht völlig gleich. Mehrere Drittanbieter-Quellen kommen übereinstimmend zu dem Urteil: punktuelle Überlegenheit, aber kein durchgängiger Vorsprung. Die folgende Analyse baut auf diesem Konsens auf.
Hintergrund: Platz 4 im AA-Ranking – was K3.1 verbessert hat
Im Intelligence Index von Artificial Analysis erreicht Kimi K3.1 Pro 55 Punkte und Platz 4. Die ersten drei Plätze belegen Claude Opus 5.5 (58), Claude Sonnet 5.5 (56) und Muse Wonder Full (56). Die Vorgängergeneration K3 lag bei 44 Punkten, diese Generation hat also auf einen Schlag 11 Punkte aufgeholt. Wenn die vollständigen Gewichte wie geplant veröffentlicht werden, wird es das offene Modell mit der höchsten Punktzahl im AA-Ranking sein.
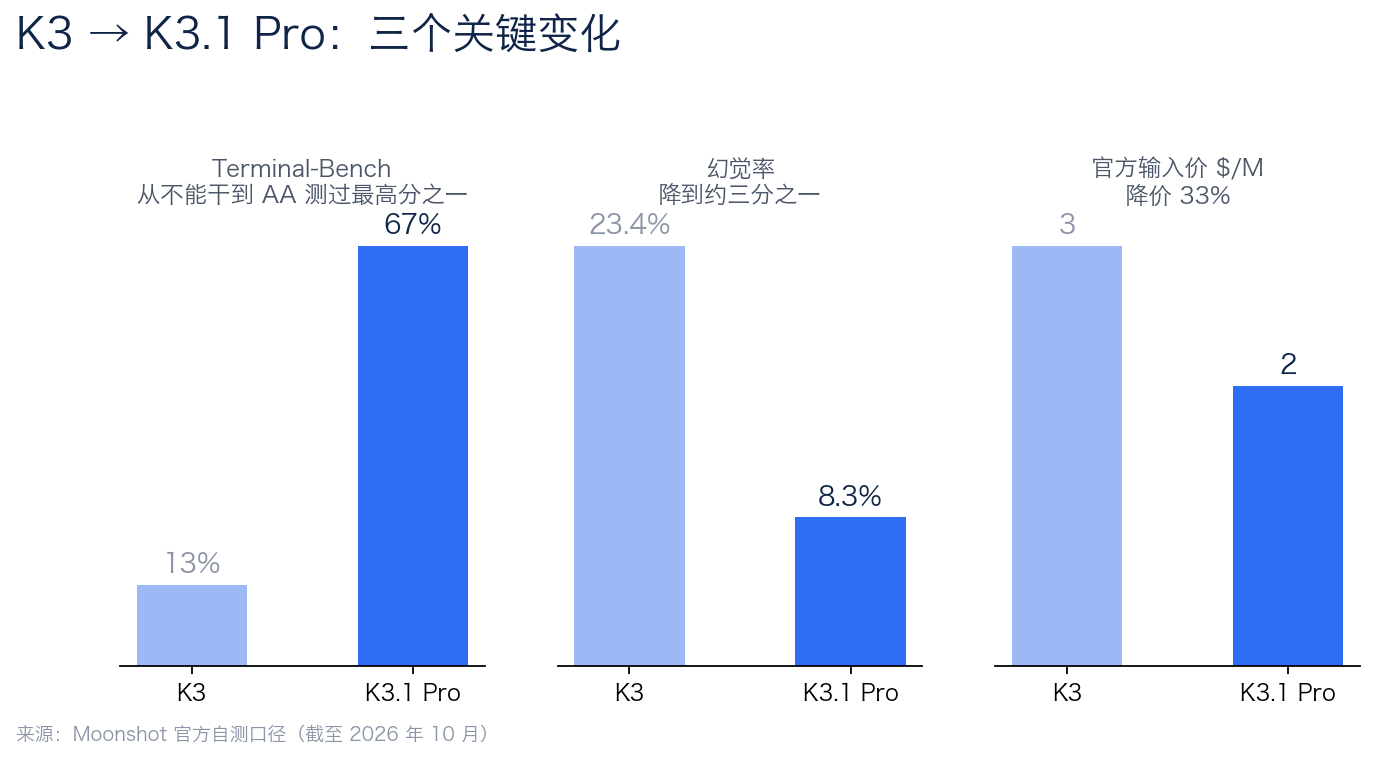
K3.1 Pro ist ein Post-Training-Upgrade von K3, die Architektur bleibt gleich: 2,8 Bio. Gesamtparameter, 104 Mrd. aktiviertes MoE, 1M Kontext, Unterstützung für Text- und Bildeingaben (ohne Audio/Video). Die Verbesserungen konzentrieren sich auf das Post-Training, am stärksten verändert haben sich drei Bereiche:
- Sprung beim agentischen Programmieren: Terminal-Bench von 13 % auf 67 % – ein Sprung von „kann es nicht" zu „höchste Punktzahl, die AA je auf diesem Benchmark gemessen hat"
- Halluzinationsrate auf ein Drittel gesenkt: von 23,4 % auf 8,3 %
- Offizielle Preissenkung um 33 %: von $3/$15 auf $2/$10, Geschwindigkeit etwa verdoppelt
Die chinesische Community reagierte direkt auf die Veröffentlichung: Laut 36kr war das Kontingent am Launch-Tag in „10 Minuten ausgeschöpft". Der Hype ist real, aber uns interessiert mehr, welches Modell es in Ihrem täglichen Workflow ersetzen kann.
Szenariovergleich
Programmierung und Agent-Aufgaben: praktisch gleichauf, unterschiedliche Ausrichtung
Das ist der überraschendste Teil. Auf Terminal-Bench 4.0 erreicht K3.1 Pro 65,7 % (Moonshots eigene Messung), Opus 5.5 liegt bei 66,4 % – der Unterschied liegt im Rauschen. Beim länger laufenden SWE-Marathon liegt Kimi mit 51,7 gegenüber 46,3 vorn. Im agentischen Teilranking GDPval-AA von AA belegt K3.1 Pro Platz 3 (1.846 Elo).
Im Klartext: Wenn Ihre Agent-Aufgaben darin bestehen, „mehrstufig im Terminal zu arbeiten" oder „einen marathonartigen großen Refactor durchzuführen", halten beide Modelle das aus, und Kimi hat bei langen Aufgaben sogar leichte Vorteile. Wenn Sie intensiver Claude-Code-Nutzer sind, sehen Sie sich unseren früheren Praxistest an: Wir haben Claude Code mit dem HiAPI-API-Key laufen lassen – dieser Workflow hat jetzt ein Kandidatenmodell mehr.
Praktische Empfehlung: Verlassen Sie sich in solchen Szenarien nicht auf Benchmarks, sondern lassen Sie 20 echte Aufgaben aus Ihrem Repository von beiden Modellen durchlaufen und nehmen Sie das mit der höheren Erfolgsquote. Bei gleichem Preis sind die Kosten für einen A/B-Test mit beiden Modellen praktisch null.
Tiefes Schlussfolgern: Opus bleibt deutlich stärker
Das ist die Basis, die Opus 5.5 verteidigt. In Drittanbieter-Tests liegt Opus beim tiefen wissenschaftlichen Schlussfolgern rund 25 Punkte vorn; beim Gesamt-Intelligence-Index führt Opus mit 58 zu 55 um 3 Punkte. Wenn Ihre Arbeit aus mathematischen Beweisen, komplexen wissenschaftlichen Analysen oder mehrstufigen logischen Herleitungen besteht, ist dieser Unterschied real, und K3.1 Pro kann hier vorerst nicht aufholen.
Halluzinationsrate: Kimi etwa halb so hoch wie Opus
8,3 % gegenüber 15,0 % (Moonshots eigene Messung) – in Szenarien, die faktische Genauigkeit erfordern, ist das ein qualitativer Unterschied. Finanzrecherche, Zusammenfassungen juristischer Texte, medizinische Fragen und Antworten, Kundenservice-Wissensdatenbanken – bei Aufgaben, bei denen „ein falsches Wort Nacharbeit bedeutet", ist eine niedrige Halluzinationsrate viel wertvoller als ein paar Punkte mehr im Benchmark. Das ist auch eine der Einzelverbesserungen, bei denen K3.1 gegenüber K3 am stärksten zugelegt hat (23,4 % → 8,3 %).
Langer Kontext: Kimis 1M ist ein harter Vorteil
Beide Modelle haben lange Kontextfenster, aber die 1M Tokens von Kimi K3.1 Pro sind beim Füttern ganzer Bücher, ganzer Codebasen oder langer Finanzberichte entspannter. Entscheidender ist die baldige Freigabe der vollständigen Gewichte: Für Teams, deren Daten das interne Netz nicht verlassen dürfen, ist die Kombination „Open Source + 1M Kontext + Flaggschiff-Fähigkeiten" etwas, das Opus 5.5 nicht bieten kann.
Preis und Geschwindigkeit
Zunächst die Preise im Klartext (Stand Oktober 2026):
| Modell | Offizieller Input | Offizieller Output | HiAPI-Plattformpreis |
|---|---|---|---|
| Kimi K3.1 Pro | $2/M | $10/M | [$2,1548/$11,2714 (Stand 2026-10): Plattformpreis, nach Launch anhand /api/pricing nachtragen] |
| claude-opus-5-5 | — | — | $2,02 / $10,08 (Cache-Lesen $0,10/M) |
Für K3.1 Pro gibt es offiziell außerdem einen Cache-Hit-Preis von $0,20/M sowie eine Highspeed-Variante ($4/$20, 2- bis 3-mal schneller), die sich für latenzempfindliche Online-Szenarien eignet. Die Vorgängergeneration Kimi K3 kostet auf HiAPI $2,1548/$11,2714 – als Referenz.
Bei der Geschwindigkeit liegen die Angaben der Quellen zwischen 27 und 80 Tokens/Sekunde, also im eher langsamen Bereich, aber doppelt so schnell wie K3. In der Kostenschätzung pro Aufgabe von AA liegt K3.1 Pro bei $1,98, gleichauf mit K3 – angesichts der verbesserten Fähigkeiten hat sich das Preis-Leistungs-Verhältnis also verbessert.
Der Preisteil in einem Satz: Hier tritt nicht ein billiger Herausforderer gegen einen teuren Maßstab an, sondern bei gleichem Preis tauscht man eine niedrigere Halluzinationsrate und längeren Kontext gegen schwächeres tiefes Schlussfolgern.
So wählen Sie: Antworten nach Szenario
Wählen Sie Kimi K3.1 Pro, wenn:
- Ihre Aufgabe agentisches Programmieren, Terminal-Arbeit oder langfristige Softwareentwicklung ist
- Ihnen die Halluzinationsrate extrem wichtig ist (Finanzen, Jura, Medizin, Wissensdatenbank-Q&A)
- Sie 1M Kontext brauchen, um ganze Materialsammlungen zu verarbeiten
- Sie Self-Hosting benötigen (sobald die Gewichte offen sind) oder offene, auditierbare Gewichte verlangen
Wählen Sie Claude Opus 5.5, wenn:
- Ihr Kern tiefes wissenschaftliches Schlussfolgern, komplexe Mathematik oder mehrstufige Logik ist
- Sie die über längere Zeit erprobte Reife suchen
- Ihr Workflow bereits tief im Anthropic-Ökosystem verankert ist
Pragmatischer Ansatz, der beides abdeckt: Gleicher Preis bedeutet, dass Sie nach Aufgabe routen können – Schlussfolgerungsaufgaben zu Opus, Programmierung und Fakten-Q&A zu Kimi. Wenn Sie die vollen Fähigkeitsgrenzen von Opus 5.5 kennenlernen möchten, sehen Sie sich die Modell-Detailseite an.
Häufig gestellte Fragen
Welches Modell schreibt besser Code, Kimi K3.1 Pro oder Claude Opus 5.5?
Praktisch gleichauf. Auf Terminal-Bench 4.0 steht es 65,7 zu 66,4 (Moonshots eigene Messung), beim länger laufenden SWE-Marathon liegt Kimi mit 51,7 zu 46,3 vorn. Was Sie wirklich tun sollten: Ihren eigenen Aufgabensatz von beiden Modellen durchlaufen lassen, statt nur auf Rankings zu schauen.
Ist die Halluzinationsrate von Kimi K3.1 Pro wirklich niedriger als die von Opus 5.5?
Nach Moonshots eigener Messung 8,3 % gegenüber 15,0 %, also etwa die Hälfte. Für diesen Einzelpunkt gibt es relativ solide Drittanbieter-Bestätigung, es ist der am besten belegte Vorteil von K3.1. Beachten Sie jedoch, dass Kimi in den eigenen Messungen mit max effort läuft und die effort-Einstellung im realen Einsatz die Leistung beeinflusst.
Wie groß ist das Kontextfenster von Kimi K3.1 Pro?
1M Tokens, Text- und Bildeingabe. Ganze Materialsammlungen und ganze Codebasen zu verarbeiten, ist seine Stärke. Die Langkontextfähigkeit von Opus 5.5 ist ebenfalls gut, aber von der Größenordnung her ist Kimi großzügiger.
Werden die Gewichte von Kimi K3.1 Pro offengelegt?
Moonshot hat zugesagt, bis zum 04.11.2026 die vollständigen Gewichte freizugeben. Danach wird es das offene Modell mit der höchsten Punktzahl im AA-Ranking sein. Für Teams, die eine private Bereitstellung benötigen, ist dies ein hartes Argument für dieses Modell.
Was kostet die Kimi K3.1 Pro API?
Offizieller Preis $2/Input, $10/Output (pro 1M Tokens), Cache-Hit $0,20, dazu eine Highspeed-Variante für $4/$20 (2- bis 3-mal schneller). HiAPI-Plattformpreis [$2,1548/$11,2714 (Stand 2026-10): Plattformpreis, nach Launch anhand /api/pricing nachtragen].
Wie kombiniert man beide Modelle bei gleichem Budget am günstigsten?
Nach Aufgabe routen: tiefes Schlussfolgern zu Opus 5.5, Programmierung, Fakten-Q&A und lange Dokumente zu Kimi. Die Stückpreise sind nahezu identisch, die zusätzlichen Kosten des Routings liegen vor allem im Engineering-Aufwand für zwei Aufruf-Wege.
Wichtigste Erkenntnisse
Kimi K3.1 Pro und Claude Opus 5.5 sind zwei verschiedene Antworten zum gleichen Preis. Kimi tauscht die Vorteile von Opus beim tiefen Schlussfolgern gegen niedrige Halluzinationsrate, 1M Kontext, agentisches Programmieren und bald offene Gewichte. Kein Modell ist in allen Szenarien besser, und der Konsens der Drittanbieter ist punktuelle Überlegenheit statt durchgängigem Vorsprung. Routen Sie nach Aufgabentyp, oder testen Sie zuerst mit einem echten Aufgabensatz – das ist verlässlicher als jedes Ranking. claude-opus-5-5 ist auf HiAPI bereits startklar; bis kimi-k3.1-pro verfügbar ist, können Sie den Workflow mit kimi-k3 zum Laufen bringen.
Artikel derselben Reihe
Ähnliche Artikel
Alle Artikel ansehen →-

Vergleichstest
Wan 2.6 Flash vs. Wan 2.7: Lohnt sich das Upgrade?
720P-Budget und 1080P-Ergebnisse mit Fuchs und Auto; Audio-Bedingungen und tatsächliche Stufen pro Gruppe angegeben.
-

Vergleichstest
Vidu Q4 Preview vs. Kling 3.0: Welches Modell für Bild-zu-Video?
Für standardmäßig mit Ton, 16 Sekunden und 5 Auflösungsstufen wähle Vidu Q4 Preview; für Anfangs- und Endframe-Fixierung wähle Kling 3.0. Inklusive zweier Vergleichspaare mit gleichem Prompt: Wasserflugzeug und Barista.
-

Vergleichstest
Replicate-Alternative: hiapi vs. Replicate im Vergleich für Bild- und Videogenerierung (2026)
Was sich beim Wechsel von Replicate zu hiapi bei Prediction-Aufrufen, Webhooks und Abrechnung ändert, mit einer 10-Schritte-Migrationscheckliste.