
Avaliação comparativa
Kimi K3.1 Pro vs Opus 5.5: como escolher
Dois modelos de ponta na mesma faixa de preço, com pontos fortes diferentes: código empatado, taxa de alucinação pela metade, contexto de 1M; seu cenário decide a resposta
Depois do lançamento do Kimi K3.1 Pro, a pergunta mais frequente é: afinal, como escolher entre ele e o Claude Opus 5.5? Os preços oficiais das APIs dos dois modelos são quase idênticos (US$ 2 de entrada / US$ 10 de saída por 1M tokens), então a resposta não está no preço, e sim no tipo de tarefa que você executa. Este artigo detalha por cenário.
Primeiro, a conclusão
- Preço empatado: o Kimi K3.1 Pro custa oficialmente US$ 2/US$ 10, e o claude-opus-5-5 na HiAPI custa US$ 2,02/US$ 10,08 (até outubro de 2026). Nessa mesma faixa de preço, o que se compara é o perfil de capacidade, não a economia
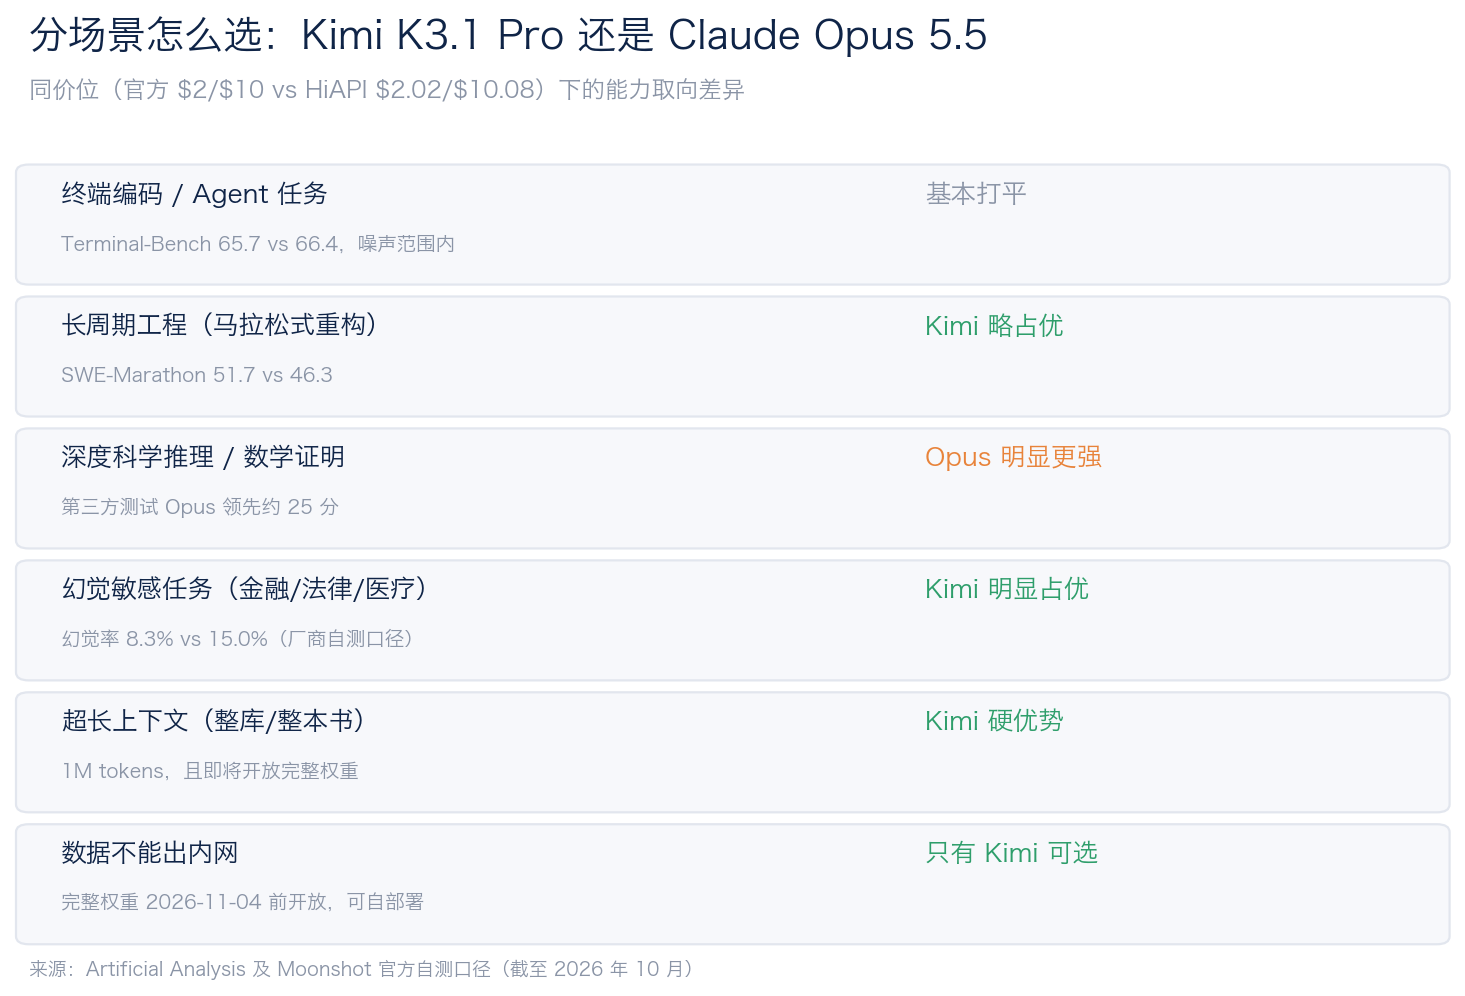
- Código praticamente empatado: no Terminal-Bench, 65,7 contra 66,4; a Kimi supera no SWE-Marathon, com 51,7 contra 46,3
- Taxa de alucinação claramente menor na Kimi: 8,3% contra 15,0%, cerca de metade
- Raciocínio científico profundo claramente mais forte no Opus: vantagem de cerca de 25 pontos em testes de terceiros
- Diferenciais exclusivos da Kimi: contexto de 1M e liberação iminente dos pesos completos (prometida até 2026-11-04)
Uma questão de critério que precisa ser esclarecida antes de tudo: a maioria dos números comparativos que circula na internet vem dos testes internos oficiais da Moonshot, e a Kimi roda por padrão em max effort enquanto o Opus roda por padrão em medium; ou seja, o poder de fogo dos dois lados não é totalmente equivalente. O julgamento consolidado de diversas fontes de terceiros é consistente: superação pontual, mas não liderança abrangente. A análise abaixo se baseia nesse consenso.
Contexto: 4º lugar no ranking AA, o que o K3.1 melhorou
No índice de inteligência da Artificial Analysis, o Kimi K3.1 Pro obteve 55 pontos e ficou em 4º lugar. Os três primeiros são Claude Opus 5.5 (58), Claude Sonnet 5.5 (56) e Muse Wonder Full (56). A geração anterior, K3, tinha 44 pontos, ou seja, esta geração recuperou 11 pontos de uma vez. Quando os pesos completos forem liberados conforme o planejado, ele será o modelo de pesos abertos com a maior pontuação no ranking AA.
O K3.1 Pro é uma versão com pós-treinamento aprimorado do K3, com arquitetura inalterada: MoE com 2,8T de parâmetros totais e 104B ativados, contexto de 1M, suporte a entrada de texto e imagem (sem áudio ou vídeo). As melhorias se concentram no pós-treinamento, com três mudanças principais:
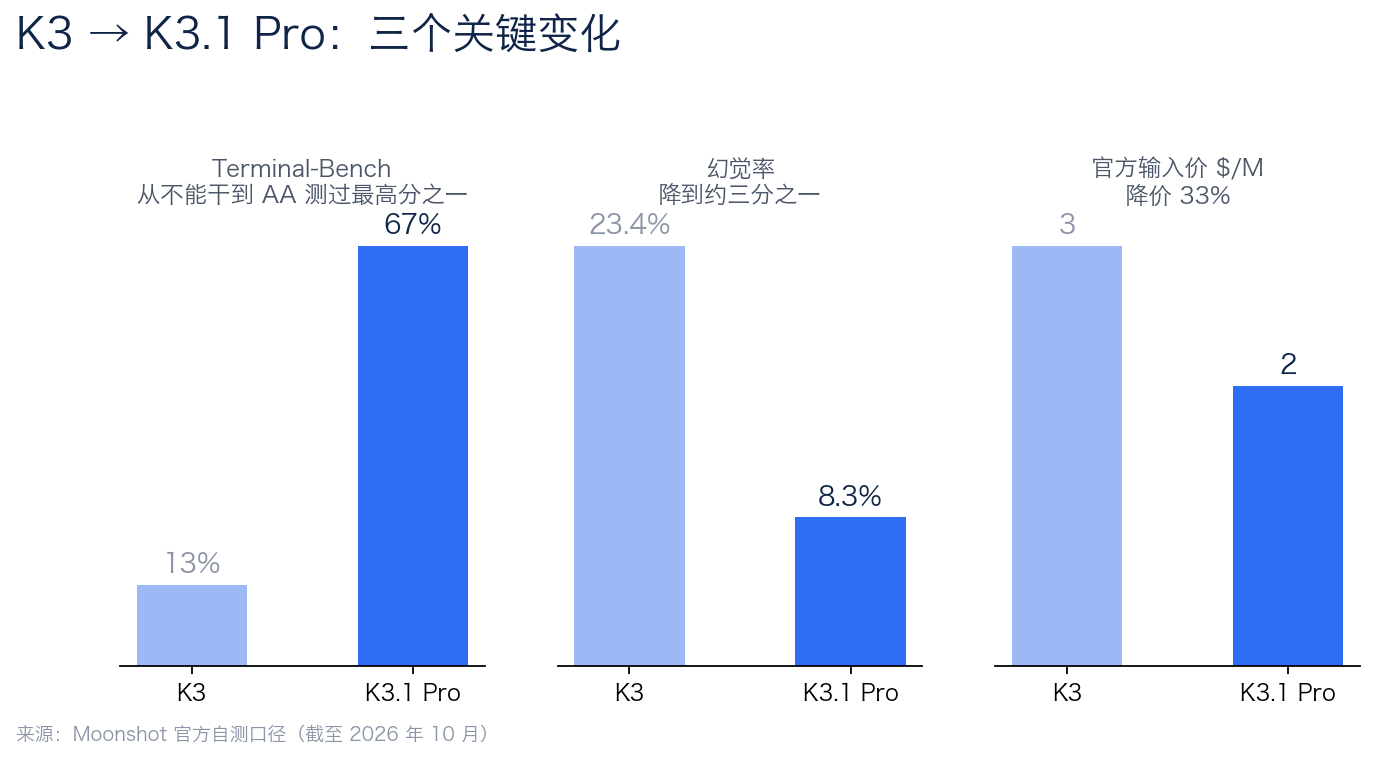
- Salto em codificação agêntica: o Terminal-Bench passou de 13% para 67%, um salto de "incapaz de fazer" para "a maior pontuação já medida pela AA nesse benchmark"
- Taxa de alucinação reduzida a um terço: de 23,4% para 8,3%
- Redução oficial de preço de 33%: de US$ 3/US$ 15 para US$ 2/US$ 10, com velocidade aproximadamente dobrada
A reação da comunidade chinesa a este lançamento foi direta: o 36kr relatou que a cota do dia de lançamento "esgotou em 10 minutos". A popularidade é real, mas estamos mais interessados em qual modelo ele pode substituir no seu fluxo de trabalho diário.
Comparação por cenário
Codificação e tarefas de agente: praticamente empatados, com orientações diferentes
Esta é a parte mais surpreendente. No Terminal-Bench 4.0, o K3.1 Pro obteve 65,7% (critério de teste interno oficial da Moonshot), e o Opus 5.5, 66,4%, uma diferença dentro da margem de ruído. No SWE-Marathon, de ciclo mais longo, a Kimi supera com 51,7 contra 46,3. No sub-ranking agêntico GDPval-AA da AA, o K3.1 Pro está em 3º lugar (1.846 Elo).
Traduzindo em termos práticos: se suas tarefas de agente são "executar várias etapas no terminal" ou "grandes refatorações no estilo maratona", os dois modelos dão conta, e a Kimi ainda tem ligeira vantagem em tarefas longas. Se você é um usuário intensivo do Claude Code, pode consultar nosso teste anterior: conectamos o Claude Code à API Key da hiapi e rodamos um ciclo completo; esse fluxo agora ganha mais um modelo candidato.
Recomendação prática: nesse cenário, não confie nas pontuações; execute cada um dos 20 tarefas reais do seu repositório uma vez e use o que tiver a maior taxa de aprovação. Os dois modelos estão na mesma faixa de preço, então o custo de uma implantação gradual com os dois modelos é praticamente zero.
Raciocínio profundo: o Opus continua claramente mais forte
Esta é a base que o Opus 5.5 mantém. Em testes de terceiros, o Opus lidera por cerca de 25 pontos em raciocínio científico profundo; no índice abrangente de inteligência, o Opus lidera com 58 contra 55, uma vantagem de 3 pontos. Se o seu trabalho envolve provas matemáticas, análise científica complexa ou dedução lógica de múltiplos saltos, a diferença nesse nível é real, e o K3.1 Pro ainda não consegue alcançar.
Taxa de alucinação: a Kimi tem cerca da metade do Opus
8,3% contra 15,0% (critério de teste interno oficial da Moonshot); essa diferença é uma mudança qualitativa em cenários que exigem precisão factual. Em pesquisa financeira, resumo de textos jurídicos, perguntas e respostas médicas e bases de conhecimento de atendimento ao cliente, tarefas em que "um único erro exige retrabalho", uma taxa de alucinação baixa vale muito mais do que alguns pontos a mais na pontuação. Este é também um dos itens em que o K3.1 mais avançou em relação ao K3 (23,4% → 8,3%).
Contexto longo: o 1M da Kimi é uma vantagem concreta
Os dois modelos têm capacidade de contexto longo, mas o 1M tokens do Kimi K3.1 Pro é mais confortável em cenários de alimentar um livro inteiro, um repositório de código completo ou relatórios financeiros longos. Mais importante ainda, ele está prestes a liberar os pesos completos: para equipes cujos dados não podem sair da rede interna, a combinação "open source + contexto de 1M + capacidade de nível de ponta" é algo que o Opus 5.5 não oferece.
Preço e velocidade
Vamos deixar os preços claros (até outubro de 2026):
| Modelo | Entrada oficial | Saída oficial | Preço na plataforma HiAPI |
|---|---|---|---|
| Kimi K3.1 Pro | US$ 2/M | US$ 10/M | [$2.1548/$11.2714 (até 2026-10): preço da plataforma, a confirmar via /api/pricing após o lançamento] |
| claude-opus-5-5 | — | — | US$ 2,02 / US$ 10,08 (leitura de cache US$ 0,10/M) |
O K3.1 Pro tem ainda preço oficial de acerto de cache de US$ 0,20/M e uma variante Highspeed (US$ 4/US$ 20, 2 a 3 vezes mais rápida), adequada para cenários online sensíveis à latência. A geração anterior, Kimi K3, custa US$ 2,1548/US$ 11,2714 na HiAPI, para referência.
Em termos de velocidade, as fontes variam entre 27 e 80 tokens/segundo, o que o coloca na faixa mais lenta, mas o dobro do K3. No cálculo de custo por tarefa da AA, o K3.1 Pro é US$ 1,98, igual ao K3; considerando a melhoria de capacidade, o custo-benefício é melhor.
Resumindo a faixa de preço em uma frase: não se trata de "um desafiante barato enfrentando uma referência cara", mas de, na mesma faixa de preço, trocar um raciocínio profundo mais fraco por uma taxa de alucinação menor e um contexto mais longo.
Como escolher: respostas por cenário
Escolha o Kimi K3.1 Pro se:
- Suas tarefas são codificação agêntica, operações de terminal ou engenharia de software de ciclo longo
- Você se importa extremamente com a taxa de alucinação (finanças, direito, medicina, perguntas e respostas em bases de conhecimento)
- Você precisa de contexto de 1M para processar materiais inteiros
- Você precisa de autohospedagem (aguardando a liberação dos pesos) ou exige pesos abertos auditáveis
Escolha o Claude Opus 5.5 se:
- Seu foco é raciocínio científico profundo, matemática complexa ou lógica de múltiplos saltos
- Você busca maturidade comprovada por mais tempo
- Seu fluxo de trabalho já está profundamente integrado ao ecossistema Anthropic
Abordagem pragmática para aproveitar os dois: como o preço é o mesmo, é possível rotear por tarefa; tarefas de raciocínio vão para o Opus, codificação e perguntas factuais vão para a Kimi. Para conhecer os limites completos de capacidade do Opus 5.5, veja a página de detalhes do modelo.
Perguntas frequentes
Qual escreve código melhor: Kimi K3.1 Pro ou Claude Opus 5.5?
Praticamente empatados. No Terminal-Bench 4.0, 65,7 contra 66,4 (teste interno oficial da Moonshot); no SWE-Marathon, de ciclo mais longo, a Kimi supera com 51,7 contra 46,3. O que realmente importa é executar seus próprios conjuntos de tarefas em cada um, não olhar apenas os rankings.
A taxa de alucinação do Kimi K3.1 Pro é realmente menor que a do Opus 5.5?
Segundo o critério de teste interno oficial da Moonshot, 8,3% contra 15,0%, cerca de metade. A corroboração de terceiros para esse item específico é relativamente sólida, sendo a vantagem mais consistente do K3.1. Mas atenção: no critério de teste interno, a Kimi roda em max effort; a configuração de effort na implantação real afeta o desempenho.
Qual é a janela de contexto do Kimi K3.1 Pro?
1M tokens, com entrada de texto e imagem. Alimentar materiais inteiros ou repositórios de código completos é o ponto forte dele. O Opus 5.5 também tem boa capacidade de contexto longo, mas em termos de magnitude a Kimi é mais folgada.
O Kimi K3.1 Pro vai abrir os pesos?
A Moonshot já prometeu liberar os pesos completos até 2026-11-04. Quando cumprido, será o modelo de pesos abertos com a maior pontuação no ranking AA. Para equipes que precisam de implantação privada, este é um motivo decisivo para escolhê-lo.
Quanto custa a API do Kimi K3.1 Pro?
Preço oficial de US$ 2 de entrada e US$ 10 de saída (por 1M tokens), acerto de cache US$ 0,20, além da variante Highspeed a US$ 4/US$ 20 (2 a 3 vezes mais rápida). Preço na plataforma HiAPI: [$2.1548/$11.2714 (até 2026-10): preço da plataforma, a confirmar via /api/pricing após o lançamento].
Com o mesmo orçamento, qual é a combinação mais econômica dos dois modelos?
Roteie por tarefa: raciocínio profundo vai para o Opus 5.5; codificação, perguntas factuais e documentos longos vão para a Kimi. O preço unitário dos dois é quase idêntico; o custo extra do roteamento é principalmente o esforço de engenharia para manter dois conjuntos de chamadas.
Conclusões principais
Kimi K3.1 Pro e Claude Opus 5.5 são duas respostas diferentes na mesma faixa de preço. A Kimi troca a vantagem de raciocínio profundo do Opus por baixa taxa de alucinação, contexto de 1M, codificação agêntica e a iminente abertura dos pesos. Nenhum modelo é melhor em todos os cenários, e o consenso de terceiros é de superação pontual, não de liderança abrangente. Roteie pelo tipo de tarefa ou faça primeiro um teste real com seu conjunto de tarefas; isso é mais confiável do que qualquer ranking. Na HiAPI, o claude-opus-5-5 já está disponível para uso; antes do lançamento do kimi-k3.1-pro, você pode usar o kimi-k3 para validar o fluxo.
Artigos da mesma série
Artigos relacionados
Ver todos os artigos →-

Avaliação comparativa
Wan 2.6 Flash vs Wan 2.7: vale a pena atualizar?
Orçamento em 720P e resultados em 1080P da raposa e do carro; condições de áudio e faixas reais indicadas conjunto por conjunto.
-

Avaliação comparativa
Vidu Q4 Preview vs Kling 3.0: como escolher para vídeo a partir de imagem?
Com som padrão, 16 segundos e 5 níveis de resolução, escolha o Vidu Q4 Preview; para travar a imagem com primeiro e último frame, escolha o Kling 3.0. Inclui duas comparações com o mesmo prompt: hidroavião e barista.
-

Avaliação comparativa
Alternativa ao Replicate: comparação entre hiapi e Replicate para geração de imagem e vídeo (2026)
O que precisa mudar nas chamadas de previsão, nos webhooks e na cobrança ao migrar do Replicate para o hiapi, com uma lista de migração em 10 passos.